メタデータ設計
このドキュメントでは、Apache Doris FE のメタデータについて、全体的なアーキテクチャ、保存構造、データフローに加え、実装の詳細、起動手順、クラッシュリカバリーの仕組みを説明します。
用語
| 用語 | 説明 |
|---|---|
| FE | Frontend。Doris のフロントエンドノードです。クライアントからのリクエストの受信と応答、メタデータとクラスタの管理、クエリプランの生成を行います。 |
| BE | Backend。Doris のバックエンドノードです。データの保存と管理、クエリプランの実行を行います。 |
| bdbje | Oracle Berkeley DB Java Edition。Doris では、メタデータ操作ログの永続化と FE の高可用性の実現に使用します。 |
全体的なアーキテクチャ
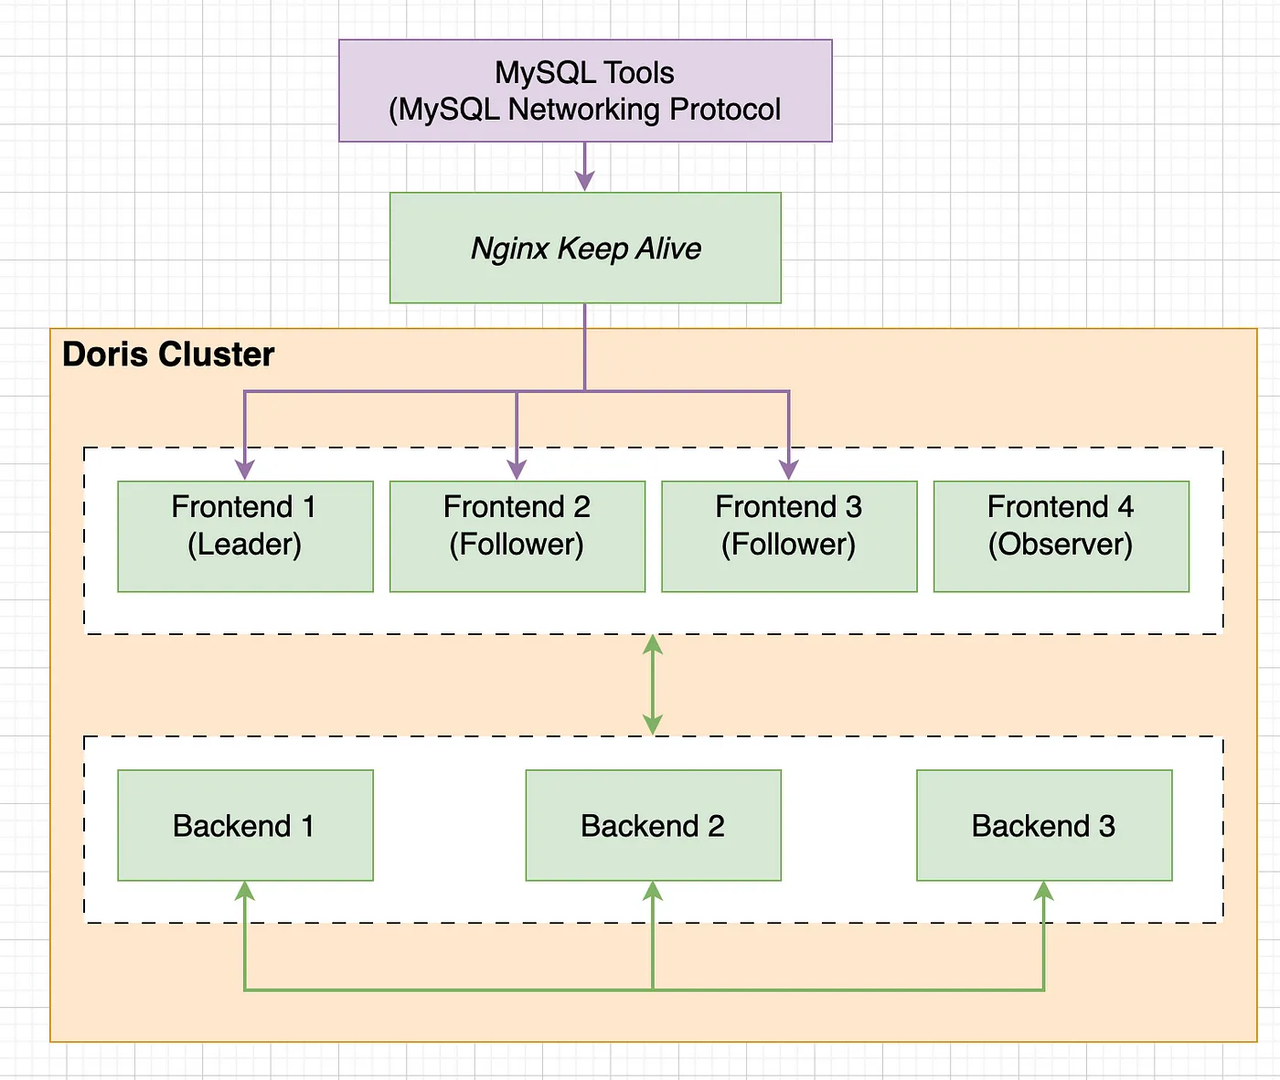
上図のように、Doris は二層のアーキテクチャです。複数の FE が第一層を構成し、FE の水平スケーリングと高可用性を実現します。複数の BE が第二層を構成し、データの保存と管理を担います。このドキュメントでは、FE 層におけるメタデータの設計と実装に焦点を当てます。
-
FE ノードには、フォロワーとオブザーバーの二種類があります。FE は bdbje(BerkeleyDB Java Edition)を通じて、リーダー選出、データ同期などを行います。
-
フォロワーノードはメタデータの書き込み操作を処理するリーダーを選出します。リーダーノードがクラッシュすると、残りのフォロワーノードが新しいリーダーを選出し、サービスの高可用性を維持します。
-
オブザーバーノードはリーダーからメタデータを同期するだけで、選出には参加しません。オブザーバーを水平に増やすことで、メタデータの読み取りサービスを拡張できます。
注:Doris におけるフォロワーとオブザーバーは、bdbje におけるレプリカとオブザーバーに対応します。以下の説明では、両方の名称が使われることがあります。
メタデータの構造
Doris のメタデータはすべてメモリ内に保持されます。各 FE は、完全なメタデータイメージをメモリ内に保持します。Baidu の社内環境では、2,500 個のテーブルと 1 million 個のタブレット(3 million 個のレプリカ)を持つクラスタでも、メタデータのメモリ使用量は約 2 GB です。(クエリの中間オブジェクトや各種ジョブ情報などのメモリ使用量は別途見積もる必要がありますが、全体的なメモリ使用量は低く抑えられます。)
メタデータはメモリ内で木構造の階層として保存され、各階層のメタデータに高速にアクセスできるよう、補助的な構造も用意されています。
次の図は、Doris のメタデータに含まれる情報を示します。
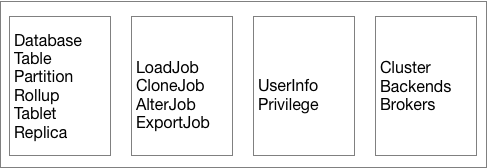
上図のように、Doris のメタデータには四種類のデータが保存されます。
- データベース、テーブルスキーマ、タブレット情報などのユーザーデータに関する情報。
- ロードジョブ、クローンジョブ、スキーマ変更ジョブなど、各種ジョブに関する情報。
- ユーザーと権限に関する情報。
- クラスタとノードに関する情報。
データフロー
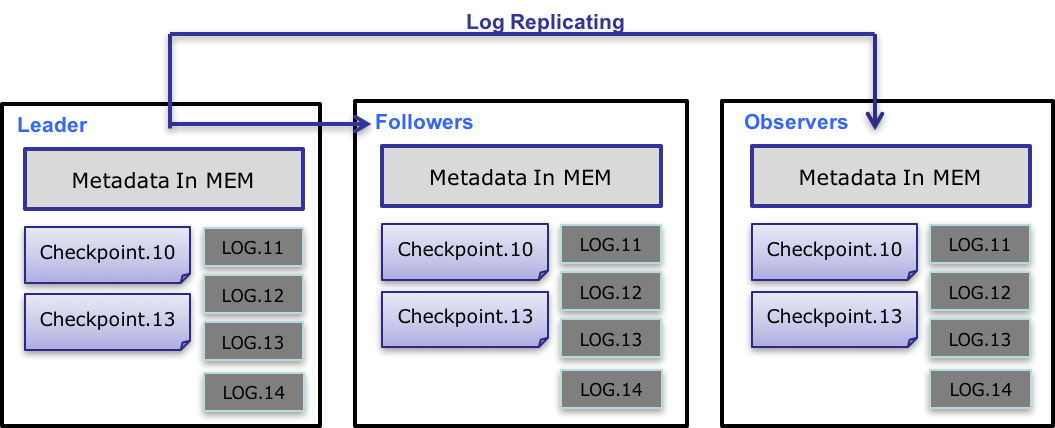
メタデータのデータフローは次のとおりです。
-
メタデータを書き込めるのはリーダー FE だけです。書き込み操作によってリーダーのメモリ内のデータが変更されると、その操作はログエントリにシリアライズされ、キーと値のペアとして bdbje に書き込まれます。キーはログ id として使用される連続した整数で、値はシリアライズされた操作ログです。
-
ログが bdbje に書き込まれると、bdbje はポリシー(write-majority または write-all)に従って、リーダー以外の FE ノードにログを複製します。リーダー以外の FE ノードはログを再生して自身のメモリ内のメタデータイメージを更新し、リーダーとのメタデータ同期を完了します。
-
リーダーのログエントリ数がしきい値(デフォルトでは 10w エントリ)に達し、チェックポイントスレッドの実行タイミング(デフォルトでは 60 秒ごと)になると、チェックポイント処理は既存のイメージファイルとそれ以降のログを読み込み、メモリ内で新しいメタデータイメージのコピーを再生して、そのコピーをディスクに書き込み、新しいイメージを作成します。既存のイメージを直接書き込まずに新しいコピーを再生するのは、イメージの書き込みには読み取りロックが必要で、書き込み操作がブロックされるためです。その結果、チェックポイント処理中は通常の二倍のメモリを使用します。
-
イメージファイルが生成されると、リーダーはリーダー以外のノードに新しいイメージが利用可能になったことを通知します。リーダー以外のノードは HTTP 経由で最新のイメージファイルを取得し、ローカルの古いファイルを置き換えます。
-
イメージの生成後、bdbje 内の古いログは定期的に削除されます。
実装の詳細
メタデータディレクトリ
- メタデータディレクトリは FE の設定項目
meta_dirで指定します。 bdb/ディレクトリには bdbje のデータが保存されます。image/ディレクトリにはイメージファイルが保存されます。
image/ ディレクトリ内の主なファイルは次のとおりです。
| ファイル | 説明 |
|---|---|
image.[logid] | 最新のイメージファイルです。接尾辞の logid は、イメージに含まれる最後のログエントリの id を示します。 |
image.ckpt | 書き込み中のイメージファイルです。書き込みに成功すると、image.[logid] に名前が変更され、古いイメージファイルが置き換えられます。 |
VERSION | Doris クラスタを一意に識別する cluster_id を記録します。cluster_id は、リーダーが最初に起動したときに生成されるランダムな 32 ビット整数で、FE の設定項目 cluster_id から指定することもできます。 |
ROLE | FE 自身の役割を記録します。役割は FOLLOWER または OBSERVER のいずれかです。FOLLOWER は、その FE が選出に参加できるノードであることを示します。(注:リーダーノードの役割も FOLLOWER です。) |
起動手順
-
FE の初回起動時に、起動スクリプトを引数なしで実行すると、FE はリーダーとして起動しようとします。最終的に、FE の起動ログには
transfer from UNKNOWN to MASTERと表示されます。 -
FE の初回起動時に、起動スクリプトの
--helperパラメータで正しいリーダー FE ノードを指定すると、FE はまず HTTP 経由でリーダーに自身の役割(ROLE)とcluster_idを問い合わせ、次に最新のイメージファイルを取得します。イメージファイルを読み込んでメタデータイメージを生成した後、FE は bdbje を起動してログを同期します。同期が完了すると、bdbje 内のイメージファイル以降のログを再生し、最終的なメタデータイメージを生成します。注 1:
--helperパラメータを指定して起動する場合は、先にリーダー上で mysql コマンドを使用して FE を追加する必要があります。そうしないと、起動時にエラーになります。注 2:
--helperには、リーダーに限らず、任意のフォロワーノードを指定できます。注 3:bdbje がログを同期している間、FE のログには
xxx detachedと表示されます。これはログの取得中であることを示す、想定どおりの表示です。 -
FE の初回以外の起動時に、起動スクリプトを引数なしで実行すると、FE はローカルに保存された ROLE 情報から自身の役割を判定します。また、ローカルの bdbje に保存されたクラスタ情報からリーダー情報を読み取り、ローカルのイメージファイルと bdbje 内のログを読み込んでメタデータイメージを生成します。(ローカルの ROLE に記録された役割が bdbje に記録された役割と一致しない場合は、エラーになります。)
-
FE の初回以外の起動時に、起動スクリプトで
--helperパラメータを指定した場合の手順は初回起動時と同じです。FE はまずリーダーに役割を問い合わせますが、その結果をローカルに保存された ROLE と比較し、一致しない場合はエラーを報告します。
メタデータの読み取り、書き込み、同期
-
mysql を使用すると、任意の FE ノードに接続してメタデータを読み書きできます。接続先がリーダー以外のノードである場合、そのノードは書き込み操作をリーダーに転送します。リーダーへの書き込みが成功すると、リーダーは最新のログ id を返します。リーダー以外のノードは、自身が再生したログ id が返されたログ id を超えるまで待ってから、クライアントに成功メッセージを返します。この仕組みにより、どの FE ノードでも Read-Your-Write セマンティクスが提供されます。
注:
SHOW LOADなど、一部の書き込み以外の操作もリーダーに転送されます。これらのコマンドは通常、ジョブの中間状態を読み取る必要がありますが、中間状態は bdbje に書き込まれないため、リーダー以外のノードのメモリ内には存在しません。(FE 間のメタデータ同期は、すべて bdbje のログ再生に依存します。メタデータを変更する操作が bdbje のログに書き込まれない場合、その変更結果はリーダー以外のノードでは確認できません。) -
リーダーノードは
TimePrinterスレッドを起動し、現在時刻を含むキーと値のエントリを定期的に bdbje に書き込みます。残りのリーダー以外のノードはこのログを再生し、記録された時刻を読み取ってローカル時刻と比較します。ローカル時刻の遅れが指定されたしきい値(設定項目meta_delay_toleration_second。書き込み間隔はこの値の半分に設定されます)を超えると、ノードは読み取り不可の状態になります。この仕組みにより、リーダーとの通信が長時間途絶えた後も、リーダー以外のノードが古いメタデータでサービスを提供し続けることを防ぎます。 -
FE 間のメタデータは最終的整合性のみを持ちます。通常、整合していない期間はミリ秒単位です。同じセッション内ではメタデータアクセスの単調一貫性が保証されますが、同じクライアントが異なる FE に接続すると、メタデータが以前の状態に戻ったように見えることがあります。(一括更新を行うシステムでは、この問題の影響は小さくなります。)
クラッシュリカバリー
| 状況 | 動作 |
|---|---|
| リーダーノードがクラッシュした場合 | 残りのフォロワーが直ちに新しいリーダーを選出し、サービスを提供します。 |
| フォロワーノードの過半数がクラッシュした場合 | メタデータを書き込めなくなります。この時点で書き込みリクエストを受けると、現在の動作ではFE プロセスがそのまま終了します。将来的には、書き込み不能の状態でも読み取りサービスを提供し続けられるよう改善される予定です。 |
| オブザーバーノードがクラッシュした場合 | 他のノードの状態にも、他のノードでのメタデータの読み書きにも影響しません。 |