Stream Load
Stream Load は、HTTP 経由でローカルファイルやデータストリームを Doris にインポートします。同期的なインポート方式であり、実行後に結果が返るため、レスポンスから成功したかどうかを確認できます。通常、10 GB 未満のファイルのインポートに使用します。これより大きいファイルは、分割してから各部分を Stream Load でインポートしてください。Stream Load は 一回のインポートジョブの原子性を保証し、すべての行が正常にインポートされるか、どの行もインポートされないかのどちらかになります。
curl を直接使用する単一並列度のインポートと比べて、専用インポートツールの Doris Streamloader を推奨します。これは Doris へのデータインポートに特化したクライアントツールで、並列インポートに対応し、大量データのインポート時間を短縮できます。使用方法と詳細は、Doris Streamloader のドキュメントを参照してください。
ユースケース
Stream Load は、次のような場面に適しています。
- ローカルまたはリモートの CSV、JSON、Parquet、ORC ファイルを Doris にインポートする。
- プログラム(Java、Go、Python など)から HTTP ストリームを通じてデータを継続的に書き込む。
- 単一のインポートジョブの原子性(すべての行が成功するか、すべて失敗するか)が必要な場合。
- 通常 10 GB 未満の単一ファイル。大きなファイルは分割してからインポートするか、Doris Streamloader を使用します。
CSV ファイルのインポート時は、NULL 値と空文字列を明確に区別してください。
- NULL 値(null):
\Nで表します。たとえばa,\N,bでは中央の列が NULL です。 - 空文字列:二つの区切り文字の間に文字がない場合、値は空文字列です。たとえば
a,,bでは 二つのカンマの間に文字がないため、中央の列は空文字列です。
基本原理
Stream Load では、HTTP 経由で FE ノードにインポートジョブを送信します。FE は負荷を分散するため、リクエストをラウンドロビン方式で BE ノードにリダイレクトします。特定の BE ノードに HTTP リクエストを直接送信することもできます。Doris は Stream Load の Coordinator として 一つのノードを指定します。Coordinator はデータを受信し、ほかのノードへ分配します。
次の図は Stream Load の主な処理フローを示しています。
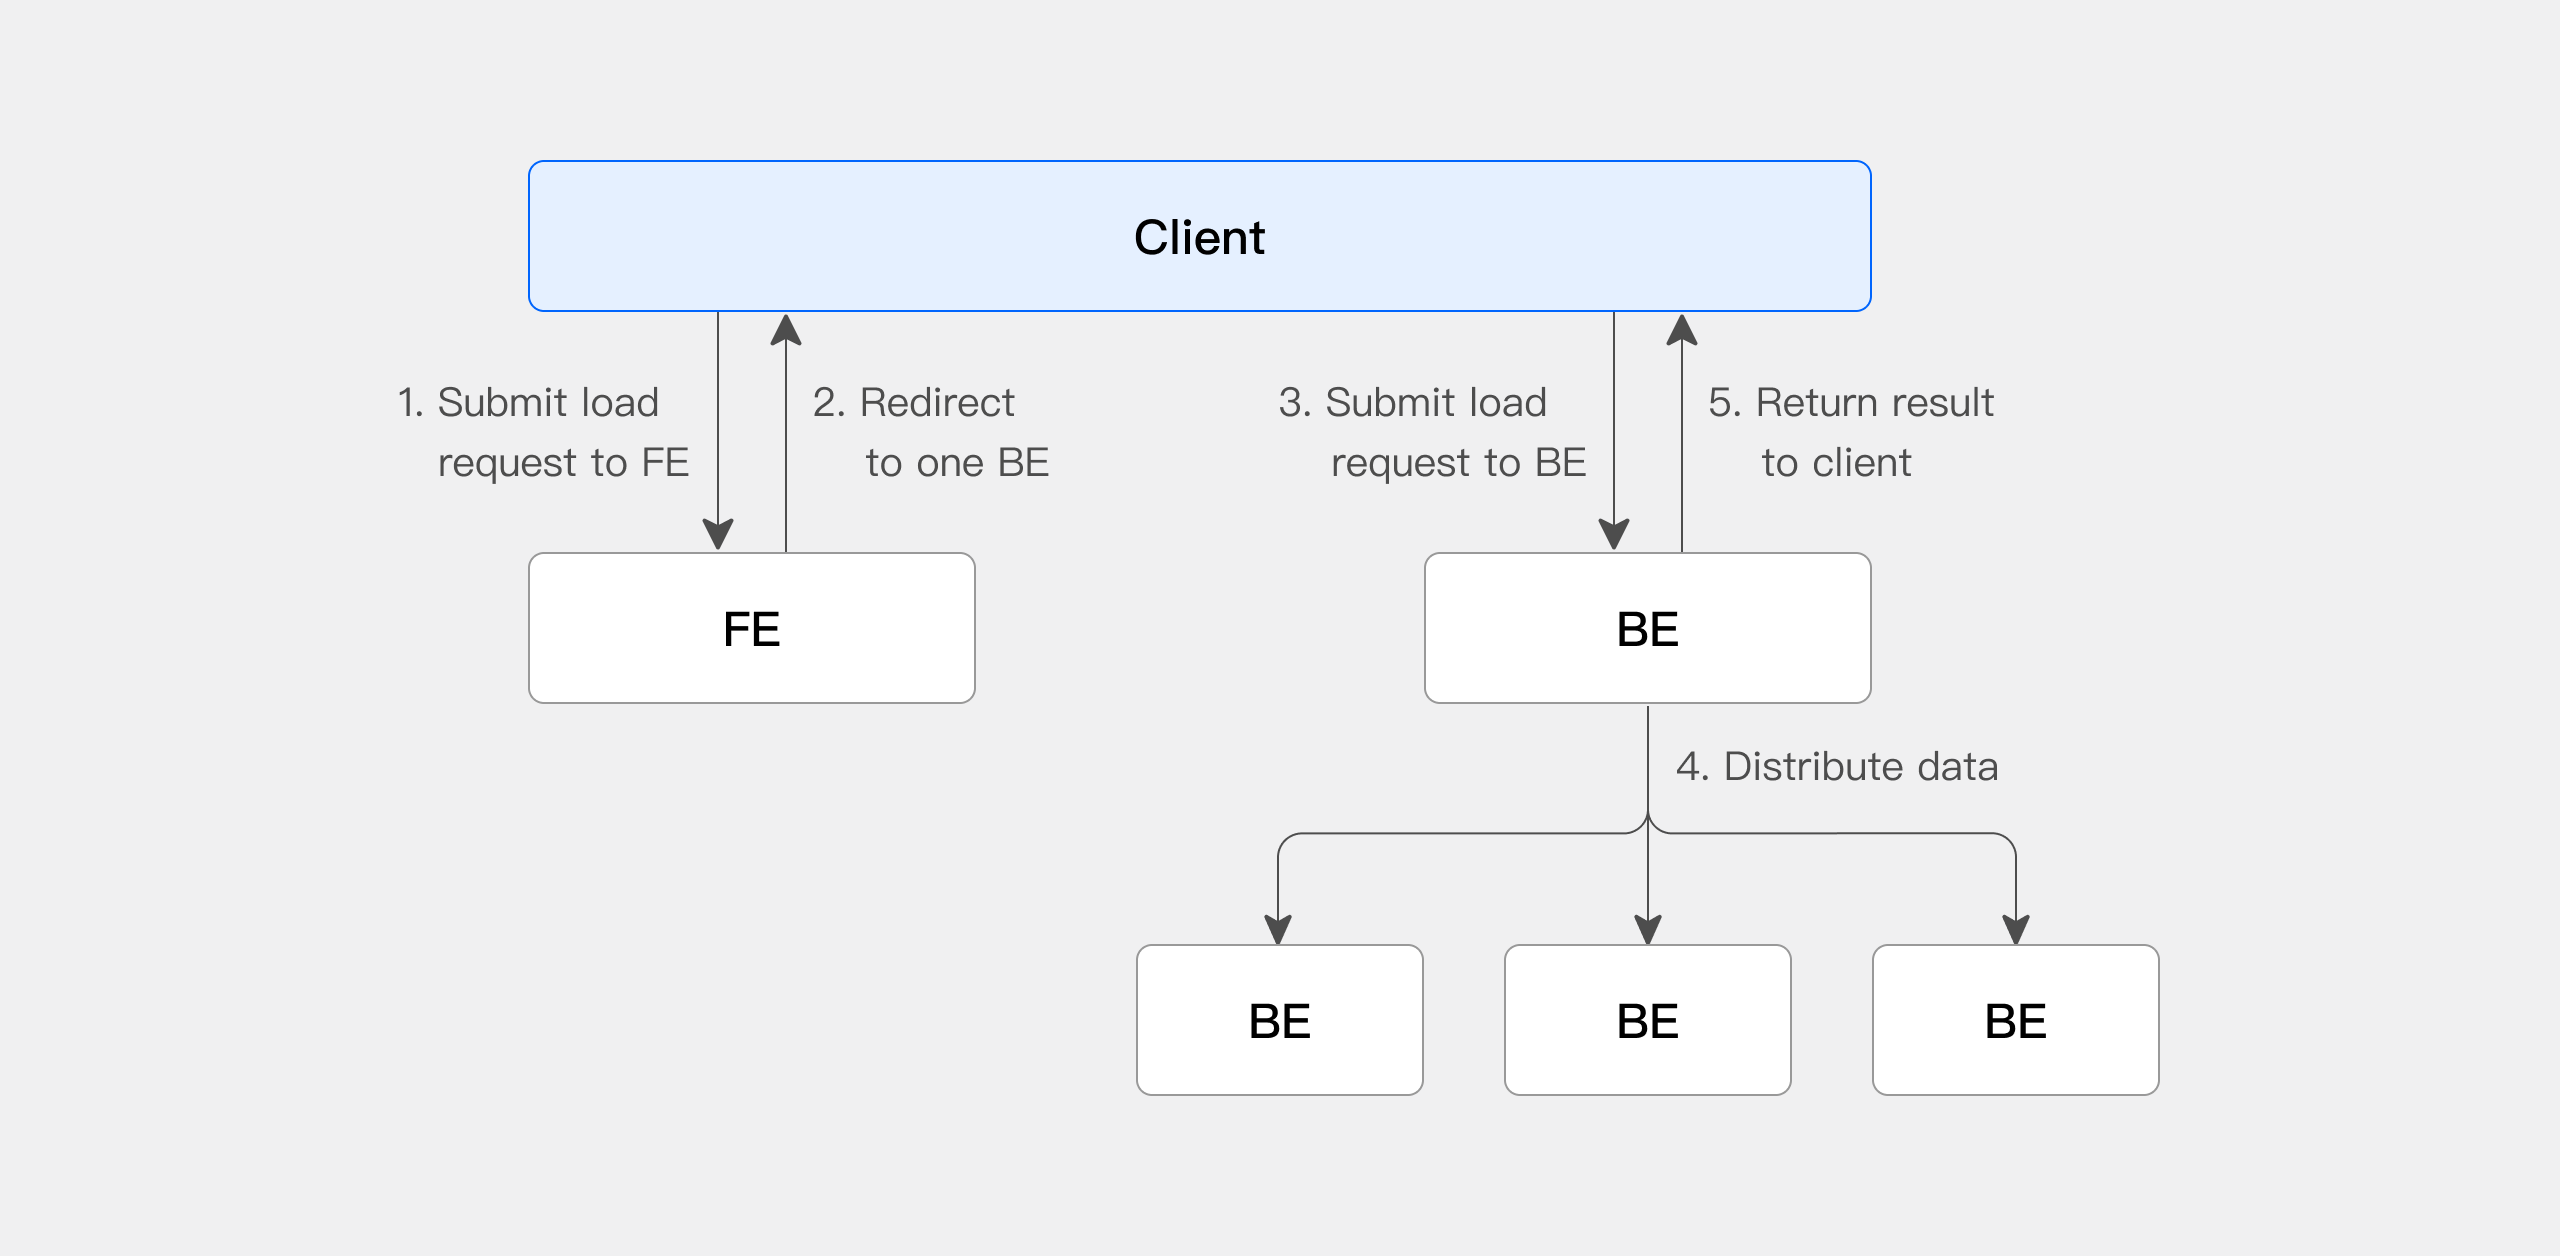
実行フローは次のとおりです。
- クライアントが Stream Load のインポートジョブを FE に送信します。
- FE はラウンドロビン方式でインポートジョブのスケジューリングを担当する BE を Coordinator として選択し、クライアントに HTTP リダイレクトを返します。
- クライアントは Coordinator である BE ノードに接続し、インポートリクエストを送信します。
- Coordinator の BE は対応する BE ノードにデータを分配します。インポート完了後、クライアントに結果を返します。
- クライアントは BE ノードを Coordinator として直接指定し、インポートジョブを分配させることもできます。
クイックスタート
Stream Load は HTTP 経由で送信および転送されます。以下の例では curl ツールを使用して、Stream Load のインポートジョブを送信する方法を示します。
前提条件
Stream Load には対象テーブルに対する INSERT 権限が必要です。ユーザーに INSERT 権限がない場合は、GRANT コマンドで付与してください。
インポートジョブの作成
CSV データのインポート
-
インポートデータを作成する
次の内容で CSV ファイル
streamload_example.csvを作成します。1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64 -
インポート先の Doris テーブルを作成する
次のステートメントで Doris にインポート先のテーブルを作成します。
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
インポートジョブを開始する
curlコマンドで Stream Load のインポートジョブを送信できます。curl --location-trusted -u <doris_user>:<doris_password> \
-H "Expect:100-continue" \
-H "column_separator:," \
-H "columns:user_id,name,age" \
-T streamload_example.csv \
-XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_loadStream Load は同期的なインポート方式であり、結果がユーザーに直接返されます。
{
    "TxnId": 3,
    "Label": "123",
    "Comment": "",
    "TwoPhaseCommit": "false",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 10,
    "NumberLoadedRows": 10,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 118,
    "LoadTimeMs": 173,
    "BeginTxnTimeMs": 1,
    "StreamLoadPutTimeMs": 70,
    "ReadDataTimeMs": 2,
    "WriteDataTimeMs": 48,
    "CommitAndPublishTimeMs": 52
} -
インポートしたデータを確認する
mysql> select count(*) from testdb.test_streamload;
+----------+
| count(*) |
+----------+
|       10 |
+----------+
JSON データのインポート
-
インポートデータを作成する
次の内容で JSON ファイル
streamload_example.jsonを作成します。[
{"userid":1,"username":"Emily","userage":25},
{"userid":2,"username":"Benjamin","userage":35},
{"userid":3,"username":"Olivia","userage":28},
{"userid":4,"username":"Alexander","userage":60},
{"userid":5,"username":"Ava","userage":17},
{"userid":6,"username":"William","userage":69},
{"userid":7,"username":"Sophia","userage":32},
{"userid":8,"username":"James","userage":64},
{"userid":9,"username":"Emma","userage":37},
{"userid":10,"username":"Liam","userage":64}
] -
インポート先の Doris テーブルを作成する
次のステートメントで Doris にインポート先のテーブルを作成します。
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10; -
インポートジョブを開始する
curlコマンドで Stream Load のインポートジョブを送信できます。curl --location-trusted -u <doris_user>:<doris_password> \
-H "label:124" \
-H "Expect:100-continue" \
-H "format:json" -H "strip_outer_array:true" \
-H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
-H "columns:user_id,name,age" \
-T streamload_example.json \
-XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load注記JSON ファイルが配列ではなく 一行に一つの JSON オブジェクトを含む場合は、ヘッダー
-H "strip_outer_array:false"と-H "read_json_by_line:true"を追加します。 JSON ファイルのルートノードにある JSON オブジェクトをインポートするには、jsonpathsを$.に設定します。例:-H "jsonpaths:[\"$.\"]"。Stream Load は同期的なインポート方式であり、結果がユーザーに直接返されます。
{
    "TxnId": 7,
    "Label": "125",
    "Comment": "",
    "TwoPhaseCommit": "false",
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 10,
    "NumberLoadedRows": 10,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 471,
    "LoadTimeMs": 52,
    "BeginTxnTimeMs": 0,
    "StreamLoadPutTimeMs": 11,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 23,
    "CommitAndPublishTimeMs": 16
}
インポートジョブの確認
デフォルトでは、Stream Load は結果をクライアントに同期的に返すため、システムは Stream Load のジョブ履歴を記録しません。記録を有効にするには、設定 enable_stream_load_record=true を be.conf に追加します。詳細は BE の設定を参照してください。
設定後、show stream load コマンドで完了した Stream Load ジョブを確認できます。
mysql> show stream load from testdb;
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
| Label | Db     | Table           | ClientIp      | Status  | Message | Url  | TotalRows | LoadedRows | FilteredRows | UnselectedRows | LoadBytes | StartTime               | FinishTime              | User | Comment |
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
| 12356 | testdb | test_streamload | 192.168.88.31 | Success | OK      | N/A  | 10        | 10         | 0            | 0              | 118       | 2023-11-29 08:53:00.594 | 2023-11-29 08:53:00.650 | root |         |
+-------+--------+-----------------+---------------+---------+---------+------+-----------+------------+--------------+----------------+-----------+-------------------------+-------------------------+------+---------+
1 row in set (0.00 sec)
インポートジョブのキャンセル
ユーザーは Stream Load を手動でキャンセルできません。タイムアウトまたはインポートエラーが発生すると、システムが自動的にキャンセルします。
Compute Group の指定
Stream Load を実行する Compute Group を指定できます。
ストレージとコンピュートの分離モード
ストレージとコンピュートの分離モードでは、次の方法で Compute Group を指定できます。
-
HTTP ヘッダーパラメーターで指定します。
-H "cloud_cluster:cluster1"Doris 4.0.0 以降では、
compute_groupパラメーターも使用できます。-H "compute_group:cluster1"compute_groupとcloud_clusterの両方を設定した場合は、compute_groupが優先されます。 -
Stream Load に紐づくユーザープロパティで Compute Group を指定します。ユーザープロパティと HTTP ヘッダーの両方で指定した場合は、ヘッダーの指定が優先されます。
set property for user1 'default_compute_group'='cluster1'; -
ユーザープロパティでも HTTP ヘッダーでも Compute Group を指定しない場合は、Stream Load に紐づくユーザーがアクセスできる Compute Group から 一つが選択されます。アクセスできる Compute Group がない場合、インポートは失敗します。
Doris 4.0 系の 4.0.8 以降、および 4.1 系の 4.1.4 以降では、ストレージとコンピュートの分離モードにおける Stream Load の Compute Group ルーティングと実行プランの不整合が修正されています。
compute_groupヘッダーはcloud_clusterより優先されます。以前は FE はcloud_clusterのみを認識していました。- 実行プランの作成時には、実際にリクエストを受信した BE の Compute Group が使用されるため、実行先と異なる Compute Group にプランが配置されなくなります。
- この処理では、インポートを実行するアカウントが対象 Compute Group にアクセスできるか、Compute Group が存在するか、およびその状態も検証します。そのため、アップグレード後にアカウントが実際にリクエストを処理する Compute Group にアクセスできない場合、権限エラーでインポートが失敗します。アカウントには該当する権限を付与する必要があります。
バージョン 4.1.4 以降、BE の Stream Load エンドポイント(PUT /api/{db}/{table}/_stream_load、PUT /api/_http_stream、PUT /api/{db}/_stream_load_2pc)では、グローバル LOAD 権限の事前チェックが行われません。認可は、実際に書き込むデータベースとテーブルに対して FE で一元的に行われます。
これにより、データベースまたはテーブルレベルの LOAD_PRIV のみを持ち、グローバル LOAD 権限を持たないアカウントでも、Stream Load と 2PC のコミット/中止を実行できるようになりました。
ストレージとコンピュートの統合モード
ストレージとコンピュートの統合モードでは、Stream Load に紐づくユーザープロパティでのみ Compute Group を指定できます。ユーザープロパティで指定しない場合は、default という名前の Compute Group が選択されます。
set property for user1 'resource_tags.location'='group_1';
リファレンス
インポートコマンド
Stream Load のインポート構文は次のとおりです。
curl --location-trusted -u <doris_user>:<doris_password> \
  -H "Expect:100-continue" [-H ""...] \
  -T <file_path> \
  -XPUT http://fe_host:http_port/api/{db}/{table}/_stream_load
Stream Load は HTTP のチャンク形式と非チャンク形式の両方のインポートに対応します。非チャンク形式のインポートでは、アップロードするコンテンツの長さを示す Content-Length を指定する必要があります。これによりデータの完全性が保証されます。
インポート設定パラメーター
FE の設定
1. stream_load_default_timeout_second
| 項目 | 説明 |
|---|---|
| デフォルト値 | 259200 (s) |
| 動的設定 | はい |
| FE Master のみの設定 | はい |
説明:Stream Load のデフォルトタイムアウトです。インポートジョブのタイムアウトを秒単位で指定します。設定した timeout 内にジョブが完了しない場合、システムがキャンセルし、ジョブは CANCELLED 状態になります。指定時間内にソースファイルをインポートできない場合は、Stream Load リクエストに個別のタイムアウトを指定するか、FE パラメーター stream_load_default_timeout_second を調整してグローバルなデフォルトタイムアウトを変更できます。
BE の設定
1. streaming_load_max_mb
| 項目 | 説明 |
|---|---|
| デフォルト値 | 10240 (MB) |
| 動的設定 | はい |
説明:Stream Load でインポートできる最大サイズです。ソースファイルがこの値を超える場合は、BE パラメーター streaming_load_max_mb を調整してください。
ヘッダーパラメーター
インポートパラメーターは HTTP ヘッダーで渡せます。各パラメーターの説明は次のとおりです。
| タグ | パラメーターの説明 |
|---|---|
| label | このインポートのラベルを指定します。同じラベルのデータを複数回インポートすることはできません。指定しない場合は Doris が自動生成します。ラベルを指定すると、同じデータの重複インポートを防げます。デフォルトでは、Doris はインポートジョブのラベルを 三日間保持します。保持期間は label_keep_max_second で調整できます。たとえば、ラベル 123 を指定するには -H "label:123" を使用します。同じデータバッチには同じラベルを使用することを強く推奨します。これにより、同じバッチへの重複リクエストは一度だけ受け付けられ、At-Most-Once セマンティクスが保証されます。ラベルに対応するインポートジョブが CANCELLED 状態の場合は、そのラベルを再利用できます。 |
| column_separator | インポートファイルの列区切り文字を指定します。デフォルトは \t です。不可視文字には接頭辞 \x を付け、区切り文字を 十六進数で表します。複数文字の組み合わせも列区切り文字に使用できます。たとえば、Hive のファイル区切り文字 \x01 は -H "column_separator:\x01" で指定します。 |
| line_delimiter | インポートファイルの行区切り文字を指定します。デフォルトは \n です。複数文字の組み合わせも行区切り文字に使用できます。たとえば \n を指定するには -H "line_delimiter:\n" を使用します。 |
| columns | インポートファイルの列とテーブルの列との対応付けを指定します。ソースファイルの列がテーブルの列と完全に一致する場合は指定不要です。一致しない場合は、データ変換のために指定する必要があります。列の指定方法には、インポートファイルのフィールド名をそのまま指定する方法と、構文 column_name = expression で派生列を指定する方法があります。詳しい例はインポート時のデータ変換を参照してください。 |
| where | データの一部を抽出するために使用します。不要なデータを除外する場合に指定します。たとえば列 k1 が 20180601 のデータのみをインポートするには、インポート時に -H "where: k1 = 20180601" を指定します。 |
| max_filter_ratio | 除外を許容するデータの最大比率を指定します(データ形式が不正な場合など)。デフォルトでは除外を許容しません。値の範囲は 0 から 1 です。インポートエラー率がこの値を超えると、インポートは失敗します。where 条件で除外された行は不正データに数えられません。たとえば、正しいデータをできるだけインポートする(100% 許容する)には -H "max_filter_ratio:1" を指定します。 |
| partitions | このインポートの対象パーティションを指定します。データに対応するパーティションが分かっている場合は指定を推奨します。指定したパーティションに該当しないデータは除外されます。たとえば p1 と p2 にインポートするには -H "partitions: p1, p2" を指定します。 |
| timeout | インポートのタイムアウトを秒単位で指定します。デフォルトは 600 秒、有効範囲は 1 秒から 259200 秒です。たとえば 1200 秒に設定するには -H "timeout:1200" を指定します。 |
| strict_mode | このインポートで厳格モードを有効にするかどうかを指定します。デフォルトでは無効です。たとえば有効にするには -H "strict_mode:true" を指定します。 |
| timezone | このインポートで使用するタイムゾーンを指定します。デフォルトはクラスターの現在のタイムゾーンです。このパラメーターは、インポートに関係するすべてのタイムゾーン関連関数の結果に影響します。たとえば Africa/Abidjan に設定するには -H "timezone:Africa/Abidjan" を指定します。 |
| exec_mem_limit | インポート時のメモリ上限です。デフォルトは 2 GB、単位はバイトです。 |
| format | このインポートのデータ形式を指定します。デフォルトは CSV です。現在、CSV、JSON、arrow、csv_with_names(CSV ファイルの先頭の一行を除外)、csv_with_names_and_types(先頭の二行を除外)、Parquet、ORC に対応します。たとえば JSON を指定するには -H "format:json" を使用します。 |
| jsonpaths | JSON データのインポートには二つの方法があります。jsonpaths を指定しない単純モードでは、JSON データがオブジェクト型である必要があります。JSON データが複雑な場合は、jsonpaths パラメーターで対応する値を照合するマッチングモードを使用します。単純モードでは、JSON のキーとテーブルの列名が 一対一 で対応する必要があります。たとえば JSON データ {"k1":1, "k2":2, "k3":"hello"} の k1、k2、k3 はテーブルの列に対応する必要があります。 |
| strip_outer_array | strip_outer_array を true にすると、配列オブジェクトで始まる JSON データの配列が展開されます。デフォルトは false です。JSON データの最外層が [] で表される配列の場合は strip_outer_array を true に設定します。たとえば [{"k1" : 1, "v1" : 2},{"k1" : 3, "v1" : 4}] のデータでは、strip_outer_array を true に設定すると Doris に 二行がインポートされます。 |
| json_root | json_root は JSON ドキュメントのルートノードを指定する有効な jsonpath 文字列です。デフォルト値は "" です。 |
| merge_type | データのマージタイプです。次の 三種類に対応します。 - APPEND(デフォルト):このバッチの全データを既存データに追加します。 - DELETE:このバッチのキーと一致するすべての行を削除します。 - MERGE: delete 条件と併用する必要があります。delete 条件に一致するデータは DELETE セマンティクスで処理し、それ以外は APPEND セマンティクスで処理します。たとえば MERGE モードを指定するには -H "merge_type: MERGE" -H "delete: flag=1" を使用します。 |
| delete | MERGE と併用した場合のみ意味があります。データの削除条件を指定します。 |
| function_column.sequence_col | UNIQUE KEYS モデルにのみ適用されます。同じキー列内で、値列が source_sequence 列の順序に従って REPLACE されるようにします。source_sequence にはデータソースの列またはテーブルスキーマの列を指定できます。 |
| fuzzy_parse | 真偽値です。true にすると、最初の行をスキーマとして JSON を解析します。このオプションで JSON インポートの効率が向上する場合がありますが、すべての JSON オブジェクトのキーの順序が最初の行と同じである必要があります。デフォルトは false です。JSON 形式にのみ使用します。 |
| num_as_string | 真偽値です。true にすると、JSON データの解析時に数値型を文字列に変換し、精度を失わずにインポートできるようにします。 |
| read_json_by_line | 真偽値です。true にすると、一行に一つの JSON オブジェクトを読み取れます。デフォルトは false です。 |
| send_batch_parallelism | 整数です。バッチデータ送信の並列度を設定します。この値が BE の設定 max_send_batch_parallelism_per_job を超える場合、Coordinator の BE は max_send_batch_parallelism_per_job の値を使用します。 |
| hidden_columns | インポートデータに含まれる隠し列を指定します。ヘッダーに Columns が含まれていない場合に有効です。複数の隠し列はカンマで区切ります。システムはユーザーが指定したデータを使用してインポートします。次の例では、インポートデータの最後の列が __DORIS_SEQUENCE_COL__ です。hidden_columns: __DORIS_DELETE_SIGN__,__DORIS_SEQUENCE_COL__ |
| load_to_single_tablet | 真偽値です。true にすると、単一ジョブのデータを該当パーティションの 一つのタブレットにのみロードできます。デフォルトは false です。ランダムバケットの OLAP テーブルへのロード時にのみ設定できます。 |
| compress_type | ファイルの圧縮形式を指定します。現在、CSV ファイルの圧縮のみ対応しています。対応形式は gz、lzo、bz2、lz4、lzop、deflate です。 |
| trim_double_quotes | 真偽値です。デフォルトは false です。true にすると、CSV ファイルの各フィールドの最外側の二重引用符を取り除きます。 |
| skip_lines | 整数です。デフォルトは 0 です。CSV ファイルの先頭から指定行数をスキップします。format が csv_with_names または csv_with_names_and_types の場合、このパラメーターは無効です。 |
| comment | 文字列です。デフォルトは空です。ジョブに追加情報を付けます。 |
| enclose | 囲み文字を指定します。CSV データのフィールドに行区切り文字または列区切り文字が含まれる場合、意図しない分割を防ぐため、シングルバイトの囲み文字を指定できます。たとえば列区切り文字が ,、囲み文字が ' で、データが "a,'b,c'" の場合、b,c は 一つのフィールドとして解析されます。注:enclose に " を設定する場合は、trim_double_quotes を true に設定する必要があります。 |
| escape | エスケープ文字を指定します。フィールド内で囲み文字と同じ文字をエスケープするために使用します。たとえばデータが "a,'b,'c'"、囲み文字が ' の場合、b,'c を 一つのフィールドとして解析するには、\\ などの シングルバイトのエスケープ文字を指定し、データを "a,'b,\\'c'" に変更します。 |
| memtable_on_sink_node | インポート時に MemTable の転送を有効にするかどうかを指定します。デフォルトは false です。 |
| unique_key_update_mode | Unique テーブルの更新モードです。現在、Merge-On-Write Unique テーブルでのみ有効です。UPSERT、UPDATE_FIXED_COLUMNS、UPDATE_FLEXIBLE_COLUMNS の 三種類に対応します。UPSERT:upsert セマンティクスでインポートします。UPDATE_FIXED_COLUMNS:部分列更新を使用します。UPDATE_FLEXIBLE_COLUMNS:柔軟な部分列更新を使用します。 |
| partial_update_new_key_behavior | Unique テーブルで部分列更新または柔軟な部分列更新を行うとき、新規挿入行の処理方法を指定します。APPEND と ERROR の 二種類があります。- APPEND:新しい行の挿入を許可します。- ERROR:新しい行を挿入すると、エラーを報告してインポートに失敗します。 |
インポートの戻り値
Stream Load は同期的なインポート方式であり、次のようにインポートリクエストへのレスポンスで結果をユーザーに返します。
{
    "TxnId": 1003,
    "Label": "b6f3bc78-0d2c-45d9-9e4c-faa0a0149bee",
    "Status": "Success",
    "ExistingJobStatus": "FINISHED", // optional
    "Message": "OK",
    "NumberTotalRows": 1000000,
    "NumberLoadedRows": 1000000,
    "NumberFilteredRows": 1,
    "NumberUnselectedRows": 0,
    "LoadBytes": 40888898,
    "LoadTimeMs": 2144,
    "BeginTxnTimeMs": 1,
    "StreamLoadPutTimeMs": 2,
    "ReadDataTimeMs": 325,
    "WriteDataTimeMs": 1933,
    "CommitAndPublishTimeMs": 106,
    "ErrorURL": "http://192.168.1.1:8042/api/_load_error_log?file=__shard_0/error_log_insert_stmt_db18266d4d9b4ee5-abb00ddd64bdf005_db18266d4d9b4ee5_abb00ddd64bdf005"
}
戻り値の各パラメーターを次の表で説明します。
| パラメーター名 | 説明 |
|---|---|
| TxnId | インポートトランザクションの ID です。 |
| Label | -H "label:<label_id>" で指定したインポートジョブのラベルです。 |
| Status | インポートの最終状態です。 - Success:インポートに成功しました。 - Publish Timeout:インポートは完了しましたが、データの可視化が遅れる場合があります。再試行は不要です。 - Label Already Exists:ラベルが重複しています。新しいラベルが必要です。 - Fail:インポートに失敗しました。 |
| ExistingJobStatus | ラベルに対応する既存のインポートジョブの状態です。Status が Label Already Exists の場合にのみ表示されます。このフィールドで既存ラベルのジョブ状態を確認できます。RUNNING は実行中、FINISHED は成功を示します。 |
| Message | インポートエラーメッセージです。 |
| NumberTotalRows | インポートで処理した行の総数です。 |
| NumberLoadedRows | 正常にインポートされた行数です。 |
| NumberFilteredRows | データ品質チェックに合格しなかった行数です。 |
| NumberUnselectedRows | where 条件で除外された行数です。 |
| LoadBytes | インポートされたバイト数です。 |
| LoadTimeMs | インポート完了までの時間(ミリ秒)です。 |
| BeginTxnTimeMs | トランザクション開始を FE に要求するのにかかった時間(ミリ秒)です。 |
| StreamLoadPutTimeMs | インポートデータの実行プランを FE に要求するのにかかった時間(ミリ秒)です。 |
| ReadDataTimeMs | データの読み取りにかかった時間(ミリ秒)です。 |
| WriteDataTimeMs | データの書き込みにかかった時間(ミリ秒)です。 |
| CommitAndPublishTimeMs | トランザクションのコミットと公開を FE に要求するのにかかった時間(ミリ秒)です。 |
| ErrorURL | データ品質の問題がある場合、この URL にアクセスして具体的なエラー行を確認できます。 |
データ品質の問題でインポートに失敗したデータは ErrorURL で確認できます。curl "<ErrorURL>" コマンドでエラーデータの情報を直接表示できます。
インポート例
インポートのタイムアウトと最大サイズの設定
インポートジョブのタイムアウトは秒単位です。設定した timeout 内にジョブが完了しない場合、システムがキャンセルし、ジョブは CANCELLED 状態になります。timeout パラメーターを指定するか、パラメーター stream_load_default_timeout_second を fe.conf に追加して、Stream Load のタイムアウトを調整できます。
インポート前に、ファイルサイズに基づいてタイムアウトを計算します。たとえば 100 GB のファイルを推定 50 MB/s でインポートする場合は、次のようになります。
Import time ~= 100GB / 50MB/s ~= 2048s
次のコマンドは、timeout を 3000 秒に設定して Stream Load のインポートジョブを作成します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "timeout:3000" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
許容するエラー率の上限を設定する
Doris のインポートジョブでは、一部の不正なデータを許容できます。許容率は max_filter_ratio で設定します。デフォルトは 0 で、誤ったデータが 一行でもあるとインポートジョブ全体が失敗します。問題のある行を一部無視するには、このパラメーターに 0 から 1 の値を設定します。Doris は形式が不正な行を自動的にスキップします。許容率の計算方法については、データ変換のドキュメントを参照してください。
次のコマンドは、max_filter_ratio を 0.4 に設定して Stream Load のインポートジョブを作成します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "max_filter_ratio:0.4" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
インポートのフィルター条件を設定する
インポート時に WHERE パラメーターを使用してデータを条件付きでフィルタリングできます。除外されたデータはフィルター率の計算に含まれず、max_filter_ratio の設定にも影響しません。インポート完了後、num_rows_unselected で除外行数を確認できます。
次のコマンドは、WHERE フィルター条件付きの Stream Load インポートジョブを作成します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "where:age>=35" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
指定したパーティションへのインポート
ローカルファイルのデータをテーブルのパーティション p1 と p2 にインポートし、20% のエラー率を許容します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "label:123" \
    -H "Expect:100-continue" \
    -H "max_filter_ratio:0.2" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -H "partitions: p1, p2" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
インポートのタイムゾーンを指定する
DATETIME 関連の型は絶対的な時点のみを表し、タイムゾーン情報を含みません。格納された値は Doris システムのタイムゾーンによって変わりません。そのため、タイムゾーン情報を含むデータはインポート時に統一的に処理され、指定した対象タイムゾーンのデータに変換されます。Doris では、このタイムゾーンはセッション変数 time_zone で表されます。
インポート時の対象タイムゾーンは timezone パラメーターで指定します。タイムゾーン変換時やタイムゾーンに依存する関数の評価時には、この値がセッション変数 time_zone に代わって使用されます。そのため、特別な事情がなければ、インポートトランザクションの timezone は現在の Doris クラスターの time_zone に合わせてください。タイムゾーン付きのすべての時刻データがそのタイムゾーンに変換されます。
たとえば Doris システムのタイムゾーンが +08:00 で、インポートデータの時刻列に 2012-01-01 01:00:00+00:00 と 2015-12-12 12:12:12-08:00 の 二行がある場合、インポートトランザクションで -H "timezone: +08:00" を指定すると、それぞれ 2012-01-01 09:00:00 と 2015-12-13 04:12:12 に変換されます。
タイムゾーンの詳細は、タイムゾーンのドキュメントを参照してください。
ストリームによるインポート
Stream Load は HTTP プロトコルに基づいているため、Java、Go、Python などのプログラムからストリームとしてデータを書き込めます。これが Stream Load という名前の由来です。
次の bash パイプラインコマンドでは、ローカルファイルではなくプログラムで生成したデータをインポートする方法を示します。
seq 1 10 | awk '{OFS="\t"}{print $1, $1 * 10}' | curl --location-trusted -u root -T - http://host:port/api/testDb/testTbl/_stream_load
CSV の先頭行をスキップしてインポートする
ファイルのデータ:
 id,name,age
 1,doris,20
 2,flink,10
format=csv_with_names を指定して、インポート時に先頭行をスキップします。
curl --location-trusted -u root -T test.csv -H "label:1" -H "format:csv_with_names" -H "column_separator:," http://host:port/api/testDb/testTbl/_stream_load
merge_type を使用して Delete 操作を行う
Stream Load には APPEND、DELETE、MERGE の 三つのインポートタイプがあります。merge_type パラメーターで切り替えられます。キーがインポートデータと一致するすべての行を削除するには、次のコマンドを使用します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: DELETE" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
インポート前のテーブルデータが次の場合:
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      3 |        2 | tom      |    2 |
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
インポートデータ:
3,2,tom,0
インポート後、一致した行はテーブルから削除され、結果は次のようになります。
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
merge_type を使用して Merge 操作を行う
merge_type を MERGE に設定すると、インポートデータをテーブルにマージします。MERGE セマンティクスは DELETE 条件と併用する必要があります。DELETE 条件に一致する行は DELETE セマンティクスで処理され、それ以外は APPEND セマンティクスでテーブルに追加されます。たとえば次の操作は、siteid が 1 の行を削除し、残りのデータをテーブルに追加します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: MERGE" \
    -H "delete: siteid=1" \
    -H "column_separator:," \
    -H "columns:user_id,name,age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
インポート前のデータ:
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      5 |        3 | helen    |    3 |
|      1 |        1 | jim      |    2 |
+--------+----------+----------+------+
インポートデータ:
2,1,grace,2
3,2,tom,2
1,1,jim,2
インポート後、siteid = 1 の行は削除され、siteid が 2 と 3 の行がテーブルに追加されます。
+--------+----------+----------+------+
| siteid | citycode | username | pv   |
+--------+----------+----------+------+
|      4 |        3 | bush     |    3 |
|      2 |        1 | grace    |    2 |
|      3 |        2 | tom      |    2 |
|      5 |        3 | helen    |    3 |
+--------+----------+----------+------+
インポート時に Merge 用の Sequence 列を指定する
Unique Key テーブルに Sequence 列を設定すると、同じキー列内では、その値を基準に REPLACE 集約関数による置換順序が決まり、大きい値で小さい値を置換できます。このようなテーブルで DORIS_DELETE_SIGN に基づいて削除をマークする場合は、キーが同じで、Sequence 列の値が現在の値以上である必要があります。function_column.sequence_col パラメーターを merge_type: DELETE とともに指定すると、削除操作を実行できます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "merge_type: DELETE" \
    -H "function_column.sequence_col: age" \
    -H "column_separator:," \
    -H "columns: name, gender, age" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
テーブルの構造が次の場合:
mysql> SET show_hidden_columns=true;
Query OK, 0 rows affected (0.00 sec)

mysql> DESC table1;
+------------------------+--------------+------+-------+---------+---------+
| Field                  | Type         | Null | Key   | Default | Extra   |
+------------------------+--------------+------+-------+---------+---------+
| name                   | VARCHAR(100) | No   | true  | NULL    |         |
| gender                 | VARCHAR(10)  | Yes  | false | NULL    | REPLACE |
| age                    | INT          | Yes  | false | NULL    | REPLACE |
| __DORIS_DELETE_SIGN__  | TINYINT      | No   | false | 0       | REPLACE |
| __DORIS_SEQUENCE_COL__ | INT          | Yes  | false | NULL    | REPLACE |
+------------------------+--------------+------+-------+---------+---------+
4 rows in set (0.00 sec)
元のテーブルのデータが次の場合:
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| li    | male   |   10 |
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
1. Sequence パラメーターが有効になる場合:インポートする Sequence 列の値がテーブル内の既存値以上
インポートデータ:
li,male,10
function_column.sequence_col: age が指定され、age がテーブル内の既存値以上であるため、元の行は削除され、テーブルのデータは次のようになります。
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
2. Sequence パラメーターが有効にならない場合:インポートする Sequence 列の値がテーブル内の既存値以下
インポートデータ:
li,male,9
function_column.sequence_col: age は指定されていますが、age がテーブル内の既存値より小さいため、DELETE 操作は有効になりません。テーブルのデータは変わらず、主キーが li の行は引き続き表示されます。
+-------+--------+------+
| name  | gender | age  |
+-------+--------+------+
| li    | male   |   10 |
| wang  | male   |   14 |
| zhang | male   |   12 |
+-------+--------+------+
この行が削除されないのは、内部の依存関係を処理する際、システムがまず同じキーの行を確認し、Sequence 列の値が大きい行を外部に公開した後、その行の DORIS_DELETE_SIGN が 1 かどうかを確認するためです。1 なら外部からは見えず、0 なら引き続き読み取れます。
囲み文字を含むデータのインポート
CSV データに区切り文字や列区切り文字が含まれる場合、データが意図せず分割されないように、シングルバイトの囲み文字を指定できます。
次のデータでは、列に区切り文字 , が含まれています。
Zhang San,30,'Shanghai City, Huangpu District, Dagu Road'
囲み文字 ' を指定すると、"Shanghai City, Huangpu District, Dagu Road" を 一つのフィールドとして扱えます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "enclose:'" \
    -H "columns:username,age,address" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
フィールド内にも囲み文字がある場合、たとえば "Shanghai City, Huangpu District, 'Dagu Road" を 一つのフィールドとして扱うには、先に列内のその文字をエスケープします。
Zhang San,30,'Shanghai City, Huangpu District, \'Dagu Road'
escape パラメーターでは、次の例の \ のような シングルバイトのエスケープ文字を指定できます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:," \
    -H "enclose:'" \
    -H "escape:\\" \
    -H "columns:username,age,address" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
DEFAULT CURRENT_TIMESTAMP フィールドを持つテーブルへのインポート
次の例では、DEFAULT CURRENT_TIMESTAMP を持つフィールドを含むテーブルにデータをインポートします。
テーブルスキーマ:
CREATE TABLE testDb.testTbl (
    `id` BIGINT(30) NOT NULL,
    `order_code` VARCHAR(30) DEFAULT NULL COMMENT '',
    `create_time` DATETIMEv2(3) DEFAULT CURRENT_TIMESTAMP
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 10;
JSON データ形式:
{"id":1,"order_Code":"avc"}
インポートコマンド:
curl --location-trusted -u root -T test.json -H "label:1" -H "format:json" -H 'columns: id, order_code, create_time=CURRENT_TIMESTAMP()' http://host:port/api/testDb/testTbl/_stream_load
単純モードでの JSON データのインポート
JSON のフィールドとテーブルの列名が 一対一 で対応する場合は、"strip_outer_array:true" と "format:json" を指定して JSON データをテーブルにインポートできます。
たとえば、テーブルを次のように定義します。
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
インポートデータのフィールド名は、テーブルのフィールド名と 一対一 で対応しています。
[
{"user_id":1,"name":"Emily","age":25},
{"user_id":2,"name":"Benjamin","age":35},
{"user_id":3,"name":"Olivia","age":28},
{"user_id":4,"name":"Alexander","age":60},
{"user_id":5,"name":"Ava","age":17},
{"user_id":6,"name":"William","age":69},
{"user_id":7,"name":"Sophia","age":32},
{"user_id":8,"name":"James","age":64},
{"user_id":9,"name":"Emma","age":37},
{"user_id":10,"name":"Liam","age":64}
]
次のコマンドで JSON データをテーブルにインポートできます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
マッチングモードでの複雑な JSON データのインポート
JSON データが複雑でテーブルの列名と 一対一 で対応しない場合や、余分な列がある場合は、jsonpaths パラメーターで列名をマッピングしてインポートできます。たとえば次のデータの場合:
[
{"userid":1,"hudi":"lala","username":"Emily","userage":25,"userhp":101},
{"userid":2,"hudi":"kpkp","username":"Benjamin","userage":35,"userhp":102},
{"userid":3,"hudi":"ji","username":"Olivia","userage":28,"userhp":103},
{"userid":4,"hudi":"popo","username":"Alexander","userage":60,"userhp":103},
{"userid":5,"hudi":"uio","username":"Ava","userage":17,"userhp":104},
{"userid":6,"hudi":"lkj","username":"William","userage":69,"userhp":105},
{"userid":7,"hudi":"komf","username":"Sophia","userage":32,"userhp":106},
{"userid":8,"hudi":"mki","username":"James","userage":64,"userhp":107},
{"userid":9,"hudi":"hjk","username":"Emma","userage":37,"userhp":108},
{"userid":10,"hudi":"hua","username":"Liam","userage":64,"userhp":109}
]
jsonpaths パラメーターを指定すると、対象の列を照合できます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
    -H "columns:user_id,name,age" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
インポートする JSON のルートノードを指定する
JSON データに入れ子の JSON フィールドが含まれる場合は、インポートする JSON のルートノードを指定する必要があります。デフォルト値は "" です。
次のデータでは、comment 列内のデータをテーブルにインポートします。
[
    {"user":1,"comment":{"userid":101,"username":"Emily","userage":25}},
    {"user":2,"comment":{"userid":102,"username":"Benjamin","userage":35}},
    {"user":3,"comment":{"userid":103,"username":"Olivia","userage":28}},
    {"user":4,"comment":{"userid":104,"username":"Alexander","userage":60}},
    {"user":5,"comment":{"userid":105,"username":"Ava","userage":17}},
    {"user":6,"comment":{"userid":106,"username":"William","userage":69}},
    {"user":7,"comment":{"userid":107,"username":"Sophia","userage":32}},
    {"user":8,"comment":{"userid":108,"username":"James","userage":64}},
    {"user":9,"comment":{"userid":109,"username":"Emma","userage":37}},
    {"user":10,"comment":{"userid":110,"username":"Liam","userage":64}}
    ]
まず json_root パラメーターでルートノードを comment に設定し、次に jsonpaths パラメーターで列名のマッピングを指定します。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format:json" \
    -H "strip_outer_array:true" \
    -H "json_root: $.comment" \
    -H "jsonpaths:[\"$.userid\", \"$.username\", \"$.userage\"]" \
    -H "columns:user_id,name,age" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Array 型のデータのインポート
次のデータには Array 型が含まれます。
1|Emily|[1,2,3,4]
2|Benjamin|[22,45,90,12]
3|Olivia|[23,16,19,16]
4|Alexander|[123,234,456]
5|Ava|[12,15,789]
6|William|[57,68,97]
7|Sophia|[46,47,49]
8|James|[110,127,128]
9|Emma|[19,18,123,446]
10|Liam|[89,87,96,12]
次のテーブルスキーマにデータをインポートします。
CREATE TABLE testdb.test_streamload(
    typ_id     BIGINT          NOT NULL COMMENT "ID",
    name       VARCHAR(20)     NULL     COMMENT "name",
    arr        ARRAY<int(10)>  NULL     COMMENT "array"
)
DUPLICATE KEY(typ_id)
DISTRIBUTED BY HASH(typ_id) BUCKETS 10;
Stream Load ジョブを使用すると、テキストファイルから ARRAY 型をテーブルに直接インポートできます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "column_separator:|" \
    -H "columns:typ_id,name,arr" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Map 型のデータのインポート
インポートデータに Map 型が含まれる例を次に示します。
[
{"user_id":1,"namemap":{"Emily":101,"age":25}},
{"user_id":2,"namemap":{"Benjamin":102,"age":35}},
{"user_id":3,"namemap":{"Olivia":103,"age":28}},
{"user_id":4,"namemap":{"Alexander":104,"age":60}},
{"user_id":5,"namemap":{"Ava":105,"age":17}},
{"user_id":6,"namemap":{"William":106,"age":69}},
{"user_id":7,"namemap":{"Sophia":107,"age":32}},
{"user_id":8,"namemap":{"James":108,"age":64}},
{"user_id":9,"namemap":{"Emma":109,"age":37}},
{"user_id":10,"namemap":{"Liam":110,"age":64}}
]
次のテーブルスキーマにデータをインポートします。
CREATE TABLE testdb.test_streamload(
    user_id            BIGINT       NOT NULL COMMENT "ID",
    namemap            Map<STRING, INT>  NULL     COMMENT "namemap"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
Stream Load ジョブを使用すると、テキストファイルから Map 型をテーブルに直接インポートできます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "format: json" \
    -H "strip_outer_array:true" \
    -T streamload_example.json \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
Bitmap 型のデータのインポート
インポート時に Bitmap 型のデータがある場合、to_bitmap でデータを Bitmap に変換するか、bitmap_empty 関数で Bitmap を設定できます。
たとえば、インポートデータが次の場合:
1|koga|17723
2|nijg|146285
3|lojn|347890
4|lofn|489871
5|jfin|545679
6|kon|676724
7|nhga|767689
8|nfubg|879878
9|huang|969798
10|buag|97997
Bitmap 型を含む次のテーブルにデータをインポートします。
CREATE TABLE testdb.test_streamload(
    typ_id     BIGINT                NULL   COMMENT "ID",
    hou        VARCHAR(10)           NULL   COMMENT "one",
    arr        BITMAP  BITMAP_UNION  NOT NULL   COMMENT "two"
)
AGGREGATE KEY(typ_id,hou)
DISTRIBUTED BY HASH(typ_id,hou) BUCKETS 10;
to_bitmap を使用してデータを Bitmap 型に変換できます。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "Expect:100-continue" \
    -H "columns:typ_id,hou,arr,arr=to_bitmap(arr)" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
HLL 型のデータのインポート
hll_hash 関数でデータを HLL 型に変換できます。次のデータを例にします。
1001|koga
1002|nijg
1003|lojn
1004|lofn
1005|jfin
1006|kon
1007|nhga
1008|nfubg
1009|huang
1010|buag
次のテーブルにインポートします。
CREATE TABLE testdb.test_streamload(
    typ_id           BIGINT          NULL   COMMENT "ID",
    typ_name         VARCHAR(10)     NULL   COMMENT "NAME",
    pv               hll hll_union   NOT NULL   COMMENT "hll"
)
AGGREGATE KEY(typ_id,typ_name)
DISTRIBUTED BY HASH(typ_id) BUCKETS 10;
hll_hash 関数を使用してインポートします。
curl --location-trusted -u <doris_user>:<doris_password> \
    -H "column_separator:|" \
    -H "columns:typ_id,typ_name,pv=hll_hash(typ_id)" \
    -T streamload_example.csv \
    -XPUT http://<fe_ip>:<fe_http_port>/api/testdb/test_streamload/_stream_load
列のマッピング、派生列、フィルタリング
Doris はインポートステートメントで多様な列変換とフィルタリング操作に対応しており、ほとんどの組み込み関数を使用できます。この機能の使用方法については、データ変換のドキュメントを参照してください。
厳格モードを有効にしてインポートする
strict_mode プロパティでインポートジョブを厳格モードで実行するかどうかを設定します。このプロパティは列のマッピング、変換、フィルタリングの結果に影響します。詳しくは厳格モードのドキュメントを参照してください。
インポート時に部分列更新または柔軟な部分列更新を行う
インポート時の部分列更新の指定方法については、列の更新のドキュメントを参照してください。
FAQ
Stream Load を手動でキャンセルできますか?
できません。Stream Load がタイムアウトするかインポートエラーが発生すると、システムが自動的にキャンセルします。実行中のジョブをユーザーが手動でキャンセルすることはできません。
Stream Load の単一ファイルにサイズ制限はありますか?
単一のインポートファイルは 10 GB 以下にすることを推奨します。大きなファイルは分割してからインポートしてください。また、BE 設定パラメーター streaming_load_max_mb を調整して 一回のインポートの上限を引き上げるか、Doris Streamloader による並列インポートで性能を向上させることもできます。
Stream Load のジョブ履歴を確認するには?
デフォルトでは、システムは Stream Load のジョブ履歴を記録しません。enable_stream_load_record=true を be.conf に設定して再起動した後、show stream load from <db> で履歴を確認できます。
「Label Already Exists」エラーにはどう対処しますか?
このエラーは、同じラベルがすでに使用されていることを示します。レスポンスの ExistingJobStatus フィールドで既存ジョブの状態を確認できます。
RUNNING:ジョブは実行中です。完了を待ってください。FINISHED:ジョブは正常に完了しています。再試行は不要です。- CANCELLED の場合は、同じラベルで新しいインポートを開始できます。
At-Most-Once セマンティクスを保証し、重複インポートを避けるため、同じデータバッチには常に同じラベルを使用することを推奨します。
データ形式エラーでインポートが失敗した場合は?
次の手順で問題を特定し、対処できます。
- レスポンスの
ErrorURLフィールドから具体的なエラー行を確認します:curl "<ErrorURL>"。 max_filter_ratio(範囲は 0 から 1)を適切に引き上げ、一部の不正データを許容します。- CSV の NULL 値(
\N)と空文字列(二つの区切り文字の間に文字がないもの)が正しく使用されているか確認します。 - 列区切り文字、行区切り文字、囲み文字(
enclose)、エスケープ文字(escape)の設定が実際のファイル内容と一致するか確認します。
インポートのタイムアウト(CANCELLED)にはどう対処しますか?
データ量に基づいて適切なタイムアウトを見積もります。
Import time ~= File size / Estimated import speed (for example, 50MB/s)
タイムアウトは次の 二つの方法で調整できます。
- 個別のインポート:ヘッダーパラメーター
-H "timeout:3000"を使用します。 - グローバル:FE パラメーター
stream_load_default_timeout_secondを調整します。
CSV で NULL 値と空文字列を区別するには?
| 種類 | 表記 | 例 | 中央の列の意味 |
|---|---|---|---|
| NULL 値 | \N を使用 | a,\N,b | 中央の列は NULL |
| 空文字列 | 二つの区切り文字の間に文字がない | a,,b | 中央の列は空文字列 |