Doris Operator のライフサイクル管理
Doris Operator は Reconcile ループを通じて Doris クラスターを管理します。Doris のカスタムリソースが変更されると、Operator は新しい望ましい状態に合わせて配下の Kubernetes リソースを更新し、必要に応じて Doris のメタデータに関する操作を実行します。
この文書では、これらの変更に伴う運用上の動作を説明します。
クラスターの作成
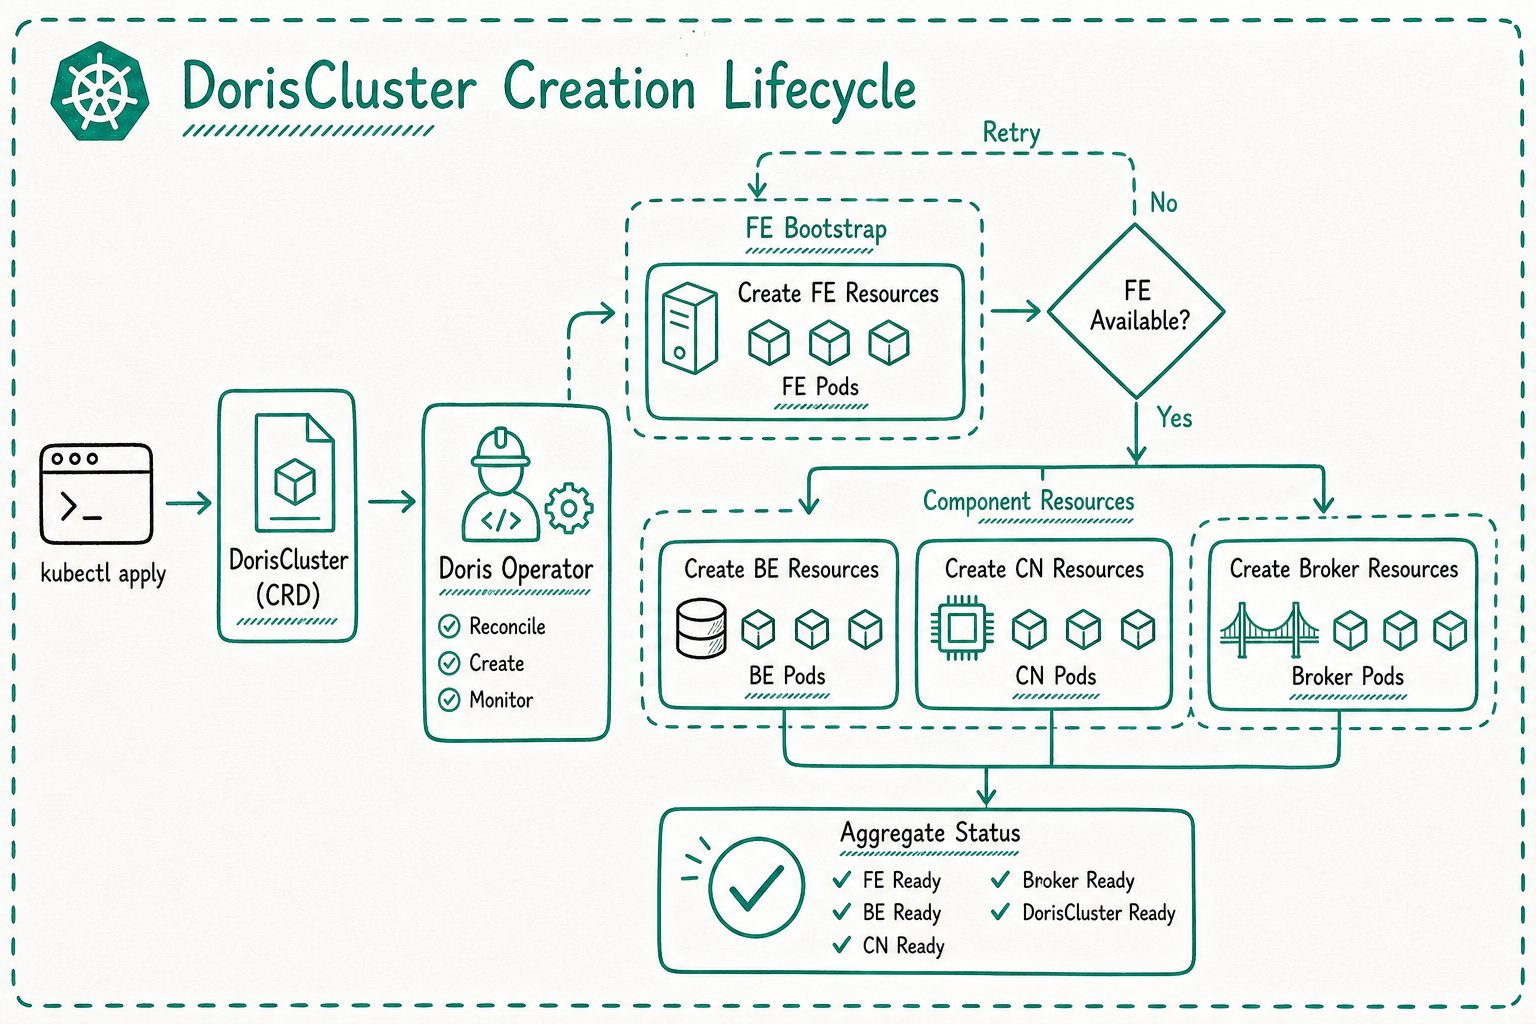
DorisCluster または DorisDisaggregatedCluster を作成すると、Operator はリソース内のコンポーネント設定に従って、配下の Kubernetes リソースを作成します。
ストレージ・コンピュート一体型クラスターでは、通常 FE が最初に作成されます。
ストレージ・コンピュート分離型クラスターでは、MetaService が最初に作成されます。
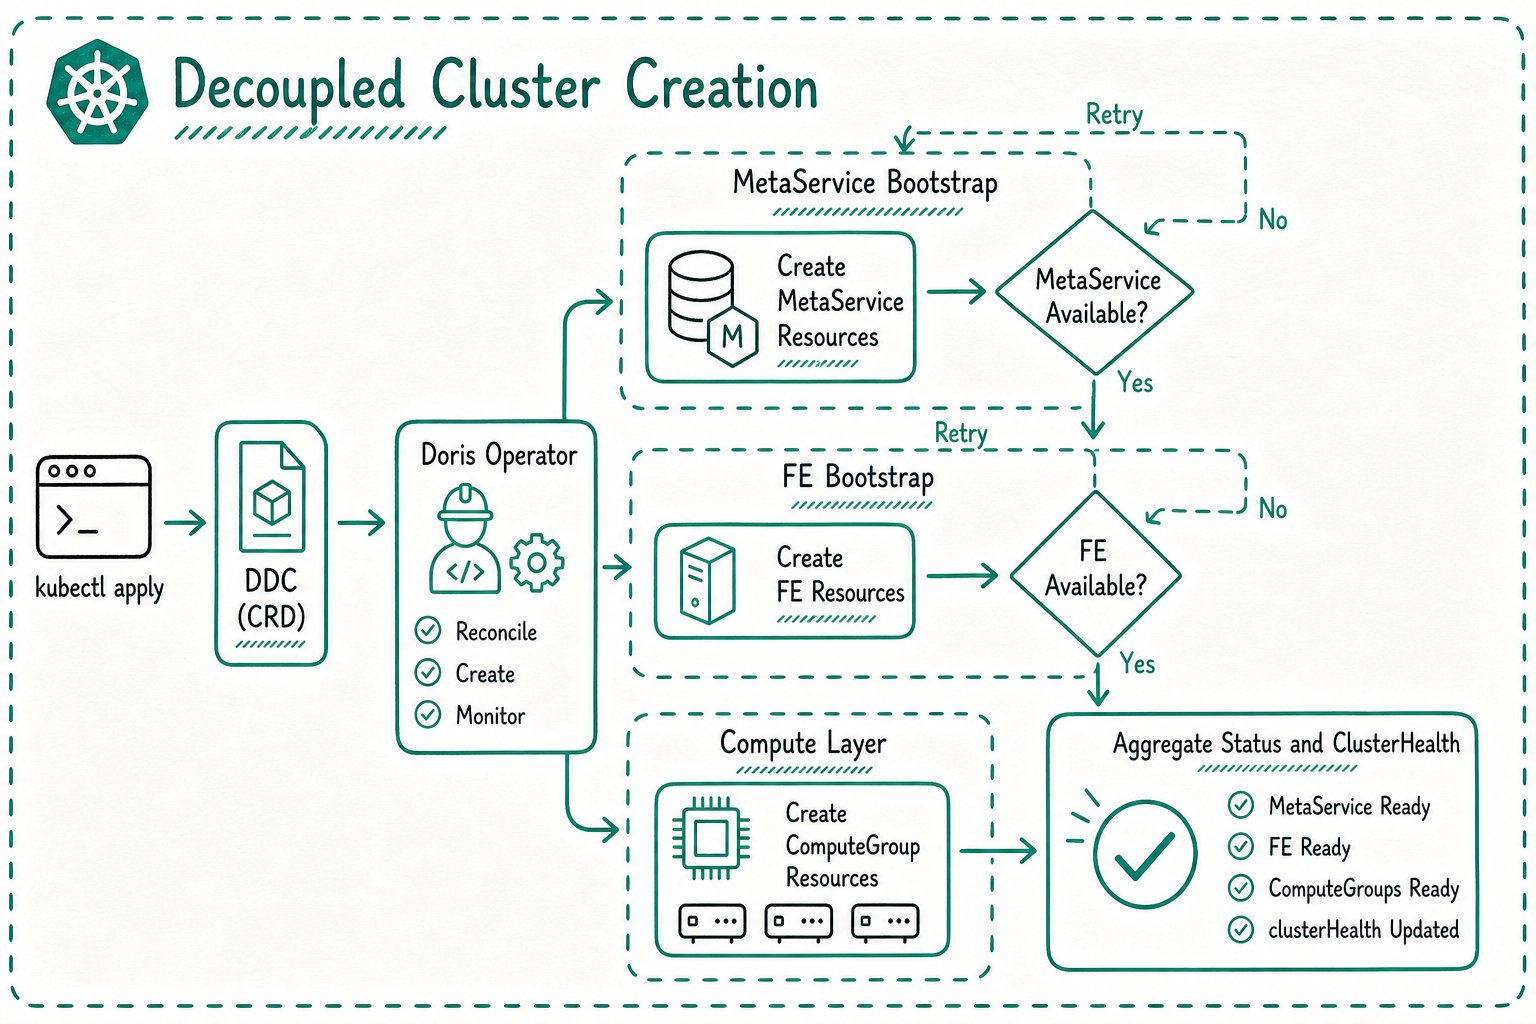
依存するリソースの準備ができていない場合、Operator は待機し、後続の Reconcile ループで再試行します。
スケールアウト
スケールアウトは通常、コンポーネントの replicas フィールドを増やして行います。次に例を示します。
spec:
  beSpec:
    replicas: 5
Operator が変更を検出すると、対応する StatefulSet を更新します。Kubernetes が新しい Pod を作成し、Operator は準備状態の確認と CR の status の更新を続けます。
ストレージ・コンピュート分離型クラスターでも、ComputeGroup のスケールアウトは同じ方法で行います。
spec:
  computeGroups:
    - uniqueId: adhoc-query
      replicas: 5
次の点に注意してください。
- クラスターに十分な CPU、メモリ、ストレージがあるか。
- 新しい Pod をスケジューリングできるか。
- PVC をバインドできるか。
- 新しいノードを Doris クラスターに登録できるか。
スケールイン
スケールインは、データのレプリカ、メタデータのクォーラム、ノードのロール、サービスの処理能力に影響する可能性があるため、スケールアウトよりリスクが高くなります。
本番クラスターをスケールインする前に、Doris のレプリカの状態、業務トラフィック、ロールバック手段を確認してください。
ストレージ・コンピュート一体型クラスター
スケールインのリスクはコンポーネントによって異なります。
| コンポーネント | 主な注意点 |
|---|---|
| FE | Follower と Observer のロールがメタデータのクォーラムに影響する可能性がある |
| BE | レプリカの移行とデータの可用性を考慮する必要がある |
| CN | データのレプリカはないが、スケールインは計算能力とキャッシュに影響する |
| Broker | 外部アクセスを伴うタスクが引き続き依存していないか確認する |
FE のレプリカ数は選挙ノードの数より少なくできません。このモードでスケールインする際は、クラスターのトポロジーと Doris 側のリスクをそれぞれ評価してください。
ストレージ・コンピュート分離型クラスター
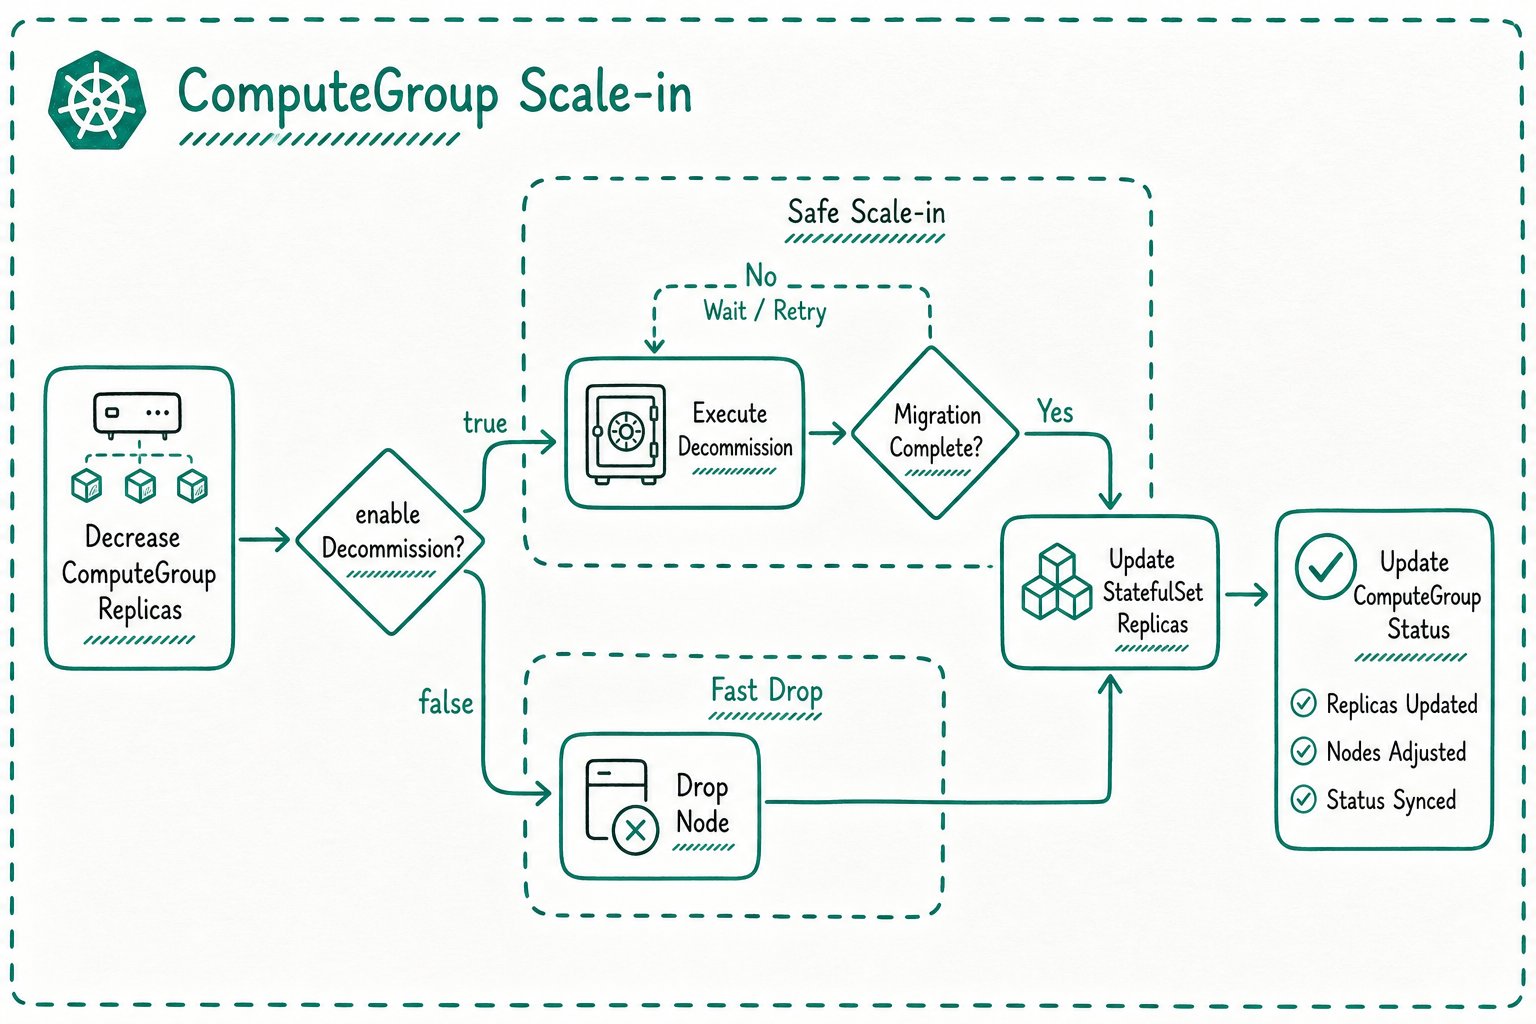
ComputeGroup をスケールインするときは、Doris のメタデータに関する操作が必要になる場合があります。動作は enableDecommission の設定によって異なります。
| 設定 | 動作 |
|---|---|
enableDecommission: true | スケールイン前にデコミッションを実行し、安全に削除できるまで待つ |
enableDecommission: false | 対応するノードを直接削除する |
スケールインする前に、現在のデータ分布と業務トラフィックを確認してください。
設定変更
Doris の起動設定は通常 ConfigMap を通じてマウントされます。変更時に再起動が必要かどうかは、設定の種類と Operator の設定によって異なります。
ストレージ・コンピュート一体型クラスターの場合は、次のように設定します。
spec:
  enableRestartWhenConfigChange: true
この設定を有効にすると、主要な ConfigMap の変更によってローリング再起動が始まる場合があります。
設定を変更するときは、次の点を確認してください。
- ConfigMap のキーが
fe.confなど、コンポーネントの要件に合っているか。 - 設定したディレクトリが PVC のマウントパスと一致しているか。
- ポート、FQDN、認証の設定が Kubernetes のネットワークモデルに合っているか。
- 変更がコンポーネントの再起動後にのみ反映されるか。
ローリングアップデート
コンポーネントのイメージ、一部の Pod テンプレートフィールド、設定ハッシュを変更すると、StatefulSet のローリングアップデートが始まる場合があります。
推奨される手順は次のとおりです。
- トラフィックの少ない時間帯にアップデートを実施する。
- 事前に、クラスターに未解決の障害がないことを確認する。
- クライアントの再試行動作を確認する。
- アップグレードの順序については、Doris のバージョンアップグレードに関する文書に従う。
クラスターの削除
Doris のカスタムリソースが削除されると、Operator はクリーンアップ処理に入り、管理対象の Kubernetes リソースを削除します。
削除する前に、次の点を確認してください。
- PVC を保持する必要があるか。
- オブジェクトストレージ、FoundationDB、その他の外部依存サービスが共有されているか。
- データとメタデータのバックアップが必要か。
- クライアントがまだ接続しているか。
CR を削除すると、対応する Kubernetes リソースが削除される場合があります。実行前にクリーンアップの対象範囲とバックアップ方針を確認してください。
ライフサイクル操作の確認
ライフサイクル操作が完了したかどうかは、CR の status、Kubernetes リソースの状態、Doris コンポーネントの状態を合わせて判断してください。
kubectl get dcr -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
kubectl get ddc -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
kubectl get pod,sts,svc,pvc -n ${namespace}
状態が長時間収束しない場合は、Operator のログと Kubernetes Events を調べ、原因がスケジューリング、ストレージのバインド、設定のマウント、ノードの登録、Doris のメタデータ操作のいずれにあるか確認してください。