分析関数
要点 Apache Doris の分析関数(ウィンドウ関数)は、
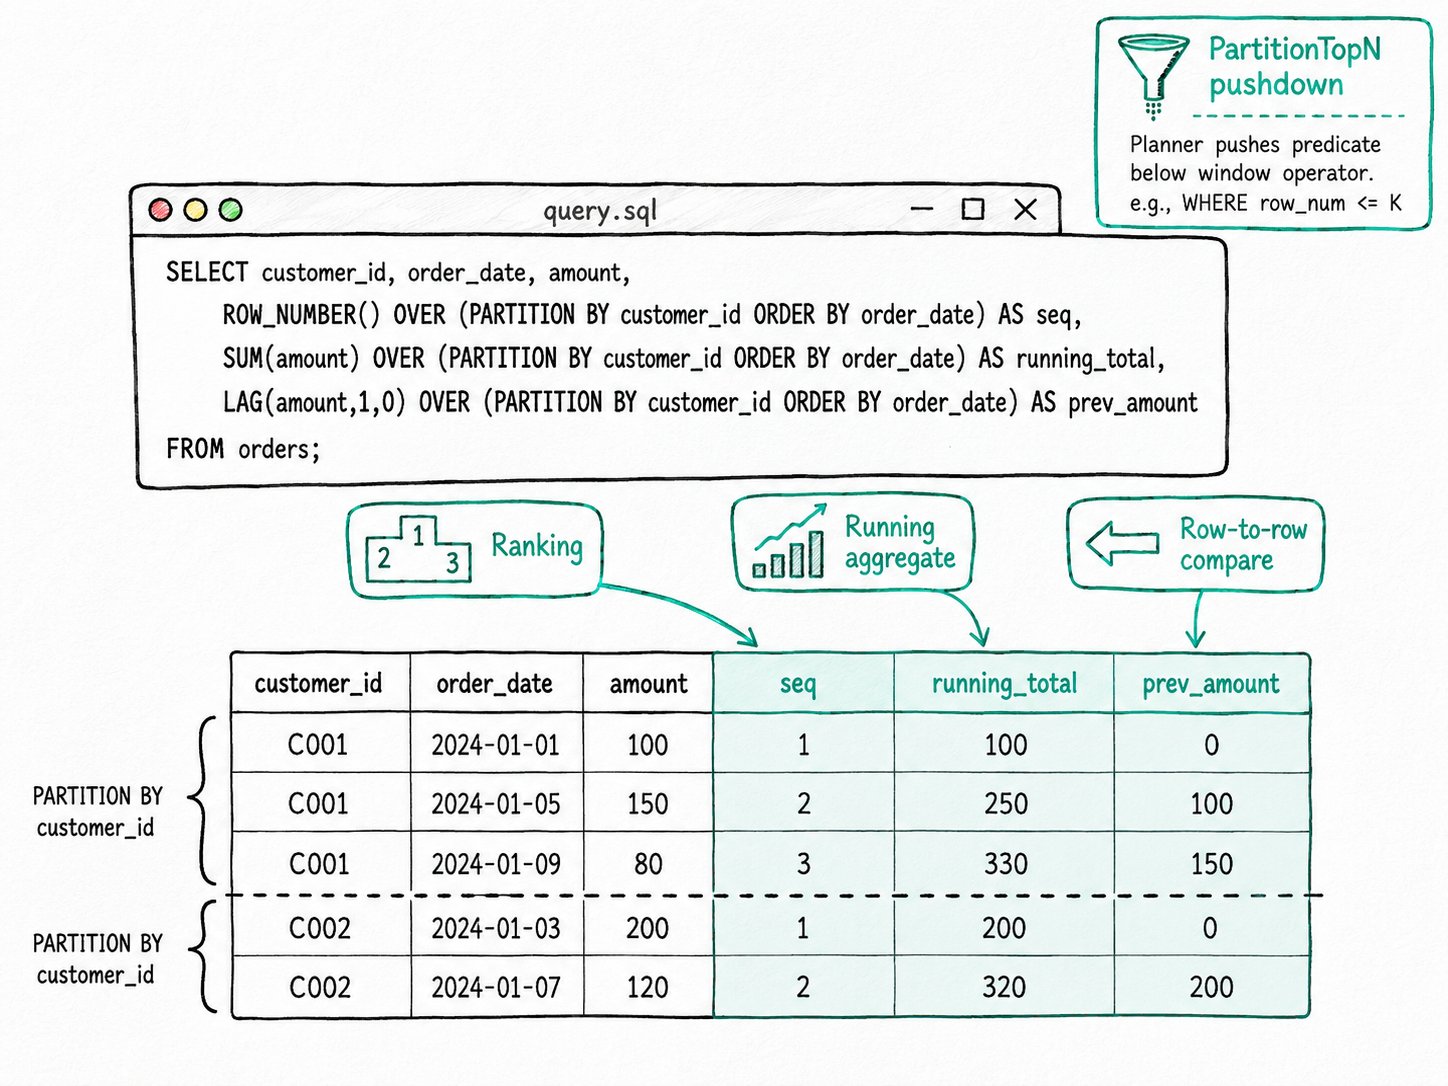
GROUP BYのように行をまとめずに、結果セットの各行について値を計算します。Apache Doris は標準的な関数であるROW_NUMBER、RANK、DENSE_RANK、NTILE、LAG、LEAD、FIRST_VALUE、LAST_VALUE、NTH_VALUE、PERCENT_RANK、CUME_DISTに加え、SUM、AVG、COUNT、MIN、MAXなど、OVERとともに使用するすべての集約関数をサポートします。Nereids オプティマイザーはWHERE row_num <= Kを、パーティションを考慮したウィンドウ演算子の下の Top-N に書き換えます。そのため、「カテゴリごとの上位 10 件」を求めるクエリでパーティション全体をソートする必要がありません。
Apache Doris で分析関数を使う理由
Apache Doris の分析関数は、ほぼすべての分析ワークロードに現れる、GROUP BY だけでは答えられない次の三つの問いに対応します。
- 「顧客ごとに注文へ時系列順の番号を振り、最初の 10 件を残したい。」
(customer_id, order_date)で自己結合しても実現できますが、テーブルを二回読み取ることになります。 - 「日ごとの売上の累積合計と 7 日移動平均を知りたい。」
GROUP BYでは、表示したい個々の行がまとめられてしまいます。 - 「各行を前の行と比較したい。」前年比、前期比、イベント間の間隔などは LAG/LEAD を使う典型的な処理です。ウィンドウ関数を使わない場合、プランナーが最適化できないオフセット条件付きの自己結合が必要になります。
Apache Doris の分析関数なら、自己結合を使わず、元の行を保持したまま、一回のデータ走査でこれらすべてに対応できます。
Apache Doris の分析関数とは
Apache Doris の分析関数は、各入力行について、OVER 句で定義された関連行の ウィンドウ にわたって値を計算する SQL 関数です。ウィンドウはパーティション全体、現在の行の前後の固定範囲、またはその中間の範囲にできます。出力の行数は入力と同じです。
function(args) OVER ( [PARTITION BY ...] [ORDER BY ...] [<frame>] )
主な用語
OVER句:通常の集約関数ではなく、ウィンドウ関数として呼び出すことを Apache Doris に示します。必須です。PARTITION BY:入力を独立したグループに分けます。各パーティションは個別に計算されます。テーブルのパーティションとは異なり、実行時の概念です。ORDER BY(OVER内):各パーティション内の行を並べます。LAG、LEAD、ROW_NUMBER、RANK、およびPRECEDING/FOLLOWINGを使うウィンドウフレームで必要です。- ウィンドウフレーム:現在の行について関数が参照する、パーティション内の範囲です。Apache Doris は
ROWS BETWEEN ... PRECEDING/FOLLOWING/CURRENT ROW/UNBOUNDED ...と、制限付きのRANGEをサポートします。 - PartitionTopN:
WHERE rank <= Kフィルターに各パーティションの上位 K 行だけが必要だと証明できる場合、プランナーが挿入する内部演算子です。参照元:CreatePartitionTopNFromWindow.java。
Apache Doris の分析関数の仕組み
Apache Doris の分析関数は、計画、シャッフル、ソート、評価、プッシュダウンという五段階のパイプラインで実行されます。
- 計画。 オプティマイザーは
OVER句をWindowExpressionに解析し、フレームを正規化し(CheckAndStandardizeWindowFunctionAndFrame)、同じPARTITION BYとORDER BYを共有するウィンドウ関数の呼び出しを一つの物理ウィンドウ演算子にまとめます。同じパーティションと並び順を共有する呼び出しでは、追加のソートは発生しません。 - パーティションごとのシャッフル。
PARTITION BYがある場合、エンジンは同じパーティションのすべての行が同じバックエンドに集まるようにシャッフルします。PARTITION BYがない場合、ウィンドウ全体が一つのパイプラインで実行されます(並列度の上限になります)。 - パーティション内でのソート。 各バックエンドは、
ORDER BY列でパーティション内の行をソートします。ORDER BYが一意でなければ、同値の行の順序は非決定的です。そのため、ドキュメントではSUM() OVER (ORDER BY date_col)が同じ日付の行に対して実行ごとに異なる結果を返し得ると注意しています。 - 行ごとの評価。 Apache Doris は各パーティションを一回走査しながら、ウィンドウフレームを管理します。順位付け関数は各行に整数を一つ出力し、
ROWS UNBOUNDED PRECEDINGを使う集約関数は累積合計を保持します。スライディングウィンドウ集約では新しい行を加え、範囲から外れた行を除きます。 - フィルターと Top-N のプッシュダウン。
CreatePartitionTopNFromWindowはWHERE row_number() OVER (PARTITION BY a ORDER BY b) <= Kをウィンドウの下にあるPartitionTopN(K)演算子に変換します。そのため、各パーティションでは上位 K 行だけがウィンドウ演算子に渡されます。PushDownFilterThroughWindowはPARTITION BY列に対するフィルターをウィンドウより前に移動し、Apache Doris がソート後ではなくソート前にフィルタリングできるようにします。
クイックスタート
CREATE TABLE orders (
  customer_id INT, order_date DATE, amount DECIMAL(10,2)
) DISTRIBUTED BY HASH(customer_id) BUCKETS 4
PROPERTIES ("replication_num" = "1");

INSERT INTO orders VALUES
  (1,'2026-04-30',50),(1,'2026-05-01',80),(1,'2026-05-02',30),
  (2,'2026-04-30',20),(2,'2026-05-01',90);

SELECT customer_id, order_date, amount,
       ROW_NUMBER() OVER (PARTITION BY customer_id ORDER BY order_date) AS seq,
       SUM(amount)  OVER (PARTITION BY customer_id ORDER BY order_date) AS running_total,
       LAG(amount,1,0) OVER (PARTITION BY customer_id ORDER BY order_date) AS prev_amount
FROM orders;
期待される結果
+-------------+------------+--------+-----+---------------+-------------+
| customer_id | order_date | amount | seq | running_total | prev_amount |
+-------------+------------+--------+-----+---------------+-------------+
|           1 | 2026-04-30 |     50 |   1 |            50 |           0 |
|           1 | 2026-05-01 |     80 |   2 |           130 |          50 |
|           1 | 2026-05-02 |     30 |   3 |           160 |          80 |
|           2 | 2026-04-30 |     20 |   1 |            20 |           0 |
|           2 | 2026-05-01 |     90 |   2 |           110 |          20 |
+-------------+------------+--------+-----+---------------+-------------+
一回の走査で三つのウィンドウ列を計算し、自己結合は不要です。元の五行は保持されます。LAG(..., 1, 0) は各パーティションの最初の行に対して 0 を返し、NULL にはなりません。
Apache Doris の分析関数を使う場面
Apache Doris の分析関数は、グループごとの Top-N、累積合計、移動平均、LAG/LEAD による比較、パーセンタイルの区分分け、全体に対する割合など、隣接する行に依存しつつ元の行を保持する計算に適しています。
適している用途
- グループごとの Top-N:「顧客ごとの上位 10 件の注文」「地域ごとの売上上位の商品」など。
WHERE rn <= 10フィルターを追加すると、Apache Doris はパーティションごとの Top-N をウィンドウの下にプッシュダウンします。 ROWS BETWEEN n PRECEDING AND m FOLLOWINGを使う累積合計、移動平均、中央移動平均。LAGとLEADを使う前年比、前日比、イベント間の間隔の分析。テーブルを一回走査することで自己結合を置き換えられます。NTILEを使う、パーセンタイルや四分位数のレポート向けの区分分け。- 行ごとの値とパーティション全体の合計を組み合わせるレポートクエリ。例:
amount / SUM(amount) OVER (PARTITION BY region) AS share_of_region。
適していない用途
- 行をまとめるだけの集約。
SELECT category, SUM(amount) FROM t GROUP BY categoryは、ソートも全行をメモリに保持することもなく、必要な処理を行えます。まずGROUP BYを使い、集約前の列も必要な場合にだけOVERに切り替えます。 - 数値オフセットを指定する
RANGEフレーム。たとえばRANGE BETWEEN 5 PRECEDING AND CURRENT ROWです。Apache Doris のRANGEフレームでは境界をUNBOUNDEDまたはCURRENT ROWに限定しており、任意のRANGE n PRECEDING/FOLLOWINGはサポートしません。数値オフセットが必要な場合はROWSを使用します。 PARTITION BYのないウィンドウ。結果セット全体が一つのパイプラインに集まり、大きな入力ではそのパイプラインがボトルネックになります。ワークロードで可能な場合はパーティションキーを追加します。- 決定的な出力が必要な場合の、一意でない列による
ORDER BY。同じ日付の行が複数ある場合、SUM(x) OVER (ORDER BY day)は実行ごとに異なる累積合計を返すことがあります。並び順を確定する列を追加してください。詳しくは ウィンドウ関数の概要 を参照してください。 - 更新のたびに同じウィンドウの結果を再計算する場合。更新頻度の低いテーブルに対して同じ
ROW_NUMBER()クエリを毎分実行する場合は、毎回ウィンドウ計算を行うよりも、部分更新を行う非同期マテリアライズドビューの方が低コストです。
関連ドキュメント
- 分析関数(ウィンドウ関数):実例を含む詳細ガイド
- ウィンドウ関数の概要:構文、フレーム句、一意の並び順に関する注意点
LAG、LEAD、ROW_NUMBER、RANK、NTILE:各関数のリファレンスページ- パイプライン実行エンジン:パーティション化されたウィンドウを BE 間で並列実行する仕組み
- ベクトル化実行:各ウィンドウのバッチを SIMD で高速化された演算子で処理するエンジン。
- 非同期マテリアライズドビュー:毎分繰り返し実行されるウィンドウ計算の結果を事前計算
- MPP アーキテクチャ:ウィンドウ/分析演算子を BE 間でシャッフルし、パーティション化する仕組み。
