バッチロード
要点 Apache Doris のバッチロードは、S3、HDFS、または別のデータウェアハウスにある大きなファイルを一度に Doris に取り込みます。
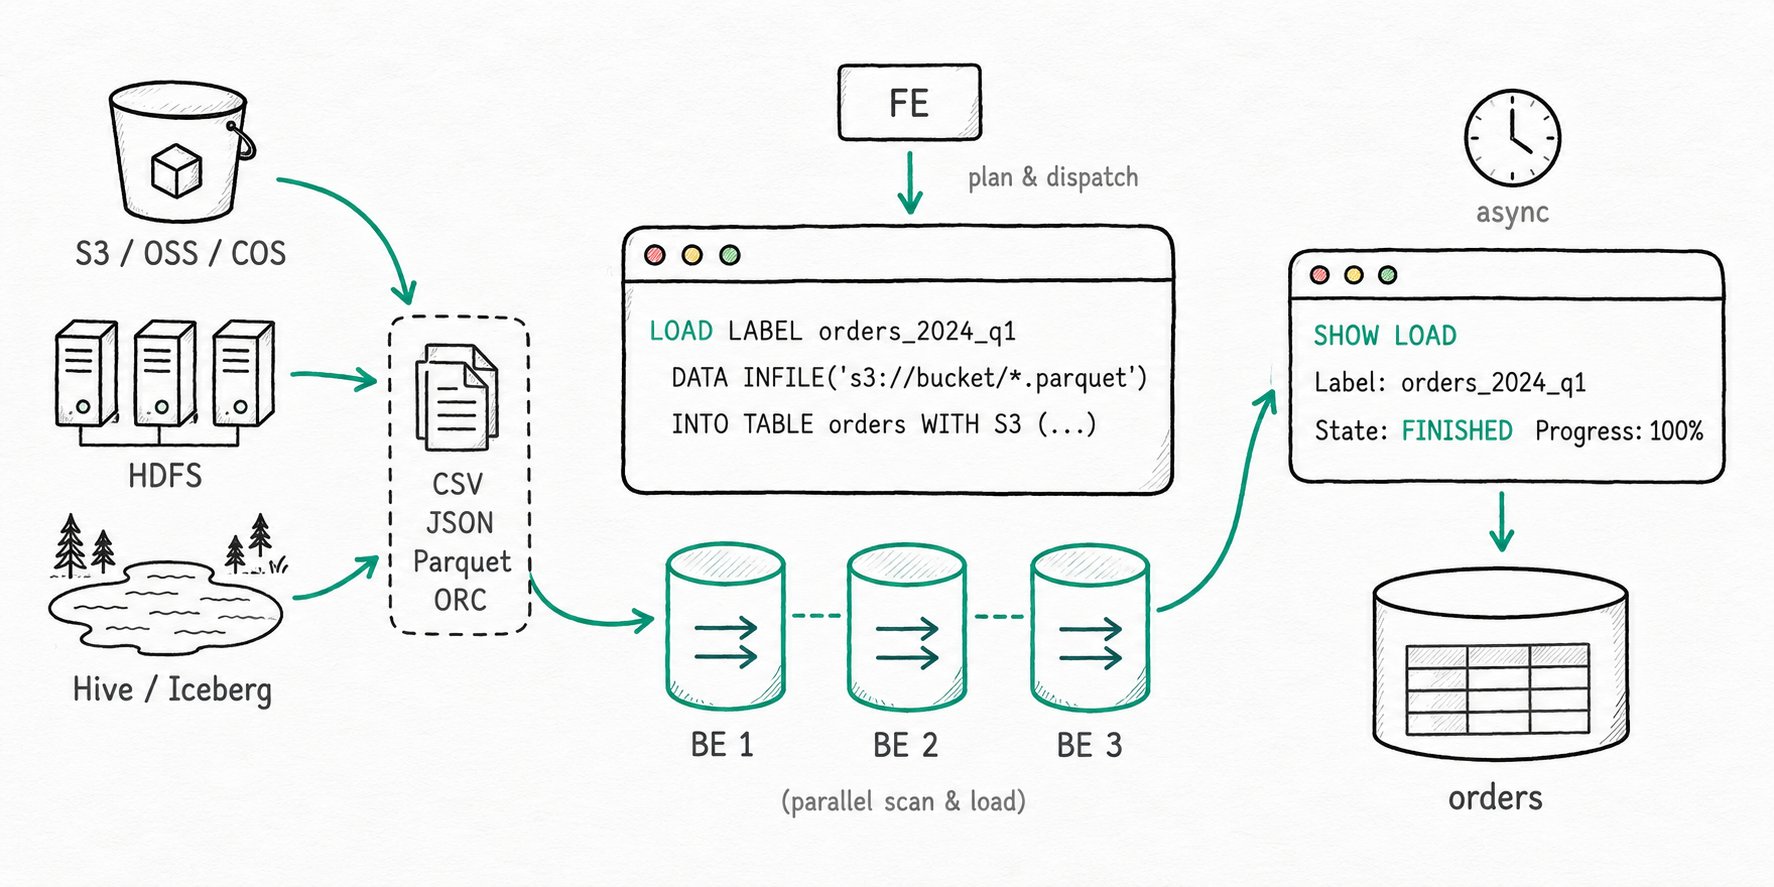
LOAD LABEL文を送信すると、FE が処理を計画して複数の BE に分散し、SHOW LOADで進行状況を確認できます。ジョブは非同期で実行されるため、クライアントが切断されても処理は続きます。ラベルを使って結果を特定し、再試行時の重複を防ぎます。外部カタログや TVF から読み込む場合は、同期実行のINSERT INTO ... SELECTを使用すると、より簡単に同様の ETL を行えます。
Apache Doris でバッチロードを使う理由
Apache Doris のバッチロードは、一度の取り込みジョブに数時間かかり、クライアントではなくデータウェアハウスがそのライフサイクルを管理する必要がある場合に適しています。イベントが少しずつ届く場合にはリアルタイムのロード方式が適していますが、TB 規模の履歴データの移行、Hive スナップショットからのファクトテーブルの再構築、S3 上の Parquet ファイルからの前四半期分のデータ補完には適しません。HTTP 経由の Stream Load はタイムアウトし、行ごとの INSERT では数日かかる可能性があります。ジョブはサーバー側で実行し、自動的に再試行でき、クライアントの接続が切れても継続する必要があります。
- 夜間 ETL では、朝のダッシュボード更新までに S3 から数百 GB の Parquet データを取り込む必要があります。
- Snowflake または Hive からの移行では、列単位のフィルターや型変換を適用しながら、パーティション全体をコピーする必要があります。
- 欠損した一日分のデータ補完で、ジョブを送信した接続を占有し続けることはできません。
バッチロードは、大量データの取り込みをラベルで追跡できる長時間実行ジョブとして扱い、データウェアハウスが最初から最後まで管理することで、これら三つのケースに対応します。
Apache Doris のバッチロードとは
Apache Doris のバッチロードは、Doris における非同期の大量データロード方式の総称です。主な入口は LOAD LABEL ... WITH S3|HDFS|BROKER 文です。以前は Broker Load と呼ばれており、現在は S3、HDFS、および Broker プロセス経由でアクセスできるストレージシステムを対象とします。同期実行の INSERT INTO ... SELECT は、ソースが外部カタログ(Hive、Iceberg、JDBC)や S3()、HDFS() などの TVF で参照するファイルである場合にも、同様のデータ取り込みに対応します。どちらも Doris の他のロード方式と同じトランザクションモデルを使用します。ジョブごとに一つのラベルを付け、アトミックにコミットし、レプリカ単位で新しいバージョンを公開します。
主な用語
LOAD LABEL: 非同期の Broker Load を実行する SQL の入口です。ラベルはデータベース単位で管理され、再試行時の重複を防ぎます。WITH S3/WITH HDFS/WITH BROKER: ストレージへのアクセス方式を選ぶ句です。S3とHDFSは BE に組み込まれています。それ以外にはBROKER broker_nameを使用し、外部の Broker プロセスを経由します。SHOW LOAD: FE 側でジョブの状態、進行状況、エラー URL、解析済みのEtlInfoを確認するためのコマンドです。- TVF(テーブル値関数):
S3(...)、HDFS(...)、LOCAL(...)、iceberg_meta(...)などです。ファイルや外部メタデータをSELECT可能なテーブルとして公開し、その結果をINSERT INTO ... SELECTで同期的に取り込めます。 max_filter_ratio: ジョブごとに許容する不正な行の割合です。デフォルトはゼロで、不正な行が一行でもあるとロードがキャンセルされます。
Apache Doris のバッチロードの仕組み
Apache Doris のバッチロードは、FE にラベル付きジョブを登録し、複数の BE でファイルの読み取りを並列化します。すべてのレプリカが新しいバージョンを公開すると、結果がアトミックにコミットされます。
- 送信とラベルの登録。
LOAD LABEL my_db.daily_orders ...リクエストが FE に届くと、FE はラベルを登録してトランザクションを開始し、ロードはPENDING状態になります。保持期間内に同じラベルで再送信すると、元のジョブがそのまま使用されます。 - 計画と分散。 FE はファイルサイズを見積もり(一台の BE が扱うデータ量は
min_bytes_per_broker_scannerからmax_bytes_per_broker_scannerの範囲で、デフォルトは 64 MB から 500 GB)、作業を分割してスキャナータスクを各 BE に割り当てます。ジョブはLOADING状態に進みます。 - 並列読み取りと書き込み。 各 BE は担当分のソースデータを S3、HDFS、または Broker 経由で取得し、CSV/JSON/Parquet/ORC を解析します。その後、
SET式、WHEREフィルター、COLUMNS FROM PATHによる値の抽出を適用し、対象タブレットにセグメントを書き込みます。不正な行はmax_filter_ratioの判定に含まれ、そのサンプルは URL フィールドから確認できます。 - コミットと公開。 すべての BE が応答すると、FE はトランザクションをコミットします。
PublishVersionタスクが各レプリカに送られ、すべてのレプリカが確認するとジョブはFINISHEDになり、行をクエリできるようになります。途中で失敗するとジョブはCANCELLEDになり、データは破棄されます。 - SHOW LOAD で確認。
SHOW LOAD WHERE LABEL = ...では、State、Progress、EtlInfo(読み取った行数、除外した行数、エラー行数)、およびエラー発生時の URL を確認できます。
INSERT INTO target SELECT * FROM s3(...) も同様の実行計画を使用しますが、同期的に実行されます。ロードが完了するまで接続を維持する必要がありますが、結果をすぐに受け取れます。また、結合や型変換、ソースへの述語プッシュダウンなどを SQL で組み合わせられます。
クイックスタート
LOAD LABEL testdb.orders_2024_q1
(
  DATA INFILE("s3://my-bucket/orders/2024-q1/*.parquet")
  INTO TABLE orders
  FORMAT AS "parquet"
  (order_id, customer_id, amount, order_date)
)
WITH S3 (
  "provider"      = "S3",
  "AWS_ENDPOINT"  = "https://s3.us-west-2.amazonaws.com",
  "AWS_REGION"    = "us-west-2",
  "AWS_ACCESS_KEY" = "<ak>",
  "AWS_SECRET_KEY" = "<sk>"
)
PROPERTIES ("timeout" = "3600", "max_filter_ratio" = "0.01");
想定される結果
+----------+--------------------+----------+------------------+--------+
| JobId    | Label              | State    | Progress         | Type   |
+----------+--------------------+----------+------------------+--------+
| 41326624 | orders_2024_q1     | FINISHED | ETL:100%;LOAD:100% | BROKER |
+----------+--------------------+----------+------------------+--------+
SHOW LOAD ORDER BY CreateTime DESC LIMIT 1 で、ジョブが FINISHED になったことを確認できます。不正な行は最大 1% まで許容されます。それを超えるとジョブがキャンセルされ、URL フィールドから問題のある行のサンプルを確認できます。
Apache Doris のバッチロードを使うべき場合
一度の取り込みで、オブジェクトストレージ、外部データウェアハウス、または Hive 形式でパーティション化されたディレクトリから数十 GB 以上のデータを扱う場合は、Apache Doris のバッチロードを使用します。
適した用途
- S3、HDFS、OSS、COS、OBS、または S3 互換ストレージにある大きな CSV、JSON、Parquet、ORC ファイルの定期的な取り込み。
- Hive、Iceberg、Snowflake、BigQuery からの一度限りの移行。Catalog と
INSERT INTO ... SELECTを組み合わせ、ソース側での射影とプッシュダウンを利用します。 - クライアントが数時間接続を維持できない、ジョブあたり数十 GB から数百 GB のデータ補完。
- サーバー側の
WHEREフィルター、SETによる列の変換、COLUMNS FROM PATH ASによるファイルパスからのパーティションフィールド抽出が必要なロード。 - 一つの文でワイルドカード(
*、?、{1..10})に一致させる、Hive 形式でパーティション化されたディレクトリ。
適さない用途
- Kafka からの継続的な取り込み。FE がコンシューマーとオフセットを管理する Routine Load を使用します。
- マイクロサービスからのイベント単位の JDBC 書き込み。小さなペイロードごとにジョブをコミットするのは非効率です。代わりに Group Commit を使用します。
- クライアントマシン上のローカルファイルからのロード。Broker Load が読み取るのはリモートストレージだけです。
Stream Loadまたは Doris Streamloader を使用します。 - 数 TB を超える単一のジョブ。デフォルトの 4 時間のタイムアウトによって失敗しやすく、再試行のコストが高く、途中で失敗するとバッチ全体を再実行する必要があります。日付やディレクトリで入力を分割し、複数のジョブを送信します。
- S3 からの継続的な増分ファイル取り込み。夜間の Broker Load には適していますが、毎分のポーリングには適していません。Streaming Job の継続的なロード を使用すると、取り込み済みファイルを FE が追跡します。
関連情報
- Stream Load: 小規模なリアルタイムバッチ向けの同期 HTTP ロード方式。
- Group Commit: 高頻度の小規模バッチをサーバー側でまとめる方式。
- Broker Load リファレンス: SQL の全構文、Kerberos と HDFS HA の設定、シナリオ別の例。
- INSERT INTO Select: TVF と Catalog を使うフローを含む同期実行の方式。
- ロード方式の選択表: リアルタイム、ストリーミング、バッチの各シナリオに適した方式。
- Catalog と TVF の入口:
S3()、HDFS()などを使用して、ファイルをクエリ可能なテーブルとして公開する方法。 - ロードトランザクション: バッチロードと Doris の他のロード方式が共有するラベル、ライフサイクルの状態、アトミックコミットの仕組み。
- BROKER LOAD SQL リファレンス: 正式な文法とすべてのオプション。
