BM25 による関連度スコアリング
要点 Apache Doris は、Lucene や Elasticsearch と同じスコアリングアルゴリズムである BM25 を使って、全文検索の一致結果をランク付けします。SELECT に
score()を追加し、WHERE 句にMATCH_*述語を指定して、スコアによるORDER BYとLIMITを使用します。Apache Doris のプランナーはトップ K の計算を転置インデックスにプッシュダウンし、関連度の高い行から返します。
Apache Doris で BM25 スコアリングを使う理由
Apache Doris の BM25 スコアリングは、全文検索の一致結果を SQL 内でランク付けされたトップ K の結果に変えます。これにより、百万行の文書集合から、別の検索エンジンを使わずに上位十件を返せます。等価条件では、どの行が一致するかは分かっても、どの行がよく一致するかは分かりません。たとえば、百万行のログテーブルに対する WHERE content MATCH_ANY 'apache doris real-time analytics' で 50,000 件が一致しても、ユーザーが求めているのは上位十件だけかもしれません。関連度スコアがなければ、その十件を適切に選ぶ方法がありません。
- 日付順に並べると、昨年の完全な一致結果が埋もれます。
- 任意の列で並べると、関連度とは無関係な結果が返ります。
- アプリケーション側で関連度を計算すると、データウェアハウスの上に検索エンジンの機能を実装することになります。
BM25 は、この問題を SQL 内で解決します。Apache Doris は、検索語がその行に現れる頻度、テーブル全体での検索語の希少性、行のテキストの長さに基づいて、一致した各行にスコアを付けます。そのスコアで並べ替えると、SELECT から検索エンジンのようなランキングを得られます。
Apache Doris の BM25 スコアリングとは
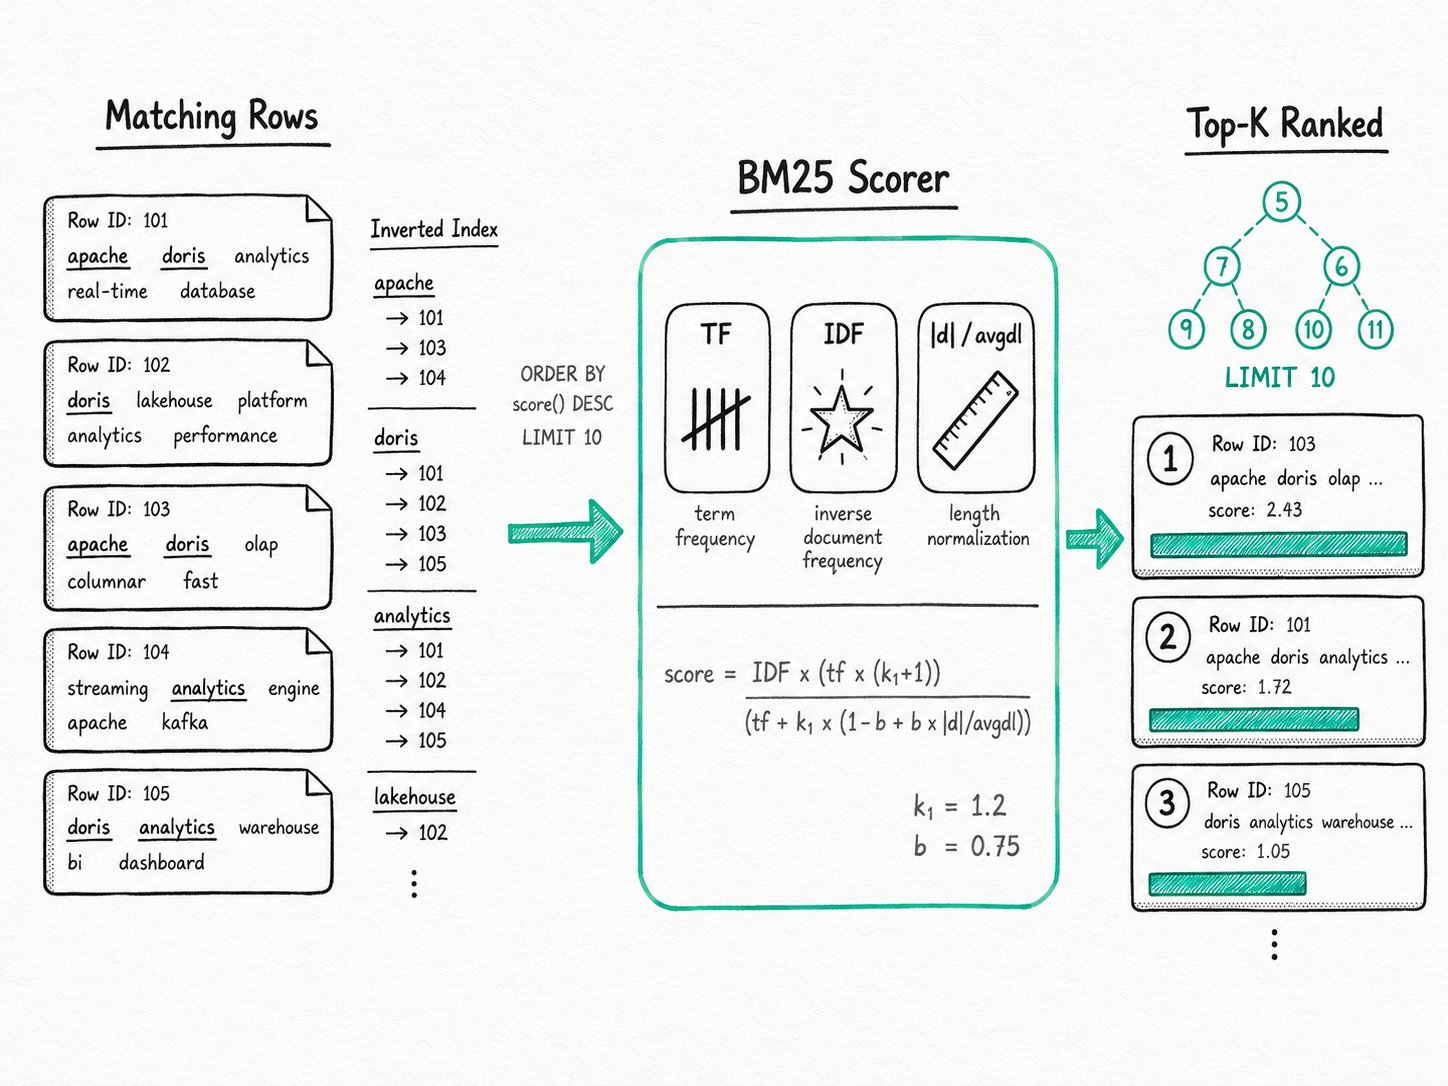
Apache Doris の BM25 スコアリングは、TF-IDF 系の関連度ランキング関数 BM25(Best Matching 25)を SQL から利用できるようにしたものです。この関数は検索語と文書から正の数値を返し、値が高いほど関連度が高いことを示します。スコアは主に三つの要素で決まります。検索語をより多く含む行ほどスコアが高くなります。一般的な語より希少な語のほうが重視されます。また、長い行は正規化されるため、同じ内容を述べる 20 語の行より 200 語の行が自動的に高く評価されることはありません。
Apache Doris では、SQL 関数 score() を通じて BM25 を利用できます。転置インデックスには、計算式に必要な語の出現頻度、文書頻度、フィールド長がすでに格納されています。そのため、インデックスの作成後は、スコアを計算するために追加のスキャンを行う必要はありません。
主な用語
score(): 現在の行について、クエリのMATCH_*述語に対する BM25 関連度スコアを返す Apache Doris のスカラー関数です。戻り値はFLOATです。- TF(term frequency、語の出現頻度): 検索語が行に現れる回数です。
- IDF(inverse document frequency、逆文書頻度): テーブル全体でその語がどれほど希少かを示す指標です。一般的な語のスコアは低く、希少な語のスコアは高くなります。
k1とb: BM25 の調整用定数です。Apache Doris では Lucene のデフォルト値であるk1 = 1.2とb = 0.75を使用します。現時点ではセッション変数として公開されていません。
Apache Doris の BM25 スコアリングの仕組み
Apache Doris は転置インデックスのリーダー内で BM25 を計算します。プランナーは score()、MATCH_*、ORDER BY、LIMIT を組み合わせたクエリを認識し、BE はポスティングを走査しながら各行をスコアリングします。そして、サイズが LIMIT に制限された最小ヒープに上位 K 件だけを保持します。
- 転置インデックスが統計情報を記録します。 トークン化する転置インデックス(
english、standard、chineseなどのパーサーを使用)を持つ列にデータをロードすると、Apache Doris は語の辞書、行ごとの語の出現頻度、フィールド長を保存します。MATCH_*のフィルタリングに使われる統計情報は、BM25 にも使われます。 - プランナーがスコアリング対象のクエリを認識します。 SELECT に
score()、WHERE にMATCH_*述語があり、ORDER BY score()とLIMITが指定されている場合、Nereids はプランを書き換えてトップ K のスコアリングをストレージ層にプッシュダウンします。この形を満たさないクエリでscore()を使用すると、Apache Doris はscore() function requires WHERE clause with MATCH function, ORDER BY and LIMIT for optimizationというエラーを返します。この制約は、十億行のテーブルの全行を意図せずスコアリングすることを防ぐためのものです。 - BE が走査中にスコアを計算します。 転置インデックスのリーダーは、検索語ごとのポスティングを走査します。候補となる各行について、
IDF * (tf * (k1 + 1)) / (tf + k1 * (1 - b + b * |d| / avgdl))を計算します。ここで|d|は行をトークン化した後の長さ、avgdlはテーブルの平均長です。複数の語を含むクエリでは、語ごとのスコアを合計します。 - ヒープが上位 K 件を保持します。 BE はサイズを
LIMITに制限した最小ヒープを使うため、一致結果全体をメモリに保持する必要がありません。50,000 行をすべてスコアリングしてから並べ替える場合とは異なり、走査しながらスコアを計算して上位十件だけを保持できます。 - Apache Doris がランク付けされた行を返します。 FE は各タブレットですでに並べ替えられたトップ K をマージし、結果を返します。
クイックスタート
CREATE TABLE articles (
  id BIGINT,
  content TEXT,
  INDEX idx_content(content) USING INVERTED PROPERTIES("parser" = "english")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'apache doris is a real-time analytics database'),
  (2, 'real-time analytics on streaming data'),
  (3, 'a guide to apache kafka');

SELECT id, content, score() AS relevance
FROM articles
WHERE content MATCH_ANY 'apache doris analytics'
ORDER BY relevance DESC
LIMIT 3;
期待される結果
+----+----------------------------------------------------+-----------+
| id | content                                            | relevance |
+----+----------------------------------------------------+-----------+
|  1 | apache doris is a real-time analytics database     |  1.871290 |
|  2 | real-time analytics on streaming data              |  0.575364 |
|  3 | a guide to apache kafka                            |  0.287682 |
+----+----------------------------------------------------+-----------+
行 1 はすべての検索語に一致するため、最上位になります。行 2 は希少な語(analytics)一つに一致します。行 3 が一致するのは、この文書集合で最も一般的な語である apache だけなので、スコアが最も低くなります。スコアの絶対値自体に意味はありません。重要なのは、この結果セット内での順位です。
Apache Doris の BM25 スコアリングを使う場面
Apache Doris の BM25 スコアリングは、全文検索のトップ K ランキングやハイブリッド検索のテキスト側のランキングに適しています。完全一致の検索、関連度に対する集計、異なるクエリ間のスコア比較には適していません。
適した用途
- ログ、文書、記事、製品説明など、トークン化する転置インデックスを持つテキスト列に対するトップ K 全文検索。
- SQL の
ORDER BYまたは RRF を使ってベクトル類似度と統合する、ハイブリッド検索クエリのテキスト関連度の評価。 - すでに Doris に保存しているデータの一致結果をランク付けすることだけを目的とした、独立した Elasticsearch クラスターの置き換え。
- 単に一致する結果ではなく、最もよく一致する結果をユーザーが求める複数語のクエリ。
適さない用途
- 完全一致の検索。 トークン化しない転置インデックスではスコアは計算されません。
=またはINを使用し、score()は使わないでください。 - スコアリング結果の集計。 Apache Doris は、
score()をGROUP BY内や集計関数内で使う場合、またはORDER BY score() LIMITを含まないプランで使う場合、クエリを拒否します。関連度に関する分析が必要な場合は、先にトップ K の結果をマテリアライズしてから、その結果セットを集計してください。 - 異なるクエリ間のスコア比較。 BM25 は文書集合とクエリに依存します。あるクエリのスコア 3.0 と別のクエリのスコア 3.0 は、意味が異なります。代わりに RRF のような順位に基づく統合手法を使ってください。Reciprocal Rank Fusion を参照してください。
- クエリごとの
k1とbの調整。 Apache Doris は Lucene のデフォルト値を使用し、現時点ではこれらを実行時パラメータとして公開していません。ワークロードで独自の調整が本当に必要な場合は、独自のスコアリングを実装して回避する代わりに、Issue を作成してください。 - ベクトルのみのランキング。 クエリが「キーワードによる制約なしで最も近い埋め込みベクトルを 10 件見つける」ものであれば、ANN 距離関数を使用し、BM25 は使用しないでください。
