カラムナストレージ
要点 Apache Doris のすべての OLAP テーブルは、列指向の Segment ファイルにデータを書き込みます。列ごとに独自のエンコーディング(PLAIN、辞書、RLE、bit-shuffle、frame-of-reference)を使用し、ページごとに独立して圧縮します(デフォルトは LZ4、オプションで ZSTD)。ページごとのゾーンマップとブルームフィルターにより、クエリはページをデコードせずにスキップできます。4.1 で追加された V3 フッターは、列数の多いテーブルで Segment を開く際のレイテンシーを 16 倍改善します。
Apache Doris でカラムナストレージを使う理由
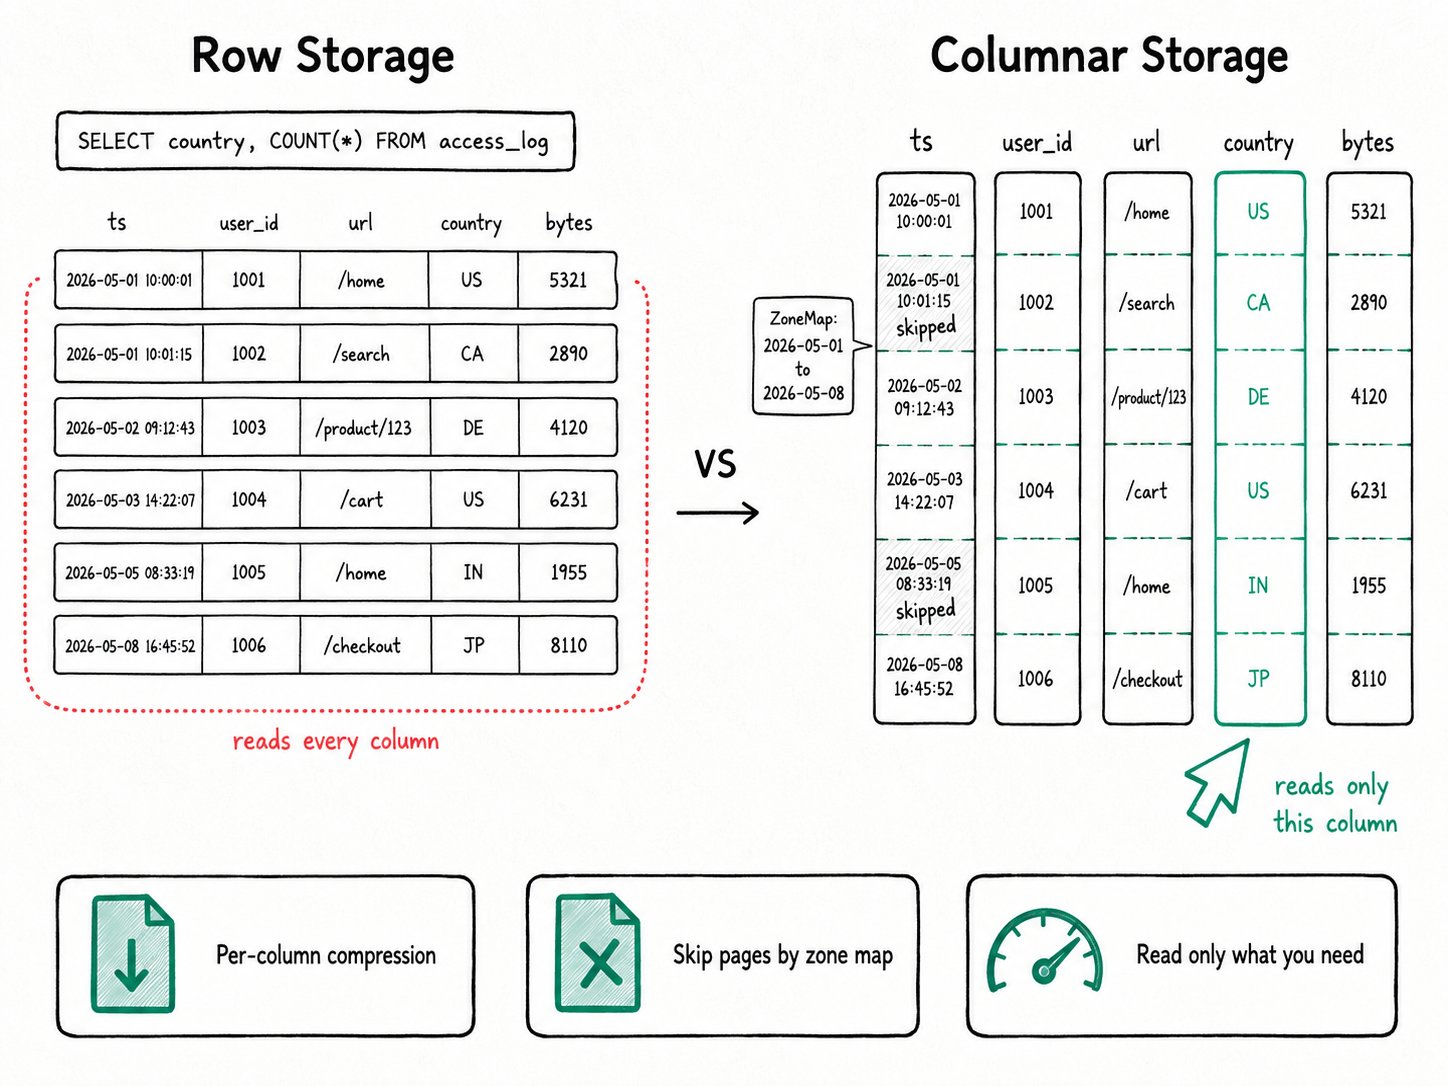
Apache Doris は、すべての OLAP テーブルを列指向の Segment ファイルに格納します。列指向のレイアウトなら、クエリが参照する列だけを I/O の対象にでき、列ごとに適したコーデックを選べるほか、スキップ用インデックスも自然に配置できるためです。行指向のストアで分析を行うと、次の三つの問題が生じます。
- 50 列のテーブルで
GROUP BY countryを実行する場合も、残りの 49 列のバイトを読み取ります。I/O コストはクエリが使う列数ではなく、行幅に応じて増えます。 - 圧縮効率が低くなります。隣接する行には異なる型の値が混在するため、辞書、ランレングス、差分などのコーデックが効果を発揮しにくくなります。
- データのスキップが難しくなります。「この 64 KB のブロックには
ts >= '2026-05-01'を満たす行がない」と判断するには、列ごとの統計情報が必要ですが、行指向のレイアウトにはそれを保持する自然な場所がありません。
列指向のレイアウトは、これら三つの問題を解決します。同じ列の値がディスク上でまとまっているため、その型に合った変換をコーデックで選べます。また、ページインデックスを使えば、データを展開する前に述語を評価できます。
Apache Doris のカラムナストレージとは
Apache Doris のカラムナストレージは、すべての OLAP テーブル(Duplicate、Unique、Aggregate)で共通する、ディスク上の Segment ファイル形式です。各ロードでは一つ以上の Segment ファイルが生成されます。Segment 内では、ライターが列を個別に処理します。値を約 64 KB のページに分け、各ページをエンコード・圧縮し、スキップ用インデックスを併せて書き込みます。ファイル末尾のフッターが、これらすべての位置を指します。
主な用語
Segment: ディスク上の不変データの単位で、マジックバイトD0R1で識別されます。デフォルト値は、ページが 64 KB、辞書ページが 256 KB、Segment の上限が 256 MB です。be/src/storage/segment/segment.hで定義されています。Page: 一つの列の値をまとめた部分です。圧縮とゾーンマップの統計情報の両方における粒度です。Encoding: 圧縮前に列ごとに適用する変換です。一般的な数値には PLAIN、カーディナリティの低い文字列には DICT、真偽値には RLE、整数列には BIT_SHUFFLE、日付には FOR(frame-of-reference)、V3 の文字列には BINARY_PLAIN_V2 を使用します。Page indexes: オーディナルインデックス、ショートキーインデックス、ゾーンマップ(ページごとの最小値・最大値と NULL の有無)、ブルームフィルターです。いずれもデータとともに Segment に書き込まれます。Footer: ファイル末尾にある protobuf レコードで、各列、各エンコーディング、各ページへのポインター、各インデックスの位置を記述します。V3(4.1 以降)では列のメタデータが外部化されるため、列数の多い Segment を開く際にそのすべてを読み込む必要がありません。
Apache Doris のカラムナストレージの仕組み
Apache Doris は Segment 内の各列を独立して書き込みます。エンコードし、約 64 KB のページに分け、圧縮してインデックスを作成し、フッターを書き込みます。ある列がディスクに書き込まれるまでの流れは次のとおりです。
- エンコード。 ライターは列の型と値の分布に基づいてエンコーディングを選びます。カーディナリティの低い
INT列には bit-shuffle を使用し、異なる値の少ない文字列列には、別の辞書ページに構築した辞書を使用します。 - ページ分割と圧縮。 エンコードした値を、それぞれ約 64 KB のページに順次格納します。各ページはデフォルトで LZ4F を使用します。テーブルの
compressionを設定すれば、ZSTD、Snappy、Zlib も使用できます。圧縮によるサイズ削減が 10% 未満の場合、圧縮をスキップします。 - インデックス作成。 ページの書き込み時に、Segment はオーディナルインデックス(行番号による二分探索)、ページごとのゾーンマップ(最小値、最大値、NULL の有無)、および
bloom_filter_columnsに指定された列のブルームフィルターも書き込みます。ショートキーインデックスには、テーブルのソートキーのプレフィックスの概要が格納されます。 - フッター。 ライターは、各列、各ページへのポインター、各インデックスを記述する
SegmentFooterPBを末尾に追加します。V3 では、これを小さなフッターとcolumn_meta_entries領域に分割します。後者は、クエリが実際に参照する列についてのみ読み込まれます。 - 読み取り。 スキャンはフッターを開き、オーディナルインデックス、ショートキー、ゾーンマップ、ブルームフィルターで読み取り対象を絞ります。残ったページだけを展開・デコードし、列指向のバッチをベクトル化エンジンに直接渡します。
Segment の上位階層は Tablet → Rowset → Segment → Column → Page です。コンパクションは Rowset をマージしますが、それより細かい単位での書き換えは行いません。すべてのクエリが読み取るのは、その下にある列とページのレイアウトです。
クイックスタート
CREATE TABLE access_log (
  ts DATETIME,
  user_id BIGINT,
  url VARCHAR(512),
  country CHAR(2)
)
DUPLICATE KEY(ts, user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "compression" = "zstd",
  "bloom_filter_columns" = "url",
  "storage_format" = "V3"
);

SELECT country, COUNT(*) AS hits
FROM access_log
WHERE ts >= '2026-05-01'
GROUP BY country
ORDER BY hits DESC;
想定される結果
+---------+--------+
| country | hits   |
+---------+--------+
| US      | 184320 |
| DE      |  62018 |
| ...     |        |
+---------+--------+
このクエリが読み取る列は ts と country だけです。リーダーは展開を行う前に、ゾーンマップの max(ts) < 2026-05-01 を満たすページをスキップします。ZSTD を使うと通常はテーブルのサイズを 5~10 倍に圧縮でき、V3 フッターにより、列数が増えても Segment を開くコストはほぼ一定に保たれます。
Apache Doris のカラムナストレージを使う場面
Apache Doris のカラムナストレージは OLAP で使用できるデフォルトかつ唯一の形式なので、すべての分析用テーブルで使われます。トレードオフが問題になるのは、高 QPS のポイントクエリやコーデックの調整など、限られた場面です。
適している場面
- Apache Doris で扱うすべての分析用テーブル。カラムナストレージはオプションではなく、OLAP で使用できるデフォルトかつ唯一の形式です。
- 列数の多いテーブルとダッシュボードのクエリ。テーブルの列数が多く、クエリが参照する列が少ないほど、行指向ストアと比べた削減効果が大きくなります。
- 頻繁にデータをロードするテーブル。同じスキーマで行が増えるほど、列ごとの圧縮とページごとのゾーンマップの両方が効果を発揮します。
- 数千列を持つテーブル。
"storage_format" = "V3"(4.1 以降)を設定すると、Segment を開く際のレイテンシーとメモリ使用量を抑えられます。
適していない場面
- 主キーを使った、数千 QPS の
SELECT *ポイントクエリ。列ごとに別々の読み取りが必要なため、幅の広い行のポイントクエリでは I/O が列数に比例して増えます。高並行ポイントクエリの方法を使用してください。これは Unique-Key の Merge-on-Write テーブルに"store_row_column" = "true"を設定し、行をキャッシュする列を追加するものです。 - プロファイルを確認せずに
compressionやstorage_page_sizeを調整すること。デフォルト値(LZ4F、64 KB)はほとんどのワークロードに適しています。CPU コストよりストレージコストが重要な場合にのみ ZSTD に切り替え、小さい列で不要な展開処理が多い場合にのみページサイズを小さくしてください。 - 「生の列を見る」ためにエンコーディングを無効にすること。生データモードはありません。コーデックはファイル形式の一部であり、取り外せるレイヤーではありません。
- 行指向のスキーマで行う、対象を絞ったポイントクエリへの対策としてカラムナストレージを考えること。すべてのクエリが
WHERE id = ?で一行を返すなら、別のシステムか行ストア拡張が必要であり、圧縮コーデックを変えても解決しません。
パフォーマンスと数値
- 列数の多いテーブルでの V3 フッター: 7,000 列、10,000 Segment のテーブルで、Segment を開く時間が 65s から 4s に短縮され(16 倍高速)、その際のメモリ使用量が 60 GB から 1 GB 未満に減りました(60 倍以上の削減)。出典: ストレージ形式 V3。
- ZSTD と従来のデフォルトの比較: 25 GB、110 百万行のテキストログデータセットでは、圧縮率が約 10 倍となり、従来のデフォルトより 53% 向上し、読み取りから展開までの全体の処理速度は 30% 向上しました。出典: Apache Doris 1.1.0 リリースノート。
関連資料
- ストレージ形式 V3: 列数の多いテーブル向けのフッター最適化と、列ごとのメタデータの外部化について説明します。
- データプルーニング: Segment 内の ZoneMap、BloomFilter、ページごとのインデックスが、スキャン時のデータスキップにどう使われるかを説明します。
- ベクトル化実行: 列リーダーがデコード済みバッチを渡すエンジンについて説明します。
- VARIANT データ型: JSON パスが、ここで説明した列ごとのエンコーディング、ページ分割、インデックス作成の対象となるサブカラムにどう昇格するかを説明します。
- Apache Doris 1.1.0 リリースノート: ZSTD 圧縮に関する当初のベンチマークと導入時の情報を確認できます。
