コンピュートグループ
要約 Apache Doris のコンピュートグループは、ストレージ・コンピュート分離型環境におけるリソースグループに相当します。BE ノードを名前付きのグループに分け、ユーザーにアクセス権を付与し、各セッションをグループに割り当てます。そのクエリを処理するのは、割り当て先のグループの BE だけです。ストレージ(S3、OSS、COS、HDFS)は共有されるため、グループの追加に必要なのはコンピュートリソースであり、データのレプリカではありません。あるグループ内の BE に障害が発生しても他のグループには影響せず、グループ全体を廃止してもデータはそのまま残ります。
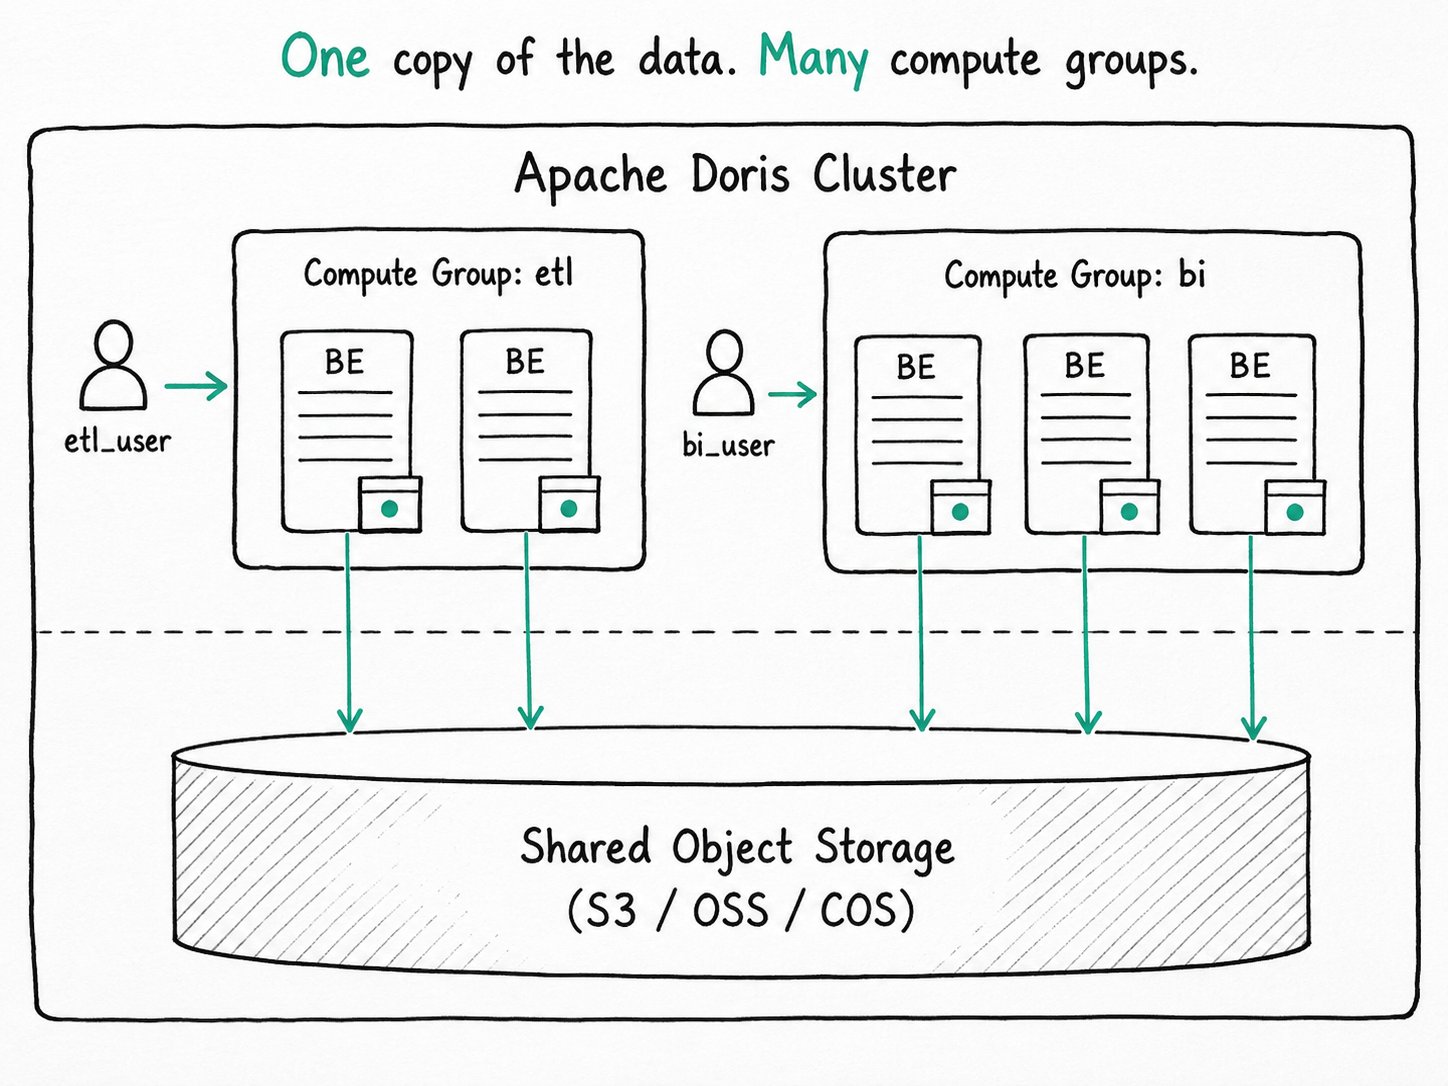
Apache Doris のコンピュートグループを使う理由
Apache Doris のコンピュートグループでは、すべてのグループが同じ共有オブジェクトストレージから読み取るため、ストレージを増やさずに BE 単位でワークロードを分離できます。ストレージ・コンピュート一体型モードではリソースグループによって BE 単位の分離ができますが、ストレージも増えます。同じテーブルを読み取るグループが五つあれば、そのテーブルのレプリカも五つ必要です。テナントを二つ追加するにはレプリカの割り当てをやり直す必要があり、翌日のバッチ処理用に一時的なプールを立ち上げるにも、まずデータを移動しなければなりません。
ストレージ・コンピュート分離型のデプロイでは、BE はステートレスです。高速化のためにアクセス頻度の高いタブレットをローカルにキャッシュしますが、正本のデータは共有オブジェクトストレージにあります。そのため、別の BE 群を追加するときに必要なのは、コンピュートリソースと、キャッシュが温まるまでの時間だけです。データを読み取るコンピュートグループがいくつあっても、論理的なデータのコピーは一つです。
コンピュートグループは、この構成をワークロードの分離に利用する機能です。リソースグループと同様に BE をグループに分けられますが、グループ数に応じて必要なストレージ容量が増えることはありません。データロードの時間帯だけ ETL 用のプールを立ち上げ、別のプールでロードの影響を受けずに BI クエリを実行し、深夜にグループを廃止できます。この間、データは移動しません。
Apache Doris のコンピュートグループとは
Apache Doris のコンピュートグループは、ストレージ・コンピュート分離型(クラウド)モードでノード単位の分離を行う仕組みです。各 BE は、名前で識別される一つのコンピュートグループにだけ属します。すべてのグループが同じオブジェクトストレージのマニフェストを利用するため、グループの追加はコンピュートリソースとウォームアップが必要なキャッシュの追加を意味し、レプリカの追加は意味しません。ワークロードグループはコンピュートグループの内部で、そのグループ上で実行されるクエリに CPU とメモリを配分します。
主な用語
tag.compute_group_name:バックエンドの追加時に設定する BE 側のプロパティです。省略するとdefault_compute_groupが使用されます。default_compute_group:新しいセッションで使用するコンピュートグループを選ぶユーザーごとのプロパティです。SET PROPERTY FOR '<user>' 'default_compute_group' = '<name>'で設定します。USE @<group>:現在の接続で有効なグループを切り替えるセッション単位のコマンドです。データベース名と組み合わせてUSE my_db@<group>と指定することもできます。USAGE_PRIV ON COMPUTE GROUP:グループの利用権限です。GRANT USAGE_PRIV ON COMPUTE GROUP <name> TO <user>で付与します。この権限がないユーザーは、そのグループを選択できません。- ファイルキャッシュ:アクセス頻度の高いタブレットのブロックを BE 上に保持するローカルキャッシュです。新しいグループのキャッシュは空なので、温まるまではキャッシュミスのたびにオブジェクトストレージへのアクセスが発生します。
Apache Doris のコンピュートグループの仕組み
Apache Doris のコンピュートグループでは、登録時に各 BE にタグを付け、特定のユーザーに USAGE_PRIV を付与します。セッションはデフォルトのプロパティまたは USE @<group> によってグループに割り当てられ、クエリフラグメントはそのグループの BE にのみ配置されます。ストレージはすべてのグループで共有します。
- 登録時に BE にタグを付ける。
ALTER SYSTEM ADD BACKEND 'host:9050' PROPERTIES ("tag.compute_group_name" = "etl")は、バックエンドをetlグループに追加します。プロパティを省略すると、その BE はdefault_compute_groupに入ります。MetaService がこの割り当てを永続化し、SHOW COMPUTE GROUPSで所属を確認できます。 - アクセス権を付与する。 一般ユーザーには、デフォルトでは利用できるコンピュートグループがありません。
GRANT USAGE_PRIV ON COMPUTE GROUP etl TO 'etl_user'を実行して初めて、そのグループを指定できるようになります。管理者ユーザーにはすべてのグループが表示されます。 - デフォルトを設定する。
SET PROPERTY FOR 'etl_user' 'default_compute_group' = 'etl'を実行すると、新しいセッションが自動的に適切なグループに割り当てられます。変更を反映するには、ユーザーが再接続する必要があります。 - 必要に応じて切り替える。
USE @biは、現在のセッションで有効なコンピュートグループを切り替えます。複数のグループにアクセスできる DBA や、ユーザーのデフォルトとは異なるプールで実行したい臨時のクエリに役立ちます。 - 計画して実行する。 クエリプランナーは、選択したグループ内の BE にのみフラグメントを配置します。各 BE は共有ストレージから読み取り、繰り返しの読み取りはローカルのファイルキャッシュで処理します。キャッシュミス時にはネットワーク経由で読み取り、クエリは失敗しません。
- 必要に応じて拡張・縮小する。
ALTER SYSTEM ADD BACKEND ...でグループを拡張し、ALTER SYSTEM DECOMMISSION BACKEND ...で縮小します。移動するレプリカがないため、タブレットのリバランスを待つ必要はありません。
クイックスタート
-- Add stateless BEs into two compute groups
ALTER SYSTEM ADD BACKEND 'be1:9050' PROPERTIES ("tag.compute_group_name" = "etl");
ALTER SYSTEM ADD BACKEND 'be2:9050' PROPERTIES ("tag.compute_group_name" = "bi");
ALTER SYSTEM ADD BACKEND 'be3:9050' PROPERTIES ("tag.compute_group_name" = "bi");

-- Grant access
GRANT USAGE_PRIV ON COMPUTE GROUP etl TO 'etl_user';
GRANT USAGE_PRIV ON COMPUTE GROUP bi  TO 'bi_user';

-- Set defaults (the user has to reconnect for new defaults to apply)
SET PROPERTY FOR 'etl_user' 'default_compute_group' = 'etl';
SET PROPERTY FOR 'bi_user'  'default_compute_group' = 'bi';

-- One-off switch for the current session
USE my_db@bi;
SELECT region, SUM(amount) FROM orders WHERE dt = CURRENT_DATE() GROUP BY region;
想定される結果
+------+-----------+-------+----------+
| Name | IsCurrent | Users | Backends |
+------+-----------+-------+----------+
| etl  | false     | 1     | 1        |
| bi   | true      | 1     | 2        |
+------+-----------+-------+----------+
SHOW COMPUTE GROUPS でグループ構成を確認できます。集計を実行するのは be2 と be3 だけです。ETL と BI はオブジェクトストレージ上の同じ orders データを使用しますが、BE もローカルキャッシュも共有しません。be1 を廃止すると etl グループは空になりますが、データはそのまま残ります。
Apache Doris のコンピュートグループを使う場面
Apache Doris のコンピュートグループは、ワークロードの分離、読み取りと書き込みの分離、またはピーク時と閑散時に応じたコンピュートリソースの伸縮が必要なストレージ・コンピュート分離型クラスターに適しています。一体型のデプロイや、グループをまたぐクエリには適していません。
適した用途
- レプリカを増やさずにワークロードを分離したいストレージ・コンピュート分離型クラスター。
- 読み取りと書き込みの分離。書き込み用グループからデータをロードし、読み取り用グループからクエリを実行します。オブジェクトストレージ上のデータは一つのコピーを共有します。読み取りを高速に保つためのウォームアップ方法については、ファイルキャッシュのベストプラクティスを参照してください。
- ピーク時と閑散時に応じたコンピュートリソースの伸縮。営業時間中にグループを追加し、夜間に廃止できます。どちらの場合もデータの移動は不要です。
- テナントごとに専用のコンピュートプールを設け、ストレージのコストを一定に保ちたいマルチテナントクラスター。
- 各コンピュートグループ内でワークロードグループを使って CPU とメモリを配分する構成。作成時の適用範囲については、ワークロードグループのバインドを参照してください。
適さない用途
- ストレージ・コンピュート一体型のデプロイ。共有オブジェクトストレージがないため、同等の機能としてリソースグループを使用します。
- グループをまたぐクエリ。リソースグループと同様に、一つのクエリで二つのコンピュートグループの BE を組み合わせることはできません。セッションごとに適切なグループを選んでください。
- キャッシュが温まるまでの性能低下を許容できないワークロード。新しいグループのファイルキャッシュは空なので、最初のクエリではすべての読み取りがオブジェクトストレージから行われます。トラフィックを流す前に
WARM UP COMPUTE GROUP <target> WITH COMPUTE GROUP <source>を使ってキャッシュを事前に準備してください。 - 作成後にワークロードグループを別のコンピュートグループに付け替える運用。ワークロードグループは一つのコンピュートグループ内に作成され、移動できません。割り当てを変更するには削除して再作成します。
- データの書き込みも分離されることを期待する用途。読み取りを行う BE は選択したグループに限定されますが、書き込みは最終的に共有ストレージ層に保存されるため、過剰なロードはストレージの帯域幅に影響する可能性があります。
関連ドキュメント
- コンピュートグループのリファレンス:SQL の全機能、権限モデル、
USE @groupによる切り替えの規則。 - コンピュートグループの管理:読み取り同士、読み取りと書き込み、書き込み同士を分離する運用手順と、旧称「compute cluster」についての説明。
- ワークロードグループのバインド:ワークロードグループを一つのコンピュートグループに限定する方法と、自動作成される
normalグループの規則。 - リソースグループ:ストレージ・コンピュート一体型モードで対応する機能と、レプリカの増加とのトレードオフ。
- ワークロードグループ:通常、コンピュートグループと組み合わせて使うプロセス内の分離機能。
- 読み取りと書き込みの分離におけるファイルキャッシュのベストプラクティス:書き込みが別のグループで行われる場合も、クエリ用グループを高速に保つためのウォームアップ方法。
- MPP アーキテクチャ:シェアードナッシング方式の実行モデル。BE を追加するたびに、フラグメントインスタンスを配置できる枠が増えます。
