データキャッシュとページキャッシュ
要点 Apache Dorisは、レイクハウスのストレージを二層でキャッシュします。データキャッシュはS3またはHDFSから取得したバイト列をBEのローカルディスクに保存し(1 MBのブロック単位)、繰り返し実行するスキャンでネットワークアクセスを省きます。ページキャッシュは展開済みのカラムページをメモリに保存し、繰り返し実行するスキャンで展開とデコードも省きます。
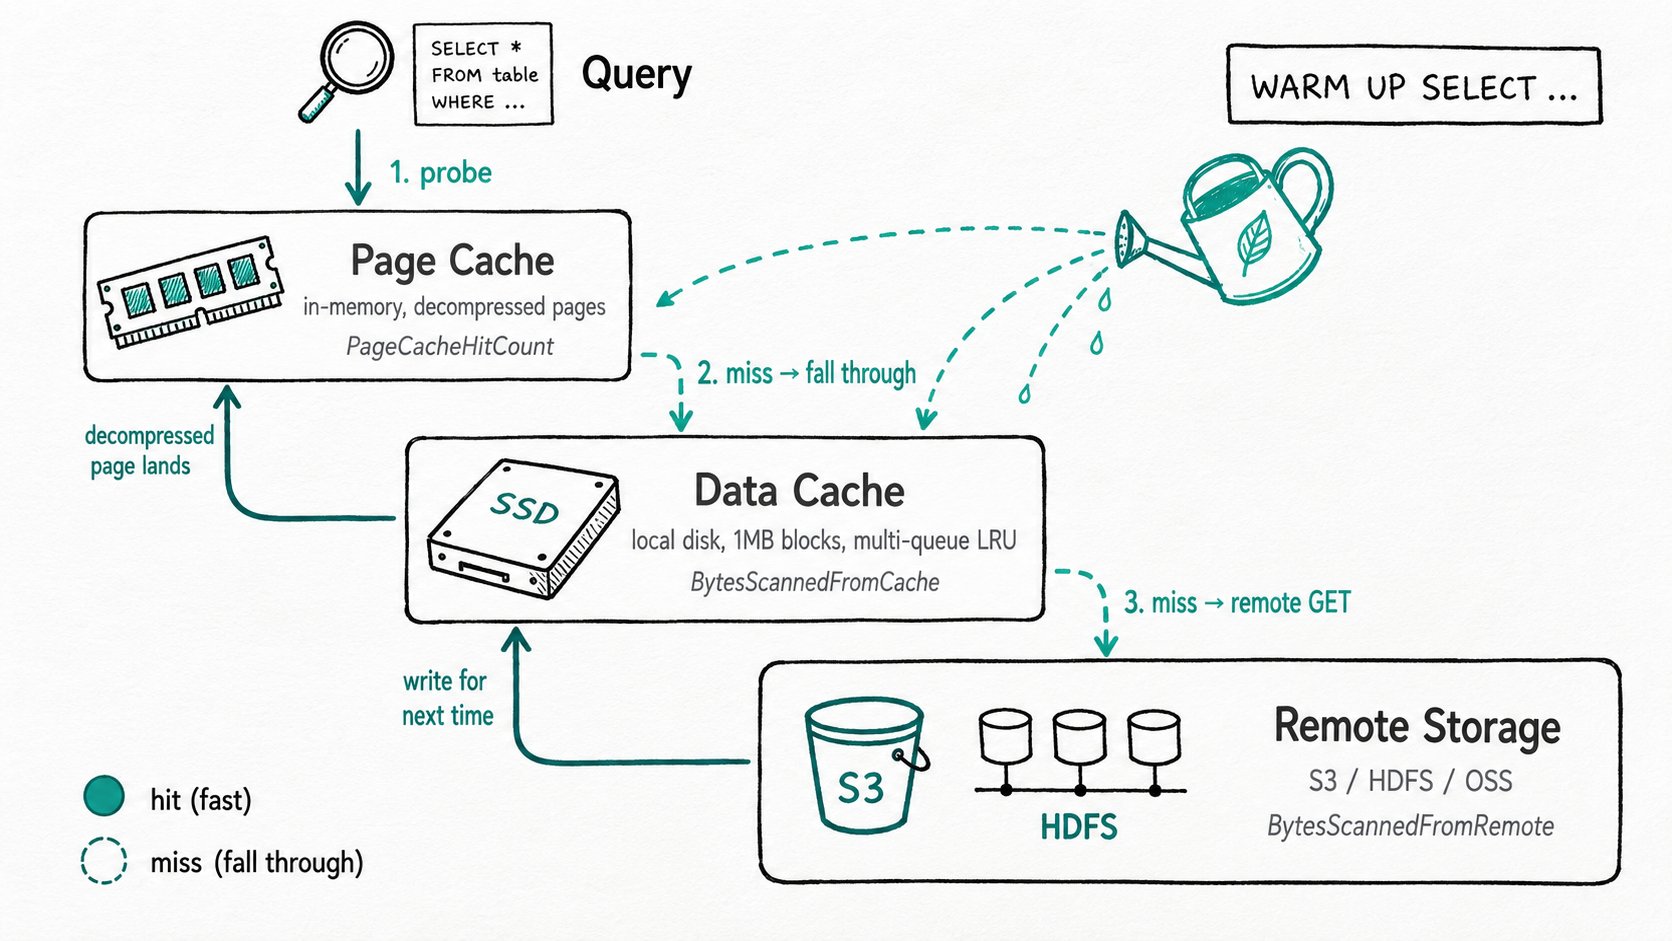
WARM UPは両方のキャッシュを事前に埋めるため、初回はコールド状態でも、二回目はローカルディスク、三回目はRAMから高速に読み取れます。
Apache Dorisでデータキャッシュとページキャッシュを使う理由
Apache Dorisのデータキャッシュとページキャッシュは、ホットデータに対するネットワークからの繰り返し取得と展開処理を省き、レイクハウスクエリのレイテンシーを短縮します。S3上のHiveまたはIcebergテーブルに対するクエリでは、各バイトの処理に三つのコストがかかります。取得(範囲指定GETごとのHTTPラウンドトリップ)、展開(snappy、zstd、gzip)、デコード(RLE、辞書、plain)です。通常、取得が最大のボトルネックです。S3 GETのテールレイテンシーは30 msから500 msに達します。数千回の範囲指定読み取りを行うParquetスキャンでは、CPU処理を始める前に、実行時間の大半をHTTPの待機に費やすことがあります。
次のようなケースで、このコストが目立ちます。
- 同じダッシュボードが五分ごとに実行され、直近のパーティションにある同じ100 GBのデータを毎回ダウンロードする。
- BEがクラスタに追加された直後(自動スケーリング、交換、デプロイ)に、そのBEで最初に実行されるクエリはすべてのファイルを新たに取得する必要がある。一方、ほかのBEはミリ秒単位で応答する。
- 同時実行数の多いレポートが数十台のBEに分散し、すべてのBEが同じホットパーティションを問い合わせる。クラスタのボトルネックはCPUではなく、オブジェクトストアからのデータ転送になる。
二つのキャッシュは異なる層にあります。データキャッシュにヒットするとネットワークアクセスを省けます。ページキャッシュにヒットすると、ネットワークアクセスと展開処理の両方を省けます。ただし、その前の読み取りでページキャッシュが埋まっている必要があります。
Apache Dorisのデータキャッシュとページキャッシュとは
Apache Dorisのデータキャッシュとページキャッシュは、相互に補完する二つのストレージキャッシュです。前者はBEごとにリモートファイルのバイト列を保存するローカルディスクキャッシュ、後者はカラムページを保存するメモリキャッシュです。
データキャッシュは、BEごとにリモートファイルのバイト列を保存するローカルディスクキャッシュです。Apache DorisのBEがHive、Iceberg、Hudi、またはPaimonテーブルのParquetファイルやORCファイルを読み取ると、バイト列を1 MBのブロック単位で取得し、設定されたローカルディレクトリに書き込みます。同じオフセットを再び読み取るときは、S3ではなくディスクから読み取ります。
ページキャッシュは、カラムページを保存するメモリキャッシュです。二種類あります。Storage Page CacheはDorisの内部セグメントにある展開済みページをキャッシュします。Parquet Page Cache(4.1以降)は外部Parquetファイルに対して同じことを行い、圧縮率に応じて圧縮状態と展開済み状態のどちらでページを保持するかを判断します。
主な用語
Block:データキャッシュの単位。デフォルトは1 MBで、ディスク上では(file, offset)の組ごとに一つのブロックを保存します。Multi-queue LRU:データキャッシュの退避方式。通常データ、TTL付きデータ、インデックスデータ、使い捨ての単発読み取りに別々のキューを使用し、一回だけのスキャンでダッシュボードが頻繁に使うブロックを追い出さないようにします。Page:カラムチャンク内のデコード単位。通常は64 KBから1 MBの値を含み、RLE、辞書、plainのいずれかでエンコードされています。WARM UP:バックグラウンドで疑似的なスキャンを実行し、いずれかのキャッシュを事前に埋めるSQL構文。Admission control:クエリがデータキャッシュへの書き込みを許可されるかどうかを決めるポリシー。単発のスキャンによるキャッシュの汚染を防ぐために使います。
Apache Dorisのデータキャッシュとページキャッシュの仕組み
Apache Dorisは、レイクハウスのスキャンでまずページキャッシュを参照し、次にデータキャッシュを参照します。どちらにもヒットしない場合にのみS3/HDFSから読み取ります。スキャンは次の順序でキャッシュを通ります。
- ページキャッシュの参照(メモリ)。 IOを開始する前に、リーダーは必要なカラムページがページキャッシュにあるかを確認します。キーにはファイルパス、ファイルサイズ、オフセットを使います。ヒットすると、デコード可能な状態(またはデコード済み)のバイト列が返り、IOと展開処理の両方を省けます。
- データキャッシュの参照(ローカルディスク)。 ページキャッシュにヒットしない場合、ファイルリーダーは要求されたバイト範囲を含む1 MBのブロックをデータキャッシュで探します。ヒットすると、GB/sの速度でローカルNVMeから読み取れます。展開とデコードは引き続き必要ですが、ネットワークアクセスは省けます。
- リモート読み取り(S3/HDFS)。 データキャッシュにもヒットしない場合、BEはオブジェクトストレージに範囲指定GETを発行し、次回のために1 MBのブロックをローカルキャッシュへ書き込みます。クエリが単発の読み取りとして指定されている場合、アドミッション制御によって書き込みが拒否されることがあります。
- デコードとページキャッシュへの書き込み。 展開済みページをページキャッシュに格納します。Parquet Page Cacheは各ページの
decompressed_size / compressed_sizeをparquet_page_cache_decompress_threshold(デフォルトは1.5)と比較します。しきい値を下回る場合は容量を抑えられる圧縮状態で、上回る場合は展開済み状態で保存します。 - 退避。 両方のキャッシュはシャード化されたLRUを使用します。データキャッシュにはバックグラウンドの退避ループ(
enable_evict_file_cache_in_advance)もあり、ディスク使用量がしきい値を超えると、クエリを待たせる前に空き容量を確保します。
WARM UPは、要求に応じて同じ経路をたどります。行を返さずにスキャンを実行し、ヒットとミスを記録して、両方のキャッシュを事前に埋めます。
クイックスタート
-- One-time setup on each BE: configure a cache directory.
-- be.conf (enable_file_cache is enabled by default since Doris 4.2):
--   enable_file_cache = true
--   file_cache_path = [{"path":"/data/file_cache","total_size":107374182400}]

-- Per-session toggles (defaults shown):
SET enable_file_cache = true;

-- Pre-populate the Data Cache for today's hot partition.
WARM UP SELECT l_orderkey, l_shipmode
FROM hive_catalog.tpch.lineitem
WHERE l_shipdate = '2026-05-01';

-- Now run the real query: it should hit cache on retries.
SELECT l_shipmode, count(*)
FROM hive_catalog.tpch.lineitem
WHERE l_shipdate = '2026-05-01'
GROUP BY l_shipmode;
想定される結果(プロファイルの抜粋)
VFileScanNode
  BytesScannedFromCache:   2.02 GB
  BytesScannedFromRemote:  0 B
  PageCacheHitCount:       18432
  PageCacheMissCount:      0
最初の実行でS3から取得したデータがデータキャッシュに格納されます。二回目の実行ではBEのローカルディスクからクエリに応答し、展開済みページはRAMから提供されます。
Apache Dorisのデータキャッシュとページキャッシュを使う場面
Apache Dorisのデータキャッシュとページキャッシュは、レイクハウスのホットパーティションを繰り返し問い合わせる場合、同時実行数の多いダッシュボード、コンピュートグループの伸縮に適しています。ワーキングセットがキャッシュより大きい場合、単発のETL、またはローカルIOがリモートソースより速くないHDDを使う場合は、使用を避けてください。
適したケース
- ホットパーティションへの繰り返しクエリ(移動時間枠のダッシュボード、日次レポート)。
- ネットワークまたはデータ転送のコストが支配的な、S3やHDFS上のレイクハウステーブル。
- 数十台のBEが同じファイルにアクセスする、同時実行数の多いワークロード。キャッシュによって、クエリのスループットがオブジェクトストアのスループットに左右されにくくなります。
- コンピュートグループの伸縮。トラフィックを新しいコンピュートグループに流す前に、既存のグループからキャッシュをウォームアップできます。
- アクセスが偏ったワークロード(パレート則:10%のパーティションに90%のクエリが集中する)。
適さないケース
- キャッシュより大きいワーキングセット。クエリのたびに新しいデータにアクセスすると、キャッシュの入れ替わりが激しくなります。毎回キャッシュミスのコストを負担し、退避にもCPUを使います。キャッシュを増やす、述語で対象を絞る、またはそのワークロードのキャッシュを無効にしてください。
- 単発のETLやバックフィル。再度読み取らないデータによって、頻繁に使うブロックが追い出されます。アドミッション制御でこれらのスキャンをキャッシュの対象外にするか、
enable_file_cache = falseで実行してください。 - データキャッシュによる改善を期待したDoris内部テーブルへのクエリ。データキャッシュが使われるのはHive、Iceberg、Hudi、Paimonのファイルのみです。内部テーブルには、すでにStorage Page CacheとOSのページキャッシュが使われます。
- HDD。データキャッシュは、ローカルIOがリモートソースより十分に速いことを前提とします。HDDでは、ローカルの読み取りにかかる時間が並列のS3 GETより長くなることがあります。SSDまたはNVMeを使用してください。
- ページキャッシュにメモリを割り当てすぎる場合。メモリの30~40%を超えると、クエリのバッファプールが不足し、キャッシュによる節約分を上回るコストのスピルが発生します。ほとんどのワークロードでは、デフォルトの
storage_page_cache_limit = 20%が妥当です。
関連資料
- データキャッシュのリファレンス:
WARM UP SELECT、クエリごとの制限、アドミッション制御を含む詳細。 - ファイルキャッシュ(コンピュートとストレージの分離):クラウドモードの内部タブレットに同じ仕組みを適用したもの。
- Parquet Page Cacheとレイクハウスのその他のチューニング:外部Parquetファイルの展開済みページを保存するメモリキャッシュ。
- Parquet Reader Optimization:読み取るバイト列を決めるリーダー。キャッシュとプルーニングを組み合わせられます。
- Query CacheとCondition Cache:ストレージキャッシュの上位にある、結果レベルと述語レベルのキャッシュ。
- WARM UP文:コンピュートグループ間でキャッシュを事前に埋めるSQL構文。
- Iceberg:ページキャッシュの主な利用対象。IcebergのスキャンはS3互換のオブジェクトストレージからリモートのParquetファイルを読み取ります。
