全文検索
要約 Apache Doris の全文検索は、転置インデックスを使ってテキスト列を検索可能な語に変換し、SQL で六つの
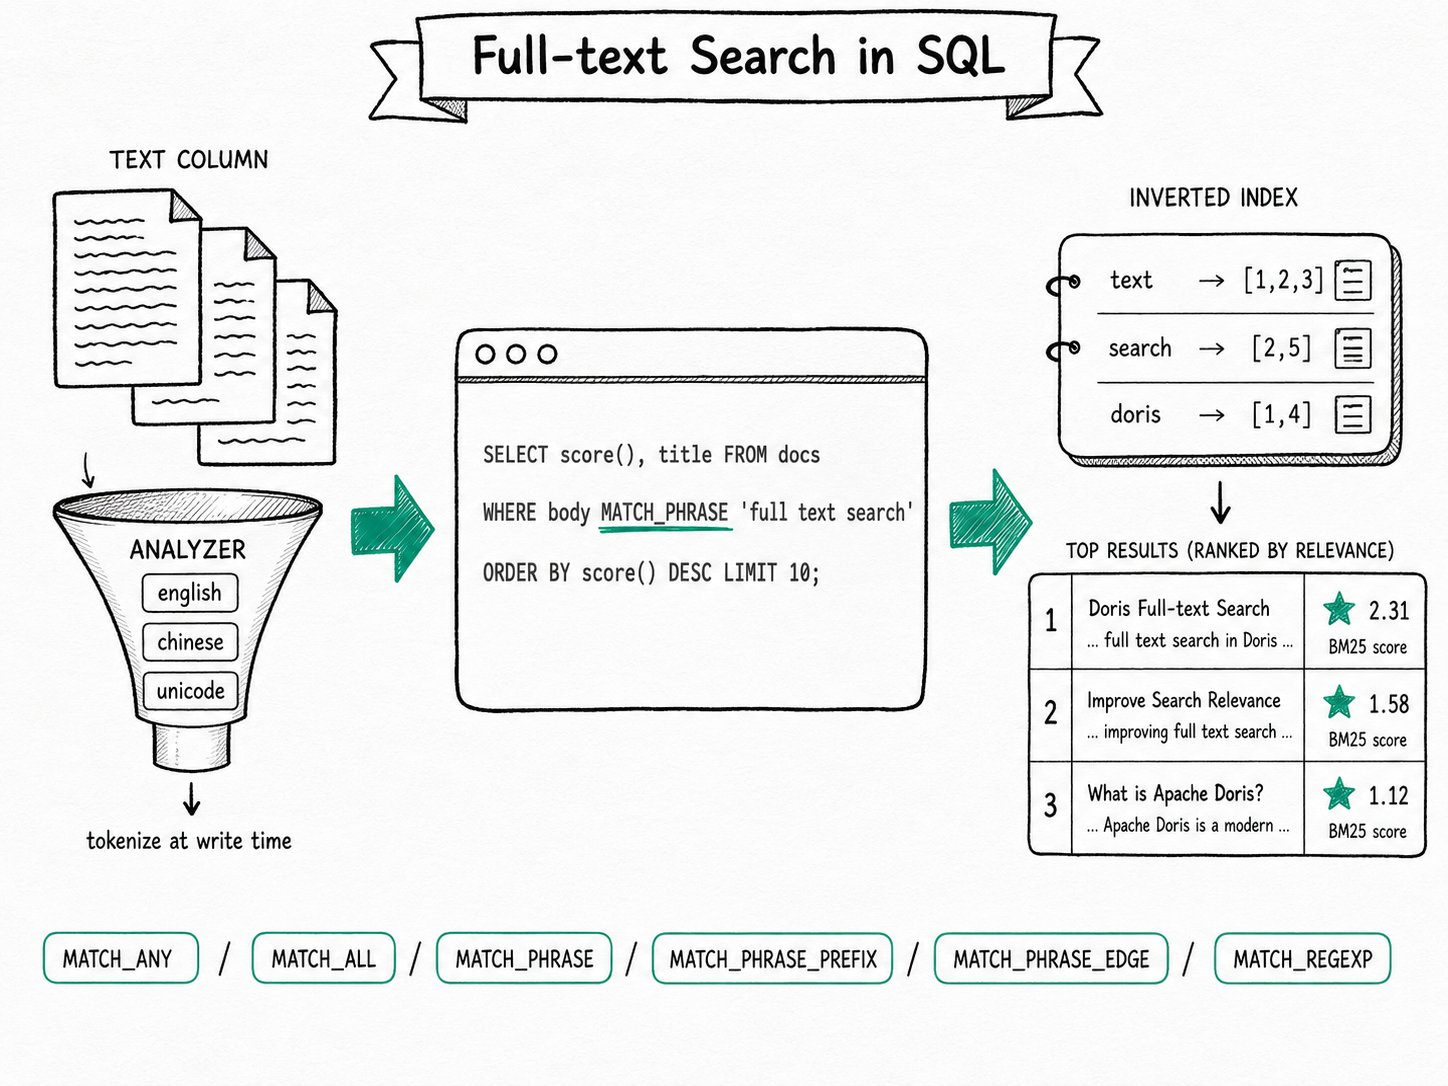
MATCH_*演算子、すなわちMATCH_ANY、MATCH_ALL、MATCH_PHRASE、MATCH_PHRASE_PREFIX、MATCH_PHRASE_EDGE、MATCH_REGEXPを利用できるようにします。インデックスの作成時にトークナイザーを選び、通常の SQL クエリを記述します。Apache Doris のプランナーが述語をインデックスにプッシュダウンするため、別の検索クラスタは必要ありません。
Apache Doris で全文検索を使う理由
Apache Doris の全文検索は、テキスト検索とデータウェアハウスの分析を一つのエンジンに統合します。トークンを考慮した演算子は、LIKE による部分文字列の一致を大きく超える検索ができます。多くのデータウェアハウスでは、テキスト検索に LIKE '%foo%' を使います。一万行の中から一行を探す程度なら機能しますが、「battery」や「batteries」に言及した注文コメント、「connection refused」というフレーズを含むログ行、「wireless」で始まる説明文を持つ商品をすべて探す必要があると、うまく対応できません。
LIKE は各値を先頭から末尾までバイト単位で読み取ります。この演算子は「Running」と「running」が同じ単語であることも、「search engine optimization」が単なる部分文字列ではなく、順序を持つ三つの語であることも認識しません。一般的な回避策は Elasticsearch を併設することですが、二つ目のクラスタの費用がかかり、壊れやすい同期パイプラインも必要になります。
Apache Doris は、これらを一つのエンジンに統合します。集計に使うテーブルをそのままテキスト検索にも使え、演算子も SQL に沿った名前です。
- 部分文字列を検索する
LIKEはフルスキャンにフォールバックします。転置インデックスはテキスト述語をポスティングリストのルックアップに変えます。 - 入力中の検索、フレーズ検索、トークンに対する正規表現には、
LIKEでは表現できない一致条件が必要です。 - 構造化された述語とテキスト述語の組み合わせ(
category = 'A' AND content MATCH_ANY 'doris')を、一つのクエリとして計画、実行できます。
Apache Doris の全文検索とは
Apache Doris の全文検索は、転置インデックスを基盤とするクエリ機能です。INVERTED インデックスを STRING、TEXT、VARCHAR、または ARRAY<STRING> 列に定義し、アナライザーを選ぶと、MATCH_* 演算子を含む WHERE 句の述語がインデックスにプッシュダウンされます。元のテーブルは通常の Apache Doris テーブルのままで、ダッシュボードからのクエリにも引き続き利用できます。
主な用語
- アナライザー(パーサー):生のテキストを検索可能な語に変換する処理です。組み込みの選択肢には
none(完全一致)、english、chinese、unicode、standard、icuがあります。カスタムアナライザーでは、char_filter、tokenizer、一つ以上のtoken_filterステージを連結できます。 - 語のクエリ:個々のトークンを照合します。
MATCH_ANYは語同士の OR、MATCH_ALLは語同士の AND です。 - フレーズクエリ:トークンが指定順で隣接する場合に一致します。トークン化しないパーサーでは、インデックスに
"support_phrase" = "true"が必要です。 score():BM25 関連度スコアです。トークン化されたインデックス、MATCH_*述語、ORDER BY score() LIMIT Nがある場合に利用できます。
Apache Doris の全文検索の仕組み
Apache Doris の全文検索は、書き込み時にテキストをトークン化し、Nereids オプティマイザーで各 MATCH_* 述語を認識して転置インデックスにプッシュダウンすることで動作します。一致しない行はデコードされません。以下の五つの段階で、解析、プッシュダウン、スコアリング、構造化された述語との組み合わせを説明します。
- 書き込み時にトークン化する。 行がタブレットに書き込まれると、アナライザーが各テキスト値を語に分割します。転置インデックスには、語ごとに、それを含む行とその位置が記録されます。
- クエリを解析する。
MATCH_*演算子は、Nereids でMatch、MatchAny、MatchAll、MatchPhrase、MatchPhrasePrefix、MatchPhraseEdge、MatchRegexpのいずれかとして認識されます。それぞれが、クエリ文字列自体のトークン化方法を制御するアナライザーのヒントを保持します。 - インデックスにプッシュダウンする。 BE は一致するポスティングリストを検索し、演算子に応じて積集合または和集合を取り、行のビットマップを返します。一致しない行はデコードされません。
- 要求された場合にスコアを計算する。 クエリに
SELECT score() ... ORDER BY score() DESC LIMIT Nがある場合、Doris は BM25(語の出現頻度、逆文書頻度、文書長の正規化)を計算して上位 N 件を返します。この三つの要素が揃わない場合、述語は通常のフィルターとして機能します。 - 自由に組み合わせる。 一つのクエリで
MATCH_*を=、IN、範囲フィルター、結合、集計と組み合わせられます。オプティマイザーはテキスト述語もプッシュダウンの対象として扱います。
クイックスタート
CREATE TABLE articles (
  id INT,
  title  STRING,
  body   STRING,
  INDEX idx_body (body) USING INVERTED
    PROPERTIES("parser" = "english", "support_phrase" = "true")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'Doris 4.0 release', 'Apache Doris adds BM25 scoring for full-text search'),
  (2, 'Storage notes',     'Inverted indexes accelerate text and structured filters'),
  (3, 'Vector primer',     'Approximate nearest neighbor search complements text search');

SELECT id, title, score() AS rel
FROM articles
WHERE body MATCH_ANY 'text search'
ORDER BY rel DESC LIMIT 3;
期待される結果
+------+-------------------+-----------+
| id   | title             | rel       |
+------+-------------------+-----------+
|    3 | Vector primer     | 0.8009131 |
|    1 | Doris 4.0 release | 0.5634479 |
|    2 | Storage notes     | 0.1384567 |
+------+-------------------+-----------+
MATCH_ANY 'text search' はクエリを text と search にトークン化し、両方のポスティングリストを検索して、いずれかの語を含む行を返します。score() は、ORDER BY rel LIMIT 3 によってオプティマイザーが Top-N クエリとして扱うと、BM25 で順位を付けます。行 3 は両方の語を含み(search は二回)、行 1 は両方の語を一回ずつ含み、行 2 は text だけを含みます。
演算子の一覧
| 演算子 | 用途 |
|---|---|
MATCH / MATCH_ANY | 指定したキーワードのいずれかを検索(OR) |
MATCH_ALL | 指定したすべてのキーワードを検索(AND) |
MATCH_PHRASE 'a b' | 順序どおりに隣接する語。~slop と厳密な順序を要求する ~slop+ に対応 |
MATCH_PHRASE_PREFIX 'a b' | 最後の語をプレフィックスとして扱うフレーズ。入力補完に利用 |
MATCH_PHRASE_EDGE 'a b c' | 最初の語はサフィックス、中間の語は完全一致、最後の語はプレフィックス |
MATCH_REGEXP '^abc.*' | 生のバイト列ではなく、トークンに対して評価する正規表現 |
一つの列に異なるアナライザーを使う転置インデックスが複数ある場合、USING ANALYZER <name> を付けると、クエリ時に使用するアナライザーを選べます。
Apache Doris の全文検索を使う場面
Apache Doris の全文検索は、ログやトレースの検索、EC サイトの商品カタログ検索、CJK とラテン文字が混在するコンテンツ、入力中の検索、テキストの一致とベクトル類似度を組み合わせる RAG パイプラインに適しています。トークン内部の部分文字列検索、編集距離によるあいまい一致、検索結果のハイライト表示が必要な場合は、LIKE または n-gram インデックスを検討してください。
適した用途
- 自由入力のテキストと構造化されたフィルターを組み合わせるログやトレースの検索(
level = 'ERROR' AND message MATCH_ANY 'timeout disconnect')。 - 同じ行に価格、カテゴリ、説明文がある EC サイトやカタログの検索。
- CJK とラテン文字が混在するコンテンツ。
chinese、unicode、icuパーサーは、一つの列で両方を処理できます。 MATCH_PHRASE_PREFIXを使い、別の自動補完サービスなしで候補を返す入力中の検索。- テキストの一致と埋め込みベクトルの類似度を組み合わせる RAG パイプライン。ハイブリッド検索では、一つの SQL で
MATCH_*とベクトル距離を組み合わせる方法を説明します。
適さない用途
- 一つのトークン内の部分文字列検索(「year」の中の「ear」を含む行をすべて探すなど)。トークン化すると、この単位でデータを参照できなくなります。
LIKE、N-Gram BloomFilter インデックス、またはトークン化しない転置インデックスを使ってください。 - あいまい一致や編集距離による一致(「もしかして…」など)。現在、Doris に組み込みのあいまい一致演算子はありません。書き込み時に音声変換や n-gram のアナライザーで前処理するか、アプリケーション側でクエリをあいまい化してください。
- 検索結果のハイライト表示(一致した箇所をマークアップ付きで返すこと)。現在、Doris はスコアを計算しますが、ハイライト用の断片は返しません。一致した語からアプリケーション側でハイライトを描画してください。
- Elasticsearch の
dis_maxのような、複数のフィールドを横断する関連度の順位付け。score()は述語ごとに計算されます。より高度なスコアリングが必要な場合はSEARCH('title:foo OR body:foo')を使い、アプリケーション層で調整してください。
トークナイザーの選び方
アナライザーの選択は、検索結果に最も大きく影響します。一致可能なクエリが決まり、インデックスに登録される語は書き込み時に確定します。
none:トークン化しません。値全体を一つの語として扱います。ID、タグ、状態を表す列挙値、完全一致フィルターに適しています。english:ASCII の単語境界で分割し、軽い正規化を行います。英語の文章に適しています。chinese:parser_modeにfine_grainedまたはcoarse_grainedを指定できる中国語の分かち書きです。CJK コンテンツに適しています。unicode:CJK や句読点に対応する、言語に依存しない単語分割です。複数言語が混在するコンテンツの標準的な選択肢です。standard:Unicode のテキスト分割に基づくトークナイザーです。ほとんどの言語で使えます。icu:Unicode の完全な分割規則を必要とする言語(タイ語、クメール語、文字体系が混在するテキスト)向けの、ICU ベースのトークナイザーです。- カスタムアナライザー(3.1 以降):プレフィックス補完には
edge_ngram、キャメルケースやハイフンでつながれた語にはword_delimiter、大文字と小文字やアクセントの違いを無視した検索にはlowercaseとasciifoldingなどを連結できます。
アナライザーを変更するには、BUILD INDEX でインデックスを再構築する必要があります。
関連資料
- 転置インデックス:これらの演算子を支えるインデックス構造。ストレージのレイアウト、構築、コンパクション時の動作を説明します。
- BM25 関連度スコアリング:
score()の計算方法、有効になる条件、k1とbの調整方法を説明します。 - ハイブリッド検索:一つの SQL で
MATCH_*とベクトルの ANN 距離を組み合わせる方法、事前フィルターとフォールバックの動作を説明します。 - 検索演算子のリファレンス:slop の構文、プレフィックスの規則、
USING ANALYZERを含む演算子の全一覧です。 - カスタムアナライザーのガイド:文字フィルター、トークナイザー、トークンフィルターを詳しく説明します。
- SEARCH 関数:複数の列にまたがる演算子を一つの文字列で組み合わせる DSL です。
- Reciprocal Rank Fusion:一つのスコアリング手法では足りない場合に、BM25 の順位とベクトルの順位を統合する SQL パターンです。
