高同時実行ポイントクエリ
要約 Apache Doris はカラム指向の OLAP エンジンですが、主キーの等価検索では別の経路を使います。Unique Key モデルと Merge-on-Write、行形式のストレージ(
store_row_column)、ショートサーキットクエリ経路、サーバー側のPreparedStatementを組み合わせると、SELECT * FROM t WHERE pk = ?は通常の OLAP クエリとは異なる方法で処理されます。BE との一往復で一行を返し、プランの解析もフラグメントのスケジューリングも行いません。これにより、ダッシュボードのウィジェットとファクトテーブルの集計を、別のデータベースを立ち上げずに同じデータベースで処理できます。
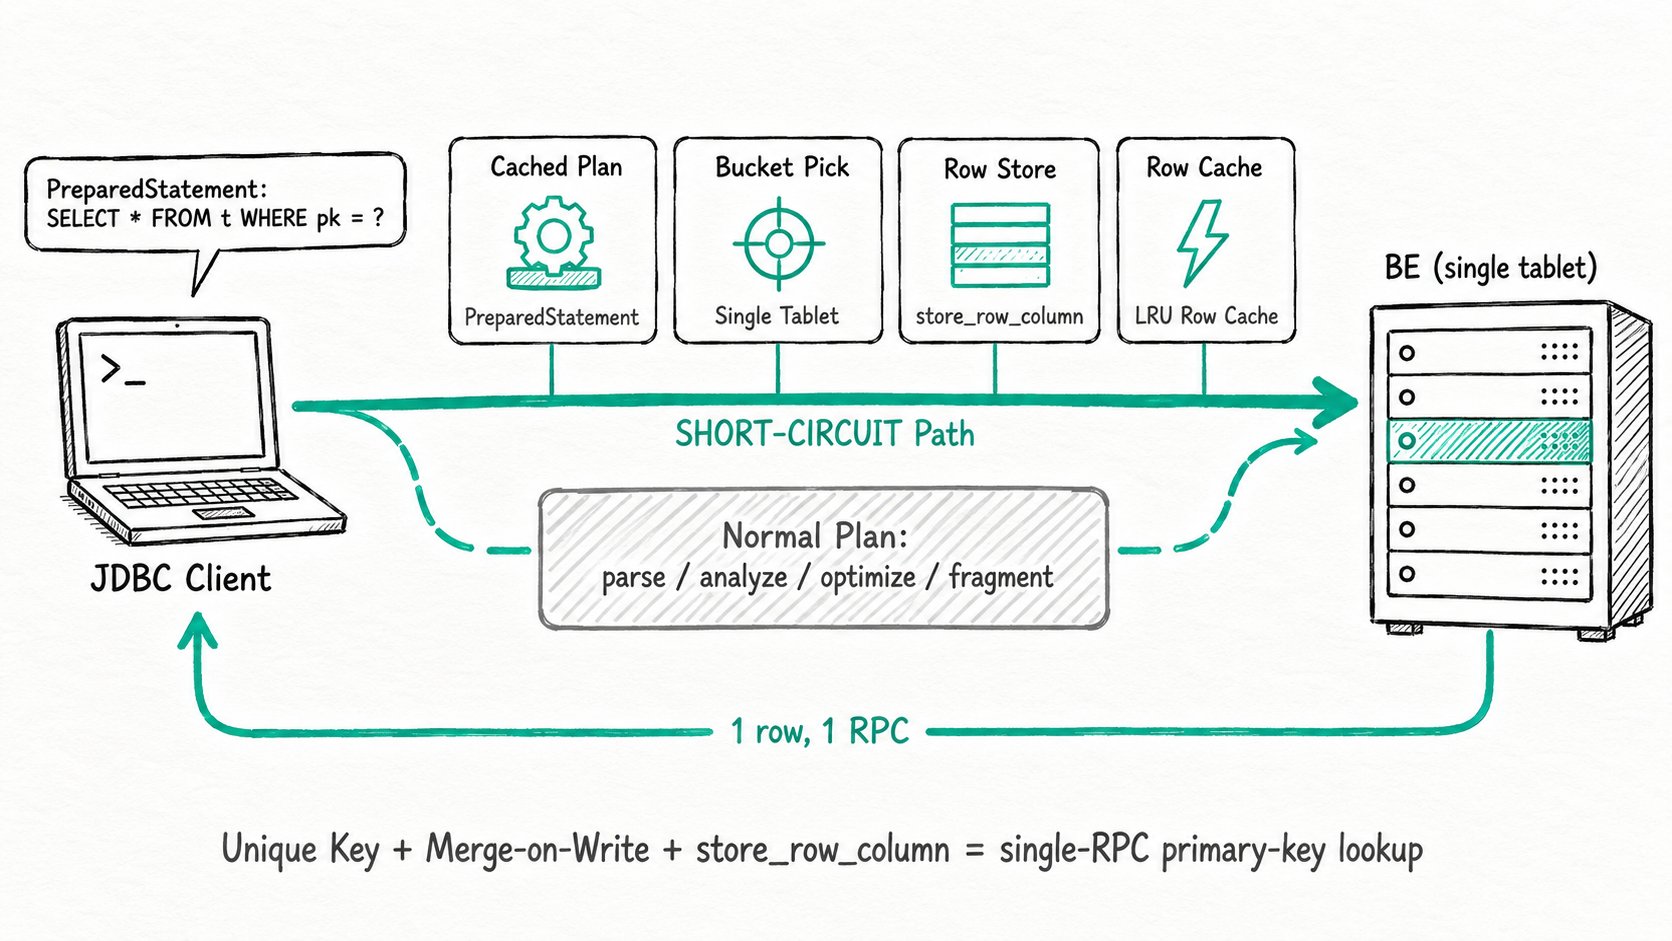
Apache Doris で高同時実行ポイントクエリを使う理由
Apache Doris の高同時実行ポイントクエリ経路は、多くの分析ワークロードに紛れ込む「ID で一行を検索する」クエリに対応します。ユーザー向けダッシュボードは、クリックされた顧客の行を取得します。リスク評価サービスは、API 呼び出しのたびにエンティティ ID で特徴量ベクトルを読み取ります。レコメンデーションのバックエンドは、ユーザーごとに最新のプロフィールを取得します。これらは分析クエリではありませんが、対象データは分析データと同じ場所にあります。そのためだけに別の KV ストアを運用するのは避けたいところです。
Apache Doris の通常の実行経路がこのようなトラフィックに適さない理由は、構造にあります。
- カラム指向ストレージでは、一行を復元するために小さなカラムファイルを多数読み取り、カラム数の多いテーブルではランダム I/O が増えます。
- Frontend のプランナーは、クエリが一行を読む場合も十億行を読む場合も、同じ解析、分析、最適化、フラグメント生成のパイプラインを実行します。数千 QPS では、BE より先に FE の CPU が飽和します。
- クエリごとにコーディネーターを起動し、フラグメントを割り当て、RPC を送信します。
WHERE id = 42のようなクエリには、このオーバーヘッドは大きすぎます。 - Page Cache はカラム単位で構成され、大規模な分析スキャンによって内容が頻繁に追い出されます。そのため、ポイントクエリは必要なときにキャッシュを利用できなくなります。
Apache Doris の高同時実行ポイントクエリは、このようなトラフィックに対応します。ストレージ、プランニング、実行、キャッシュを調整することで、主キー検索を一往復の通信と数マイクロ秒の FE CPU 時間で処理します。
Apache Doris の高同時実行ポイントクエリとは
Apache Doris の高同時実行ポイントクエリは、テーブルとクエリが厳密な条件を満たすと自動的に有効になる、四つの層からなる最適化です。対象は、Merge-on-Write と行ストアが有効な Unique Key テーブルに対し、主キーのすべてのカラムを等価述語で指定するクエリです。条件を満たすと、プランナーはショートサーキット経路を選び、BE はカラムごとのファイルから一行を組み立てる代わりに、行形式のカラムから読み取ります。
主な用語
Unique Key model:主キーで行を特定する Apache Doris のテーブルモデルです。enable_unique_key_merge_on_write=trueの場合、各行の最新バージョンが書き込み時に実体化されるため、読み取り時にバージョンをマージする必要がありません。store_row_column:各行を行形式でエンコードしたデータとして保持する隠しカラムを追加するテーブルプロパティです。これにより、BE は行全体を返す際に N 個のカラムではなく一つのカラムを読み取ります。SHORT-CIRCUIT:プランナーが通常の分散プランを省略し、一つのタブレットに対する一回の RPC を使う経路にクエリを送ったとき、EXPLAINの出力に表示されるマーカーです。PreparedStatement:MySQL プロトコルを介したサーバー側のステートメントキャッシュです。Apache Doris は解析済みステートメント、出力式、ディスクリプタテーブルをセッションごとにキャッシュし、EXECUTE呼び出し間で再利用します。Row Cache:行全体を保持する独立した LRU キャッシュです。分析クエリとポイントクエリが混在するワークロードで、カラム指向の Page Cache が受けるキャッシュ追い出しの影響を受けずに利用できます。
Apache Doris の高同時実行ポイントクエリの仕組み
Apache Doris の高同時実行ポイントクエリ経路は、ストレージレイアウト、FE によるプランの書き換え、ショートサーキットでのディスパッチ、サーバー側での PreparedStatement の再利用、オプションの Row Cache を使う BE の行検索という五つの層を連携させます。
- ストレージレイアウト。 テーブル作成時に
store_row_column=trueを設定すると、BE は各行をカラム指向のセグメントと、行形式でエンコードした隠しカラムの両方に書き込みます。Apache Doris 3.0 以降では、row_store_columns="k1,v1,v2"を使って対象を一部のカラムに限定し、ストレージのオーバーヘッドを抑えられます。 - プランの書き換え(FE)。 Nereids のルール
LogicalResultSinkToShortCircuitPointQueryは、単一の Unique テーブル、すべてのキーカラムに対する等価の連言述語、結合やサブクエリなし、集計なしというクエリの形を確認します。すべて一致すると、isShortCircuitQueryフラグをStatementContext内で有効にします。 - ショートサーキットでのディスパッチ。 FE はフラグメントの生成と送信の代わりに、
PartitionPruneV2ForShortCircuitPlanでバケットを特定し、そのキーを保持し得る一つのタブレットを選び、所有する BE に一回の RPC を送ります。 - サーバー側での
PreparedStatementの再利用。useServerPrepStmts=trueの場合、FE はShortCircuitQueryContextをセッション UUID ごとにキャッシュします。その後のEXECUTE呼び出しでは解析とプランニングをすべて省略し、パラメーター値だけを変更します。 - BE での行検索。
point_query_executorはキーで行を特定し、行形式のカラムを読み取ってバイト列を返します。オプションの Row Cache にヒットした場合は、セグメントの読み取りも省略します。
クイックスタート
CREATE TABLE tbl_point_query (
  k1 INT,
  v1 VARCHAR(64),
  v2 DECIMAL(27, 9)
)
UNIQUE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 1
PROPERTIES (
  "enable_unique_key_merge_on_write" = "true",
  "light_schema_change" = "true",
  "store_row_column" = "true"
);

EXPLAIN SELECT * FROM tbl_point_query WHERE k1 = 42;
期待される結果(抜粋)
0:VOlapScanNode
  TABLE: tbl_point_query, PREAGGREGATION: ON
  PREDICATES: k1 = 42 AND __DORIS_DELETE_SIGN__ = 0
  partitions=1/1, tablets=1/1
  SHORT-CIRCUIT
重要なのは SHORT-CIRCUIT の行です。同じ DDL でも、クエリが条件を満たせない場合(結合、キーカラムの指定漏れ、不等号による条件)は通常の分散プランに切り替わります。FE の CPU 使用量も削減するには、jdbc:mysql://host:9030/db?useServerPrepStmts=true&cachePrepStmts=true を指定してクライアントを接続し、PreparedStatement を ? プレースホルダーとともに使用します。繰り返し実行するクエリが、生の SQL ではなく fe.audit.log に Stmt=EXECUTE(...) として記録されることを確認してください。
Apache Doris の高同時実行ポイントクエリを使う場面
Apache Doris の高同時実行ポイントクエリは、リクエストごとに主キーで一行を読み取るオンラインサービスに適しています。特に、対象データが分析ワークロードとともに Unique Key テーブルに格納されている場合に有効です。
適したケース
- リクエストごとに主キーで一行を読み取るオンラインサービス。たとえば、ユーザープロフィール、特徴量ベクトル、状態フラグ、ルックアップテーブルです。
- 別の KV ストアを使うとデータと運用負荷が重複する、OLAP とポイントクエリの混合ワークロード。
- JDBC 経由で
PreparedStatementをすでに使用している、高 QPS のクライアント。 row_store_columnsによって行ストアの対象を頻繁に参照する少数のカラムに絞れる、カラム数の多い Unique Key テーブル。
適さないケース
- 範囲クエリ(
k1 BETWEEN 1 AND 1000)。ショートサーキット経路では、すべてのキーカラムに対する等価条件が必要です。通常のスキャンを使用し、データプルーニングを活用してください。 - 複数行に対する集計や結合。
GROUP BY pkでも書き換えの対象から外れます。通常の OLAP クエリとして実行してください。 - キー以外のカラムによる検索。行ストアではなく、セカンダリインデックスまたは転置インデックスを追加してください。
- 作成時に行ストアを有効にしなかったテーブル。
store_row_columnはCREATE TABLEでのみ設定できます。既存のテーブルに必要な場合は、再作成してデータを再ロードしてください。 - 書き込みが主体で読み取りがまれなワークロード。行形式のストレージは容量と書き込み I/O を増やします。キーによる読み取りがほとんどない場合は有効にせず、カラム指向ストレージのみを使用してください。
性能と確認方法
Apache Doris によると、FE の CPU がボトルネックの場合、ショートサーキット経路に加えてサーバー側の PreparedStatement を有効にすると、スループットが 4 倍以上向上します。これは Prepared Statement の紹介ページで、Prepared Statement の観点から示されているものと同じ 4 倍の効果です。二つの効果を重ね合わせたものではありません。数値は行の幅、Row Cache のヒット率、トラフィックを受け持つ FE Observer の数によって変わるため、ベンチマーク値ではなく計画上の下限として扱ってください。
次の二点で、この経路が有効であることを確認できます。
- 対象クエリの
EXPLAINで、スキャンノードにSHORT-CIRCUITが表示される。 - 繰り返し実行する検索が
fe.audit.logに、生の SQL 文字列ではなくStmt=EXECUTE(...)として表示される。
FE の CPU が引き続き上限となる場合は、Observer を増やし、JDBC のロードバランシング(jdbc:mysql:loadbalance://host1,host2,host3/db?useServerPrepStmts=true&cachePrepStmts=true)で接続を分散してください。コンピュートとストレージを分離した構成では、Base Compaction の出力をファイルキャッシュに残すため、SET GLOBAL enable_snapshot_point_query=false と BE のフラグ enable_file_cache_keep_base_compaction_output=1 も検討してください。
関連資料
- 高同時実行ポイントクエリ(詳細ガイド)
- Row Store のストレージレイアウト
- インデックスの概要:セカンダリ、Bloom、転置
- データプルーニング:ポイントクエリ以外を高速化する方法
- MPP アーキテクチャ:ポイントクエリのショートサーキット経路が省略する、分散実行の全経路。
- Unique Key:
store_row_columnと組み合わせることで KV ストアとして機能する、ポイントクエリ向けのテーブルモデル。
