ハイブリッド検索
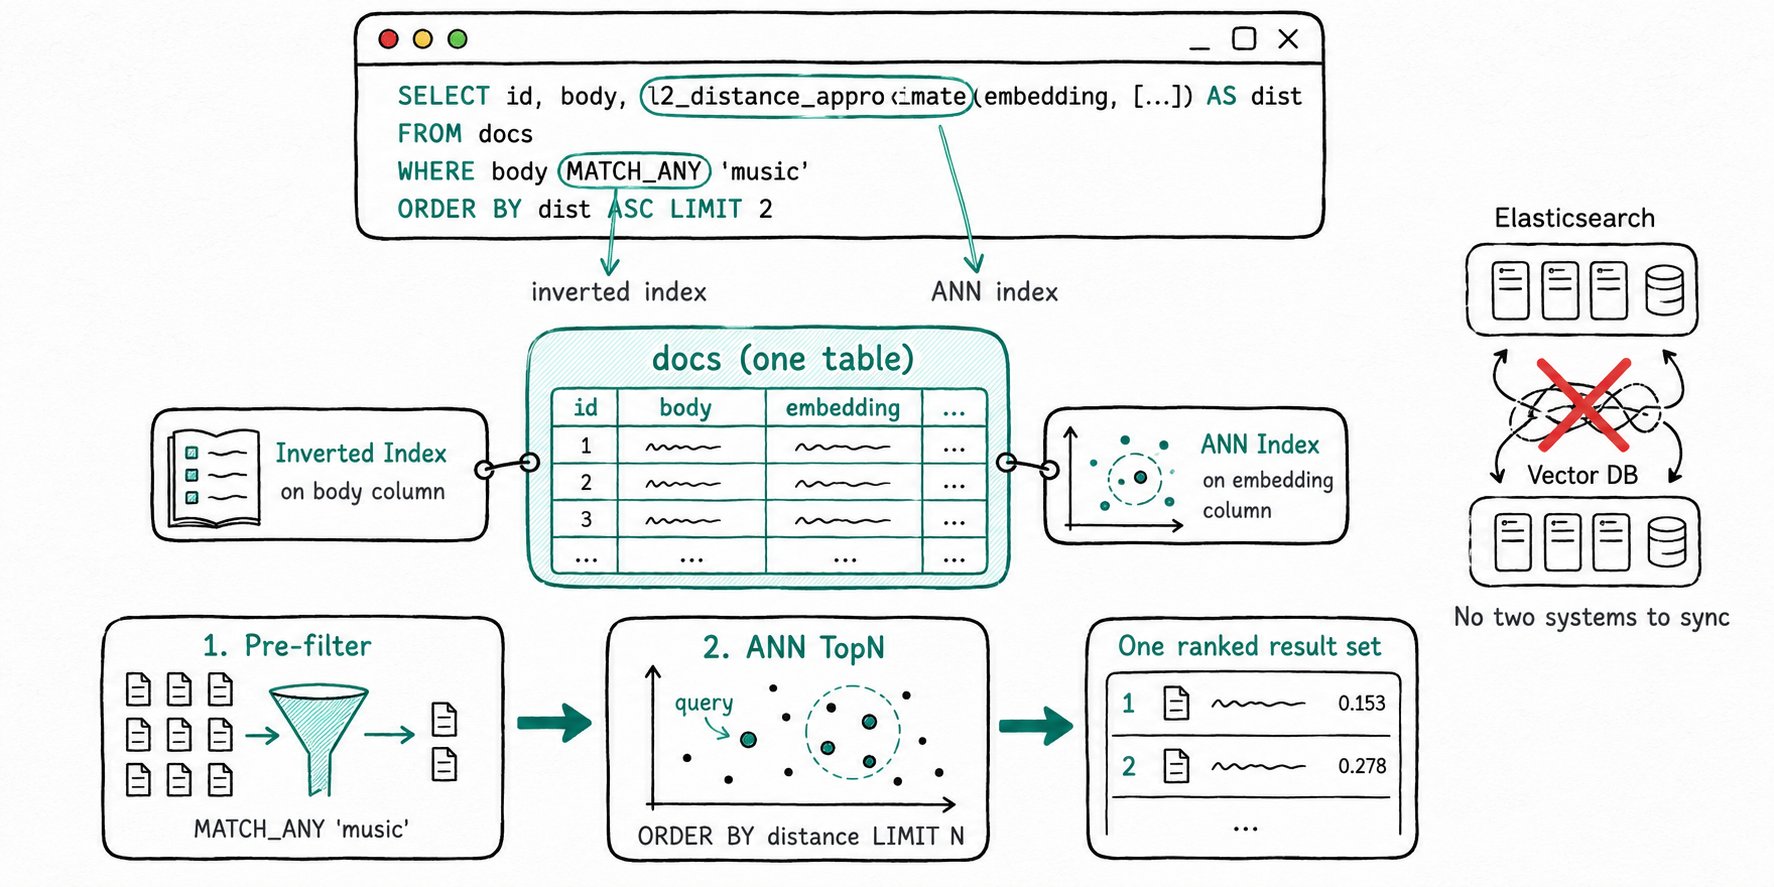
要約 Apache Doris のハイブリッド検索は、一つのテーブルに対する 一つの SQL クエリで全文マッチングとベクトル類似検索を組み合わせます。このテーブルには、通常なら Elasticsearch とベクトルデータベースに分けて格納する列に、転置インデックスとANN インデックスの両方を設定できます。一つの
WHERE句でMATCH_ANYとl2_distance_approximateを組み合わせ、フィルタリングとランキングを一度に行います。
Apache Doris でハイブリッド検索を使う理由
Apache Doris のハイブリッド検索は、二種類の検索方法を 一つの SQL クエリにまとめるため、データウェアハウスとは別に検索クラスタを運用する必要がありません。検索処理で使う方法は、通常 一種類だけではありません。たとえば「トレイル用の軽量ランニングシューズ」を探すユーザーは、「ランニング」や「トレイル」との完全一致を求めると同時に、「オフロード」や「荒れた地形」に言及する商品との意味的な一致も求めています。一般的には処理を 二つのシステムに分けて対応しますが、それには次のコストが伴います。
- 同期を保つ必要がある 二つのデータ取り込みパイプライン。同期がずれると検索結果の再現率も低下します。
- 手書きの結果統合ロジックでつなぐ 二種類のクエリ言語。
- サイジング、監視、費用負担が必要な 二つのクラスタ。
Apache Doris では、これらを 一つのテーブルと 一つの SQL 文にまとめ、ほかのクエリにも使う同じ MPP エンジンで処理します。
Apache Doris のハイブリッド検索とは
Apache Doris のハイブリッド検索は、独立したエンジンではなくクエリのパターンです。一つのテーブルに、MATCH_* 演算子と score() による BM25 スコアリングを支える転置インデックスと、l2_distance_approximate や inner_product_approximate などの近似ベクトル距離関数を支えるANN インデックスを設定できます。Apache Doris のプランナーは 一つのクエリで両方のインデックスを読み取り、順位付けされた 一つの結果セットを返します。
主な用語
- 転置インデックス:
STRING列に設定する全文検索用インデックスです。トークナイザーにはenglish、standard、中国語用のものがあります。 - ANN インデックス:
ARRAY<FLOAT>列に設定する近似最近傍インデックスです。バックエンドには HNSW、IVF、ディスク上の IVF があります。 - 事前フィルタリング:Apache Doris のデフォルトの方式です。まずスカラー条件とテキスト条件を適用し、残った行に対してベクトル距離による TopN を求めます。
Apache Doris のハイブリッド検索の仕組み
Apache Doris のハイブリッド検索では、ロード時に両方のインデックスを構築し、一つの MPP 実行計画で転置インデックスによるフィルタリングと ANN インデックスによるランキングを行います。
- ロード時のインデックス構築。 データを取り込むと、転置インデックスは各テキスト列をトークン化し、ANN インデックスは各ベクトルに対して HNSW グラフまたは IVF コードブックを構築します。どちらもベーステーブルと同じストレージ階層に配置されます。
- 単一の実行計画。 クエリで
MATCH_*演算子とベクトル距離関数を組み合わせると、プランナーはテキスト条件を転置インデックスに、距離関数を ANN インデックスに振り分けます。二つ目のクエリやクライアント側での結合は不要です。 - フィルタリング後にランキング。 Apache Doris はまず転置インデックスで事前フィルタリングを行い、残った行の集合に対して ANN TopN を実行します。これは一般的な「先に ANN、後でフィルタリング」という方式とは逆で、フィルタリング条件の選択性が高い場合にも高い再現率を保ちます。
- 適応的なフォールバック。 フィルタリングの選択性が非常に高く、ANN の探索で候補を除外しすぎる場合、Apache Doris はフィルタリング後の行集合に対する総当たりのベクトルスコア計算に切り替えます。SQL はそのまま使用でき、変わるのは実行経路だけです。
- 結果の返却。 ソートされ、件数が制限された 一つの結果セットを返します。外部の結果統合サービスやアプリケーション側のランキング処理は不要です。
クイックスタート
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  body STRING NOT NULL,
  INDEX idx_body(body) USING INVERTED PROPERTIES("parser"="english"),
  INDEX idx_vec(embedding) USING ANN
    PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music'),
  (2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today'),
  (3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend'),
  (4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update');

SELECT id, body,
       l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
FROM docs
WHERE body MATCH_ANY 'music'   -- inverted index pre-filter
ORDER BY dist ASC              -- ANN TopN over the filtered rows
LIMIT 2;
期待される結果
+------+---------------------+----------+
| id   | body                | dist     |
+------+---------------------+----------+
|    1 | this is about music | 0.663325 |
|    3 | latest music trend  | 1.280625 |
+------+---------------------+----------+
MATCH_ANY 'music' は、body に「music」を含む行に候補を絞ります。その後、ANN インデックスがそれらの行をクエリベクトルとの距離で順位付けし、最も近い 二行を返します。
Apache Doris のハイブリッド検索を使うべき場面
同じデータに対してキーワードによるフィルタリングとベクトル類似検索を 一つの SQL クエリで行いたい場合、別個のベクトルデータベースを運用せずに Apache Doris のハイブリッド検索を使用できます。
適した用途
- キーワード条件(テナント、文書タイプ、日付範囲)で検索対象を絞り込んでから意味的なランキングを行う RAG 検索。
- 構造化された条件(ブランド、価格、在庫の有無)と、タイトルや説明文の埋め込みベクトルの類似度を組み合わせる商品・カタログ検索。
- ユーザーが「X を含む」と「Y に似ている」という条件を日常的に組み合わせるログ・文書検索。
- SQL 分析用のデータをすでに Doris に保存しており、そのコピーをベクトルデータベースに送信したくないワークロード。
適さない用途
- フィルタリングも分析も行わない、数十億件規模の純粋な ANN 検索。専用のベクトルデータベースなら、クエリ当たりのメモリ使用量やコストを抑えられる場合があります。
AGGREGATE KEY、または merge-on-write を使用しないUNIQUE KEYが必要なテーブル。現時点で ANN インデックスを使用できるのはDUPLICATE KEYテーブルと MoWUNIQUE KEYテーブルです。- NULL を許可するベクトル列。ベクトル列は、インデックスと次元数が一致する
NOT NULL ARRAY<FLOAT>でなければなりません。 - 二種類のスコアリング結果に対する Reciprocal Rank Fusion が必要なワークロード。単一パスの方式では、キーワードによる事前フィルタリングの後にベクトル距離で順位付けします。BM25 のランキングとベクトルのランキングを統合するには、Reciprocal Rank Fusion の 二つのリストを使用する SQL パターンを使ってください。
比較
| 項目 | Doris のハイブリッド検索 | Elasticsearch + ベクトル DB | ベクトル DB のみ |
|---|---|---|---|
| データ取り込みパイプライン | 一つ | 二つ。同期が必要 | 一つ |
| クエリ経路 | 一つの SQL | アプリケーション側で結果を統合 | 一つの API |
| フィルタリングの表現力 | 完全な SQL(結合、範囲指定、集約) | DSL、限定的な結合 | タグとメタデータのみ |
| 同じデータに対する分析 | 完全な MPP SQL | 限定的 | なし |
同じデータに対して結合や集約も行いたい場合、Doris のハイブリッド検索が効果を発揮します。非常に大規模な純粋なベクトル検索には、通常、専用のベクトルデータベースのほうが運用しやすくなります。
関連ドキュメント
- ベクトルインデックス:ハイブリッド検索のベクトル側を支える ANN インデックス。
- 全文検索:トークナイザーや
MATCH_*演算子群を含む、転置インデックス側の仕組み。 - BM25 関連度スコアリング:
score()によるテキスト一致の順位付け。ベクトル距離と組み合わせることで、二種類のスコアを使うパターンを実現できます。 - Reciprocal Rank Fusion:単一パスによる統合では不十分な場合に、BM25 とベクトルのランキングを組み合わせる SQL パターン。
- Embedding:
EMBED()は、ANN インデックスが読み取るベクトルを生成します。 - ベクトルインデックスの概要:インデックスのプロパティとクエリパターンの詳細なリファレンス。
- 転置インデックスの概要:トークナイザー、MATCH 演算子、アナライザーの選択肢。
- ベクトル検索の実践ガイド:データの準備からチューニングまでの手順。
- Doris の AI 機能:ハイブリッド検索と Doris のほかの AI 機能との関係。
