転置インデックス
要点 Apache Doris の転置インデックスは、任意の列に
INDEX ... USING INVERTEDで定義する、CLucene を基盤としたセカンダリインデックスです。行をスキャンする代わりにポスティングリストを読み取り、等価条件、範囲条件、IN、IS NULL、配列の要素検索、全文検索のMATCH_*条件を高速化します。Apache Doris 2.0 から利用できます。
Apache Doris で転置インデックスを使う理由
Apache Doris の転置インデックスは、OLAP クエリで大きなコストを占める WHERE 条件の評価を、全件スキャンからポスティングリストの参照に変えます。例えば、2 TB のイベントテーブルで user_id の条件、request_time の範囲条件、url のキーワード検索を行う場合、インデックスがなければ、絞り込み後に残った各セグメントの全行について各列をデコードする必要があります。一般的な代替策である増分マテリアライズドビューや別の検索クラスターは、ストレージと運用のコストを倍増させます。
特にコストが高いケースは次のとおりです。
- 高カーディナリティ列の等価検索(
WHERE order_id = ?)では、セグメントを低コストで除外する手段がないため、タブレット全体をスキャンします。 - 数値列や日時列の範囲条件(
WHERE event_time BETWEEN ...)は、ZoneMap の最小値と最大値による絞り込みに限られ、範囲内のすべてのページにアクセスします。 - テキスト列のキーワード検索は、基本の SQL エンジンだけでは効率的に処理できません。
LIKE '%term%'はスキャンにフォールバックし、データを Elasticsearch に送る場合は同期を保つための別のパイプラインが必要です。
Apache Doris の転置インデックスは、同じ DDL でこれら三つのケースに対応します。
Apache Doris の転置インデックスとは
Apache Doris の転置インデックスは列単位のセカンダリインデックスです。各値、またはテキスト列をトークン化した各語を、それを含む行 ID の集合に対応付けます。CLucene(Lucene の C++ 移植版)を基盤とし、Apache Doris の列指向ストレージとベクトル化実行に統合されています。
転置インデックスは、DDL の INDEX <name>(<col>) USING INVERTED [PROPERTIES(...)] で定義します。対応する列型は、整数型、DECIMAL、DATE、DATETIME、IPV4、IPV6、CHAR/VARCHAR/STRING、およびこれらの型を要素とする ARRAY<T> です。テキスト列では、トークン化の方法を制御する parser を指定できます。
主な用語
- ポスティングリスト(
Posting list):値や語に対応する行 ID の集合です。条件の評価は、ポスティングリストの参照と集合演算(AND/OR/NOT)になります。 - パーサー(
Parser):テキスト列に使うトークナイザーです。組み込みの選択肢はnone(文字列全体を一語として扱うデフォルト)、english、chinese、unicode、standardです。3.1 以降ではカスタムアナライザーも利用できます。 MATCH operators(MATCH 演算子):MATCH_ANY(いずれかの語)、MATCH_ALL(すべての語)、MATCH_PHRASE(隣接する語)、MATCH_PHRASE_PREFIX、MATCH_REGEXPがあります。これらにはパーサーを設定した転置インデックスが必要ですが、通常の=とLIKEには必要ありません。.idx file(.idx ファイル):ディスク上のインデックス本体です。.idxファイルはタブレットディレクトリ内の各セグメントファイルの隣に一つずつ配置されるため、インデックスはセグメントに結び付いており、コンパクション時には行セットとともに処理されます。
Apache Doris の転置インデックスの仕組み
Apache Doris の転置インデックスは、インデックスを対象セグメントと同じ場所に配置し、一度構築して何度も参照する仕組みです。
- 書き込み時に構築する。 行セットがフラッシュされると、BE は隣接する
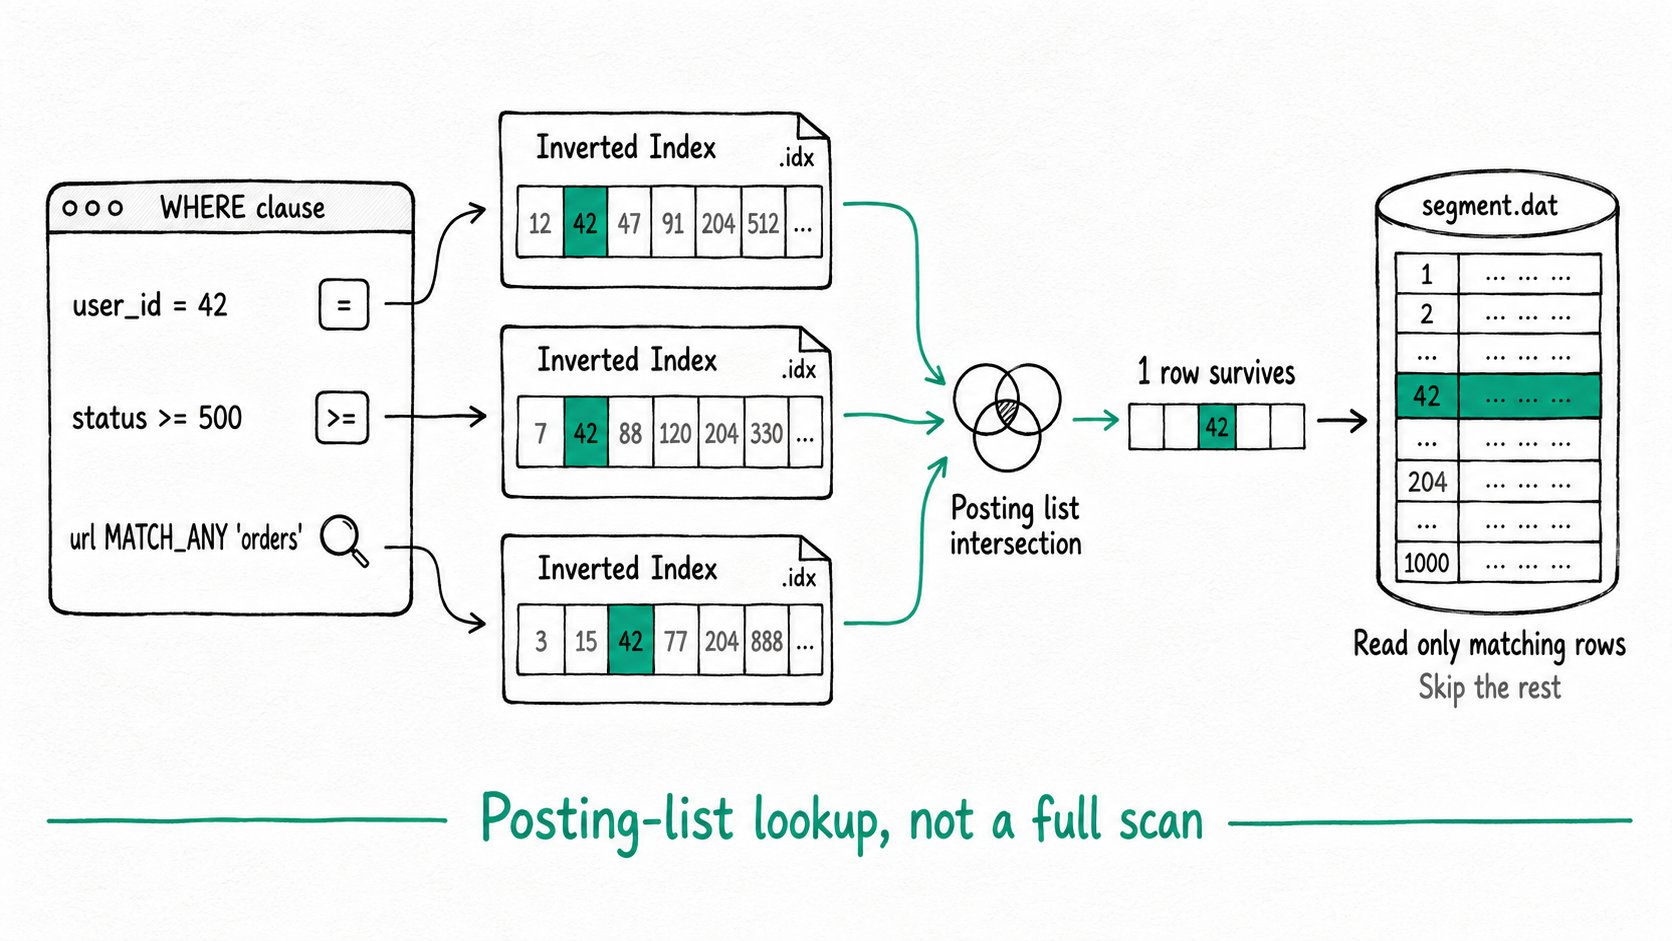
.idxファイルに CLucene 形式のインデックスを書き込みます。セグメント内の各行は CLucene のDocIDと 1 対 1 で対応するため、行とドキュメント ID の対応表を別途管理する必要はありません。 - クエリ時に参照経路を選ぶ。 プランナーがプッシュダウンした条件について、BE はまず転置インデックスを参照します。構築時と同じパーサーで条件のリテラルをトークン化し、語の辞書をたどってポスティングリストを読み取ります。
- 集合演算で結果を組み合わせる。 条件間の
AND、OR、NOTは、列データにアクセスせず、ポスティングリストの積集合、和集合、補集合として処理します。 - 行ビットマップをスキャナーに渡す。 スキャナーは、条件に一致した行だけを列指向ストアから読み取ります。ZoneMap、BloomFilter、転置インデックスの結果は組み合わせて使え、それぞれが後続の処理量を減らします。
- セグメント単位で管理する。 インデックスはセグメントの隣にあるため、コンパクション時にはデータとともにマージされ、リモートストレージへの階層化時にも一緒に移動します。再構築が必要なグローバルインデックスはありません。
クイックスタート
CREATE TABLE access_log (
  ts        DATETIME    NOT NULL,
  user_id   BIGINT      NOT NULL,
  status    INT         NOT NULL,
  url       STRING      NOT NULL,
  INDEX idx_user(user_id)  USING INVERTED,
  INDEX idx_status(status) USING INVERTED,
  INDEX idx_url(url) USING INVERTED PROPERTIES("parser"="english")
) DUPLICATE KEY(ts) DISTRIBUTED BY HASH(user_id) BUCKETS 4;

INSERT INTO access_log VALUES
  ('2026-05-01 10:00:00', 42, 200, '/api/orders/list'),
  ('2026-05-01 10:01:00', 42, 500, '/api/orders/create'),
  ('2026-05-01 10:02:00', 99, 200, '/api/users/profile');

SELECT user_id, status, url FROM access_log
WHERE user_id = 42 AND status >= 500 AND url MATCH_ANY 'orders';
期待される結果
+---------+--------+---------------------+
| user_id | status | url                 |
+---------+--------+---------------------+
|      42 |    500 | /api/orders/create  |
+---------+--------+---------------------+
各条件はインデックスの参照によって処理されます。user_id = 42 と status >= 500 は、等価条件と範囲条件にそれぞれ転置インデックスを使用します。url MATCH_ANY 'orders' は english パーサーで列をトークン化し、orders のポスティングリストを参照します。スキャナーが読み取るのは、三つのポスティングリストの積集合に残る一行だけです。
Apache Doris の転置インデックスを使う場面
Apache Doris の転置インデックスは、高カーディナリティ列の条件、テキストや配列の検索、ZoneMap による絞り込みが粗すぎる列で効果を発揮します。
適しているケース
- キー以外の列に対する高カーディナリティの等価条件や
IN条件:order_id、trace_id、device_id。 BETWEENを含む範囲条件:ZoneMap だけでは十分に絞り込めない数値列やDATETIME列。- 値がまばらに存在する列の
IS NULL/IS NOT NULL条件。インデックスは NULL を記録し、O(1) で参照します。 - ログ、文書、コンテンツの列に対するキーワード検索やフレーズ検索。演算子については全文検索、関連度による順位付けについてはBM25 スコアリングを参照してください。
- 配列の要素検索条件:
array_contains(tags, 'x')やarray_overlaps(tags, ['a','b'])。
適していないケース
- 先頭にワイルドカードがある
LIKE '%abc%'。転置インデックスは部分文字列を探すLIKEを高速化しません。代わりに NGram BloomFilter インデックスを使用してください。 - テーブルで最も頻繁に絞り込みに使う列。プレフィックスインデックスで処理できるようにキー列にします。プレフィックスインデックスのほうが密度が高く、追加コストもかかりません。
- 数百万行程度の小さなテーブルで、全件スキャンが数ミリ秒で終わる場合。インデックスの参照コストに比べて、スキャンを省略できるデータ量が十分に大きい場合にのみ効果があります。
- 条件にほとんどの行が一致する列。ポスティングリストは短いときに有利です。行の 80% が残るなら、どちらの方法でもスキャナーの処理量は変わりません。
- ストレージ容量に制約があるテーブル。幅の広いテキスト列では、転置インデックスが列自体と同程度のサイズになることがあります。テキスト検索より容量を重視する場合は、BloomFilter インデックスを使用してください。
関連情報
- 転置インデックスのユーザーガイド:DDL の全構文、パーサーのオプション、管理コマンド。
- 検索演算子のリファレンス:すべての
MATCH_*演算子と使用例。 - インデックスの概要:転置インデックスとプレフィックス、ZoneMap、BloomFilter、NGram BloomFilter の比較。
- 全文検索:このインデックスを基盤とするトークナイザー、フレーズクエリ、
SEARCH()DSL。 - BM25 関連度スコアリング:
score()による一致結果の順位付け。4.0 以降で利用できます。 - ハイブリッド検索:一つの SQL クエリで転置インデックスと ANN ベクトルインデックスを組み合わせる方法。
- Apache Doris の転置インデックスの仕組み:内部構造とベンチマークの詳しい解説。
