KafkaとCDCの連携
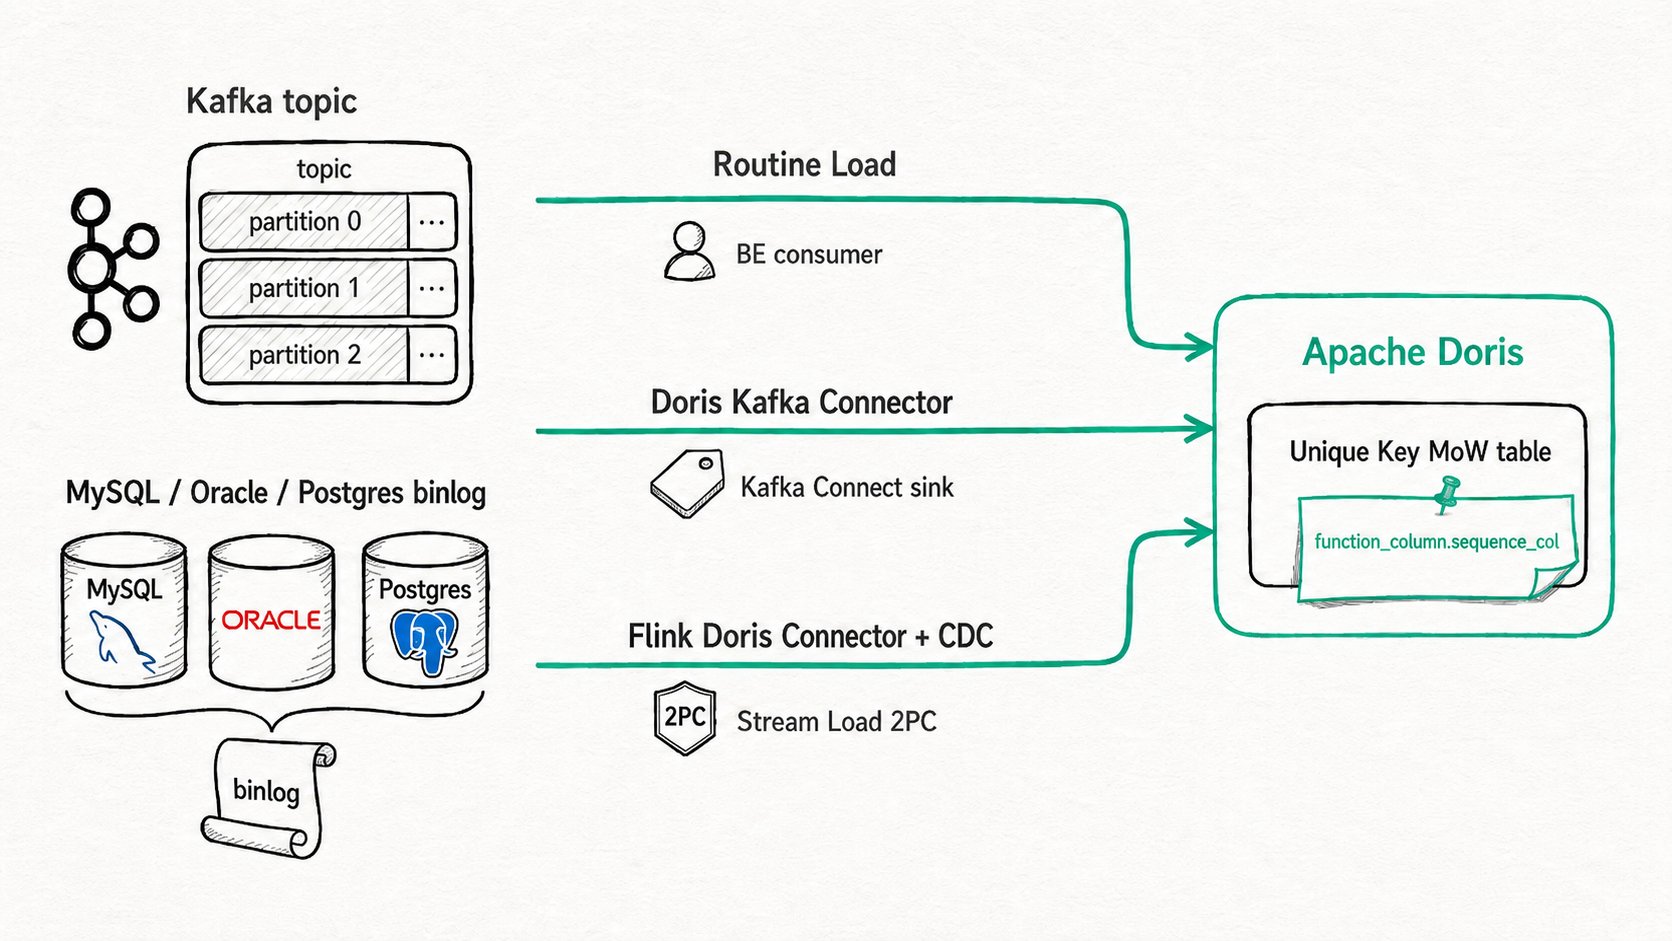
要約 Apache Dorisは、KafkaトピックとCDCの変更ストリームを三つの経路でネイティブに取り込みます。FE内で動作し、外部サービスを必要としないKafkaコンシューマーが欲しい場合は、Routine Loadを使います。MySQL/Postgres/Oracleのデータベース全体を同期し、Stream Load 2PCでexactly-onceを実現したい場合は、Flink CDCとFlink Doris Connectorを使います。Kafka Connectがすでに稼働していて、ペイロードがAvro、Protobuf、Debeziumの場合は、Doris Kafka Connectorを使います。どの経路も同じUnique Key Merge-on-Writeテーブルに書き込むため、到着順が前後するイベントや削除は、選んだ経路によらず同じように処理されます。
Apache DorisでKafkaとCDCの連携を使う理由
Apache DorisのKafkaとCDCの連携では、ストリーミング取り込み、exactly-once配信、到着順が前後するイベントの処理をエンジン内で行うため、トピックやbinlogからクエリ可能な行までの経路が短くなります。多くのデータウェアハウスでは、ストリーミング取り込みを後付けする必要があります。Kafkaコンシューマーを立て、オフセット管理、再試行、スキーマの対応付け、削除処理を実装し直したうえで、データウェアハウスが停止したときにコンシューマーも正常に停止することを期待することになります。Flinkを前段で動かすなら、追加のクラスターも必要です。あるいは「リアルタイム」を諦めて、バルクデータロードで五分ごとのバッチを送ることになります。
- CDCパイプラインがチェックポイントの失敗後に最後のバッチを再実行し、バッファに保持していたすべての行が二重になります。
- どの書き込みが新しいかをエンジンに伝える手段がないため、Unique Keyテーブルで到着順が前後した更新が古いバージョンに負けます。
- AvroやProtobufを含むKafkaトピックは、JSONかCSVしか扱えないHTTPデータロードAPIには適合しません。
Dorisはこうした処理の大半をエンジン内で行います。そのため、KafkaトピックやMySQLのbinlogからクエリ可能な行までの経路が短く、どのような障害が起こり得るかも明確です。
Apache DorisのKafkaとCDCの連携とは
Apache DorisのKafkaとCDCの連携は、共通の基盤を使うストリーミングおよびCDCの取り込み経路の集まりです。その基盤は、Labelで識別されるトランザクション型データロード、upsertと削除を処理するUnique Key Merge-on-Writeテーブル、そしてイベントの到着順が前後したときに採用するバージョンを決めるシーケンス列から成ります。経路によって異なるのは、コンシューマーをどこで動かすかです。
主な用語
Routine Load:FEが管理する、継続稼働型のKafkaコンシューマーです。CREATE ROUTINE LOAD文を一つ実行すると、FEがBEにタスクを割り当てます。BEはバッチを取得し、各バッチをトランザクション型データロードにします。Stream Load 2PC:後続の呼び出しでtxn_operation: commitまたはtxn_operation: abortが送られるまで、PRECOMMITTEDで停止するHTTPデータロードです。この二段階の処理によって、外部のシンクでexactly-onceを実現できます。Flink Doris Connector:Stream Load 2PCを駆動し、コミットをFlinkのチェックポイントに結び付ける外部Flinkシンクです。Flink CDCと組み合わせると、データベース全体を同期し、DDLも反映します。Doris Kafka Connector:Kafka Connectのシンクプラグインです。Kafka Connectのコンバーター群を利用できるため、カスタムシリアライザーなしでAvro、Protobuf、Debeziumのペイロードを扱えます。function_column.sequence_col:Unique Key MOWテーブルに設定するプロパティで、行のどのバージョンを採用するかを値によって決める列を指定します。到着順が前後するCDCイベントに備える仕組みです。
Apache DorisのKafkaとCDCの連携の仕組み
Apache DorisのKafkaとCDCの各取り込み経路では、データがFEに到達した後の流れは共通です。バッチを取得し、ラベル付きトランザクションにまとめ、確認を受けてコミットし、すべてのレプリカに公開します。
- コンシューマーがバッチを取得します。 Routine LoadはBEにタスクを割り当て、
max_batch_rows(デフォルトは20M行)、max_batch_size(デフォルトは1 GB)、max_batch_interval(デフォルトは60 s)のいずれかに達するまでKafkaから取得します。Flink CDCはチャンク形式のHTTP Stream Loadで行をストリーミングします。この接続はチェックポイントの処理中も開いたままです。 - バッチがトランザクションになります。 BEは
Label付きのトランザクションを開始します。Routine Loadはラベルを生成し、Flink Doris ConnectorはチェックポイントIDをラベルに付けます。どちらの場合も、同じラベルで再送すると重複が排除されます。 - 確認後にコミットします。 Routine Loadはバッチの取り込みが完了するとコミットし、成功した場合にのみKafkaのオフセットを進めます。Flink CDCは
PRECOMMITTEDで停止します。次のチェックポイントバリアでtxn_operation: commitが実行され、チェックポイントが失敗するとabortによって準備済みのデータが破棄されます。 - 公開後に行が見えるようになります。 バックグラウンドのデーモンが各レプリカに
PublishVersionを送ります。トランザクションがVISIBLEになると、新しい行をクエリできます。同じトランザクションに含まれるタブレットが部分的に見えることはありません。 - エラーが起きると、データではなくジョブが一時停止します。 Routine Loadのバッチで
max_error_number(デフォルトは0)を超えると、ジョブはPAUSEDになり、FEには最後のエラーURLが保持されます。ソースデータを修正してから再開できます。オフセットは元の位置にとどまります。
クイックスタート
CREATE TABLE events (
  user_id BIGINT, event_type STRING, ts DATETIME
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 8;

CREATE ROUTINE LOAD events_kafka ON events
COLUMNS(user_id, event_type, ts)
PROPERTIES (
  "format" = "json",
  "jsonpaths" = "[\"$.user_id\",\"$.event_type\",\"$.ts\"]"
)
FROM KAFKA (
  "kafka_broker_list" = "localhost:9092",
  "kafka_topic" = "events",
  "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
想定される結果
+--------+--------------+---------+----------------------+
| Id     | Name         | State   | Statistic            |
+--------+--------------+---------+----------------------+
| 100123 | events_kafka | RUNNING | {"loadedRows":4821,..|
+--------+--------------+---------+----------------------+
SHOW ROUTINE LOAD FOR events_kafkaを実行すると、RUNNING状態のジョブ、パーティションごとの最後に消費したオフセット、取り込んだ行数が表示されます。PAUSE、RESUME、STOPは、ほかのDorisジョブと同じように使えます。
CDCでは、コンシューマーをFlink CDCとFlink Doris Connectorに置き換えます(Flinkジョブ一つ、MySQLソース、Dorisシンク、sink.enable-2pc = true)。スキーマとシーケンス列はDoris側に定義します。
CREATE TABLE orders (
  order_id BIGINT, status STRING, updated DATETIME
)
UNIQUE KEY(order_id) DISTRIBUTED BY HASH(order_id) BUCKETS 8
PROPERTIES ("function_column.sequence_col" = "updated");
新しいCDCイベントより後に遅延したイベントが届いても、sequence_colの設定があれば古いupdatedの値は採用されず、新しい値が採用されます。到着順にかかわらず結果は同じです。
Apache DorisのKafkaとCDCの連携を使う場面
ストリーミングイベントや上流データベースの変更を、五分ごとのバッチではなく、exactly-once配信と正しい順序でDorisに取り込む必要がある場合に、Apache DorisのKafkaとCDCの連携を使います。
適しているケース
- CSVまたはJSONを含むKafkaトピックを、追加のサービスなしでDorisに取り込みたい場合。最も短い経路はRoutine Loadです。
- MySQL、Postgres、OracleのCDCを、exactly-once配信とDDLの反映を伴ってDorisに取り込みたい場合。Flink CDCとFlink Doris Connectorを使います。
- Kafka Connectがすでに稼働していて、ペイロードがAvro、Protobuf、Debeziumの場合。Doris Kafka Connectorなら形式の不一致を回避できます。
- 到着順が前後する書き込みでも正しい順序で処理する必要があるUnique Keyテーブル上のリアルタイムダッシュボード。上記のいずれかの経路に
function_column.sequence_colを組み合わせます。
適さないケース
- KafkaからAvroをRoutine Loadで取り込む場合。Routine Loadが読み取れるのはCSVとJSONだけです。上流で変換するか、適切なコンバーターを備えたDoris Kafka Connectorを使います。
- マイクロサービスからイベントごとに
INSERT INTO ... VALUESを実行する場合。KafkaやCDCの用途ではありません。BEが小さな書き込みをサーバー側でまとめられるよう、Group Commitを使います。 - Kafkaの保持期間が短いトピックでRoutine Loadを使う場合。保持期間が24 hでジョブが二日間一時停止すると、保存済みのオフセットが取得可能な最も古いオフセットより前になり、再開時にKafkaが「out of range」で拒否します。保持期間を延ばすか、バッファリングするコネクターを使います。
- FEだけでオフセットの遅延を監視する場合。現在、FEは遅延メトリクスを公開していません(未解決のissue)。Kafka側のコンシューマー遅延エクスポーターからメトリクスを収集するか、BE側の処理レートを監視します。
- クラウド環境またはストレージとコンピュートを分離した構成で、Merge-on-WriteのUnique KeyテーブルにStream Load 2PCを使う場合。BEがこの組み合わせを拒否するため、その環境ではFlink Connectorのexactly-once経路は
Labelによる重複排除とシーケンス列の組み合わせに切り替わります。オンプレミスのクラスターでは、MoWに対してStream Load 2PCの経路をすべて利用できます。
性能と数値
リリースブログ記事「FlinkからApache Dorisへのリアルタイム書き込みが高速性とexactly-onceを両立する仕組み」(2022年7月)によると、同時実行されるStream Loadが30件未満のとき、エンドツーエンドのレイテンシーは1秒未満でした。20個のFlinkタスクで、上流からの毎秒約100,000イベントを継続して処理しました。高い同時実行数では、従来のデータロード経路と比べてBEのCPU使用量が約25%低下しました。出典:Apache Dorisブログ。
関連資料
- Routine Loadのリファレンス
- Flink Doris ConnectorとFlink CDC
- Avro、Protobuf、Debezium向けDoris Kafka Connector
- データロードトランザクション:2PCを支えるモデル
- データの更新と削除:シーケンス列とMerge-on-Write
- Changelog / Table Stream:逆方向に流れる変更フィードで、Dorisの行の変更を下流のコンシューマーに公開します。
- Iceberg:整備されたCDCパイプラインの一般的な出力先です。SQLによる書き戻しによって、ほかのエンジンの読み取り側との同期を保てます。
- Unique Key:CDCシンクの書き込み先となるテーブルモデルです。ソースのLSNまたはコミット時刻に対応するシーケンス列と組み合わせます。