LLM SQL 関数
要約 Apache Doris には、行の列の値を外部 LLM に送信し、結果を SQL 内で直接返す
AI_*SQL 関数群があります。プロバイダーを AIRESOURCEとして一度設定すれば、値を指定できる場所でAI_CLASSIFY(...)、AI_EXTRACT(...)、AI_GENERATE(...)を使用できます。Snowflake の Cortex AISQL と Databricks の AI Functions も同様の用途を扱います。Apache Doris のAI_*関数群は、それらに相当するオープンソースの機能です。
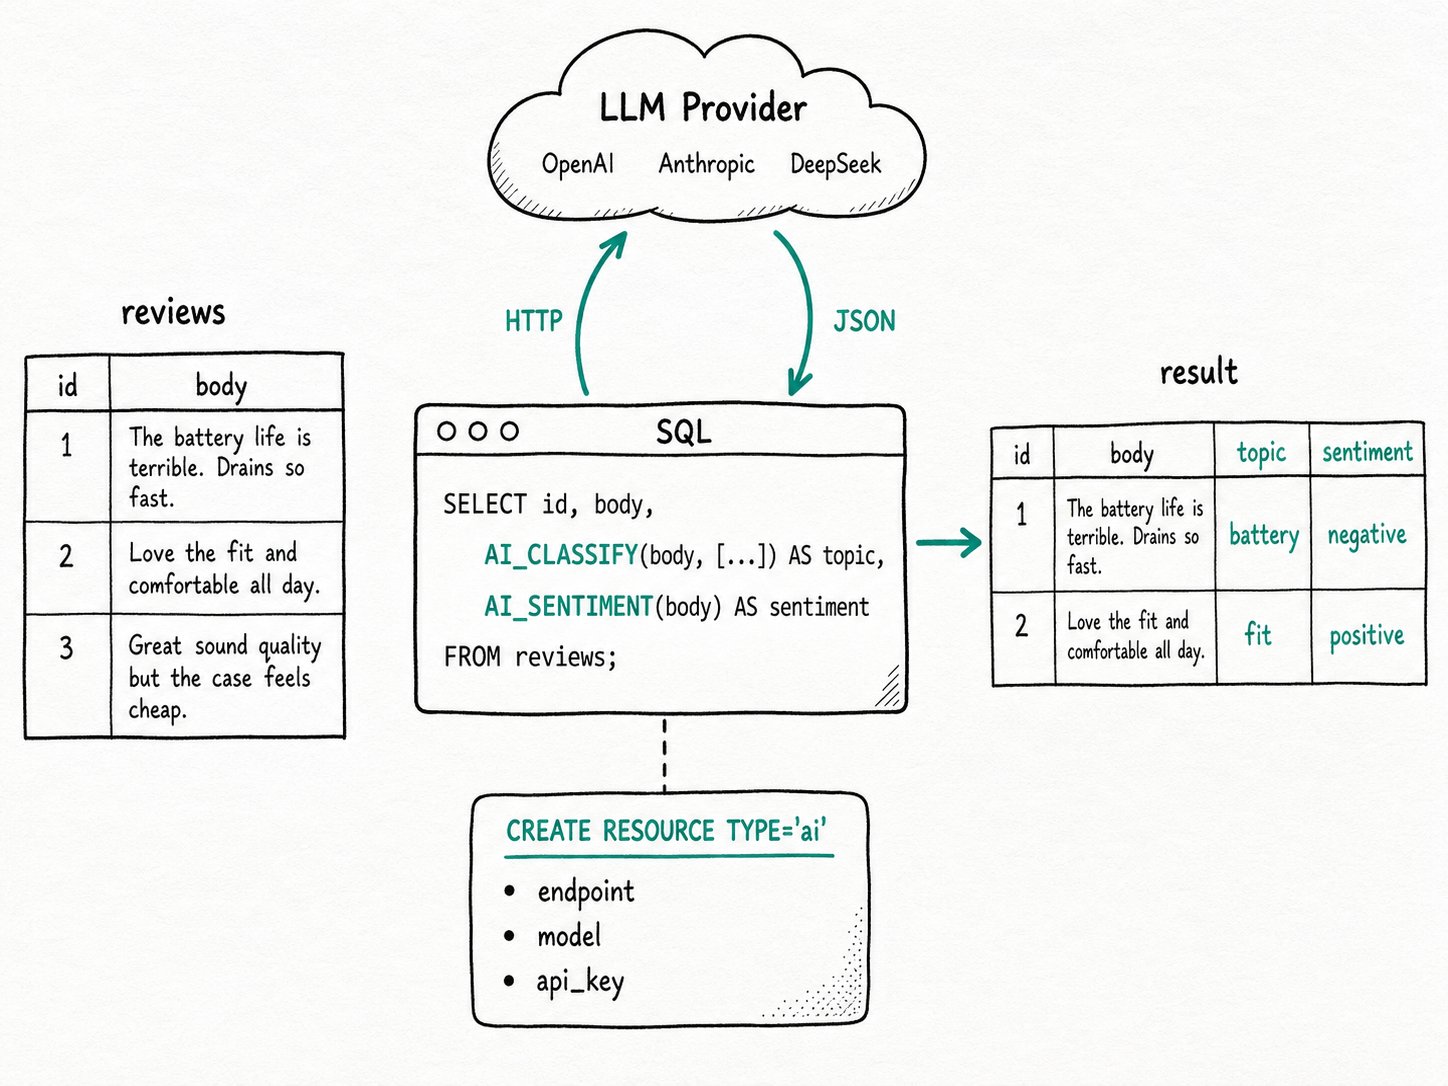
Apache Doris で AI_* SQL 関数を使う理由
Apache Doris の AI_* SQL 関数を使えば、テキスト列の分類、抽出、要約、個人を特定できる情報(PII)のマスキングのために外部の Python サービスを用意する必要がなくなります。テキスト列を使った分析作業の多くは、実際には分析ではありません。サポートチケットのトピック別分類、レビューの感情判定、自由記述の苦情からの商品名の抽出、長い通話メモの要約、エクスポート前の PII のマスキングなどが必要です。これらは繰り返し行う作業で、対象の列はすでにウェアハウスにあります。足りないのはモデルだけです。Apache Doris はすでに EMBED() で埋め込みを提供し、AI クライアント向けに MCP サーバー も提供しています。この機能は、SQL から呼び出せる AI 機能を補完します。
一般的な回避策は Python サービスです。Doris から行を取得し、OpenAI または Anthropic を呼び出して応答を解析し、結果を書き戻します。しかし、このサービスはソーステーブルとの同期がずれる可能性があり、独自のリトライ処理を持ち、ウェアハウスの権限管理や監視の枠外で動作します。
AI_* 関数は、この一連の処理を SQL に移します。モデルをリソースとして登録し、関数で呼び出します。結果は列として返されるため、INSERT で保存したり、WHERE でフィルタリングしたり、その場で計算したりできます。一つの言語、一つのトランザクション境界、監査ログを確認する一つの場所で扱えます。
Apache Doris の AI_* SQL 関数とは
Apache Doris の AI_* 関数群は、LLM プロバイダーへの HTTP 呼び出しをラップする、SQL から呼び出せる関数です。各関数は固定のプロンプトテンプレートを使って入力列を渡し、型のある結果を返します。そのため、プランナーは通常のスカラー関数と同様に扱います。Apache Doris は、CREATE RESOURCE ... TYPE='ai' で一度作成した AI リソースを通じてプロバイダーに接続します。よく使われるタスクには十個のスカラー関数が対応し、集約関数 AI_AGG は複数行を一つの LLM 生成結果にまとめます。
主な用語
- AI リソース:LLM プロバイダーへの名前付き接続です。
provider_type、エンドポイント、モデル名、API キー、調整用の設定値(temperature、max_token、max_retries、retry_delay_second)を保存します。対応するプロバイダーは十二種類です。OpenAI、Anthropic、Gemini、DeepSeek、MoonShot、QWen、MiniMax、Zhipu、Baichuan、VoyageAI、Jina、およびセルフホストのエンドポイント向けのlocalです。 AI_*スカラー関数:AI_GENERATE、AI_TRANSLATE、AI_SUMMARIZE、AI_SENTIMENT、AI_CLASSIFY、AI_EXTRACT、AI_FIXGRAMMAR、AI_MASK、AI_FILTER、AI_SIMILARITYです。それぞれ第一引数にリソース名、第二引数に列を取り、ラベルの集合や翻訳先言語など、タスク固有の引数を追加で取るものもあります。AI_AGG:グループ内のすべての行を連結し、カスタムプロンプトとともに LLM に送信して、グループごとに一つの要約を返す集約関数です。AI_SUMMARIZEのグループ版に相当します。default_ai_resource:セッションの残りの期間で使用するリソースを選択するセッション変数です。設定すると、明示的な第一引数を省略できます。
Apache Doris の AI_* SQL 関数の仕組み
Apache Doris の AI_* SQL 関数は BE 上でスカラー UDF として実行されます。プランナーが各呼び出しを振り分け、BE が行をバッチにまとめます。バッチごとにプロバイダーへ HTTP リクエストを一回送信し、型のある値を SQL に返します。
- モデルを登録する。
CREATE RESOURCEは検証用の呼び出しでエンドポイントを確認し(provider_type = 'local'の場合、またはai.validity_check = 'false'の場合は省略)、SHOW RESOURCESの出力では API キーをマスクし、設定を FE のメタデータに保存します。 - 呼び出しを計画する。 プランナーが
AI_*関数を検出すると、通常のスカラー UDF と同様に処理を BE に振り分けます。関数の第一引数にはリソース名のリテラルを指定する必要があり、式を指定すると解析時に拒否されます。 - BE でバッチ化する。 BE は入力行を、
embed_max_batch_size(デフォルトは 5)とai_context_window_size(蓄積したテキストのデフォルト上限は 128 KB)で制限されるバッチにまとめ、バッチごとに HTTP リクエストを一回送信します。上限を超える行は単独のバッチになるため、一つの長い文書がクエリの残りを停滞させることはありません。 - リトライとタイムアウトを適用する。 HTTP 呼び出しは、リソースの
ai.max_retriesとai.retry_delay_secondに従います。各リクエストには、セッションのquery_timeoutの残り時間が適用されるため、プロバイダーの応答が遅くてもクエリの制限時間は延長されません。 - 型のある値を返す。 スカラー関数は
STRINGを返します(BOOLEANを返すAI_FILTERと、DOUBLEを返すAI_SIMILARITYを除きます)。SQL から離れることなく、結果を保存したり、フィルタリングに使ったり、次の演算子に渡したりできます。
クイックスタート
CREATE RESOURCE "deepseek_chat" PROPERTIES (
  "type" = "ai",                     "ai.provider_type" = "deepseek",
  "ai.endpoint"   = "https://api.deepseek.com/chat/completions",
  "ai.model_name" = "deepseek-chat", "ai.api_key" = "sk-xxx"
);
SET default_ai_resource = "deepseek_chat";

CREATE TABLE reviews (id INT, body STRING)
  DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;
INSERT INTO reviews VALUES
  (1, 'Battery dies in 4 hours. Returning it.'),
  (2, 'Fits perfectly, color is exactly as pictured. Love it.');

SELECT id, body, AI_SENTIMENT(body) AS sentiment,
       AI_CLASSIFY(body, ['battery', 'fit', 'price', 'shipping']) AS topic
FROM reviews;
期待される結果
+----+--------------------------------+-----------+---------+
| id | body                           | sentiment | topic   |
+----+--------------------------------+-----------+---------+
|  1 | Battery dies in 4 hours...     | negative  | battery |
|  2 | Fits perfectly, color is...    | positive  | fit     |
+----+--------------------------------+-----------+---------+
このクエリは関数ごとに一回、合計二回の LLM との往復通信を行います。それぞれの呼び出しでは両方の行がバッチ化されます。出力列は文字列型なので、後続の GROUP BY topic や結合に解析処理は不要です。
Apache Doris の AI_* SQL 関数を使うべき場面
Apache Doris の AI_* 関数は、バッチでのデータ付加、ETL のバックフィル、複数行の集約に適しています。一方、対話的な一秒未満のクエリや厳密な再現性が求められるワークロードには適していません。
適した用途
- テキスト列へのバッチでのデータ付加。たとえば、サポートチケットを毎晩分類する、新しいレビューの感情を判定する、取り込み時に請求書から構造化フィールドを抽出するといった用途です。
- データベース内でのバックフィル。
UPDATE t SET topic = AI_CLASSIFY(body, [...]) WHERE topic IS NULLなら、処理を一か所にまとめ、Doris のトランザクションを利用できます。 AI_AGGによる複数行の集約。製品ごとの苦情の週次要約、会議メモの経営層向け要約、ニュース記事のテーマ別ダイジェストなどです。WHERE句での意味的なフィルタリング。AI_FILTER('Is this a security incident?', body)は、専用の分類モデルを構築するほどではない一時的なトリアージに使えます。
適さない用途
- ダッシュボードが更新されるたびに各行で
AI_*を呼び出すこと。行ごとにプロバイダーへの呼び出しが発生し、費用は行数と更新頻度に応じて増えます。結果を列に保存してインデックスを設定し、その列をクエリしてください。事前計算の方法については、インクリメンタルマテリアライズドビューを参照してください。 - 対話的な一秒未満のクエリ。LLM の推論には、速くても数百ミリ秒かかり、レート制限によって遅い側の応答時間はさらに長くなります。
AI_*はバッチ処理や ETL に使用し、ユーザーのボタン操作を待たせるクエリには使用しないでください。 - 類似する項目を探す検索タスク。埋め込み列、ベクトルインデックス、
cosine_distanceを組み合わせるほうが高速で安価、かつ再現可能です。SQL 内で処理する方法については、Embedding を参照してください。 - 厳密な再現性が必要な処理。
temperature = 0に固定しない限り、プロバイダーの応答は非決定的です。固定した場合でも、モデル側の小さな更新によって出力は変わります。クエリごとに再計算せず、結果のスナップショットを保存してください。 - 対応するプロバイダー一覧にないプロバイダーが必要なワークロード。十二種類の
provider_typeに含まれないものは、OpenAI、Anthropic、Gemini のいずれかと互換性のある API を公開するか、localエンドポイントとして実行する必要があります。
関連ドキュメント
- Doris の AI 機能:
AI_*関数、埋め込み、ベクトル検索、MCP サーバーの関係を含む、AI 機能の全体像。 - AI 関数の概要:対応するすべてのプロバイダー、
CREATE RESOURCEのプロパティ一覧、各関数の個別の例。 - Embedding:
EMBED()は同じ AI リソースの仕組みを共有します。次にベクトル検索を行う場合に適した機能です。 - ハイブリッド検索:LLM が生成した列を、同じクエリ内で全文検索や ANN の条件と組み合わせる方法。
- Snowflake Cortex AISQL リファレンス:データウェアハウス間で比較する際に最も近い機能。
- MCP サーバー:AI 機能のもう一方の側面であり、AI クライアントが Model Context Protocol のツールを介して Doris にクエリできるようにします。
- VARIANT データ型:
AI_EXTRACTなどが生成する JSON 出力の保存先に適しています。 - Databricks AI Functions:同様の機能に対する別のベンダーのアプローチ。
