MPP アーキテクチャ
要約 Apache Doris の MPP は、一つの SQL クエリを、クラスタ内の各 BE で並列実行される
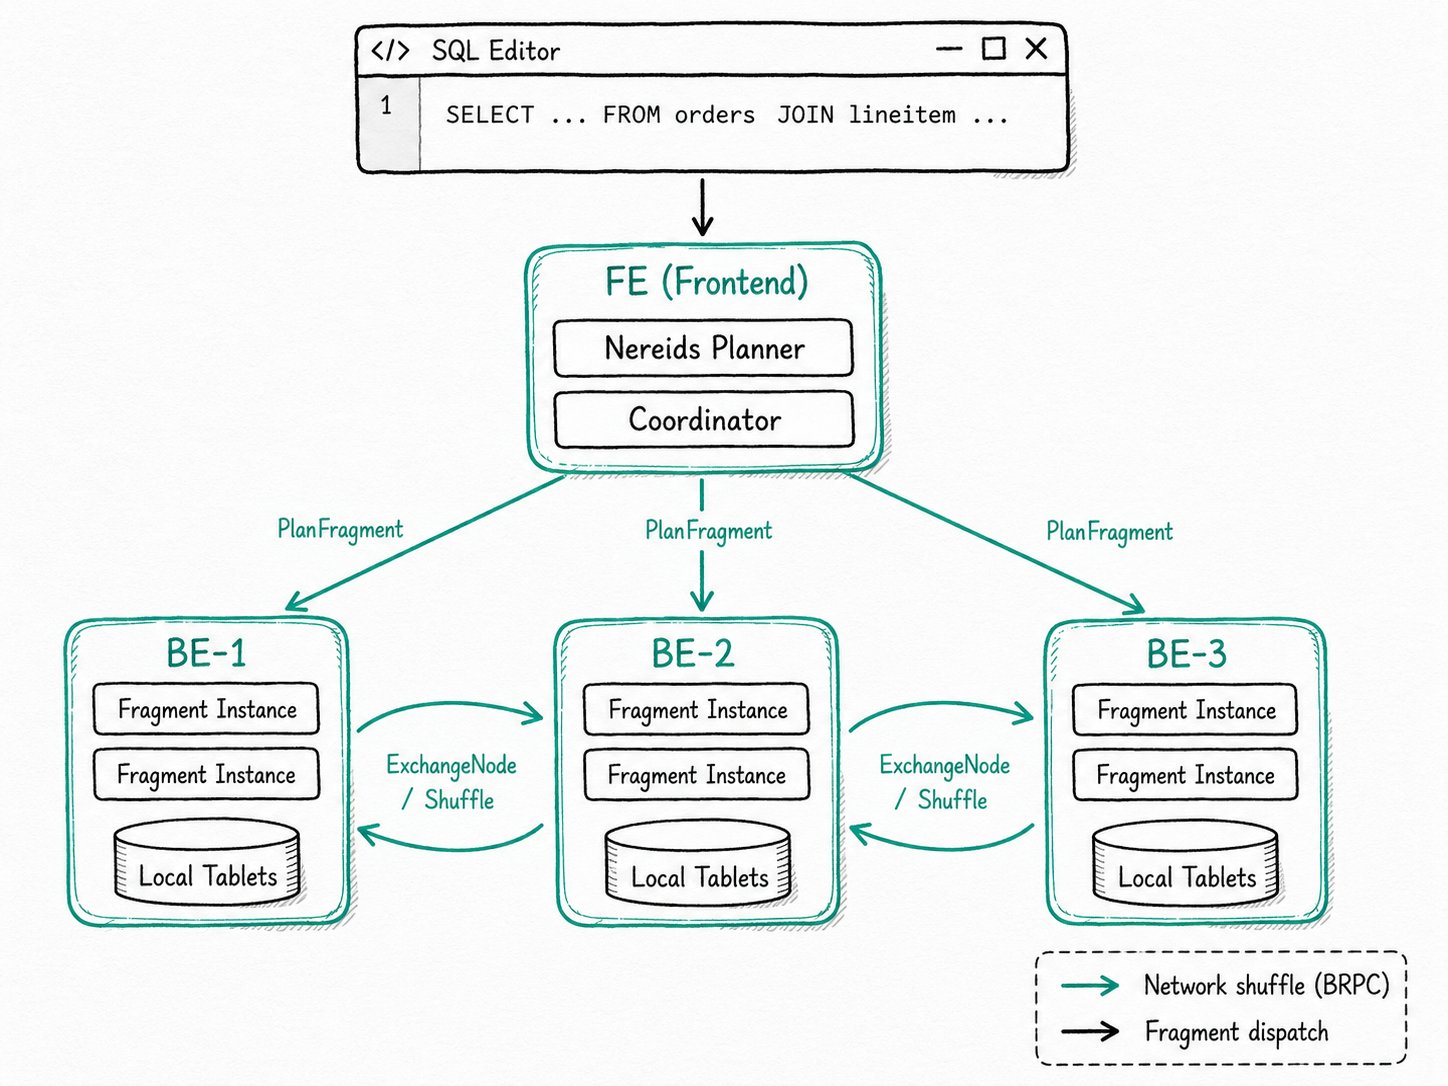
PlanFragmentの DAG に変換します。FE 側のCoordinatorは Nereids オプティマイザを使って DAG を計画し、各フラグメントを BRPC 経由で担当の BE に送信し、ExchangeNodeとDataStreamSinkによるシャッフルでフラグメントをつなぎます。シェアードナッシングのストレージとクエリごとのメモリ上限(exec_mem_limit、デフォルト 2 GB)により、クラスタを水平に拡張できます。BE を追加するたびに、同じクエリ実行基盤で利用できる CPU、メモリ、ローカルタブレットが増えます。
Apache Doris で MPP を使う理由
Apache Doris の MPP を使うと、一つの分析クエリで、一台のマシンだけでなくクラスタ内のすべての CPU を利用できます。10 × 十億行の集計、五つのファクトテーブルを結合する処理、一年分のログを対象とする多数の列による GROUP BY は、いずれも一ノードでは実用的な時間内に完了しません。MPP レイヤーによって、「より大きなマシンを購入する」代わりに「BE を追加する」ことで対応できます。
解決する課題は次のとおりです。
- 単一ノードでの処理には限界があります。 一テラバイトのカラムナデータを扱うクエリでは、スキャン、フィルタ、結合、集計の処理を一台に集中させず、複数のマシンに分散する必要があります。
- 手動シャーディングはデータチームの負担になります。 シャードごとのテーブルに対して手書きした UNION クエリは、結合キーの変更やシャードのリバランスが起きると維持が難しくなります。
- ストレージへのアクセスがボトルネックになると計算資源が無駄になります。 計算のためにシャードを一台へ集めると、クラスタ内でそのまま処理できるデータの転送にネットワークを使うことになります。
Apache Doris の MPP では、プランナーがクエリを分割してデータのある場所へ処理を送り、ネットワークを越える必要がある行だけをシャッフルします。
Apache Doris の MPP アーキテクチャとは
Apache Doris の MPP は、Frontend(FE)がクエリを PlanFragment の DAG として計画し、Backend(BE)がローカルのタブレットに対して各フラグメントを並列実行する、シェアードナッシング型の分散実行モデルです。Nereids オプティマイザは SQL を論理プランに変換してシャッフルの境界で分割し、FE の Coordinator が各 PlanFragment を一連の BE に割り当てます。各 BE はフラグメントから一つ以上の フラグメントインスタンスを作成し、BE 内部のパイプラインスケジューラがそれらをスレッド上で実行します。フラグメント間のデータは、受信側の ExchangeNode と送信側の DataStreamSink を通り、Block としてシリアライズされて BRPC 経由で転送されます。
主な用語
PlanFragment: FE が BE に送信する分散処理の最小単位です。一つのクエリは、フラグメントで構成される一つの DAG です。- フラグメントインスタンス: 一台の BE で実行される
PlanFragmentの実行時のコピーです。同じフラグメントのインスタンスを複数の BE で実行することで、水平並列性が得られます。 Coordinator: フラグメント DAG の構築、BE の割り当て、フラグメントの送信、結果の収集、障害への対処を担う FE 側のオブジェクトです。実装はfe/fe-core/src/main/java/org/apache/doris/qe/Coordinator.javaにあります。ExchangeNode/DataStreamSink: ネットワーク経由でフラグメント間のデータを移動する受信側と送信側の組です。プランナーが各シャッフル境界に挿入します。- 分散モード: シャッフル時にネットワーク上で行を振り分ける方法です。
UNPARTITIONED、RANDOM、HASH_PARTITIONED、BUCKET_SHFFULE_HASH_PARTITIONEDがあります。 - Nereids プランナー: 結合順序、シャッフル方法、並列度を選択する Cascades 方式のコストベースオプティマイザです。旧プランナーは削除されており、
enable_nereids_plannerスイッチはREMOVEDとされています。
Apache Doris の MPP アーキテクチャの仕組み
Apache Doris の MPP は五つの段階で動作します。FE がフラグメントを計画、分割、送信し、各 BE が受け取ったフラグメントをパイプラインタスクに変換します。タブレットをローカルでスキャンし、プランで必要な場合に限って ExchangeNode を介してデータをシャッフルし、最後に一つのルートフラグメントが結果をクライアントへ返します。
- 計画と分割。 Nereids オプティマイザが SQL を物理プランに書き換えます。FE はツリーをたどり、データの再分散が必要な箇所(すべてのキーを一台に集める必要がある集計、両側を同じ方法でハッシュ分割する必要があるハッシュ結合、最終結果のシンク)で
PlanFragmentに分割します。 - シャッフル方法の選択。 プランナーはフラグメントの各境界で四つの分散モードから一つを選びます。ハッシュ結合では、Broadcast Join(右側を左側の各インスタンスへコピー)、Shuffle Join(両側を結合キーでハッシュ分割)、Bucket Shuffle Join(左テーブルのバケット配置を再利用し、右側だけを転送)、Colocate Join(両テーブルがすでに同じ BE に配置されているため、シャッフルを省略)の四つの方式から選びます。どの方式を実行するかはコストで決まります。
- 送信とインスタンス化。
Coordinatorは各フラグメントを、割り当てた BE へ BRPC 経由で送信します。各 BE は並列実行スロットごとにフラグメントインスタンスを作成し、スケジューリングのために Pipeline Execution Engine へ渡します。 - ローカルでのスキャンと必要に応じたシャッフル。 スキャンオペレータは同じ BE 上のタブレットを読み取るため、大部分のデータはネットワークを越えません。次のフラグメントが必要とする行だけが、カラムナ形式の
Blockとしてシリアライズされ、DataStreamSink→ExchangeNodeを通って転送されます。 - 結果の返却。
UNPARTITIONEDシンクを持つルートフラグメントが一台の BE で実行され、統合された結果を集めて FE に送り、FE が MySQL プロトコルでクライアントにストリーミングします。
クイックスタート
有効化の操作は不要です。すべてのクエリが MPP で実行されます。運用時に特に役立つのは EXPLAIN です。フラグメント DAG、分散モード、オプティマイザが選択したシャッフル方式を確認できます。
EXPLAIN
SELECT o.o_orderpriority, COUNT(*) AS orders, SUM(l.l_extendedprice) AS revenue
FROM   orders o
JOIN   lineitem l ON o.o_orderkey = l.l_orderkey
WHERE  o.o_orderdate >= '2026-01-01'
GROUP BY o.o_orderpriority
ORDER BY revenue DESC
LIMIT 10;
想定される結果(抜粋)
PLAN FRAGMENT 2  (BUCKET_SHFFULE_HASH_PARTITIONED on o_orderkey)
  HASH JOIN   join op: INNER JOIN  ... (Bucket Shuffle)
    SCAN orders  (partitions=12, tablets=120, ...)
    EXCHANGE  HASH_PARTITIONED  <-- from FRAGMENT 1
PLAN FRAGMENT 1  (RANDOM)
  SCAN lineitem  (partitions=48, tablets=480, ...)
PLAN FRAGMENT 0  (UNPARTITIONED)
  RESULT SINK
  AGGREGATE (merge finalize)
    EXCHANGE  HASH_PARTITIONED  <-- from FRAGMENT 2
フラグメントは三つです。フラグメント 1 は、タブレットを保持する各 BE 上で lineitem をスキャンし、l_orderkey で行をハッシュ化して、Exchange を介してフラグメント 2 に送ります。フラグメント 2 は Bucket Shuffle で orders と結合します(orders は o_orderkey でバケット分割されているため、そのタブレットは移動しません)。続いて o_orderpriority で事前集計し、部分集計したグループをフラグメント 0 に送ります。フラグメント 0 は集計を確定し、ソートして結果を書き込みます。
Apache Doris の MPP アーキテクチャを使う場面
Apache Doris の MPP は、すべての分析クエリのデフォルトの実行モードです。一般的な SELECT に別の実行経路はありません。MPP を前提にチューニングしてください。
適した用途
- 数千万行から数十億行を対象とする分析スキャン。多数の列による GROUP BY、大規模な結合、時間窓での集計。
- スタースキーマやスノーフレークスキーマの結合。Broadcast よりも Bucket Shuffle や Colocate Join を選択することは、Nereids オプティマイザが担う重要な役割です。
- クエリをすべての BE に分散させたいマルチテナントクラスタ。テナントごとに CPU とメモリを分離するには、MPP と Workload Group を組み合わせます。
- データに偏りがある環境での長時間実行クエリ。MPP プランナーのシャッフル方法の選択は、各 BE 内の偏りを緩和する Local Shuffle にも反映されます。
適さない用途
- 一秒あたり数千件の単一行の主キー検索。計画、フラグメントの送信、BRPC の往復にかかるコストが、検索処理そのものを大きく上回ります。代わりに高並列ポイントクエリを使用してください。
- MPP を行単位の OLTP エンジンとして使うこと。行ごとのトランザクションレイヤーはなく、更新には Unique Key テーブルと一括ロードの経路を使います。
- MPP と Pipeline、ベクトル化実行を混同すること。この三つは重なるレイヤーであり、相互に置き換えられるものではありません。Pipeline Execution Engine は一台の BE 内でオペレータを実行し、ベクトル化実行はカラムのバッチに対する内部ループを実行します。MPP は BE 間でこれらを調整します。
- 小規模なクラスタ上の小さなテーブル。テーブル全体が一つのフラグメントのメモリに収まり、一台の BE の CPU で一秒以内に処理できるなら、プランナーは一台の BE での Broadcast Join を選択します。それが適切な方法です。
関連資料
- 製品の概念: Fragment、Instance、Exchange: 他のドキュメントの基礎となる、ユーザー向けの正式な定義です。
- システムアーキテクチャ: FE と BE の役割、FE の合意形成に使われる BDBJE、トポロジー内での Coordinator の位置を説明します。
- 結合の最適化とシャッフル方式: Broadcast、Shuffle、Bucket Shuffle、Colocate Join のコスト上のトレードオフを例とともに説明します。
- Pipeline Execution Engine: MPP からフラグメントを受け取る BE 内部のスケジューラです。BE 内での処理の詳細を確認できます。
- 並列度のチューニング: ワークロードごとに
parallel_pipeline_task_numを変更する場面と方法を説明します。 - Apache Doris 実行エンジンの進化: Volcano から Pipeline、PipelineX への設計の変遷と、その過程での MPP プランナーの変化を紹介します。
