クエリキャッシュ
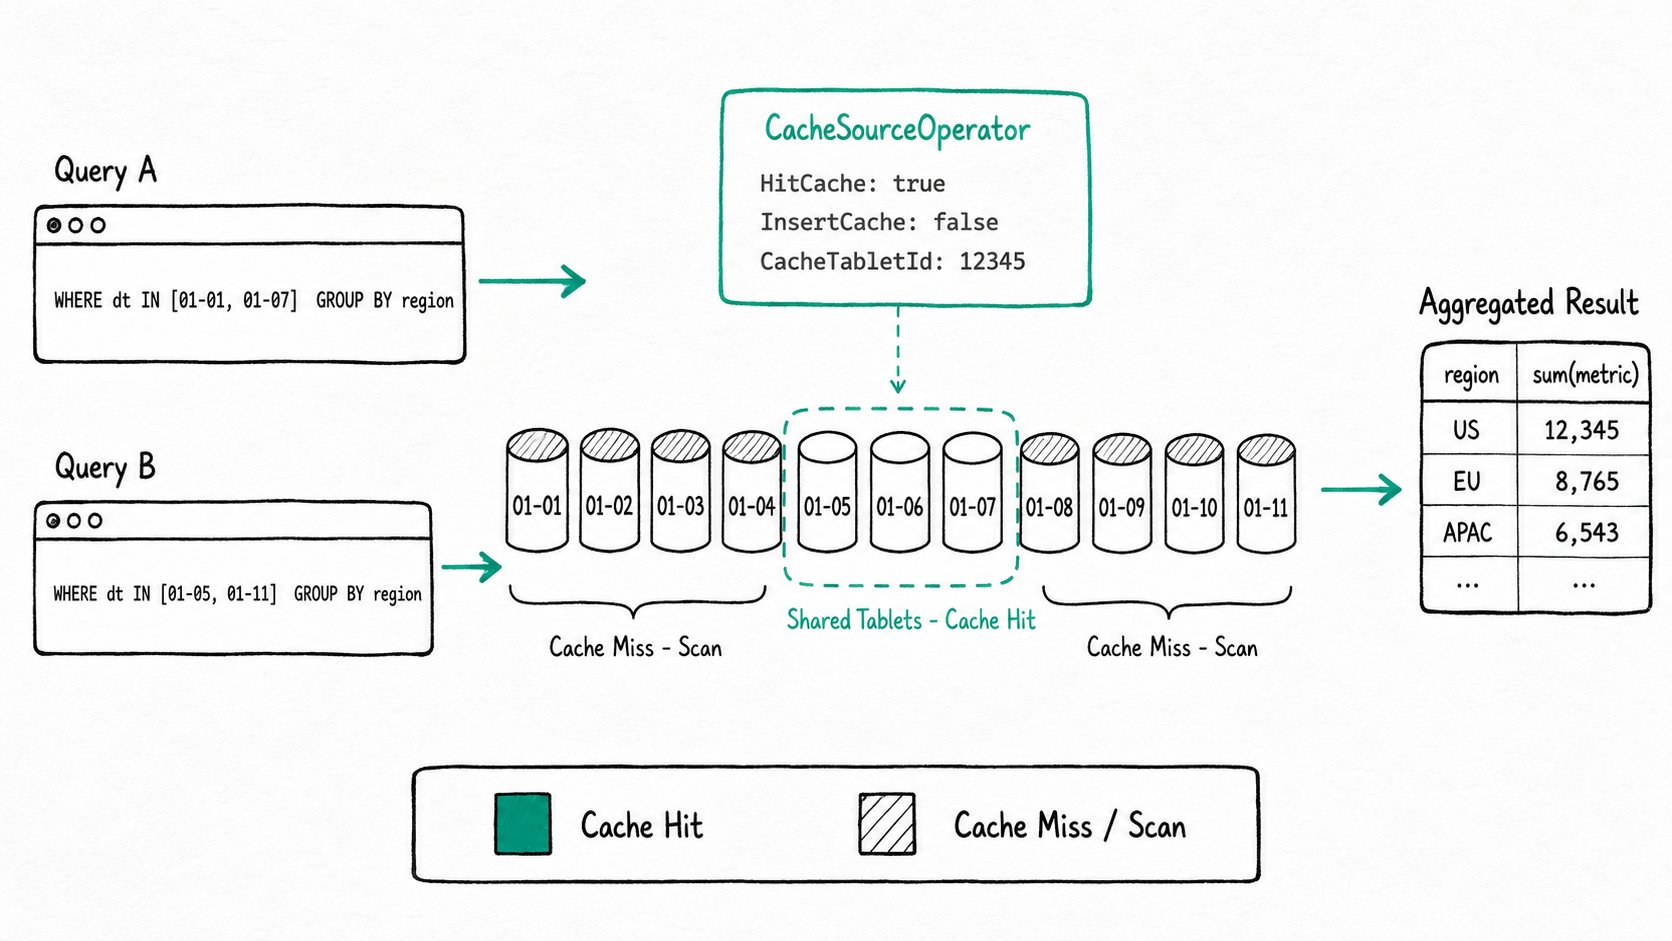
要点 Apache Doris のクエリキャッシュは、内部 OLAP テーブルに対する集約クエリ向けのパイプラインエンジンのキャッシュです。クエリキャッシュは部分集約結果をタブレット単位で保存し、プランのダイジェスト、タブレット ID、バージョンをキーとして使用します。二つのクエリがタブレットを共有していれば、日付範囲が一部しか重ならなくても、そのタブレットのキャッシュを共有します。そのため、15 秒ごとに同じ
GROUP BYを実行するダッシュボードは、更新のたびに同じタブレットを再スキャンせずに済みます。
Apache Doris のクエリキャッシュを使う理由
Apache Doris のクエリキャッシュは、同じ集約を重複するパーティションに対して数秒おきに実行する BI ダッシュボードで、タブレット単位の重複処理をなくします。BI のトラフィックの大半は、繰り返し実行される集約です。ダッシュボードのタイルは、更新のたびに同じ SUM/COUNT/AVG を再実行します。T+1 レポートは昨夜のパーティションを集約した後も、今日誰かがページを開くたびに再集約します。トレーダー向けのパネルは、一分間に数個のタブレットしか変化しない板情報に対して、五秒おきに同じ GROUP BY symbol を実行します。
同じタブレットが何度も同じ部分集約結果を生成し、そのたびにクラスタはスキャンと集約のコストをすべて負担します。
SQL Cache は SQL テキストがバイト単位で同一の場合に役立ちますが、フィルターが一つ変化したり、タブレットのバージョンが一つ更新されたりすると再利用できません。マテリアライズドビューはクエリの形を固定できますが、ビューとその更新スケジュールを維持する必要があります。
クエリキャッシュは、そのどちらよりも細かい単位、つまり一つの集約に対する一つのタブレットの寄与を扱います。ダッシュボードの更新が実際に重複するのはこの単位です。フィルター範囲が一日先に進んでも、更新のたびに新しくなるパーティションは一つか二つだけです。
Apache Doris のクエリキャッシュとは
Apache Doris のクエリキャッシュは、フラグメントが AggregationNode -> OlapScanNode、または二段階集約では AggregationNode -> AggregationNode -> OlapScanNode という形に一致すると有効になるパイプラインエンジンの最適化です。途中にフィルターや射影のノードがあっても構いません。結合、ソート、和集合、ウィンドウ関数、Exchange ノードは含められません。フラグメントが条件を満たすと、BE はスキャン前にキャッシュを確認します。ヒットした場合はスキャン範囲をスキップし、キャッシュ済みのブロックを直接出力します。ミスした場合は通常どおり結果を計算し、タブレットごとに一つのエントリとしてキャッシュに書き戻します。
主な用語
enable_query_cache:セッション変数。デフォルトでは無効です。セッション単位で有効にするか、ダッシュボード用アカウントに対してグローバルに設定します。CacheSourceOperator:集約とスキャンの間に挿入されるパイプラインオペレーター。プロファイルのこのセクションには、タブレットごとのHitCache、InsertCache、CacheTabletIdが表示されます。SQL digest:正規化された集約プラン(関数、グループ化キー、パーティション以外の述語、射影列、結果に影響するセッション変数)から計算される SHA-256。意味的に同等の SQL は同じダイジェストになります。Tablet range:パーティション述語から導出される範囲。キャッシュキーに含まれるため、二つのクエリは共通するパーティションのキャッシュを再利用できます。LRU-K (K=2):登録ポリシー。新しいエントリは、キャッシュの枠を得る前に少なくとも二回アクセスされる必要があります。そのため、一度限りのアドホッククエリがダッシュボードで使うエントリを追い出すことはありません。
Apache Doris のクエリキャッシュの仕組み
Apache Doris のクエリキャッシュは、FE でスキャン上の集約パターンを検出し、プランのダイジェストとタブレット ID・バージョンからタブレットごとのキャッシュキーを作成し、各 BE がスキャンする前にキャッシュを照会します。以下の五つの手順で、プランの確認、キーの構築、照会、ヒット、ミスを説明します。
- プランの確認(FE)。 Nereids は各フラグメントを調べ、スキャン上の集約パターンを探します。結合、ソート、ランタイムフィルターの適用先、外部テーブルのスキャン、非決定的な式があるフラグメントは対象外です。
- キャッシュキーの構築(FE)。 単一列の RANGE パーティションテーブルでは、プランナーがパーティション述語を抽出し、述語の範囲とスキャン対象の各パーティションとの共通範囲を計算します。プランのダイジェストは、クエリの残りの部分を対象とします。タブレットごとのキーは
(digest, tablet_id, tablet_range)です。 - タブレットごとの照会(BE)。 割り当てられた各タブレットに対して、
QueryCache::lookup(key, version)がキャッシュキーとタブレットのバージョンの両方を確認します。エントリの書き込み後にINSERT、DELETE、UPDATE、またはコンパクションが行われていれば、ミスになります。 - ヒットした場合。 スキャンオペレーターはその範囲をスキップし、集約オペレーターは何も生成せず、
CacheSourceOperatorがキャッシュ済みのブロックを出力します。射影の順序がキャッシュ済みエントリと異なる場合(同じダイジェストになるSELECT a, bとSELECT b, aなど)は、列の順序が自動的に入れ替えられます。 - ミスした場合。 フラグメントは部分集約を計算し、通常どおり後続に行を送りながら、そのコピーをバッファーに保持します。フラグメントの処理が終わると、
query_cache_entry_max_bytes(5 MB)およびquery_cache_entry_max_rows(500,000)の範囲内に収まる結果がキャッシュに書き込まれます。
クイックスタート
SET enable_query_cache = true;

-- Run 1: warms the cache for partitions 2024-01-01 .. 2024-01-07
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt >= '2024-01-01' AND dt < '2024-01-08'
GROUP BY region;

-- Run 2: overlapping window, three shared days
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt >= '2024-01-05' AND dt < '2024-01-12'
GROUP BY region;
期待される結果(EXPLAIN PROFILE からの抜粋)
CacheSourceOperator
  HitCache:      true
  InsertCache:   false
  CacheTabletId: 12345
一回目の実行ではすべてのタブレットでミスし、タブレットごとの部分集約結果が書き込まれます。二回目の実行では、重複する三日間(2024-01-05 から 2024-01-07)はキャッシュにヒットし、新しい日付(2024-01-08 から 2024-01-11)のみがスキャンされます。ヒットを確認するには、プロファイルの CacheSourceOperator を調べます。タブレットごとの HitCache: true は、そのタブレットの結果がメモリから返されたことを示します。
Apache Doris のクエリキャッシュを使う場面
Apache Doris のクエリキャッシュは、単一列の RANGE パーティションを持つ内部テーブルに対する BI ダッシュボード、T+1 レポート、ローリングウィンドウ集約に使用します。JOIN、ORDER BY、UNION、ウィンドウ関数を含むクエリ、外部レイクハウステーブル(代わりに SQL Cache を使用)、書き込み頻度の高いテーブル、主キーによる検索には使用しないでください。
適した用途
- 一分間に同じ集約を何度も繰り返す BI ダッシュボードやタイルウィジェット。
- T+1 レポート。当日のロードが完了すると、翌日のロードで新しいパーティションのキャッシュが無効になるまで、繰り返しの読み取りにはキャッシュが使われます。
- 更新間隔の間に最新のパーティションだけが変化する、日付のローリングウィンドウを使った集約クエリ。
- 単一列の
RANGEパーティションテーブル。異なるフィルター範囲でタブレット単位の再利用ができる構成です。
適さない用途
- キャッシュ対象のサブツリーに
JOIN、ORDER BY、UNION、ウィンドウ関数があるクエリ。先に集約してから結合するか、結合を含む構成には非同期マテリアライズドビューを作成します。 - 外部テーブル(Hive、Iceberg、Hudi、Paimon、JDBC)。キャッシュのキーに使うタブレット ID とバージョンが外部テーブルにはありません。代わりに SQL Cache を使用します。
- 数秒おきに書き込みがあるテーブル。バージョンが更新されるたびに該当するタブレットのエントリが無効になるため、ヒット率は低くなります。フィルターの再利用が目的なら、Condition Cache を検討してください。
now()、rand()、uuid()、または非決定的な UDF を使うクエリ。プランが非決定的とみなされ、キャッシュは無効になります。WHERE dt = date(now())のような日単位の式に置き換えます。- フィルター範囲が変化する複数列の
RANGEまたはLISTパーティションテーブル。パーティション述語がそのままダイジェストに含まれるため、範囲が変わると異なるキーになります。タブレット単位の再利用が機能するのは単一列のRANGEだけです。 - 主キーによる検索。クエリキャッシュは集約用です。
WHERE pk = ?のようなパターンには、代わりに高並行性ポイントクエリを使用します。
設定項目
| 設定項目 | 設定場所 | デフォルト値 | 変更する場面 |
|---|---|---|---|
enable_query_cache | セッション | false | 常に設定します。セッション単位で設定するか、ダッシュボード用アカウントに対してグローバルに設定します。 |
query_cache_entry_max_bytes | セッション | 5 MB | グループ化の結果が非常に幅広い場合に引き上げます。この値を超える結果は、通知されずにキャッシュ対象外になります。 |
query_cache_entry_max_rows | セッション | 500,000 | カーディナリティの高い GROUP BY に対して引き上げます。 |
query_cache_size | be.conf | 512 MB | BE ごとのメモリ上限です。キャッシュ容量がボトルネックになるダッシュボードでは引き上げます。 |
query_cache_force_refresh | セッション | false | キャッシュされた結果が古いと疑われる場合、一つのクエリに対して true に設定し、その後元に戻します。 |
関連資料
- クエリキャッシュのユーザーガイド
- SQL Cache:あらゆるクエリに対する結果単位のキャッシュ
- Condition Cache:セグメントのフィルター結果をキャッシュ
- 非同期マテリアライズドビュー:複雑なパイプラインを事前集約
- Doris のキャッシュ:適切な方法の選び方
- Data Cache と Page Cache:繰り返しスキャンするときにクエリキャッシュの下位で働くストレージ層のキャッシュ。
- Metadata Cache:フェデレーションによるレイクハウスクエリ向けの外部カタログメタデータキャッシュ。
- MPP アーキテクチャ:結果を再利用できる場合にクエリキャッシュがフラグメント DAG の処理を省略する、実行モデル。
