相互順位融合(Reciprocal Rank Fusion)
要約 Apache Doris には組み込みの
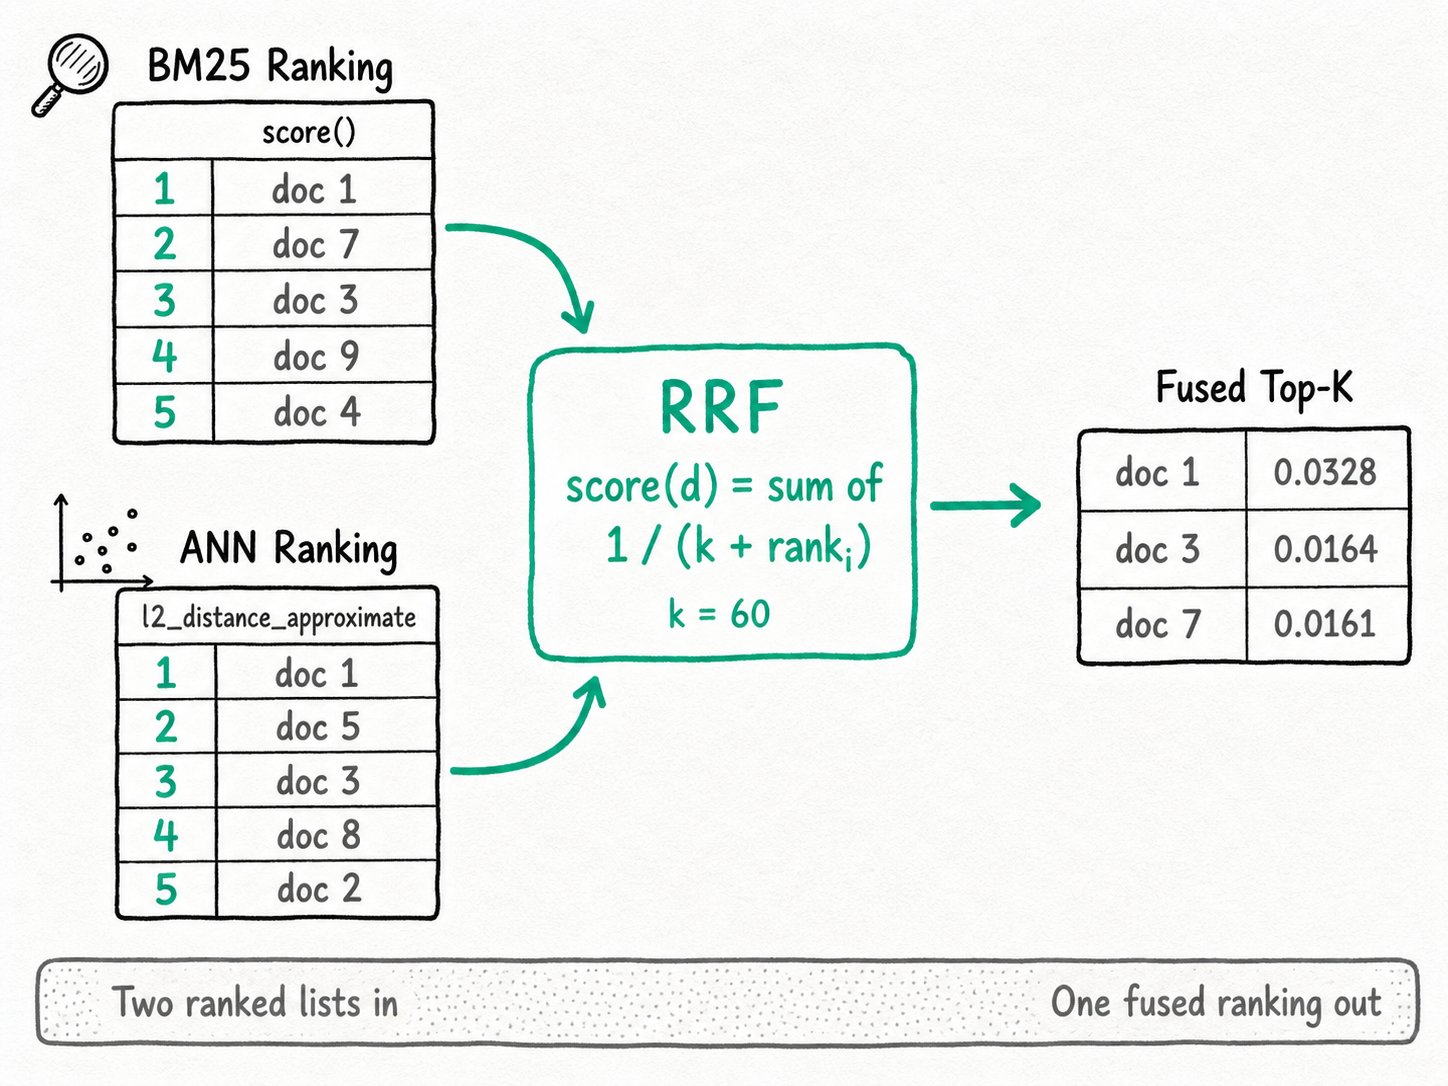
rrf()関数はありませんが、通常の SQL で相互順位融合(Reciprocal Rank Fusion、RRF)を実装できます。このパターンでは、ROW_NUMBER()を BM25 の順位とベクトル検索の順位に適用し、両方のリストの1.0 / (60 + rank)を合計します。標準的な平滑化定数はk = 60です。これにより、BM25 スコアとコサイン距離のスケールを合わせなくても、統合された単一の上位 K 件のリストを得られます。
Apache Doris で相互順位融合を使う理由
相互順位融合は、スケールの異なる二種類のスコアを調整せずに BM25 とベクトル検索の結果を統合できるため、Apache Doris のハイブリッド検索における妥当なデフォルトの方法です。ハイブリッド検索では、同じクエリに対して二つの順位付きリストを返します。一つは全文一致検索(score() による BM25 スコア)、もう一つはベクトル類似検索(l2_distance_approximate または inner_product_approximate)によるものです。これらのスコアはスケールが異なります。BM25 はコーパスの統計に依存する上限のない正の値であり、コサイン距離は 0~2 の範囲に収まり、L2 距離には上限がありません。これらのスコアを加算または平均しても、解釈できる値にはなりません。また、クエリごとの最小値・最大値による正規化は不安定で、どちらかのリストに外れ値が一つあるだけで統合結果が崩れます。
相互順位融合では、スコアを捨てて順位だけを使うことで、この問題を回避します。調整するパラメーターは一つだけで、Cormack、Clarke、Buettcher が 2009 年に発表して以来、検索ベンチマークでも良好な結果を示しています。
- BM25 スコアとベクトル距離はスケールが異なるため、そのまま算術演算で組み合わせるのは危険です。
- 一つのクエリで裾の長いスコア分布が生じると、最小値・最大値による正規化は破綻します。
- アプリケーション側に統合サービスを設けると、デプロイしてデータベースと同期を保つ対象が一つ増えます。
Apache Doris の相互順位融合とは
Apache Doris の相互順位融合は組み込み関数ではなく、ROW_NUMBER、FULL OUTER JOIN、標準的な 1/(k+rank) の式で表す、順位に基づく統合アルゴリズムの SQL パターンです。文書 d が順位付きリスト R_1, R_2, ..., R_n に現れるとき、統合スコアは、文書が現れる各リストでの順位の逆数を合計したものです。
score(d) = Σ 1 / (k + rank_i(d))
rank_i(d) は文書 d のリスト i における 1 から始まる順位です。k は平滑化定数で、Cormack らが推奨し、多くの本番システムでも使用されている値は 60 です。あるリストに存在しない文書は、そのリストからの寄与がゼロになります。最後に統合スコアの降順で並べ替え、最終的な順位を決めます。
Apache Doris では、これは関数ではなく SQL パターンとして実装します。BM25 用と ANN 用の二つの順位付きサブクエリを作り、それぞれの行に ROW_NUMBER() を付け、FULL OUTER JOIN で結合して順位の逆数を合計します。
主な用語
score():Doris の転置インデックス用 BM25 スコア関数です。MATCH_*述語、スコアによるORDER BY、LIMITを含む単一テーブルのクエリでのみ動作し、score() AS sのように、そのまま選択する必要があります。順位付けや丸めは外側のクエリで行います。l2_distance_approximate/inner_product_approximate:Doris のベクトルインデックス(HNSW または IVF)を使用する ANN 距離関数です。ROW_NUMBER() OVER (ORDER BY ...):結果セット内の各行に、1 から始まる順位を付けます。k:RRF の平滑化定数です。小さい値(20~40)ほど上位の行の影響が強まり、大きい値(80 以上)ほど影響が均されます。
Apache Doris で相互順位融合が動作する仕組み
Apache Doris では、二つの順位付き検索をサブクエリとして実行し、それぞれに ROW_NUMBER() で順位を付けます。次に、文書 ID で二つのリストを FULL OUTER JOIN し、1/(k+rank) を合計して最終的な並び順を決めます。以下の五つの手順で、検索、順位付け、結合、スコアの統合、件数の絞り込みを行います。
- 二つの順位付き検索を実行する。 BM25 サブクエリは
MATCH_ANYで絞り込み、score()の降順に並べます。ANN サブクエリはベクトル距離の昇順に並べます。それぞれLIMIT Nで候補数を制限します。Nは候補プールのサイズで、通常は 50~200 です。 - リストごとに順位を付ける。
ROW_NUMBER() OVER (ORDER BY ...)により、各サブクエリの行に 1、2、3 と番号を付けます。番号は整数なので、二つの結果を組み合わせる際にスコアのスケールを気にする必要はありません。BM25 リストでは、score()を計算するクエリの一段外側でウィンドウ関数を使います。ROW_NUMBER() OVER (ORDER BY score() DESC)を同じSELECTに置くと、score() function requires WHERE clause with MATCH function, ORDER BY and LIMIT for optimizationというエラーで拒否されます。 - 文書 ID で二つのリストを外部結合する。
FULL OUTER JOINにより、どちらかのリストに現れた文書をすべて残します。片方に存在しない行の順位はNULLになります。 - 順位の逆数を合計する。
COALESCE(1.0/(60+bm25_rank), 0) + COALESCE(1.0/(60+ann_rank), 0)で各文書の統合スコアを計算します。存在しない順位の寄与はゼロとなり、元の RRF の定義と一致します。 - 並べ替えて件数を絞る。
ORDER BY rrf_score DESC LIMIT Kで最終的な上位 K 件を返します。
候補プールのサイズ N は重要です。各検索手法から上位 10 件しか取得しない場合、BM25 で 11 位、ANN で 1 位の文書はベクトル検索のみに現れた文書として扱われます。各リストから 100 件の候補を取得するのは妥当なデフォルトで、再現率が重要なワークロードではさらに増やします。
クイックスタート
ベクトルインデックスとハイブリッド検索の例と同じ四つの行を使い、コメントのテキストを body に格納します。
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  body STRING NOT NULL,
  INDEX idx_body(body) USING INVERTED PROPERTIES("parser"="english"),
  INDEX idx_vec(embedding) USING ANN
    PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music'),
  (2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today'),
  (3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend'),
  (4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update');

SELECT COALESCE(b.id, a.id) AS id,
       COALESCE(1.0 / (60 + b.r), 0) + COALESCE(1.0 / (60 + a.r), 0) AS rrf
FROM (
  -- BM25 list: score() stays plain here; ROW_NUMBER() ranks it one level up
  SELECT id, ROW_NUMBER() OVER (ORDER BY s DESC) AS r
  FROM (SELECT id, score() AS s FROM docs
        WHERE body MATCH_ANY 'music' ORDER BY s DESC LIMIT 100) bm25_hits
) b
FULL OUTER JOIN (
  -- ANN list
  SELECT id, ROW_NUMBER() OVER (ORDER BY dist ASC) AS r
  FROM (SELECT id, l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
        FROM docs ORDER BY dist ASC LIMIT 100) ann_hits
) a ON b.id = a.id
ORDER BY rrf DESC LIMIT 5;
期待される結果
+------+---------+
| id   | rrf     |
+------+---------+
|    1 | 0.03224 |
|    3 | 0.03201 |
|    4 | 0.01639 |
|    2 | 0.01587 |
+------+---------+
BM25 では文書 3 が首位、1 が二位です(「music」を含むのはこの二つだけです)。ベクトル検索の順位は 4、1、2、3 です。文書 1 は両方のリストで二位なので、スコアは 1/62 + 1/62 ≈ 0.0322 となり、BM25 では首位でも距離では最後となる文書 3(1/61 + 1/64 ≈ 0.0320)をわずかに上回ります。文書 4 と 2 はベクトル検索のリストにしか現れないため、その後に並びます。
Apache Doris で相互順位融合を使うべき場面
Apache Doris の相互順位融合は、RAG パイプライン、商品カタログや文書の検索、BM25 とベクトル検索を組み合わせるワークロードで、絶対スコアのスケール調整が現実的でない場合に使用します。検索手法が一つだけの場合、候補プールが非常に小さい場合、確率として校正された値が必要な場合、追加の結合による遅延が問題になる高頻度のクエリには向きません。
適している場面
- キーワードと埋め込みの類似度の両方で検索し、LLM に渡す統合済みの上位 K 件を必要とする RAG パイプライン。
- キーワード検索と意味検索が相互に再現率を補い、妥当なデフォルトの順位付けが必要な商品カタログや文書の検索。
- コーパスやクエリの分布が変化するため、検索手法間で絶対スコアを調整することが現実的でないワークロード。
- アプリケーション層に統合サービスを構築することになる場合。SQL 内で統合すれば、データ処理の経路を短くできます。
適していない場面
- 検索手法が一つだけのワークロード。BM25 または ANN のどちらか一方だけを実行する場合は、元のスコアで並べ替え、結合を省きます。一つのリストに対する RRF は、順位の単調変換にすぎません。
- 非常に小さい候補プール(各リストの上位 5 件または 10 件)。RRF では両方のリストに現れる文書が高く評価されますが、そのためには両方のリストに十分な深さが必要です。各検索手法から少なくとも 50 件取得します。
- しきい値判定、回答の保留、後段のコストモデルなどのために、確率として校正された値が必要なワークロード。RRF スコアは確率ではなく、クエリをまたいで比較できる絶対的な意味もありません。校正が必要なら、学習済みの順位付けモデルを使用します。
- 追加のサブクエリと結合による遅延が問題になる高頻度のクエリ。事前フィルタリングのパターン(
MATCH_ANY+ORDER BY l2_distance_approximate)なら、一度の処理で単一の順位付きリストを返せます。ハイブリッド検索では、これをデフォルトで使用します。
k の調整
k を小さくする(20 に近づける)と、1 位と 5 位の差が広がります。これは、片方の検索手法のほうが明らかに信頼できる場合に役立ちます。k を大きくする(100 に近づける)と差が縮まり、両方のリストで下位に現れる文書にも多くの評価を与えます。k を一度変更したら、ラベル付きのデータセットで再現率を測定し、それ以上の調整はやめます。クエリごとの調整が必要なら、学習済みの順位付けモデルが適している兆候です。
関連資料
- ハイブリッド検索:転置インデックスによる絞り込みと ANN による順位付けを組み合わせる Doris のデフォルトの単一パスパターン。このページで比較している代替手段です。
- 関連度スコアリング(BM25):統合に使用する一方の入力である
score()の計算方法と、その有効化条件。 - 転置インデックスの概要:BM25 サブクエリで使用するインデックスの種類、トークナイザー、
MATCH_*演算子。 - ベクトルインデックスの概要:HNSW と IVF のバックエンド、距離関数、ANN サブクエリの制約。
- ROW_NUMBER:順位付きサブクエリの各行に整数の順位を付けるウィンドウ関数。
- Cormack、Clarke、Buettcher(2009):相互順位融合は Condorcet 法や個別の順位学習手法を上回る:原論文であり、
k = 60の推奨値の出典です。
