ディスクへのスピル
要点 Apache Doris のディスクへのスピルを使用すると、クエリがメモリの上限を超えそうになったとき、HashJoin、Aggregation、Sort、CTE の各オペレーターが中間状態をローカルディスクに書き出せます。クエリの実行は遅くなりますが、メモリ不足で失敗せずに完了します。セッションごとに
set enable_spill = trueを実行するか、Workload Group で有効にし、BE のスピル用ディレクトリを設定してください。スピルのカウンターはクエリプロファイルで確認できます。
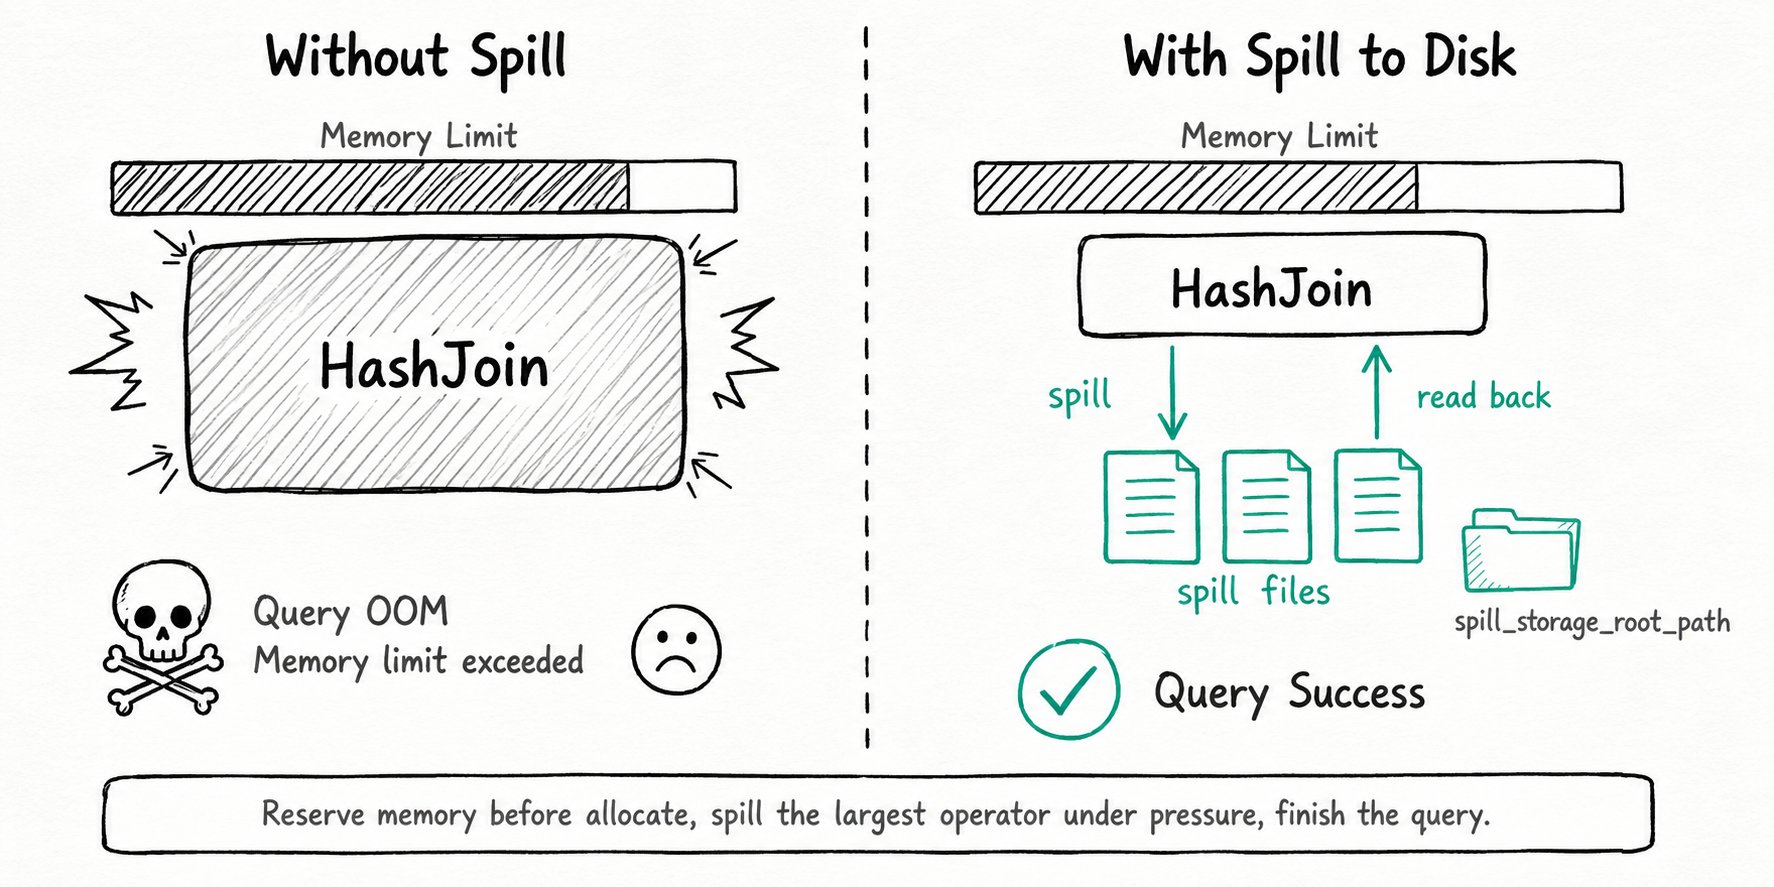
Apache Doris でディスクへのスピルを使う理由
ディスクへのスピルを使うと、Apache Doris でメモリ不足により失敗していたクエリを、実行時間は延びるものの完了できるようになります。Apache Doris は MPP エンジンです。デフォルトでは、結合のハッシュテーブル、集約状態、ソートバッファーはすべて BE のメモリ上に置かれます。これは応答時間には有利ですが、クエリがノード、クエリ、または Workload Group に許されたメモリ量を超えると問題になります。典型的な例は、幅の広いファクトテーブルを読み、数ギガバイトのハッシュテーブルを構築する夜間 ETL や TPC-DS 型のアドホッククエリが、Memory limit exceeded で失敗するケースです。再実行しても同じ上限に達し、exec_mem_limit を引き上げるか、実行を諦めることになります。
- 大きすぎる HashJoin または Aggregation が一つあるだけで、クエリ全体が失敗します。
- RAM よりはるかに大きなテーブルを扱う ETL は不安定になり、実行できないこともあります。
- クエリごとに
exec_mem_limitを引き上げると、ほかのクエリが使えるメモリが減ります。 - メモリを大量に使うクエリが同時に実行されると、BE が全体のメモリ上限に近づき、緊急キャンセルが発生します。
Apache Doris のディスクへのスピルは、こうした失敗を、時間はかかっても完了するクエリに変えます。従来はデータセットが 10x の規模になるとメモリ不足で失敗していた同じノードでも、ディスク I/O のコストを払うことで、50x の規模の処理を完了できます。
Apache Doris のディスクへのスピルとは
Apache Doris のディスクへのスピルは、Pipeline Execution Engine の実行時の仕組みです。メモリ負荷の高いオペレーターが、メモリ不足時に中間状態をローカルディスクへ退避し、後で読み戻してクエリを完了できます。スピルはクエリ単位ではなくオペレーター単位で行われます。実際に大きくなったオペレーターだけがスピルし、クエリはメモリ上とディスク上の状態を併用して実行を続けられます。
主な用語
Spillable operator(スピル可能なオペレーター): 必要に応じてメモリを解放できるオペレーターです。現在は HashJoin(パーティション化ハッシュ結合)、Aggregation(パーティション化集約)、Sort(外部マージソート)、CTE が対象です。Reserve memory(メモリの予約): オペレーターはブロックを処理する前に必要なメモリ量を見積もり、メモリトラッカーに予約を要求します。予約に失敗すると、実際にメモリを割り当てる前にスピルが始まります。Revocable memory(回収可能なメモリ): ディスクに書き出して回収できる、オペレーターのメモリの一部です。スケジューラーは回収可能なメモリ量が最も多いオペレーターを最初にスピルさせます。Force spill(強制スピル): メモリに余裕がある場合でもスピルさせるデバッグモード(enable_force_spill)です。本番環境で利用する前に、スピル経路でクエリが正しく動作することを検証するために使用します。- スピルの保存先パス: BE がスピルファイルに使用するローカルディレクトリです。テーブルの保存先パスとは別に設定します。
Apache Doris のディスクへのスピルの仕組み
Apache Doris のディスクへのスピルでは、メモリを割り当てる前に予約し、メモリ不足を検知すると、回収可能なメモリ量が最も多いオペレーターを選んで状態をパーティションごとにディスクへ書き出します。メモリに余裕ができるとクエリを再開します。以下の六つのステップが一連の流れです。
- 割り当て前に予約する。 各パイプラインタスクは次のブロックに必要なメモリ量を見積もり、クエリ単位とプロセス単位のメモリトラッカーに予約を要求します。事前に少ない負荷で正確に見積もることで、後から慌ててキャンセルする事態を避けます。
- メモリ不足を検知する。 クエリ、Workload Group、または BE プロセスの上限を超える場合、予約は失敗します。タスクはキャンセルされずに一時停止します。
- スピル対象を選ぶ。 クエリスケジューラーは、一時停止したクエリのオペレーターを調べ、回収可能なメモリ量が最も多いものを選びます。通常は、ビルド側のハッシュテーブルか、処理中の集約マップです。
- パーティションごとにスピルする。 パーティション化された HashJoin と Aggregation は、状態を N 個のパーティション(
spill_hash_join_partition_count、spill_aggregation_partition_count)にハッシュ分割し、スピル I/O スレッドプールを通じてパーティション全体をディスクへ書き出します。Sort はソート済みのランを書き出し、後でマージします。 - 再開して完了する。 メモリが十分に空くと、タスクの一時停止が解除されます。プローブ側の行も同じパーティション関数で振り分けられるため、各パーティションはディスク上の対応するデータと結合または集約されます。結果は正しく得られますが、ディスク I/O の分だけ実行時間が延びます。
- 記録してクリーンアップする。 プロファイルには、書き込みバイト数、ファイル数、I/O 待機時間、パーティションの偏りなど、各スピルのカウンターが記録されます。スピルファイルは
spill_storage_root_pathの下に置かれ、バックグラウンドタスクによってガベージコレクションされます。
クイックスタート
-- Enable spill for this session (or set it on a workload group).
SET enable_spill = true;
-- Spill paths do real disk IO, so give the query a longer budget.
SET query_timeout = 3600;
-- Run a query that would normally OOM.
SELECT l_orderkey, SUM(l_quantity)
FROM lineitem JOIN orders ON l_orderkey = o_orderkey
WHERE o_orderdate >= '1995-01-01'
GROUP BY l_orderkey
ORDER BY 2 DESC LIMIT 100;
-- Check that spill actually happened.
SELECT query_id, spill_write_bytes_to_local_storage
FROM information_schema.backend_active_tasks;
期待される結果
クエリは上位 100 行を返します。クエリプロファイル で、Spilled: true が PARTITIONED_HASH_JOIN_SINK_OPERATOR または AGGREGATION_SINK_OPERATOR に表示されることと、SpillWriteBlockBytes、SpillWriteFileBytes、SpillWriteTime を確認してください。監査ログにも同じクエリの SpillWriteBytesToLocalStorage と SpillReadBytesFromLocalStorage が記録されます。これらのカウンターがゼロなら、クエリはメモリ内に収まり、スピルは発生していません。これは望ましい結果です。
Apache Doris のディスクへのスピルを使う場面
Apache Doris のディスクへのスピルは、応答時間よりもクエリの完了を重視する、高負荷の ETL、バッチ分析、マルチテナントのワークロードに使用します。一秒未満の応答が必要な処理や、際限なくリソースを消費するクエリには適していません。
適しているケース
- ノードごとのメモリよりはるかに大きなテーブルを使う高負荷の ETL。データに偏りがあっても一晩で完了させる必要がある集約や結合が該当します。
- 一つの実行プランに複数の大規模ハッシュ結合を含む TPC-DS、複数テーブルを使うマテリアライズドビューの更新、その他のバッチ処理。
- 幅の広いパーティションで、まれにメモリ使用量が急増するクエリ。応答時間と引き換えに、メモリ使用量の急増に対応できます。
- 各 Workload Group のメモリ上限を厳しく設定し、上限超過時にクエリをキャンセルする代わりにスピルさせたいマルチテナントクラスター。
適していないケース
- 応答時間が重要な処理(ポイントルックアップや、一秒未満で表示するダッシュボード)。ディスク I/O によって SLA を満たせなくなります。そもそも、これらのクエリはメモリ上限を超えないようにすべきです。
exec_mem_limitを適切に設定し、スピルは無効にしておきます。 - メモリ上限の引き上げがディスク I/O より低コストなワークロード。クエリが上限を 10% 超える程度なら、
exec_mem_limitまたはmax_memory_percentを引き上げたほうがスピルより早く完了します。 - ストリーミング集約。この経路は設計上スピルしません。非ストリーミング集約に切り替えるか、必要なメモリを確保してください。
- ローカルディスクの空き容量がなく、SSD もないクラスター。HDD で大量にスピルすると、ディスク I/O がクエリ時間の大部分を占め、通常のスキャンに必要な I/O 帯域も圧迫します。
- 際限なくリソースを消費するクエリへの対処としての利用。スピルによって 100GB のハッシュテーブルも扱えますが、十億行に対する
SELECT *のコストがなくなるわけではありません。Workload Group の上限とキューイングを併用してください。
関連資料
- ディスクへのスピルの管理ガイド: BE の設定、FE のセッション変数、スロットベースのメモリ割り当て、TPC-DS 10TB の検証結果を説明します。
- Workload Group: グループごとのメモリ上限と、高水位しきい値によってクエリをキャンセルする前にスピルを開始する仕組みを説明します。
- Pipeline Execution Engine: 割り当て前の予約によるメモリ管理と、回収可能なメモリの記録を担う実行エンジンを説明します。
- クエリプロファイル: スピルの発生を確認する、オペレーターごとの
Spill*カウンターの読み方を説明します。 backend_active_tasksシステムテーブル: 監視やアラートに使う、実行中のクエリごとのスピルバイト数を確認できます。- MPP アーキテクチャ: ディスクへのスピルが従うメモリ予算である
exec_mem_limitを BE ごとに割り当てる、分散実行レイヤーを説明します。
