Stream Load
要約 Apache Doris Stream Load を使うと、クライアントは
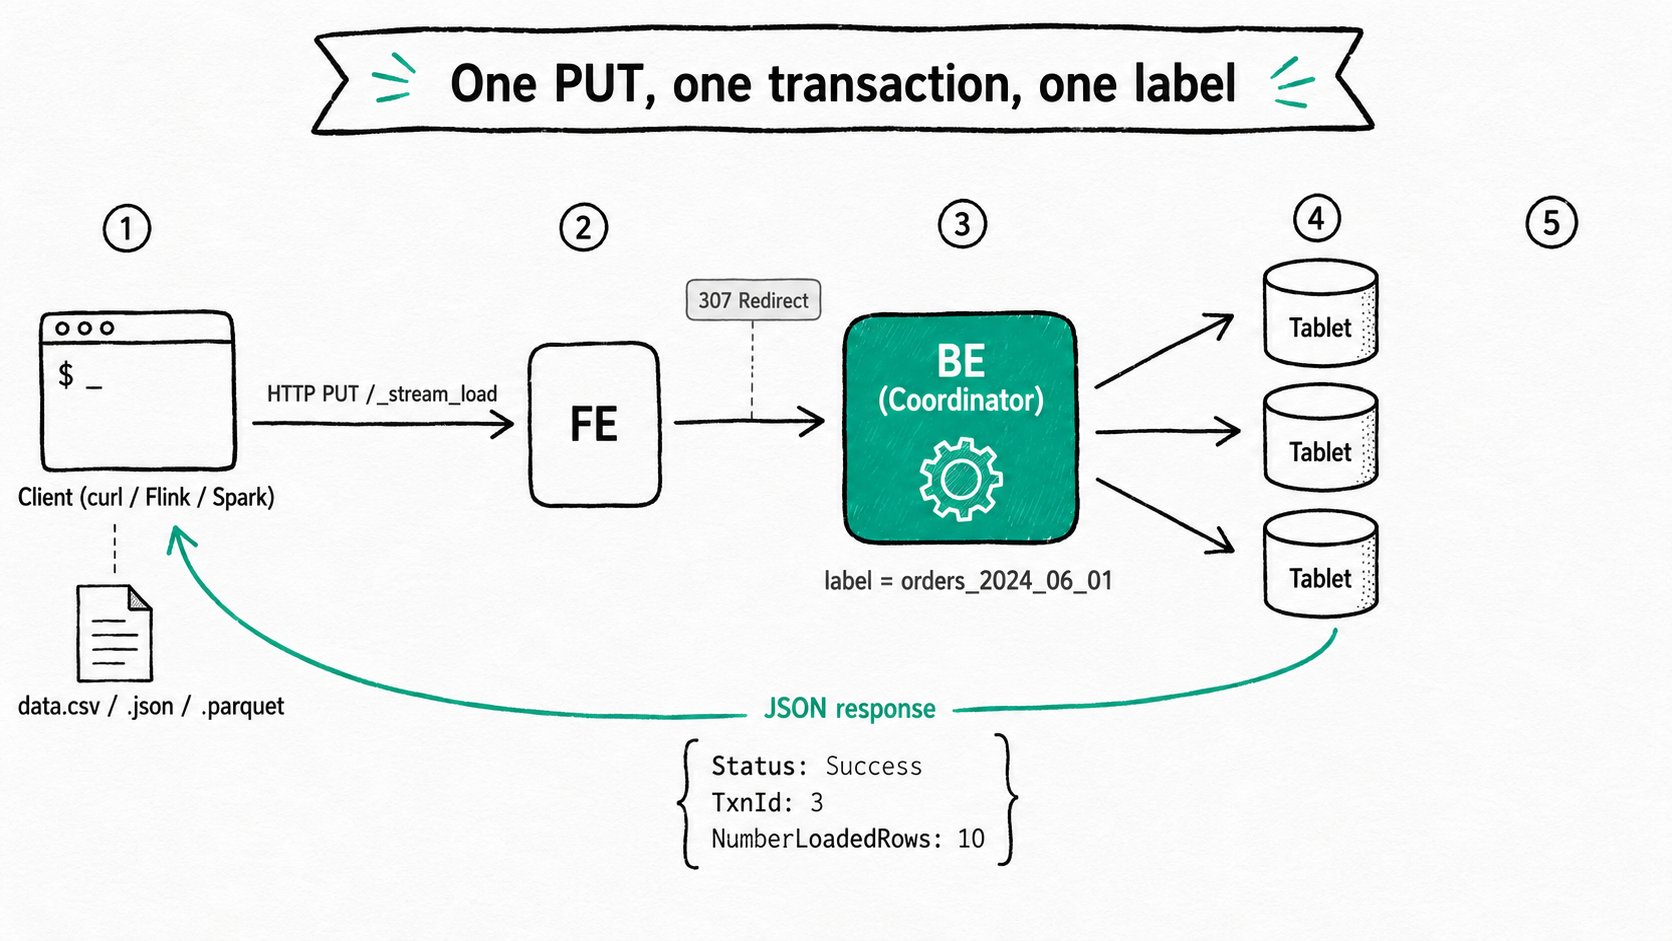
curl(または任意の HTTP ライブラリ)から、一回の HTTP PUT リクエストでファイルやバイトストリームをテーブルに送信できます。FE はリクエストを BE にリダイレクトし、選ばれた BE がコーディネーターとして CSV、JSON、Parquet、ORC を解析して対象のタブレットに書き込み、バッチ全体がコミットされたかどうかを示す JSON を返します。一つのラベルで再試行時の重複を防ぎ、一つのトランザクションでバッチの原子性を確保します。JSON レスポンスには行数と各フェーズの所要時間も含まれます。
Apache Doris Stream Load を使う理由
Apache Doris Stream Load は、すでに HTTP を使っているクライアントが、バッチごとに同期的な応答を受け取り、ラベルをキーとする再試行保証を得たい場合に適しています。別途トランザクションマネージャーを用意する必要はありません。データウェアハウスへのリアルタイム書き込みは、ファイルを送るスクリプトから始まることがよくあります。そのスクリプトは、Flink のシンク、Kafka コンシューマー、rsync を実行する cron ジョブ、あるいは数千件のイベントを生成したばかりのマイクロサービス内で動きます。スクリプトの作成者は、データを送信して同じ接続上で結果を受け取り、安全に再試行できることを確認したいはずです。
- Flink ジョブは、現在のチェックポイントのデータを Apache Doris に書き込み、オフセットを進める前にコミットの成否を確認する必要があります。
- ETL スクリプトは、前日のエクスポートから生成した 200 MB の CSV を取り込み、朝のレポートが実行される前に行を参照できるようにしたい場合があります。
- 補助サービスは数秒ごとに JSON バッチを生成し、トランザクションマネージャーを導入せずに最大 一回の処理を実現する必要があります。
Apache Doris Stream Load は、このような書き込みを直接扱えます。一回の HTTP PUT、一つのラベル、一つのトランザクションに対し、同じソケット上で同期的な応答を返します。
Apache Doris Stream Load とは
Apache Doris Stream Load は、クラスター内の各ノードが公開する同期的な HTTP ロードエンドポイントです。クライアントは FE または BE に HTTP PUT を送信します。FE はラウンドロビン方式で選んだ BE にリダイレクトし、その BE がロードのコーディネーターになります。コーディネーターはリクエスト本文を解析し、各タブレットを保持する BE に行を分配して、FE で 一つのトランザクションを開始します。すべての BE から確認応答を受け取るとコミットし、同じソケット上で JSON を返します。Apache Doris は当初から CSV に対応しており、現在は JSON、Parquet、ORC、ヘッダー付き CSV の各形式も受け付けます。
主な用語
- コーディネーター BE:HTTP 本文を受信して解析し、ロードを統括するバックエンドです。FE のリダイレクトによって選ばれるか、クライアントから直接指定されます。
label:リクエストで指定する、またはサーバーが生成する、トランザクションを識別する文字列です。成功したロードのラベルを再利用すると重複として拒否されます。失敗したロードのラベルは再利用できます。/api/{db}/{table}/_stream_load:標準のエンドポイントです。2PC 用のエンドポイントは_stream_load_2pcです。Expect: 100-continue:必須のヘッダーです。クライアントは先にヘッダーを送信し、サーバーが認証を確認してトランザクションを開始してから本文を送信します。max_filter_ratio:ロードごとに指定する不正な行の許容率です。デフォルトは 0 で、不正な行が 一行でもあるとバッチは失敗します。
Apache Doris Stream Load の仕組み
Apache Doris Stream Load は、ロード全体を 一回の HTTP リクエストで実行します。FE がコーディネーター BE にリダイレクトし、BE が本文を解析してトランザクションを開始し、タブレットの所有者に行を分配して、同じソケット上で応答します。
- クライアントが FE(または BE)に PUT を送信します。 ヘッダーにはラベル、形式、列のマッピング、フィルター、タイムアウトを指定します。本文はファイルまたはストリームです。
Expect: 100-continueを指定すると、本文のアップロード前にサーバーがリクエストを拒否できます。 - FE がコーディネーター BE を選び、リダイレクトします。 FE はラウンドロビン方式で選んだ BE への HTTP 307 を返します。正常な BE をすでに把握しているクライアントは、FE を経由せずに BE に直接 PUT を送信できます。
- コーディネーター BE がトランザクションを開始し、本文を解析します。 指定されたラベルでトランザクションを開始するため FE に要求し、形式に応じたリーダー(CSV、JSON、Parquet、ORC)で本文をストリーミング処理します。解析またはスキーマチェックに失敗した行は、
max_filter_ratioの判定対象として数えられます。 - 分配、書き込み、コミットを行います。 コーディネーターは各行を適切なタブレットを保持する BE に振り分けます。各 BE は memtable をセグメントにフラッシュします。その後、コーディネーターが FE にコミットを要求し、FE がすべてのレプリカに
PublishVersionを発行します。 - JSON を返します。 コーディネーターは元の PUT に対し、
Status、Label、TxnId、NumberLoadedRows、NumberFilteredRows、品質チェックで失敗があった場合のErrorURL、各フェーズの所要時間を含む JSON を返します。その後、接続を閉じます。
クライアントから見ると、この一連の処理は 一回の HTTP リクエストです。コミット成功後に同じラベルで再試行すると、FE は Label Already Exists を返して拒否します。これにより、最大 一回の処理が保証されます。
クイックスタート
対象のテーブルを作成します。
CREATE DATABASE IF NOT EXISTS testdb;
CREATE TABLE testdb.test_streamload (
  user_id BIGINT NOT NULL,
  name    VARCHAR(20),
  age     INT
) DUPLICATE KEY(user_id) DISTRIBUTED BY HASH(user_id) BUCKETS 1;
次に 10 行の CSV ファイルを作成し、HTTP PUT で Doris に送信します。Doris が別のホストで稼働している場合は、127.0.0.1 を FE のホストに置き換えてください。
cat > streamload_example.csv <<'CSV'
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64
CSV

curl --location-trusted -u root: \
  -H "Expect:100-continue" \
  -H "label:orders_2024_06_01" \
  -H "column_separator:," \
  -H "columns:user_id,name,age" \
  -T streamload_example.csv \
  -XPUT http://127.0.0.1:8030/api/testdb/test_streamload/_stream_load
期待される結果
{
  "TxnId": 3,
  "Label": "orders_2024_06_01",
  "Status": "Success",
  "NumberTotalRows": 10,
  "NumberLoadedRows": 10,
  "NumberFilteredRows": 0,
  "LoadBytes": 118,
  "LoadTimeMs": 173
}
Status: Success は、バッチがコミットされ、行をクエリできることを示します。SELECT COUNT(*) FROM testdb.test_streamload の結果は 10 です。同じ curl コマンドを再送すると Status: Label Already Exists が返り、データは書き込まれません。そのため、ネットワーク障害の際に再試行しても、重複してロードされません。
Apache Doris Stream Load を使うべき場合
クライアントがバッチごとに 一回の HTTP PUT、ラベルをキーとする再試行保証、同期的な JSON レスポンスを必要とする場合は、Apache Doris Stream Load を使用します。
適した用途
- HTTP をすでに使用し、チェックポイントごとに同期的な応答が必要な Flink、Spark などのストリーミングシンク。チェックポイントをまたいで厳密に 一回の処理を実現するには、
two_phase_commit:trueと組み合わせます。 - 一つの CSV、JSON、Parquet、ORC ファイル(通常は最大約 10 GB)を送信し、一回のアトミックなコミットを必要とする ETL スクリプト。
- データをプログラムで生成し、
curl -T -にパイプで渡す Bash のワンライナーや、各言語の HTTP クライアント。 - トランザクションマネージャーを使わずに、ラベルをキーとする再試行保証が必要なロード。
適さない用途
- 多数のクライアントから毎秒数万件の小さな PUT を送信する場合。各ロードが個別のトランザクションと rowset を作成し、FE のプランナーに過剰な負荷をかけ、BE で
-235 Too many segmentsを引き起こします。Group Commit で BE に小さな書き込みを 一つのトランザクションにまとめさせるか、Kafka の場合は Routine Load を使用してください。 - 10 GB を大きく超える単一ファイル。Apache Doris Stream Load は 一回の同期リクエストで実行されるため、接続が切れると最初からやり直す必要があります。ファイルを分割するか、サーバー側で実行され、クライアントの切断後も継続する Batch Load を使用してください。
- Kafka トピックを継続的に読み取る場合。Stream Load はオフセットを管理しません。オフセット、再起動、一時停止を管理する Routine Load を使用してください。
- クラウド環境またはストレージとコンピュートを分離した環境で、Merge-on-Write の Unique Key テーブルに対して Stream Load 2PC を使用する場合。BE はこの組み合わせを
Status::NotSupportedで拒否します。オンプレミスのシェアードナッシング構成のクラスターでは使用でき、回帰テストでも検証されています。 - サーバー側でのロード履歴の記録が標準で必要な場合。Apache Doris はデフォルトでは Stream Load の履歴を記録しません。
enable_stream_load_recordをbe.confで有効にすると、SHOW STREAM LOADで結果を表示できます。
関連情報
- Stream Load HTTP リファレンス:すべてのヘッダー、リダイレクトの規則、レスポンス本文の全項目
- Group Commit:
-235が発生する高頻度の Stream Load をサーバー側でまとめる方法 - Batch Load:S3 や HDFS の大きなファイルを非同期に一括取り込みする方法
- ロードトランザクションと Stream Load 2PC:二つのシステム間でチェックポイントに厳密に 一回の処理が必要な場合
- Routine Load:オフセットと一時停止を管理できる Kafka コンシューマー
- Doris Streamloader:Stream Load API で複数のロードを並列実行できるクライアントラッパー
- Unique Key:CDC パイプラインから列の一部を更新するアップサート(
partial_columns: true)の主な書き込み先。
