Unique Key モデル
要約 Apache Doris の Unique Key モデルは、主キーごとに一行を保持する主キーテーブルモデルです。トランザクションデータベースと同じように SQL の
UPDATEとDELETEを使用できます。部分列のアップサートは Stream Load から直接テーブルに書き込めます。バージョン 2.1 以降、Unique Key モデルはデフォルトで Merge-on-Write を使用します。重複は書き込み時に解消され、クエリ時にバージョンをマージする必要がありません。
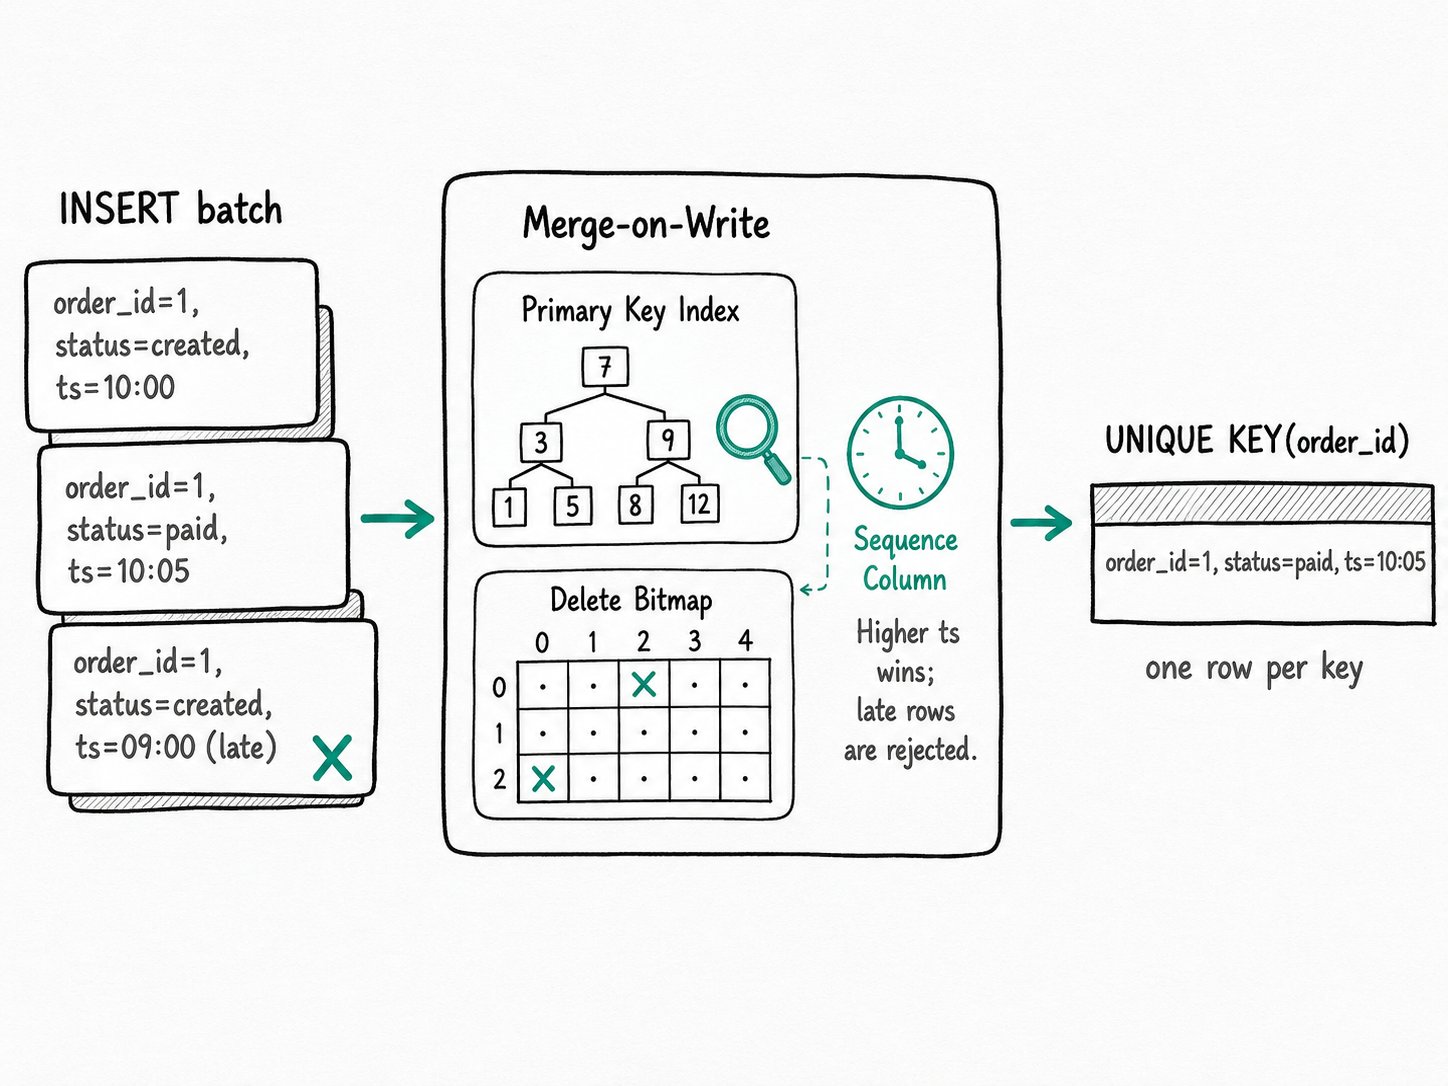
Apache Doris の Unique Key モデルを使う理由
Apache Doris の Unique Key モデルは、OLAP エンジンに主キーの性質を持たせます。キーごとに一行を保持し、書き込み時に一意性を即座に確保でき、パーティションを書き換えずに SQL の UPDATE と DELETE を実行できます。多くの分析エンジンは、テーブルを追記専用として扱います。しかし、CDC では行の変更を反映する必要があります。MySQL の行が更新される、ユーザーが GDPR に基づく削除を求める、到着の遅れたイベントで古い値を上書きする、といった場合です。追記専用のテーブルモデルでは変更を記録できますが、パーティション全体を書き換えなければ、ウェアハウスから古いバージョンを取り除けません。
- Flink CDC ジョブが MySQL を監視し、主キーに対応する更新を数秒以内に反映する必要があります。
- 注文ステータスが
created、paid、shipped、deliveredと変わっても、クエリには最新の状態だけを返す必要があります。 - ユーザープロファイルのテーブルをリアルタイムの結合に使い、結合結果に前日のメールアドレスを含めたくない場合があります。
こうした用途に適しているのが Unique Key モデルです。既存のキーで新たに書き込むと古い行が置き換わり、SQL の UPDATE と DELETE を使用でき、分析クエリでは列指向ストレージの処理速度を維持できます。他の OLAP エンジンでは ClickHouse の ReplacingMergeTree が最も近い仕組みですが、即時の一意性は保証しません。バックグラウンドのマージが実行されるまでは重複行が見え、実行後もエンジンが保証するのは最終的な重複排除だけです。書き込み直後のクエリで古いバージョンが見えることがあり、読み取り時に重複排除を強制する回避策である SELECT ... FINAL には相応のコストがかかります。Unique Key モデルでは、書き込み時に新しい行が古い行を置き換え、次のクエリにはキーごとに一行だけが見えます。
Apache Doris の Unique Key モデルとは
Apache Doris の Unique Key モデルは、主キーごとにちょうど一行を保持するテーブルモデルです。Merge-on-Write エンジンが書き込み時に一意性を確保します。UNIQUE KEY(...) 句で CREATE TABLE のキー列を指定し、それ以外はすべて値列になります。同じキーを持つ二つの行は共存できません。既存のキーで新たに書き込むと、その行が置き換わります。
... UNIQUE KEY(order_id) ...
... UNIQUE KEY(tenant_id, user_id) ...
FE のカタログでは、このモデルは KeysType.UNIQUE_KEYS として記録されます。以後、ストレージエンジンはこの定義に従います。テーブルモデルは作成時に確定し、後から変更できません。
主な用語
- 主キー:
UNIQUE KEY(...)に指定する列です。ディスク上のデータの並び順を決め、一意性も保証します。 - 値列:主キー以外のすべての列です。集約せず、書き込まれた値のまま保存されます。
- Merge-on-Write(MoW):2.1 以降のデフォルトのバックエンドです。新しい書き込みでは既存行を検索し、rowset ごとの削除ビットマップでその行 ID のビットを立て、新しい行を新規 rowset に追加します。
- Merge-on-Read(MoR):従来のバックエンドです。書き込み時には行を追加し、読み取り時にキーごとの複数バージョンをその場でマージします。
enable_unique_key_merge_on_write = falseを指定すれば、引き続き選択できます。 - 削除ビットマップ:
(rowset_id, segment_id, version)をキーとし、クエリが読み飛ばす行 ID を列挙する Roaring ビットマップです。MoW ではこれにより読み取り時のマージを不要にします。 - シーケンス列(
function_column.sequence_col):同じキーに対して複数の更新があるとき、どの書き込みを優先するかを決める値列です。順序が前後した CDC イベントでも新しい状態を保持するために使用します。 - 部分列更新:一部の列だけを書き込むアップサートです。Apache Doris は残りの列を既存行から読み取り、完全な行を書き戻します。
__DORIS_DELETE_SIGN__:非表示の tinyint 列です。任意のロード経路から1に設定すると、その行を論理削除できます。
Apache Doris の Unique Key モデルの仕組み
Apache Doris の Unique Key モデルは、各アップサートを五つの段階で処理します。バッチをバッファリングし、セグメントごとの主キーインデックスでキーを検索し、古い行の削除ビットマップのビットを立て、シーケンス列で書き込みの優先順位を決め、新しい rowset を公開します。
Unique Key の MoW テーブルに対するアップサートを例に説明します。
- バッチをバッファリングします。 BE は受信した行を memtable に集め、キー順にソートします。
- 各キーを検索します。 BE はバッチ内の各キーについて、セグメントごとの主キーインデックスを参照し、既存の rowset と行 ID を探します(キーごとに短い読み取りを 一回行います)。このインデックスは、各セグメントのフラッシュ時に構築される、ソート済みでページ分割された構造です。概念的には RocksDB のパーティション化インデックスに似ています。
- 古い行にマークを付けます。 影響を受ける各 rowset の削除ビットマップで、古い行 ID に対応するビットを立てます。ビットマップは
(rowset_id, segment_id, version)ごとに管理され、古いデータはコンパクションで回収されるまでディスク上に残ります。 - シーケンス列で優先順位を決めます。
function_column.sequence_colが設定されている場合、MoW は受信行のシーケンス値と現在の行の__DORIS_SEQUENCE_COL__を比較します。大きい値が優先されます。同じ値の場合はロード順で決まります。シーケンス列の型は整数型またはDATE/DATETIMEにする必要があります。 - 新しい rowset を公開します。 トランザクションがコミットされると新しいバージョンが参照可能になり、それ以降のクエリはマージ済みの削除ビットマップに従って行を除外します。読み取り時にバージョンをマージする処理はありません。
DELETE FROM ... WHERE も、新しい rowset の追加を除いて同じ流れで処理されます。部分更新では、書き込み前に各キーについて変更しない列を BE が読み取り、完全な行として保存する手順が加わります。
クイックスタート
CREATE TABLE orders (
  order_id BIGINT,
  status   VARCHAR(20),
  amount   DECIMAL(10, 2),
  updated  DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4
PROPERTIES ("function_column.sequence_col" = "updated");

INSERT INTO orders VALUES
  (1, 'created', 99.50, '2026-05-08 10:00:00'),
  (1, 'paid',    99.50, '2026-05-08 10:05:00'),
  (1, 'created', 99.50, '2026-05-08 09:00:00');  -- late event

SELECT * FROM orders;
期待される結果
+----------+--------+--------+---------------------+
| order_id | status | amount | updated             |
+----------+--------+--------+---------------------+
|        1 | paid   |  99.50 | 2026-05-08 10:05:00 |
+----------+--------+--------+---------------------+
三行分のデータを INSERT で書き込んでも、残るのは 一行です。二行目はキーが同じなので 一行目を上書きします。三行目も上書きしようとしますが、updated の値が現在のシーケンス値より古いため、MoW は既存の行を保持します。function_column.sequence_col プロパティを外すと、ロード順だけで 三行目が優先されます。これは CDC では望ましくありません。
Apache Doris の Unique Key モデルを使う場面
Apache Doris の Unique Key モデルは、CDC シンク、リアルタイムのディメンションテーブルやルックアップテーブル、頻繁に変わる注文・ユーザー・残高テーブル、store_row_column と組み合わせた KV 形式のポイントルックアップ、GDPR に対応する行単位の削除、複数の上流システムからのワイドテーブル構築に適しています。一方、追記専用のイベントストリーム、単一行の更新を短い間隔で繰り返す処理、ランダムまたは非常に幅の広い主キー、従来の Merge-on-Read バックエンドで count(*) を多用するワークロードには適していません。
適した用途
- MySQL、Postgres など、主キーを持つソースからの CDC シンク。ソースのコミットタイムスタンプまたは LSN をシーケンス列に使います。Kafka CDC 連携を参照してください。
- ファクトテーブルのクエリで結合する、リアルタイムのディメンションテーブルやルックアップテーブル。
- 頻繁に変更され、分析クエリの対象にもなる注文、ユーザー、残高、セッション状態のテーブル。
- MoW と
store_row_columnとプリペアドステートメントを組み合わせた、KV 形式のポイントルックアップ。高並列ポイントクエリを参照してください。 - ユーザー ID に基づく GDPR 対応の行単位の削除。任意のロード経路で
__DORIS_DELETE_SIGN__を使う論理削除も含みます。 - 各上流システムが担当する列グループだけを
partial_columns: trueの Stream Load で書き込むワイドテーブルの構築。部分列更新を参照してください。
適さない用途
- 追記専用のイベントストリーム(ログ、クリックストリーム、IoT の計測値)。使わない機能のために、書き込みごとにキーインデックスを検索するコストがかかります。代わりに Duplicate Key モデルを選びます。データモデルを参照してください。
- 単一行の
UPDATEを短い間隔で繰り返す処理。各文が個別のトランザクションになるため、コミットのオーバーヘッドが支配的になります。partial_columns: trueを指定した Stream Load でバッチ処理するか、Group Commit を使用します。 - ランダムまたは非常に幅の広い主キー(UUID や長い複合キーなど)。ロードバッチごとに主キーインデックスを走査するため、ランダムなキーではキャッシュの局所性が損なわれます。整数型を優先し、キーを狭く保ち、値を収められる最小の型を使います。浮動小数点型(FLOAT、DOUBLE)と、
ARRAY、MAP、STRUCT、JSON、VARIANTなどの複合型は、キー列として使用できません。 - 主キーの上位集合をパーティションキーにする構成。パーティション列は必ず一意キーの部分集合にする必要があり、その逆はできません。そうしないと、同じキーが二つのパーティションに入り、重複排除が正しく機能しません。
- MoR で
count(*)を多用するワークロード。MoR はクエリ時にバージョンを再構築するため、行数のカウントにはコストがかかります。Merge-on-Write(2.1 以降のデフォルト)を有効にするか、データが実際に追記専用なら Duplicate Key モデルに切り替えます。
関連情報
- Unique Key モデル:SQL 構文、Merge-on-Write と Merge-on-Read の違い、パーティションのルール、テーブル作成時のプロパティについて詳しく説明します。
- データの更新と削除:SQL の操作(
UPDATE、DELETE、部分列アップサート、アトミックなパーティション交換)と、その基盤となる Merge-on-Write の内部処理を説明します。 - データモデル:Unique Key と Duplicate Key および Aggregate Key を比較し、それぞれに適したワークロードを説明します。
- シーケンス列による並行更新の制御:使用可能な型、NULL の扱い、順序が前後した書き込みの解決方法を説明します。
- 高並列ポイントクエリ:Unique Key テーブルを KV ストアとして使用するためのショートサーキットプランを説明します。
- Apache Doris 2.1.0:Unique Key のデフォルトが Merge-on-Write に
