ベクトルインデックス
要点 Apache Doris 4.0 では、
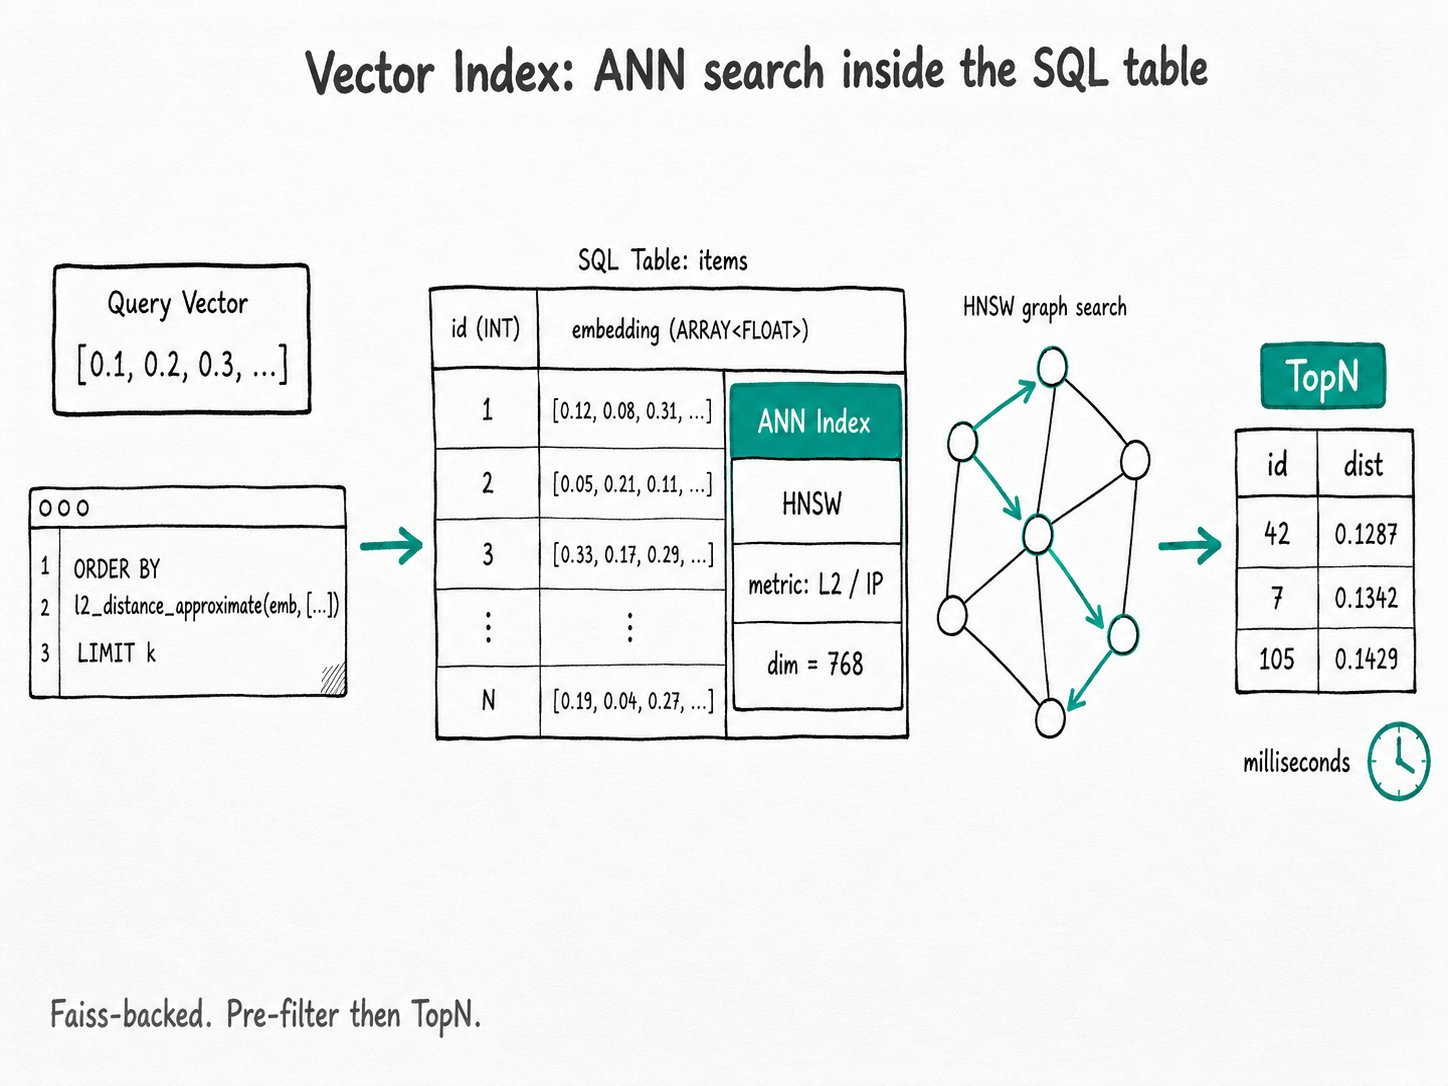
ARRAY<FLOAT>カラムに対するネイティブ ANN インデックスが追加されました。インデックスはCREATE TABLE内で宣言できます(またはCREATE INDEX ... USING ANNで作成できます)。HNSW または IVF、L2 距離または内積を選択し、l2_distance_approximateまたはinner_product_approximateをORDER BY ... LIMIT kで呼び出します。Faiss を基盤とするベクトルインデックスは TopN の前にフィルタリングを行うため、WHERE条件も正しく適用されます。
Apache Doris でベクトルインデックスを使う理由
Apache Doris のベクトルインデックスを使えば、分析用データウェアハウスとは別にベクトルデータベースを用意する必要がなくなります。ベクトル検索が必要になったとき、別のクラスタを追加するのが一般的な方法です。この方法でも動作しますが、費用と運用の両面で負担が増えます。キーワードによるフィルタ条件は一方のシステムに、埋め込みベクトルはもう一方のシステムに置かれるためです。
- 「最も近い 10 個のベクトルを探す」ためだけに、別のクラスタの規模を決め、監視し、費用を負担する必要があります。
- 行が片方で更新され、もう片方では更新されないと、分析テーブルとベクトルストアの内容が食い違います。
- SQL エンジンからベクトルを参照できないため、アプリケーションにクエリを振り分けて結果を統合するコードが必要になります。
Apache Doris では、ベクトルインデックスをほかのデータと同じテーブルに格納できます。取り込みパイプラインは一つ、結果を得るための SQL クエリも一つです。
Apache Doris のベクトルインデックスとは
Apache Doris のベクトルインデックスは、ベクトルを格納するカラムに対する ANN(近似最近傍探索)のセカンダリインデックスです。新しいカラム型は不要で、ベクトルは次元数が固定された ARRAY<FLOAT> として格納されます。インデックスはデータとともにセグメント単位で構築され、プランナーが ORDER BY 内に近似距離関数を検出すると使用されます。
主要な用語
ARRAY<FLOAT>: Apache Doris でベクトルを格納する形式です。カラムはNOT NULLである必要があり、各行の配列長はインデックスのdimと一致しなければなりません。USING ANN: インデックスを指定する句です。プロパティでアルゴリズム(hnsw、ivf、ivf_on_disk)、距離尺度(l2_distanceまたはinner_product)、次元数を選択します。- HNSW: デフォルトのグラフベースのアルゴリズムです。高速で再現率が高い一方、メモリ上に保持する必要があります。
- IVF / ディスク上の IVF: メモリが限られる環境で、より大規模なデータ集合に適した転置ファイル方式のアルゴリズムです。
l2_distance_approximate/inner_product_approximate: インデックスの使用を引き起こす SQL 関数です。_approximateの付かない関数もありますが、そちらは総当たり検索にフォールバックします。
Apache Doris のベクトルインデックスの仕組み
Apache Doris のベクトルインデックスは、ロード時の構築、クエリパターンの認識、事前フィルタリング、セグメントごとの TopN の統合、セッション変数による再現率の調整という五つの段階で動作します。
- ロード時に構築。 セグメントの書き込み時に、Apache Doris はカラムを Faiss に渡し、データとともにインデックスファイルを構築します。セグメントごとに一つのインデックスが作られ、別途構築ジョブを実行する必要はありません。
- プランナーがパターンを認識。
ORDER BY l2_distance_approximate(col, [...]) LIMIT kを使うクエリは、ストレージ側のAnnTopNオペレーターに書き換えられます。リテラルのベクトルは LIMIT とともにプッシュダウンされます。 - 事前フィルタリングの後に TopN を実行。
WHERE句がある場合、Apache Doris は先に条件を評価し、残った行に対して ANN TopN を実行します。これにより、絞り込み条件が厳しい場合でも再現率が保たれます。条件に使うカラムには転置インデックスなど独自のセカンダリインデックスが必要です。ない場合は、結果の正しさを保つため、対象行の総当たり検索にフォールバックします。 - セグメントごとに TopN を求めてから統合。 各セグメントが最も近い k 件を返します。TopN オペレーターがセグメントとタブレットをまたいで結果を統合し、全体の k 件を生成します。
- クエリ実行時に調整可能。
hnsw_ef_searchなどのセッション変数で候補キューを広げると、レイテンシーと引き換えに再現率を高められます。デフォルト値は控えめなので、目標とする再現率に応じて調整してください。
クイックスタート
CREATE TABLE docs (
  id INT NOT NULL,
  embedding ARRAY<FLOAT> NOT NULL,
  INDEX idx_emb (embedding) USING ANN PROPERTIES(
    "index_type" = "hnsw",
    "metric_type" = "l2_distance",
    "dim" = "3"
  )
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO docs VALUES
  (1, [1.0, 2.0, 3.0]),
  (2, [0.5, 2.1, 2.9]),
  (3, [10.0, 10.0, 10.0]);

SELECT id, l2_distance_approximate(embedding, [1.0, 2.0, 3.0]) AS dist
FROM docs ORDER BY dist LIMIT 3;
期待される結果
+------+-----------+
| id   | dist      |
+------+-----------+
|    1 |         0 |
|    2 | 0.5196152 |
|    3 |  13.92839 |
+------+-----------+
id=1 に対する距離は正確に 0 です。ANN インデックスは近い二件を先に、離れた一件を最後に順位付けします。同じ形式のクエリを SIFT-1M データセット(1M 件の 128 次元ベクトル)に対して実行すると、インデックスありでは約 20 ms、なしでは約 290 ms かかります。いずれもベクトル検索の概要に記載された数値です。
Apache Doris のベクトルインデックスを使う場面
Apache Doris のベクトルインデックスは、埋め込みベクトルが、すでに絞り込みや集計に使用している構造化カラムと同じテーブルにあるワークロードに適しています。
適した用途
- 同じテーブルにテナント ID、文書の種類、時刻、その他のフィルタ用カラムも格納する RAG の検索。フィルタリングとベクトル検索を一つのクエリで実行できます。
- 商品やコンテンツのメタデータとともに埋め込みベクトルを格納し、そのメタデータをダッシュボードにも使用するレコメンデーションの候補検索や「類似項目を探す」機能。
- 近似範囲検索(
WHERE l2_distance_approximate(...) > 300)を使う異常検知や「距離 X 以内のすべての項目を探す」ワークロード。 MATCH_*のテキスト条件とベクトルの順位付けを組み合わせるハイブリッド検索。転置インデックスで事前に絞り込み、ANN インデックスで順位付けします。ハイブリッド検索を参照してください。
適さない用途
- フィルタも SQL 分析も使わない、数十億件規模の純粋な ANN 検索。専用のベクトルデータベースのほうが運用コストが低く、QPS あたりのメモリ使用量も少なくなる場合があります。
AGGREGATE KEYテーブル、または merge-on-write を使わないUNIQUE KEYテーブル。現在、ANN インデックスにはDUPLICATE KEYまたは MoW のUNIQUE KEYが必要です。- NULL を許容するベクトルカラムや配列長の異なる行。カラムは
NOT NULL ARRAY<FLOAT>である必要があり、各行の長さは宣言したdimと完全に一致しなければなりません。長さが異なるデータのロードは失敗します。 score()と距離関数を同じORDER BY内で併用する場合。TopN のプッシュダウンでは並べ替え式を一つしか受け付けません。BM25 と ANN のスコアを統合する必要がある場合は、SQL レイヤーの上位で統合してください。cosine_distanceを使うコサイン類似度検索。Apache Doris にはコサイン距離尺度がないため、挿入前にベクトルを正規化してinner_productを使用してください。単位長のベクトルでは、コサイン類似度は内積と等しくなります。
性能と数値
以下の数値は、プロジェクトが公開した Cohere-MEDIUM-1M(768 次元、1M 件のベクトル、FE 32C 64GB + BE 32C 64GB)のベンチマークによるものです。
| 同時実行数 | 方式 | QPS | 平均レイテンシー | P99 レイテンシー | 再現率 |
|---|---|---|---|---|---|
| 240 | HNSW (FLAT) | 3,340 | 71 ms | 163 ms | 91.0% |
| 240 | HNSW + SQ INT8 | 3,189 | 75 ms | 160 ms | 88.3% |
| 240 | 総当たり検索(インデックスなし) | 3.7 | 25.6 s | 29.4 s | 100% |
出典: ベクトルインデックスの性能。これらの数値は目安であり、お使いのワークロードでの性能を保証するものではありません。同じページによると、SQ8 量子化ではインデックスのサイズが FLAT の約三分の一になる一方、上表に示すように再現率はわずかに低下します。
関連資料
- ハイブリッド検索: ANN インデックスと転置インデックスを一つの SQL 文で組み合わせる方法。
- ベクトル検索の概要: インデックスのプロパティ、クエリパターン、制限の詳細。
- HNSW の詳細:
max_degree、ef_construction、ef_searchによる再現率とレイテンシーの調整方法。 - ディスク上の IVF: ベクトル集合が BE のメモリに収まらない場合の選択肢。
- 実践ガイド: データの準備、ロード、チューニングを含む一連の手順。
- 埋め込み:
EMBED()SQL 関数を使って、テキストやメディアを、このインデックスが読み取るARRAY<FLOAT>ベクトルに変換する方法。 - AI の概要: ベクトル検索と Doris のほかの AI 機能との関係。
