ベクトル化実行
要点 Apache Doris のすべてのクエリは、ベクトル化エンジンで実行されます。オペレーターは
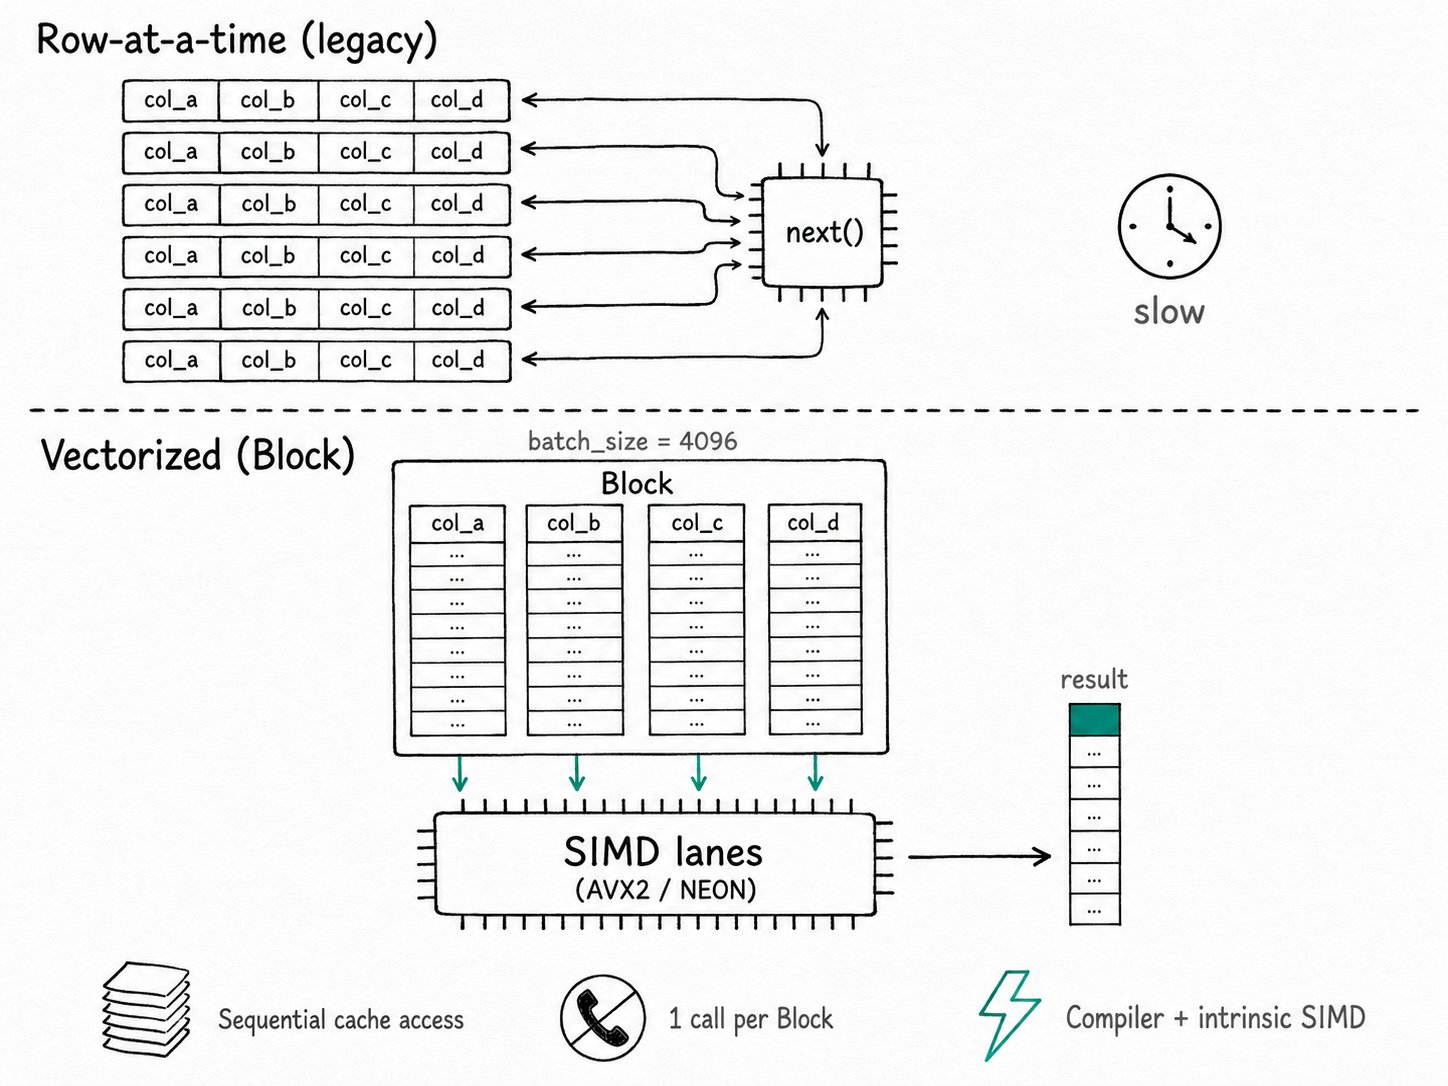
Block単位で最大 4,096 行の列指向データを受け渡します。内部ループは、コンパイラーや手書きの組み込み関数が SIMD を利用できるように設計されています。行ベースのエンジンは v2.0 で完全に削除されたため、有効化の操作は不要です。ほとんどのユーザーが調整する可能性のある設定はbatch_sizeだけです。
Apache Doris でベクトル化実行を使う理由
Apache Doris のベクトル化実行は、行ごとの仮想関数呼び出しを列単位のバッチ処理ループに置き換え、CPU が間接呼び出しよりも演算に時間を使えるようにします。従来の Volcano 型実行エンジンは、オペレーターのツリーをたどりながら、行ごとに next() を呼び出して一つのタプルを生成します。最新の CPU では、仮想関数呼び出し、分岐予測の失敗、キャッシュミスにかかるコストに比べて、実際の演算コストはごくわずかです。十億行を一行ずつ集計すると、高速なマシンでも処理が遅くなります。
- オペレーターごとに各行で仮想関数を呼び出すと、分岐予測が効きにくい間接ジャンプが何百万回も発生します。
- 行データがメモリ上に不規則に配置されると、CPU の L1/L2 キャッシュに有用なデータが載りにくくなります。
- データが行をまたいで交互に配置されていると、数値演算の単純なループを自動ベクトル化できません。
ベクトル化実行では、内部ループの処理方法が変わります。オペレーターは列の値をバッチで受け取り、そのバッチを単純なループで処理します。頻繁に実行される処理は、AVX2 が得意とする形になります。
Apache Doris のベクトル化実行とは
Apache Doris のベクトル化実行は、列指向のバッチを処理するクエリエンジンです。各オペレーターの get_block() は一つの Block を消費して別の Block を生成します。Block は、1 行から batch_size 行までを表す少数の列指向配列です。SIMD の組み込み関数は、フィルターの選択、Decimal 演算、文字列比較、JSON 解析など、効果の大きい処理を高速化します。このモデルは MonetDB/X100 と Vectorwise に由来します。ClickHouse、StarRocks、DuckDB も同じ設計を採用しています。
主な用語
Block:オペレーター間で受け渡すデータの単位です。型付きの列指向配列と列のメタデータを保持します。実装はbe/src/vec/core/block.hにあります。Column:Block 内にある一つの型付き配列です。ColumnVector、ColumnString、ColumnDecimal、ColumnNullable、ColumnDictionaryなど、データの形に合わせて最適化された実装があります。batch_size:Block に含める行数の上限です。デフォルトは 4,096 で、セッションごとに設定できます。大きなバッチでは呼び出しごとのオーバーヘッドを分散でき、小さなバッチではメモリ使用量とテールレイテンシーを抑えられます。- SIMD 実行経路:
be/src/util/simd/にある手書きのコードと、コンパイラーが自動ベクトル化したループを組み合わせたものです。実行時に、AVX2 を x86 で、NEON を ARM で使用するように切り替えます。
Apache Doris のベクトル化実行の仕組み
Apache Doris のベクトル化実行では、オペレーターが最大 4,096 行の列指向 Block を受け渡し、効果がある箇所では SIMD を使いながら列ごとに単純なループを実行します。Pipeline スケジューラーは、これらのバッチの処理を複数のコアに分散します。
- プランからオペレーターの連鎖へ。 オプティマイザーがプランを生成し、FE がそれをオペレーターのパイプラインに書き換えます。各オペレーターは
get_block(state, block, eos)を実装します。 - バッチの取得。 スキャンオペレーターはタブレットの列指向ストレージから最大
batch_size行を読み取り、その場で Block に格納して返します。行が構造体として実体化されることはありません。 - 列ごとの処理。 フィルター、射影、集計、結合の各オペレーターは、単純なループで各列を走査します。効果がある場合は、フィルターの圧縮に使う
bytes32_mask_to_bits32_maskや、ベクトル化された Decimal 比較などの SIMD プリミティブを呼び出します。 - 後続への受け渡し。 Block は値としてパイプラインを流れます。Pipeline スケジューラーは CPU 負荷の高い段階と I/O 負荷の高い段階を複数のコアに割り当てます。複数のパイプラインタスクが異なる Block を並列に処理します。
- クライアントへの返却。 最後のオペレーターが最終的な Block を MySQL ワイヤープロトコルにシリアライズし、クエリが完了します。
v2.0 で導入された Pipeline エンジンは、この仕組みの上に構築されています。ベクトル化はオペレーターがバッチに対して何をするかを決め、Pipeline はそのバッチを複数のコアでどうスケジュールするかを決めます。両者は異なる層ですが、混同されがちです。
クイックスタート
ベクトル化実行を有効にする必要はありません。これが唯一の実行モードです。知っておくべき設定項目は batch_size です。
-- Default; safe to leave alone for most workloads
SHOW VARIABLES LIKE 'batch_size';

-- Larger batches: better throughput on big aggregations, more memory per fragment
SET batch_size = 8192;

SELECT user_id, COUNT(*) AS events, SUM(bytes) AS total_bytes
FROM access_log
WHERE ts BETWEEN '2026-05-01' AND '2026-05-08'
GROUP BY user_id
ORDER BY total_bytes DESC
LIMIT 10;
想定される結果
+---------+--------+-------------+
| user_id | events | total_bytes |
+---------+--------+-------------+
|   42718 |  18374 |   924518127 |
|     ...                        |
+---------+--------+-------------+
集計は、8,192 行の Block を列ごとに処理します。一致する行が数百万件ある幅の広いテーブルをスキャンする場合、バッチを大きくすると BE のメモリ使用量がやや増える代わりに、スケジューリングの往復回数が減ります。そのため、長いスキャンでは通常有利ですが、少量のデータを取得するポイントクエリでは不利になります。
Apache Doris のベクトル化実行を使うべき場面
v2.0 以降、Apache Doris の実行モードはベクトル化実行だけです。そのため、実際に検討すべきなのは、batch_size を調整するタイミングや、別のクエリ経路を利用するタイミングです。
適しているケース
- Doris で実行するすべてのワークロード。スキャンを多用する集計、GROUP BY、ハッシュ結合、ソートはすべてこのエンジンで動作します。比較対象となる「非ベクトル化」オプションはありません。
- 幅の広いテーブルの分析やダッシュボードクエリ。列ごとのループと SIMD フィルターが特に効果を発揮します。
- AVX2 または NEON に対応したマシン上のワークロード。Doris のインストールチェックリストでは AVX2 対応の x86 CPU を推奨しています。ARM では NEON がデフォルトの実行経路です。古い CPU でも動作しますが、SIMD で高速化する処理はスカラーコードにフォールバックします。
適していないケース
- 毎秒数千クエリで処理する、主キーによる単一行の検索。Block に一行しかない場合、Block ごとの初期化コストが不利に働きます。代わりに 高並行ポイントクエリ の経路を使用してください。
- アドホッククエリのための
batch_sizeの調整。デフォルトの 4,096 には理由があり、変更しても通常は効果がないか、やや悪化します。プロファイリングでバッチごとのオーバーヘッドが支配的だと分かった場合や、フラグメントでメモリが不足する場合にだけ検討してください。 enable_vectorized_engineに言及する古い助言に従うこと。このセッション変数は v1.2.1 で効果のない設定となり、行ベースの実装は v2.0 で削除されました。ドキュメントやブログ記事にこの変数を切り替えるよう書かれている場合、その内容は古くなっています。- この機能とベクトル検索を混同すること。「ベクトル化実行」はクエリエンジンのモデルです。ANN 型のベクトル検索は、
docs/ai/vector-search/以下にある別のインデックス群を使用します。
パフォーマンス
- 以前のバージョンより 3~5 倍高速:v1.1 でベクトル化実行がすべてのクエリのデフォルトになった際の値です。出典:Apache Doris 1.1.0 リリースノート。
- 幅の広いテーブルの集計で 5~10 倍の改善:列指向のメモリ配置と SIMD による高速化の組み合わせによるものです。出典:Doris の製品コンセプト。
関連資料
- 製品コンセプト:ベクトル化実行エンジン
- Pipeline 実行エンジン
- システムアーキテクチャの概要
- 列指向ストレージ:ページとエンコーディングがベクトル化された列に直接データを供給するディスク上の形式です。
- Parquet Reader の最適化:外部 Parquet のデコード結果が Arrow を経由せずにベクトル化エンジンへ直接渡される仕組みを説明します。
- Apache Doris 2.0 リリースノート(行ベースのエンジンの削除)
- MPP アーキテクチャ:単一の BE 内だけでなく、複数の BE にまたがってベクトル化オペレーターをスケジュールする層です。
