垂直コンパクション
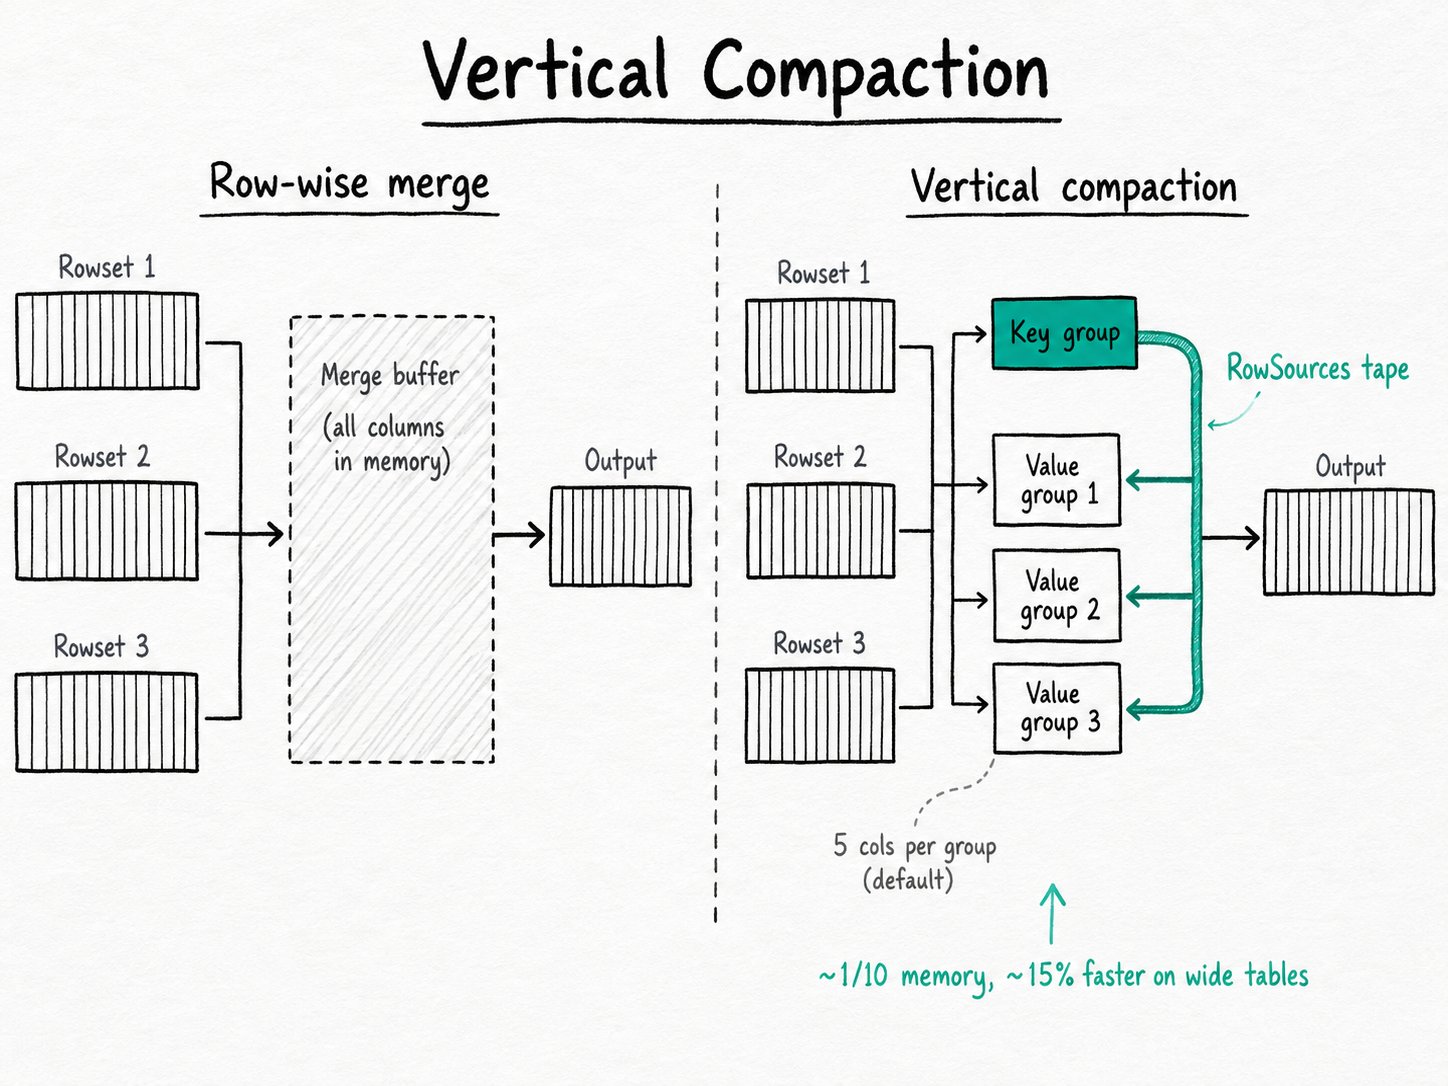
要約 Apache Doris の垂直コンパクションは、幅の広いテーブルのスキーマを小さなカラムグループに分け、グループごとにマージします。従来の行単位のコンパクションのように、すべてのカラムを同時にメモリへ保持しません。キー列から作る行ごとのシーケンスマーカーを使って出力を同一に保ちながら、幅の広いテーブルではコンパクション時のメモリ使用量を約 1/10 に減らし、処理速度を約 15% 向上させます。垂直コンパクションは Apache Doris 1.2.2 以降、デフォルトで有効です。
Apache Doris で垂直コンパクションを使う理由
垂直コンパクションは、幅の広いテーブルで Apache Doris のコンパクションに使うメモリを一定範囲に抑えます。行単位のマージではすべてのカラムを一度にメモリへ読み込むため、BE がメモリ不足(OOM)になることがあります。コンパクションは、タブレットの rowset を少数の大きな rowset にまとめ、クエリが数百ものバージョンをたどらずに済むようにするバックグラウンド処理です。従来のアルゴリズムは各入力 rowset から行を一つずつ読み、採用する行を選んで書き出すことを繰り返します。5 カラムのファクトテーブルでは問題なく動作しますが、200 カラムのユーザーテーブル、とりわけカラムに大きな VARIANT の JSON ペイロードが入る場合には行き詰まります。
- マージ用のブロックは、バッチ内の各行についてすべてのカラムを保持する必要があります。メモリ使用量はカラム数とバッチサイズの両方に応じて増えます。
- バックエンド(BE)は多数のコンパクションタスクを並列実行します。幅の広いテーブルのタスクが数件あるだけでも、ノードが OOM になる可能性があります。
- 運用者がメモリを抑えるためにコンパクションのスレッドプールを制限すると、rowset がたまります。タブレットのバージョン数が
max_tablet_version_numを超えると、ロードがエラー -235 で失敗し始めます。
垂直コンパクションは、この問題に対処します。マージの単位を「すべてのカラムを含む一行」から「全行にわたる一つのカラムグループ」に変えます。そのために、行ごとのシーケンスマーカーという構造を一つ追加します。
Apache Doris の垂直コンパクションとは
Apache Doris の垂直コンパクションは、行単位ではなく、カラムをグループに分けてマージするアルゴリズムです。BE はテーブルのスキーマをキー列のグループと複数の値列のグループ(デフォルトではグループあたり 5 カラム)に分けます。まずキーグループをマージして全体の順序を確定し、その順序を再利用して各値グループをマージします。出力 rowset は行単位のコンパクションで生成されるものと同じで、変わるのはメモリ使用量の特性だけです。
主な用語
Column group:スキーマを一定数のカラムで区切ったものです。デフォルトはグループあたり 5 カラムで、テーブルごとに設定できます。Key group:テーブルのキー列から作る最初のグループです。このグループのマージで出力行の順序が決まります。RowSourcesBuffer:各出力行がどの入力 rowset のどの行から来たかを記録する、ディスクを補助記憶として使うバッファーです。デフォルトの上限は 1 GB です。Vertical merge iterator:すべての入力 rowset から一つのカラムグループを走査し、マージしたカラムを出力する BE コンポーネントです。enable_vertical_compaction:デフォルトでtrueの BE 設定フラグです。無効にすると行単位のコンパクションに戻ります。
Apache Doris の垂直コンパクションの仕組み
Apache Doris の垂直コンパクションは、スキーマをカラムグループに分割し、まずキーグループをマージして行の順序を確定します。その順序を各値グループに適用するため、処理中のグループ以外のカラムをメモリに保持する必要がありません。以下の五つのステップで、分割、マージ、順序の再利用、結合、ディスクへの退避を説明します。
- スキーマをグループに分ける。 BE はタブレットのスキーマをたどり、キー列をグループ 0 に入れ、残りのカラムを
vertical_compaction_num_columns_per_group個ずつのグループに分けます(デフォルトは 5)。enable_vertical_compact_variant_subcolumnsが有効な場合、BE は VARIANT サブカラムも同じ処理に組み込みます。 - キーグループをマージして順序を記録する。 Merger は、すべての入力 rowset のキー列をヒープを使ってソートします。各行をヒープから取り出すたびに、その行の取得元を示すエントリを RowSourcesBuffer に書き込みます。この処理で、ソート済みのキー列と全体の RowSources 記録が得られます。
- 値グループごとに記録した順序を再利用する。 BE は値グループごとに同じ入力 rowset を開き、そのグループのカラムだけを読みます。次に読む入力はヒープではなく RowSources の記録に従って選びます。比較処理は不要で、処理中のグループ以外のカラムをメモリに保持しません。
- グループを一つの rowset に結合する。 出力ライターは各グループを一つのセグメントファイルに組み立てます。削除ビットマップと転置インデックスの更新も含め、結果は行単位のコンパクションとバイト単位で一致します。
- 記録が大きくなったらディスクに退避する。 RowSourcesBuffer の上限は
vertical_compaction_max_row_source_memory_mb(1 GB)で設定します。マージで生成される行がこの上限を超える場合、バッファーはタブレットのディレクトリに退避し、ステップ 3 でストリーミング読み込みされます。
トレードオフとして、垂直コンパクションでは各入力 rowset を全体で一回ではなく、グループごとに一回読みます。ディスク IO がボトルネックのクラスターでは、IO コストが概ね (num_groups - 1) の分だけ増えます。通常はメモリ削減の効果が上回るため、デフォルトで有効になっています。カラム数が少ないテーブル(5 カラム以下)ではスキーマから作られるグループは結局一つだけで、アルゴリズムは行単位の処理に戻ります。
クイックスタート
垂直コンパクションはデフォルトで有効です。以下は、幅の広いテーブルのカラムをどの程度細かくグループ化するかを制御する、テーブル単位の設定例です。
CREATE TABLE user_profile (
  user_id BIGINT,
  name VARCHAR(64), age INT, country VARCHAR(32), city VARCHAR(64),
  attr_01 STRING, attr_02 STRING, attr_03 STRING, attr_04 STRING,
  attr_05 STRING, attr_06 STRING, attr_07 STRING, attr_08 STRING
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "vertical_compaction_num_columns_per_group" = "3"
);

SHOW CREATE TABLE user_profile;
期待される結果
+--------------+--------------------------------------------------+
| Table        | Create Table                                     |
+--------------+--------------------------------------------------+
| user_profile | ... "vertical_compaction_num_columns_per_group" |
|              |     = "3" ...                                    |
+--------------+--------------------------------------------------+
グループサイズを 3 にすると、IO がやや増える代わりにメモリ使用量をさらに抑えられます。これは大きな STRING または JSONB カラムが多数あるテーブルに適しています。SHOW CREATE TABLE で設定が反映されたことを確認してください。デフォルトに戻すには、ALTER TABLE でそのプロパティを削除します。
Apache Doris の垂直コンパクションを使う場面
Apache Doris の垂直コンパクションは、カラム数の多いスキーマ、行単位のコンパクションで OOM が起きるタブレット、疎な VARIANT サブカラムを持つテーブルに適しています。カラム数の少ないテーブルや、読み込み回数の増加による負荷がメモリ削減の利点を上回るディスク IO がボトルネックのクラスターでは、設定を調整する必要はありません。
適したケース
- カラムが数十以上ある幅の広いスキーマ。特に大半が可変長カラム(
STRING、JSONB、ARRAY、MAP)の場合です。スキーマが大きいほど効果も大きくなります。 - 行単位のアルゴリズムによるコンパクションで OOM が起きるタブレット。スレッドプールを制限する代わりに、グループサイズを 5 から 2 または 3 に下げます。
- 疎な
VARIANTサブカラムを持つテーブル。同じ処理経路はenable_vertical_compact_variant_subcolumnsにも使われ、マージ中に存在しないサブカラムを実体化せずに済みます。 - 幅の広いテーブルでベースコンパクションが遅い場合。グループごとの作業データが小さくなり、マージ処理が CPU キャッシュに収まりやすくなります。
適さないケース
- カラムが少ないテーブル(一~五カラム)。カラムグループが一つしか作られず、効果がないのに行の取得元を記録する処理が発生します。害はありませんが、意味もありません。
- シーケンスマップ列を持つタブレット。現在の実装では、この場合は垂直コンパクションをスキップします(
_tablet->tablet_schema()->has_seq_map()をcompaction.cppで参照)。マージは自動的に行単位の処理に戻ります。 - コンパクション時の IO がすでに支配的な、ディスク IO がボトルネックのクラスター。グループごとに読み込みを繰り返すとボトルネックが悪化する可能性があります。グループを大きくする(
vertical_compaction_num_columns_per_groupを増やす)か、先に IO 性能の限界に対処します。 - ロード頻度が高すぎる問題を垂直コンパクションで解決しようとする場合。コンパクション中のメモリ負荷は、根本原因ではなく、処理の滞留を示していることがよくあります。ロード側の調整方法については、データコンパクションとグループコミットを参照してください。
パフォーマンスと数値
- メモリ:幅の広いテーブルでは、行単位のコンパクションの約 1/10。出典:Doris のコンパクション調整ドキュメント。
- スループット:同じ幅の広いテーブルのベンチマークで、処理全体が約 15% 高速。出典:上記と同じ。
- 利用可能なバージョン:Doris 1.2.2 以降。現行リリースではデフォルトで
true。
関連資料
- データコンパクション:垂直コンパクションと累積、ベース、時系列の各ポリシーとの関係。
- コンパクションの調整:垂直、セグメント、単一レプリカ、時系列:各コンパクション方式を運用時に調整するための設定。
- コンパクションの原理、種類、スケジューリング:次にコンパクションするタブレットを選ぶスコアリングとスケジューリングの仕組み。
- BE 設定リファレンス:各
vertical_compaction_*フラグのデフォルト値と単位。 - 3 分でわかるデータコンパクション(ブログ):垂直コンパクションを図とともに紹介した元の記事。
- Unique Key:垂直コンパクションが整合させる必要のある、rowset ごとの削除ビットマップを生成するテーブルモデル。
