ワークロードグループ
要約 Apache Doris のワークロードグループは、単一のクラスターを名前付きのグループに分け、グループごとに CPU の割り当て、メモリの上限、クエリの同時実行数、IO の使用量を設定します。負荷の高い ETL、ダッシュボード、アドホック分析を別々のグループに配置できます。あるグループのクエリが暴走しても、ほかのグループを巻き込まずに済みます。CPU の分離には Linux cgroups を使用し、メモリ、IO、同時実行数は BE プロセスが制御します。
Apache Doris でワークロードグループを使う理由
Apache Doris のワークロードグループを使うと、共有クラスター上で異なるワークロードが互いのリソースを奪い合うことを防げます。本番環境の Doris クラスターで実行されるワークロードは、ほとんどの場合、一種類ではありません。たとえば、午前 2 時に ETL パイプラインが前日のパーティションを書き換え、午前 9 時に財務チームが日次レポートを再実行し、業務時間中は経営層向けダッシュボードが同じ GROUP BY region を十五秒ごとに実行し、アナリストが SELECT * を実行する際に WHERE 句を付け忘れる、といった状況です。
リソース制御がなければ、これら四種類のワークロードは単一の共通プールを共有します。ETL ジョブは、ダッシュボードを処理するスレッドと同じスレッド上で実行されます。問題のあるアドホッククエリが BE のメモリを使い切り、レポートのクエリが強制終了されることもあります。同時実行数に制限がないため、ダッシュボードの更新が急増すると ETL の負荷に重なり、すべてのワークロードの性能が低下します。
ワークロードグループを使えば、ハードウェアを追加せずにこの問題に対処できます。ワークロードの種類ごとにグループを定義し、各グループに許可する上限を設定して、ユーザーを適切なグループに紐付けます。クラスターは同じ BE 群で稼働し続けますが、BE のスケジューラー、メモリトラッカー、cgroup コントローラーが、定義したグループに沿って処理能力を分配します。
Apache Doris のワークロードグループとは
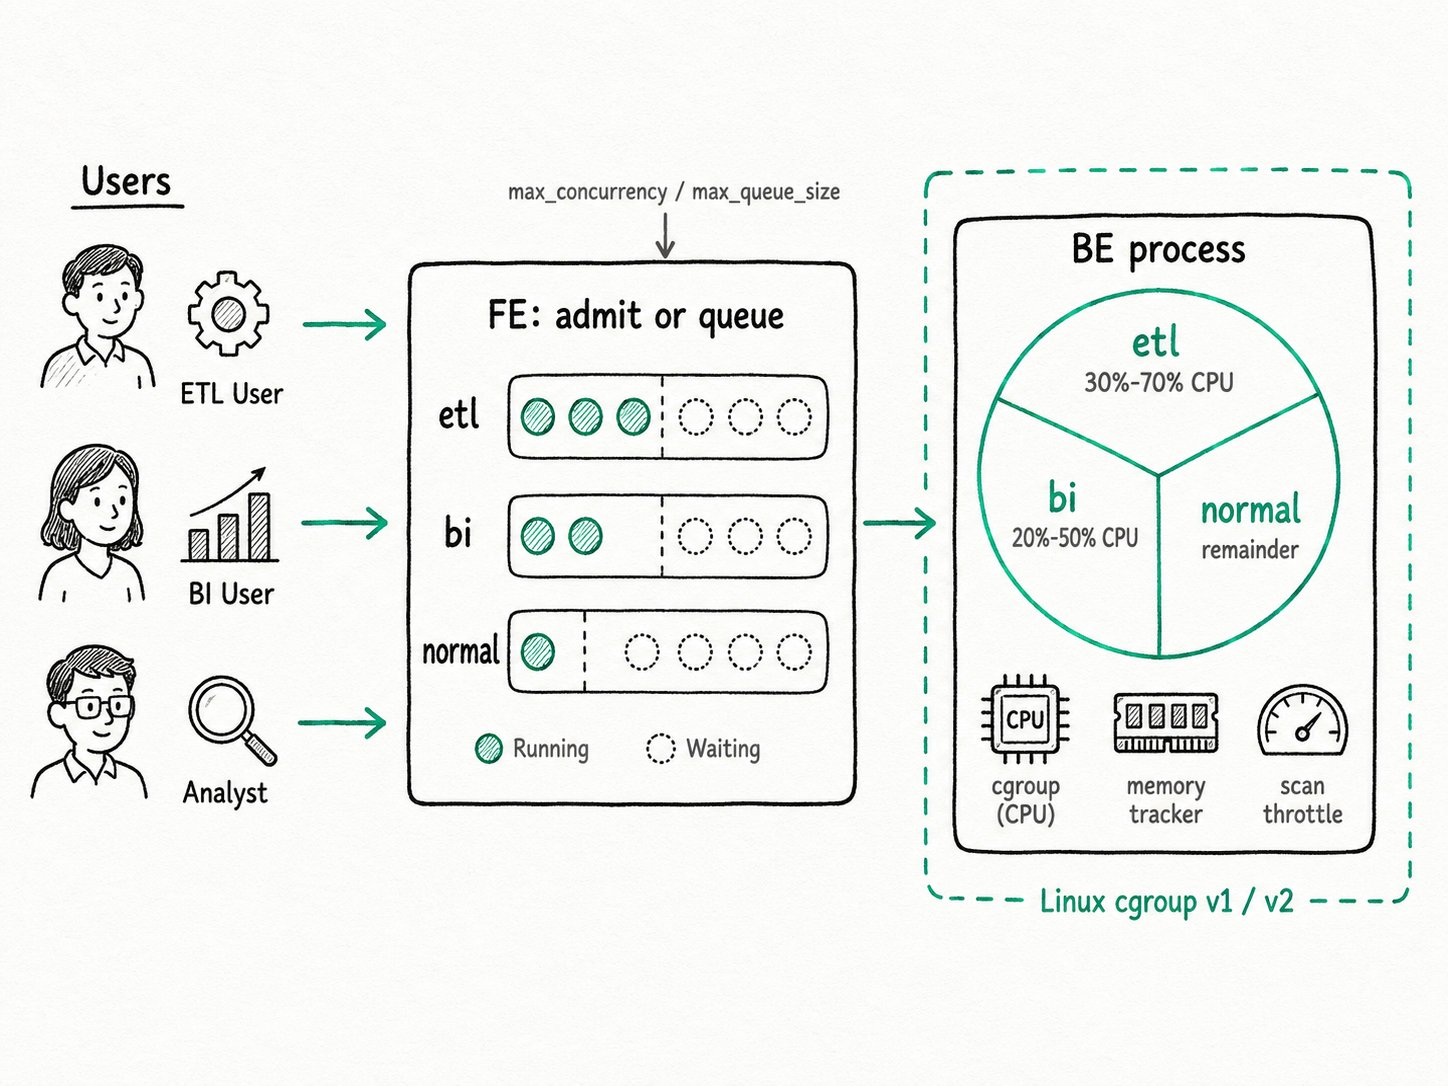
Apache Doris のワークロードグループは、プロセス内でリソースを分離する機能です。各 BE プロセスがすべてのグループを処理しますが、BE はスレッド、スキャンスロット、メモリがどのグループに属するかを把握します。CPU の分離では、BE のワーカースレッドをグループごとの cgroup に割り当てます。メモリの分離では、BE のメモリトラッカーでグループごとの使用量を追跡し、上限を超えた場合にディスクへの退避またはクエリのキャンセルを行います。同時実行数は FE で制御します。各グループにキューがあり、上限を超えたクエリは待機するか、すぐに失敗します。
主な用語
min_cpu_percent/max_cpu_percent:グループに確保される CPU 帯域幅(ソフトな下限)と、超えられない上限(ハードな上限)です。全グループのmin_cpu_percentの合計は 100% 未満にする必要があります。min_memory_percent/max_memory_percent:グループに保証される BE メモリの割合と、クエリがディスクへの退避または強制終了の対象となるまで使用できる割合です。max_concurrency/max_queue_size/queue_timeout:実行中クエリ数の上限、待機キューの長さの上限、キュー内のクエリが待機できる時間です。いずれもクラスター全体ではなく、FE ごとに適用されます。read_bytes_per_second/remote_read_bytes_per_second:グループごとの IO 制限です。ローカルテーブルにはデータディレクトリごと、外部ソースには BE ごとに適用されます。normalグループ:初回起動時に自動作成されるデフォルトグループです。ほかのグループに紐付けられていないセッションに使用されます。削除できません。
Apache Doris のワークロードグループの仕組み
Apache Doris のワークロードグループでは、FE が対象グループを決定してクエリを受け入れるかキューに入れ、その後 BE が CPU、メモリ、IO の制限を適用します。
- グループを決定する(FE)。 FE は次の優先順位でグループを選びます。明示的な
/*+ SET_VAR(workload_group='...') */ヒント、セッション変数workload_group、ユーザープロパティdefault_workload_group、最後にnormalです。FE は選ばれたグループに対する USAGE 権限を確認します。 - クエリを受け入れるかキューに入れる(FE)。 グループのキューは、この FE 上で当該グループのクエリが何件実行中かを確認します。
max_concurrency未満なら、クエリは実行枠を得て処理を続けます。上限を超えている場合は待機し、待機件数はmax_queue_size、待機時間はqueue_timeoutによって制限されます。キューが満杯なら、クエリはすぐに拒否されます。 - スレッドを cgroup に割り当てる(BE)。 各 BE は、グループごとに cgroup v2 では
/sys/fs/cgroup/doris/<wg_id>、v1 では/sys/fs/cgroup/cpu/doris/<wg_id>の下に cgroup を保持します。グループのフラグメントが実行されると、そのワーカーは該当する cgroup に参加します。カーネルの CFS スケジューラーが、min_cpu_percent(cpu.weight経由)とmax_cpu_percent(cpu.max経由)を適用します。 - グループごとのメモリを追跡する(BE)。 すべてのメモリ割り当てにグループ ID が付けられます。グループのトラッカーが
memory_low_watermarkを超えると、ディスクへの退避が可能なオペレーターは退避を開始します。memory_high_watermarkを超えると、BE はそのグループのクエリを一時停止し、使用量をしきい値未満に戻すため、最大のクエリをキャンセルする場合があります。 - スキャンを制限する(BE)。 ローカルおよびリモートのスキャンスレッドプールには、グループごとの上限(
scan_thread_num、max_remote_scan_thread_num)があります。また、read_bytes_per_secondはグループのスキャンが消費できるディスク IO を制限します。この設定により、インデックスを利用しないテーブル全体のスキャンが SSD の帯域を占有するのを防げます。
クイックスタート
-- One group for ETL, one for BI dashboards
CREATE WORKLOAD GROUP etl PROPERTIES (
  'min_cpu_percent'='30','max_cpu_percent'='70',
  'min_memory_percent'='30','max_memory_percent'='70',
  'max_concurrency'='10');

CREATE WORKLOAD GROUP bi PROPERTIES (
  'min_cpu_percent'='20','max_cpu_percent'='50',
  'min_memory_percent'='20','max_memory_percent'='50',
  'max_concurrency'='50','max_queue_size'='100','queue_timeout'='3000');

-- Bind users persistently
SET PROPERTY FOR 'etl_user' 'default_workload_group'='etl';
SET PROPERTY FOR 'bi_user'  'default_workload_group'='bi';

-- One-off override for a single query
SELECT /*+ SET_VAR(workload_group='bi') */ region, SUM(revenue)
FROM orders WHERE dt = CURRENT_DATE() GROUP BY region;
期待される結果
+------+-------------------+-------------------+-----------------+
| name | running_query_num | waiting_query_num | max_concurrency |
+------+-------------------+-------------------+-----------------+
| etl  | 4                 | 0                 | 10              |
| bi   | 47                | 12                | 50              |
+------+-------------------+-------------------+-----------------+
SHOW WORKLOAD GROUPS(または SELECT ... FROM information_schema.workload_groups)を実行すると、現在の件数を確認できます。bi で待機中の 12 件のクエリは、実行中の 47 件の後ろに並んでいます。BI がビジー状態でも、四件の ETL クエリには CPU の 30% が保証され、70% を超えることはできません。
Apache Doris のワークロードグループを使うべき場面
単一クラスターで複数の種類のワークロードを実行し、ハードウェアを追加せずに負荷がかかったときの動作を予測可能にしたい場合は、Apache Doris のワークロードグループを使用します。
適している場面
- ETL、定期レポート、ダッシュボード、アドホック分析が BE を共有する、複数種類のワークロードを持つクラスター。
- 完全な分離よりコストを重視するマルチテナント環境。単一のクラスターを複数のチームで使い、負荷がかかったときの動作を予測可能にできます。
- 問題を起こしやすい既知のワークロードの制限。チームで頻繁に実行される
SELECT *、ときどき大量の処理を発生させる Kafka のバックフィルなど、過大な負荷を抑えたい場合に役立ちます。 - ストレージとコンピュートを分離したモードでは、コンピュートグループと組み合わせます。コンピュートグループは別の BE 群を提供し、ワークロードグループはその内部のリソースを分配します。
適していない場面
- 個別の SLA、個別のセキュリティドメイン、課金対象のテナントなど、物理的な分離が必要な場合。同じプロセス内のすべてのグループは、BE のクラッシュやカーネルの OOM の影響を受けます。代わりにリソースグループまたは専用のコンピュートグループを使用してください。
- クラスター全体の同時実行数を単一の値で制限したい場合。FE が三台ある場合、
max_concurrency=10ではクラスター全体で最大 30 件のクエリを同時実行できます。FE ごとの上限をそれに応じて設定するか、ユーザーを一台の FE に固定するロードバランサーをクラスターの前段に配置してください。 - 特権のない Docker または Kubernetes コンテナーで BE を実行する場合。CPU 制限を適用するには、BE プロセスにホストの cgroup ツリーに対する読み書き権限が必要です。特権モード(または Doris Operator)がないと、CPU の上限は通知なしに適用されません。メモリと同時実行数の制御は引き続き機能しますが、重要な制御手段を失います。
- メモリのオーバーコミットを有効にし、
max_memory_percentの合計を 100% にする場合。ソフトリミットを超えた際の処理に必要な余裕がなくなり、BE が全体の上限に達すると、グループ内で最大のクエリをキャンセルします。10~20% の余裕を残してください。 - ワークロードの負荷変動が大きく、実行時間も短いため、Snowflake のような自動スケーリング型ウェアハウスのほうが固定割り当てより安価になる場合。ワークロードグループは固定のリソースプールを分割する機能であり、新しいコンピュートリソースをプロビジョニングしません。
関連資料
- ワークロードグループのリファレンス:プロパティの完全な一覧、cgroup の設定手順、4.0 でのプロパティ名変更に伴う移行上の注意事項。
- ワークロード管理の概要:ワークロードグループ、リソースグループ、コンピュートグループの関係と選択基準。
- 同時実行制御とキューイング:FE ごとのキューの動作、管理者向けの
bypass_workload_groupによる上書き、複数 FE 環境でのキューイングの注意点。 - ディスクへの退避:グループが
memory_low_watermarkに達したときの動作と、スロットベースのメモリポリシー。 information_schema.workload_groups:上の例でも使用する、グループの現在の状態を確認できるシステムテーブル。- リソースグループ:より強い SLA 上の分離境界を実現する、BE ノード単位の物理的な分離。
- コンピュートグループ:データを複製せずに分離を強化する、コンピュートとストレージを分離した構成での仕組み。
- Apache Doris におけるマルチテナントのワークロード分離:16 コアの BE における CPU のソフトリミットとハードリミットの内部ベンチマークを含む、元の設計ブログ。
- MPP アーキテクチャ:ワークロードグループがクエリごとのフラグメントインスタンス数を制限する実行モデル。
