BloomFilter インデックス
BloomFilter インデックスは、BloomFilter アルゴリズムに基づくスキップインデックスです。クエリで指定した値がデータブロックに存在する可能性があるかをすばやく判定し、等価条件に一致しないデータブロックをスキップすることで、I/O の負荷を軽減し、クエリを高速化します。
BloomFilter アルゴリズムの原理
BloomFilter は、複数のハッシュ関数によるマッピングを利用する高速な検索アルゴリズムで、1970 年に Bloom によって提案されました。主な特性は次のとおりです。
- 高い空間効率: 長いビット配列と複数のハッシュ関数で集合を表現できます。
- 判定結果: ある要素が集合に含まれるかどうかの判定では、BloomFilter は次のいずれかの結果のみを返します。
- 存在する可能性がある(ハッシュの衝突により、誤検知の可能性があります)
- 存在しないことが確実(この結果は信頼できます)
処理の流れは次のとおりです。
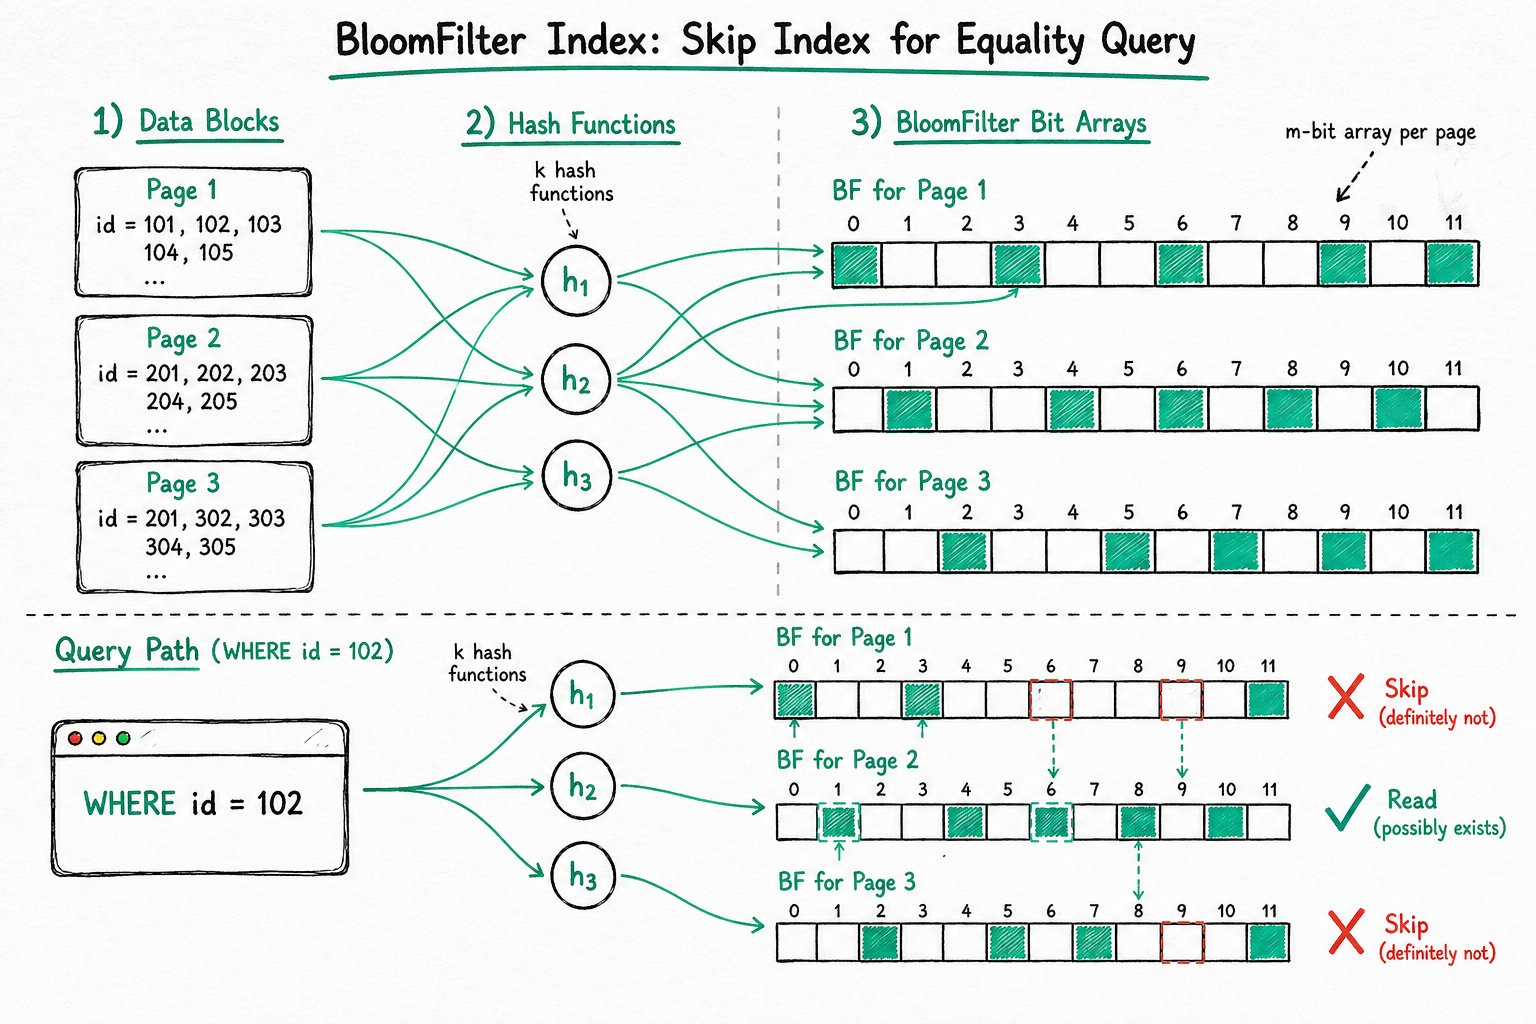
- ビット配列のすべてのビットをゼロに初期化します。
- 要素を挿入するときは、複数のハッシュ関数で要素をハッシュして複数の位置を計算し、ビット配列の対応する位置を 1 に設定します。
- 要素を検索するときは、同じ方法で位置を計算します。対応する位置のいずれかが 0 なら、その要素は存在しません。すべてが 1 なら、存在する可能性があります。
次の図は、m=18、k=3 の BloomFilter の例です(m はビット配列のサイズ、k はハッシュ関数の数)。集合内の三つの要素 x、y、z は、それぞれ 3 つの異なるハッシュ関数によってビット配列にマッピングされます。要素 w を検索すると、対応するビットの少なくとも一つが 0 であるため、w は集合に含まれないことが確実に分かります。
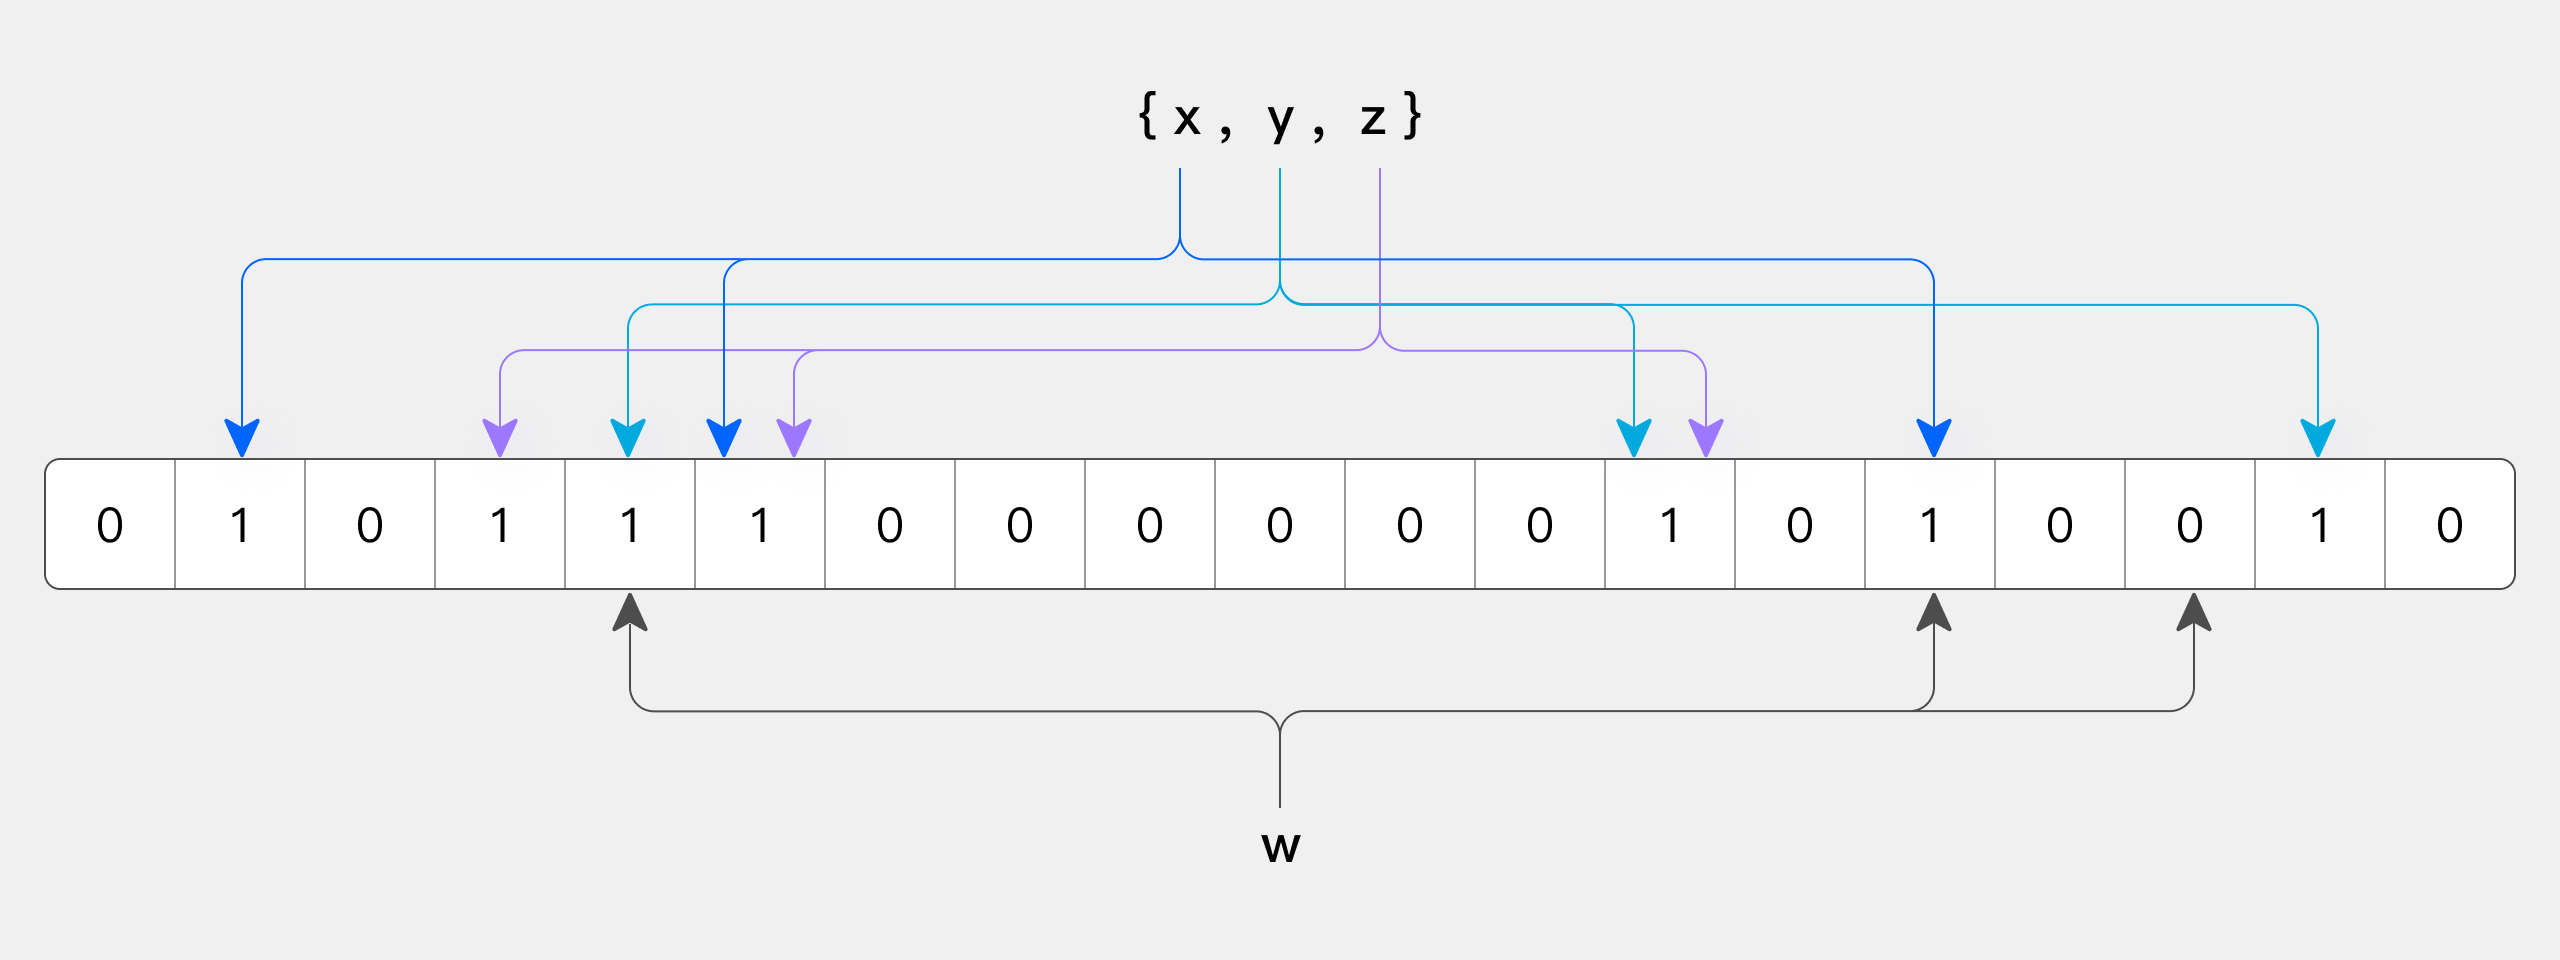
ハッシュの衝突が起こり得るため、BloomFilter には「誤検知」があります。そのため、BloomFilter に基づくインデックスは、条件に一致しないことが確実なデータだけをスキップできます。条件に一致するデータを正確に特定することはできません。
Doris での実装
Doris の BloomFilter インデックスはデータブロック(ページ)単位で構築され、各データブロックに一つの BloomFilter が割り当てられます。
- 書き込み時: データブロック内の各値がハッシュされ、対応するデータブロックの BloomFilter に格納されます。
- クエリ時: 等価条件の値を使って、各データブロックの BloomFilter にその値が含まれるかを確認します。含まれない場合はそのデータブロックをスキップし、I/O を減らしてクエリを高速化します。
ユースケース
BloomFilter インデックスは等価条件を使うクエリ(= と IN を含む)を高速化でき、userid のような一意の ID カラムなど、カーディナリティの高いカラムに特に適しています。
適用できる場面
| 場面 | 説明 |
|---|---|
| 等価条件を使うクエリ | WHERE column = value |
| IN を使うクエリ | WHERE column IN (v1, v2, ...) |
| カーディナリティの高いカラム | ユーザー ID や注文番号など、異なる値が多く、同じ値の出現頻度が低いカラム |
制限事項
- クエリの種類:
=とINを使うクエリにのみ有効です。!=、NOT IN、>、<などを使うクエリには効果がありません。 - データ型:
Tinyint、Float、Double型のカラムには BloomFilter インデックスを構築できません。 - カーディナリティ: カーディナリティの低いカラムでは高速化の効果が限られます。たとえば「性別」カラムには値が二種類しかないため、ほぼすべてのデータブロックに両方の値が含まれます。BloomFilter ではデータを絞り込めず、インデックスを設ける意味がありません。
- バージョン: バージョン 4.1.2 以降、
CHAR型のカラムに対する BloomFilter インデックスは効果がありません。
インデックスの管理
テーブル作成時に BloomFilter インデックスを作成する
歴史的な経緯から、BloomFilter インデックスの定義構文は、転置インデックスなどで使う一般的な INDEX 構文とは異なります。BloomFilter インデックスはテーブルの PROPERTIES 属性である bloom_filter_columns で指定し、一つ以上のカラムを同時に指定できます。
PROPERTIES (
    "bloom_filter_columns" = "column_name1,column_name2"
);
BloomFilter インデックスを確認する
SHOW CREATE TABLE を使って、テーブルに作成済みの BloomFilter インデックスを確認します。
SHOW CREATE TABLE table_name;
BloomFilter インデックスを変更する
ALTER TABLE でテーブルの bloom_filter_columns プロパティを変更し、BloomFilter インデックスの対象カラムを追加または削除します。
column_name3 に BloomFilter インデックスを追加する:
ALTER TABLE table_name SET ("bloom_filter_columns" = "column_name1,column_name2,column_name3");
column_name1 の BloomFilter インデックスを削除する:
ALTER TABLE table_name SET ("bloom_filter_columns" = "column_name2,column_name3");
インデックスの使用
BloomFilter インデックスは、WHERE 条件の等価条件を使うクエリを高速化します。条件を満たすと自動的に適用され、特別な構文は必要ありません。
Query Profile でインデックスの効果を分析する
Query Profile の次のメトリクスを使って、BloomFilter インデックスによる高速化の効果を分析できます。
| メトリクス | 意味 |
|---|---|
RowsBloomFilterFiltered | BloomFilter インデックスによって除外された行数です。ほかの Rows メトリクスと比較すると、絞り込みの効果を分析できます。 |
BlockConditionsFilteredBloomFilterTime | BloomFilter インデックスによる絞り込みにかかった時間です。 |
使用例
次の例は、Doris で BloomFilter インデックスを作成する方法を示します。
CREATE TABLE 文の PROPERTIES で、"bloom_filter_columns" = "k1,k2,k3" の形式を使って BloomFilter インデックスを構築するカラム名を指定します。次の例では、saler_id カラムと category_id カラムに BloomFilter インデックスを作成します。
CREATE TABLE IF NOT EXISTS sale_detail_bloom (
    sale_date date NOT NULL COMMENT "Sale time",
    customer_id int NOT NULL COMMENT "Customer ID",
    saler_id int NOT NULL COMMENT "Salesperson",
    sku_id int NOT NULL COMMENT "Product ID",
    category_id int NOT NULL COMMENT "Product category",
    sale_count int NOT NULL COMMENT "Sales quantity",
    sale_price DECIMAL(12,2) NOT NULL COMMENT "Unit price",
    sale_amt DECIMAL(20,2) COMMENT "Total sales amount"
)
DUPLICATE KEY(sale_date, customer_id, saler_id, sku_id, category_id)
DISTRIBUTED BY HASH(saler_id) BUCKETS 10
PROPERTIES (
    "replication_num" = "1",
    "bloom_filter_columns" = "saler_id,category_id"
);