大規模データのパフォーマンスベンチマーク
このドキュメントでは、中規模から大規模、および億件規模のデータセットを対象に、Doris ANN Index の実環境でのロード性能とクエリ性能を示します。データ規模ごとのクエリ性能を評価し、単一ノード構成から分散構成へ円滑に拡張する方法を理解するのに役立ちます。
クイックナビゲーション
このドキュメントを読むと、次の疑問に答えられます。
- 数千万件のベクトルを単一の BE ノードでオンライン検索できるか。また、どの程度の QPS とレイテンシーを期待できるか。
- 数億件のベクトルを扱う際、単一ノードのメモリが不足した場合に、複数 BE の構成でベクトルクエリを継続して提供するにはどうすればよいか。
- ベクトルの次元数(768/1536)や距離指標(
inner_product/l2_distance)によって性能はどう変わるか。 - これらのテスト結果をどう再現するか。
テスト環境とデータセット
デプロイ構成
| デプロイ方式 | BE ノード数 | ノードごとのスペック | 対象データ規模 |
|---|---|---|---|
| 単一ノード | 1 | 16C64GB | 数千万件 |
| 分散構成 | 3 | 16C64GB | 数億件 |
FE と BE は別々にデプロイしています。すべてのテストで VectorDBBench ツールを使用しています。
データセットの概要
| データセット | データ量 | ベクトルの次元数 | 距離指標 | デプロイ構成 |
|---|---|---|---|---|
| Performance768D10M | 10M | 768 | inner_product | 単一ノード |
| Performance1536D5M | 5M | 1536 | inner_product | 単一ノード |
| Performance768D100M | 100M | 768 | l2_distance | 分散構成 |
単一ノードのベンチマーク(16C64GB)
単一ノードの結果は、中規模から大規模のデータセットにおける ANN クエリ性能の基準になります。
ロード性能
両データセットのロード指標は次のとおりです。
| 項目 | Performance768D10M | Performance1536D5M |
|---|---|---|
| ベクトルの次元数 | 768 | 1536 |
metric_type | inner_product | inner_product |
| データ量 | 10M 行 | 5M 行 |
| ロード時のバッチパラメータ | NUM_PER_BATCH=500000--stream-load-rows-per-batch 500000 | NUM_PER_BATCH=250000--stream-load-rows-per-batch 250000 |
| ロード時間 | 76m41s | 41m |
show data all | 56.498 GB (25.354 GB + 31.145 GB) | 55.223 GB (25.346 GB + 29.878 GB) |
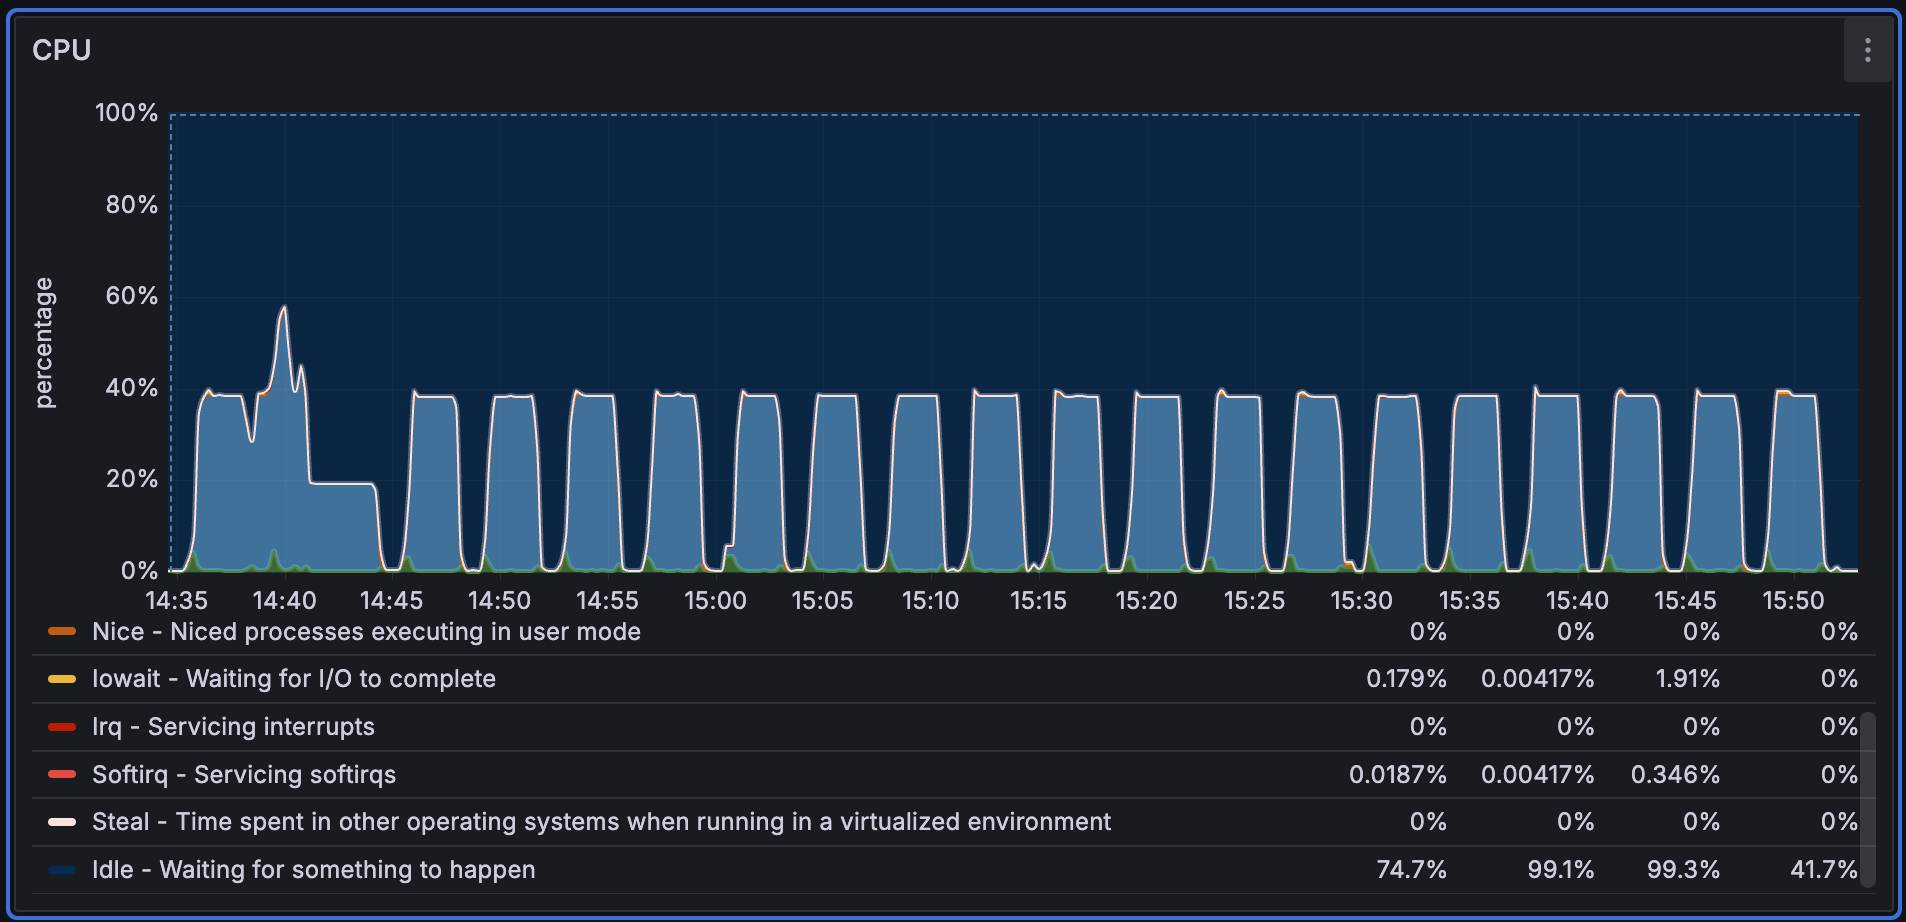
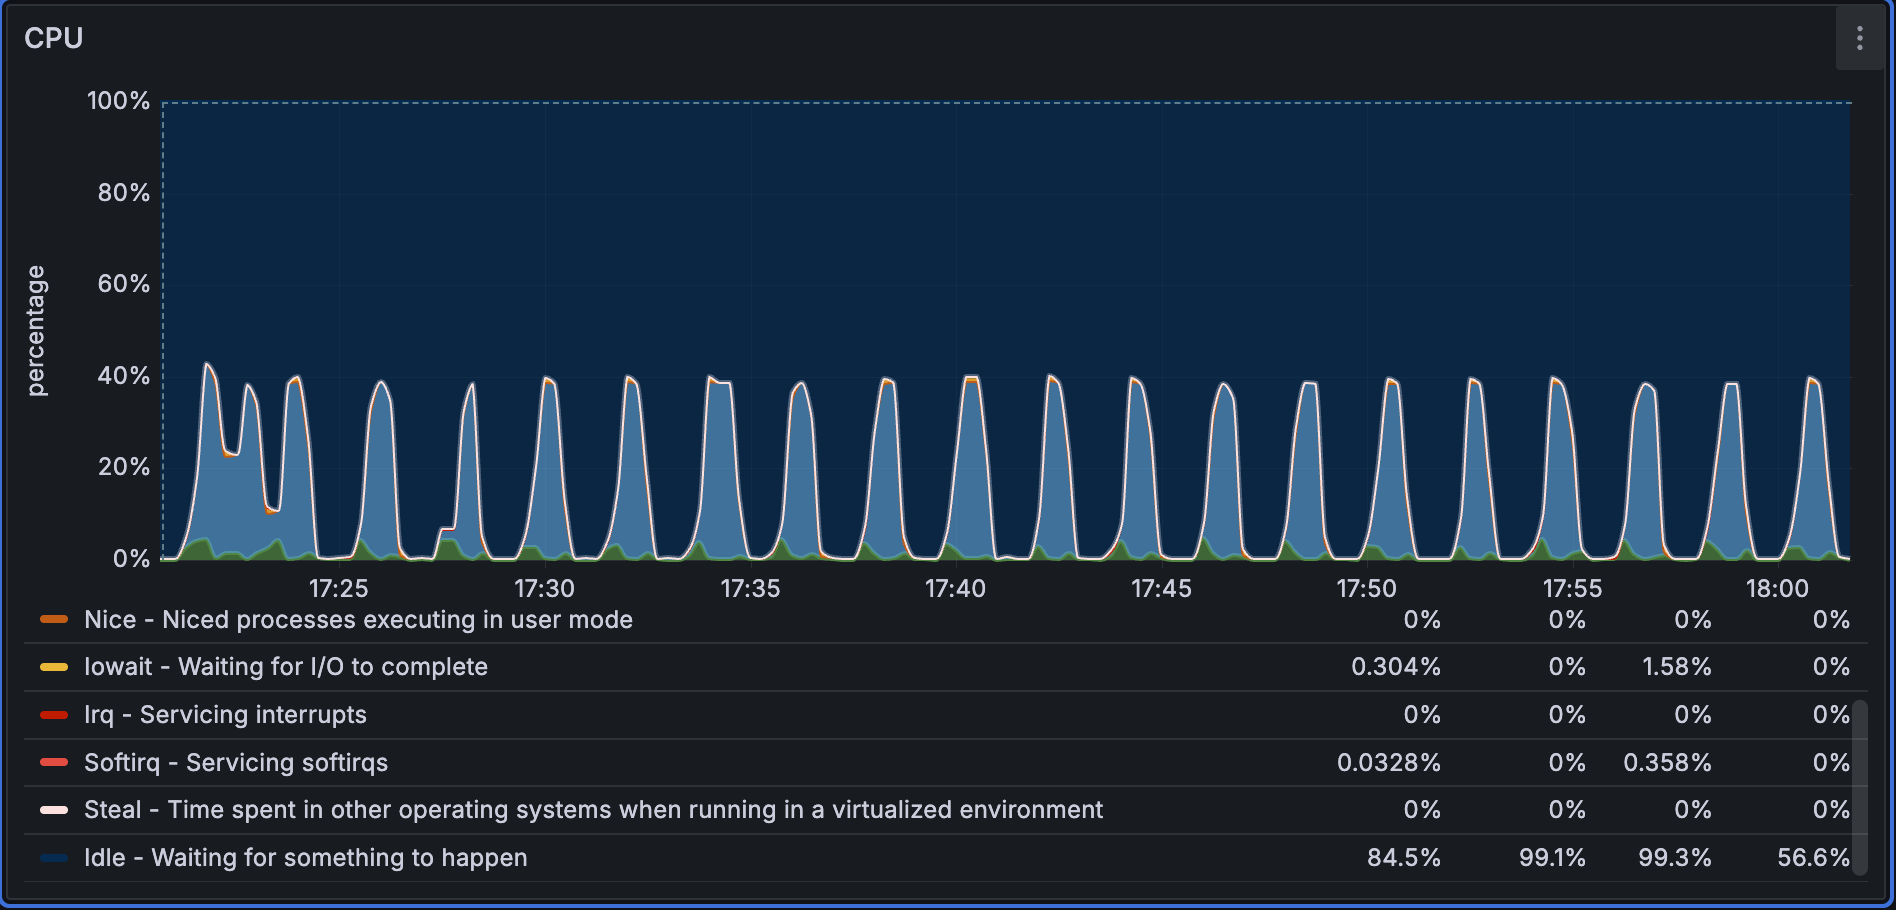
CPU 使用率:
-
Performance768D10M のロード中、CPU 使用率は全体として比較的安定していました。
-
Performance1536D5M はデータ量とバッチサイズが小さいため、ロード中の CPU 使用率はより頻繁に変動しました。
クエリ性能
高い再現率を維持しながら、単一ノード構成で数百 QPS に達し、クエリのレイテンシーを低く抑えられます。
主要指標
| データセット | BestQPS | Recall@100 |
|---|---|---|
| Performance768D10M | 481.9356 | 0.9207 |
| Performance1536D5M | 414.7342 | 0.9677 |
Performance768D10M の詳細(inner_product、10M 行)
| 同時実行数 | QPS | P95 レイテンシー | P99 レイテンシー | 平均レイテンシー |
|---|---|---|---|---|
| 10 | 116.2000 | 0.0932 | 0.0933 | 0.0861 |
| 40 | 455.9485 | 0.1102 | 0.1225 | 0.0877 |
| 80 | 481.9356 | 0.2331 | 0.2674 | 0.1658 |
Performance1536D5M の詳細(inner_product、5M 行)
| 同時実行数 | QPS | P95 レイテンシー | P99 レイテンシー | 平均レイテンシー |
|---|---|---|---|---|
| 10 | 144.3221 | 0.0764 | 0.0800 | 0.0693 |
| 40 | 401.9732 | 0.1271 | 0.1404 | 0.0994 |
| 80 | 414.7342 | 0.2772 | 0.3222 | 0.1925 |
CPU 使用率の監視
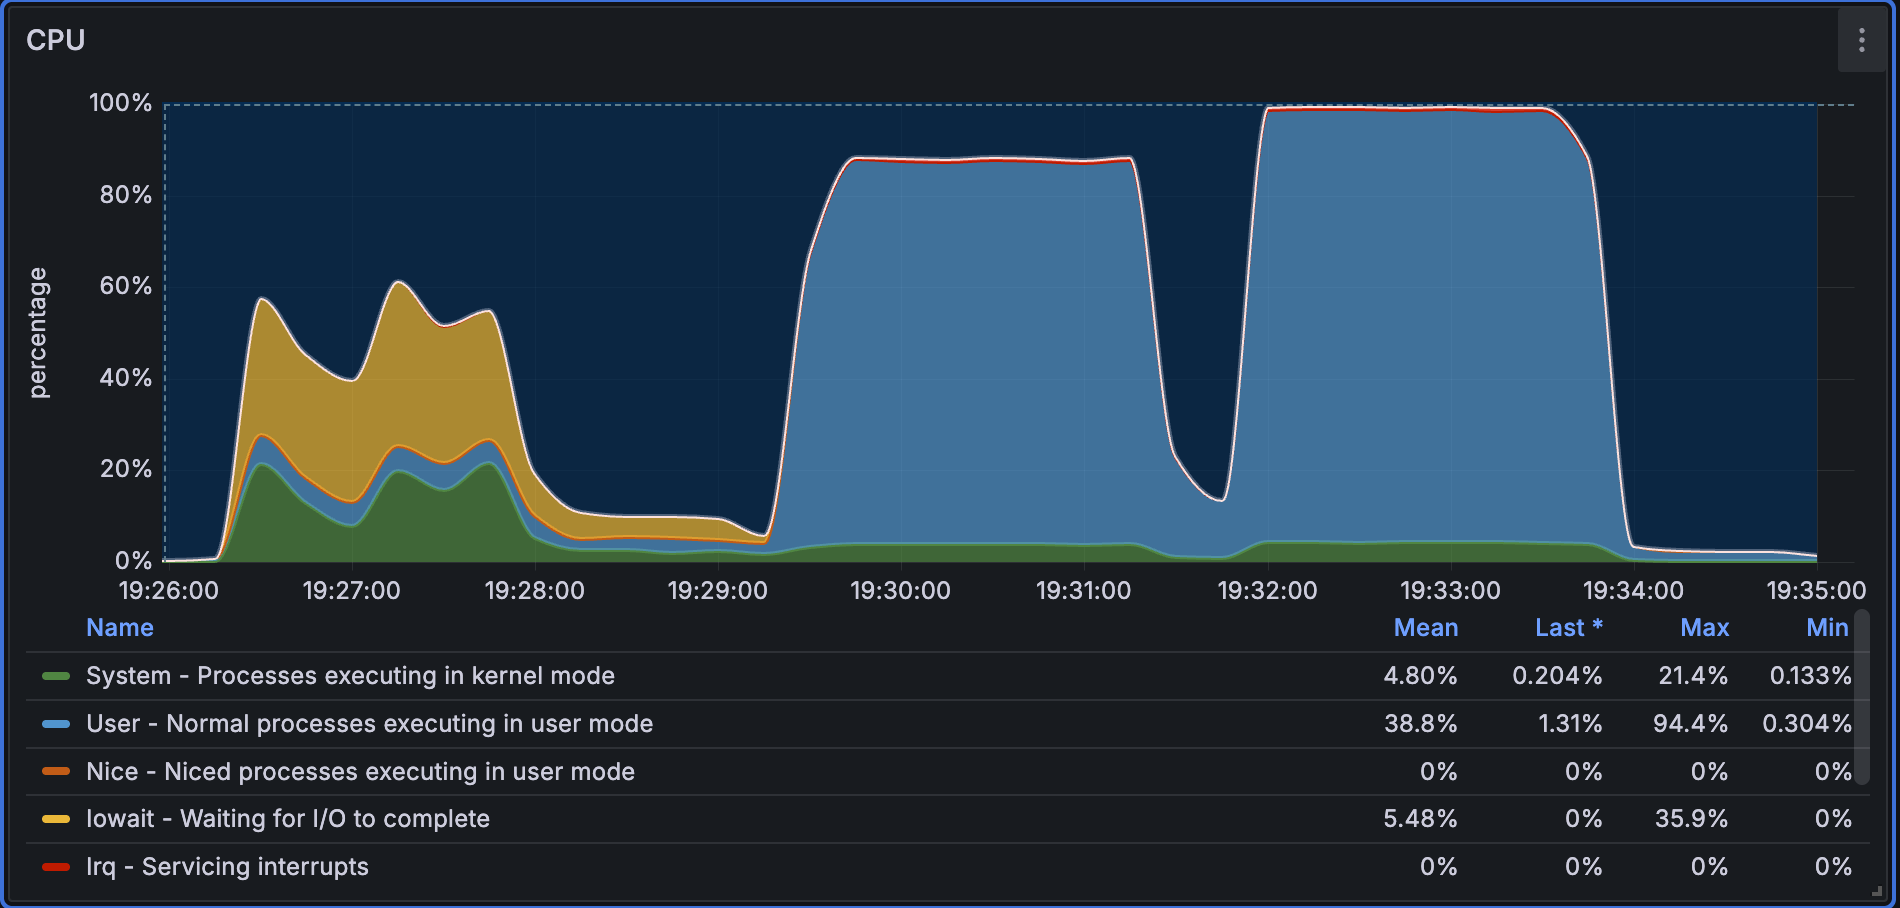
コールドクエリの段階ではインデックスをメモリに読み込む必要があるため、CPU 使用率は比較的低く、システムは主に I/O を待機します。ホットクエリの段階に入ると、CPU 使用率は大幅に上昇し、100% に近づきます。
分散構成のベンチマーク(3 x 16C64GB)
データ規模が単一の 16C64GB ノードで無理なく扱えるメモリ容量を超えた場合、複数 BE の構成によって水平に拡張できます。このセクションでは、Performance768D100M データセット(100M 行、768 次元)を使用し、100M 件規模でも Doris がオンラインでベクトルクエリを提供できることを示します。
このテストは、小規模データを使った単一ノードのテストと、数値を一対一で直接比較するためのものではありません。データ量の増加に伴う性能の変化を確認するのに適しています。
ロードとインデックスの構築
ノードごとのメモリ上限が 64GB のため、このテストではベクトルの量子化圧縮を使用してメモリ使用量を削減します。
| 項目 | 値 |
|---|---|
| データセット | Performance768D100M |
| データ量 | 100M 行 |
| ベクトルの次元数 | 768 |
| バッチパラメータ | NUM_PER_BATCH=500000--stream-load-rows-per-batch 500000 |
| インデックスパラメータ | "dim"="768", "index_type"="hnsw", "metric_type"="l2_distance", "pq_m"="384", "pq_nbits"="8", "quantizer"="pq" |
| インデックスの構築時間 | 4h5min |
show data all | 198.809 GB (137.259 GB + 61.550 GB) |
インデックス構築後のデータ分布:
- バケットは合計 3 個
- 各バケットには 34 個の rowset があり、各 rowset は約 1.99 GB
- 各 rowset には 6 個の segment が含まれる
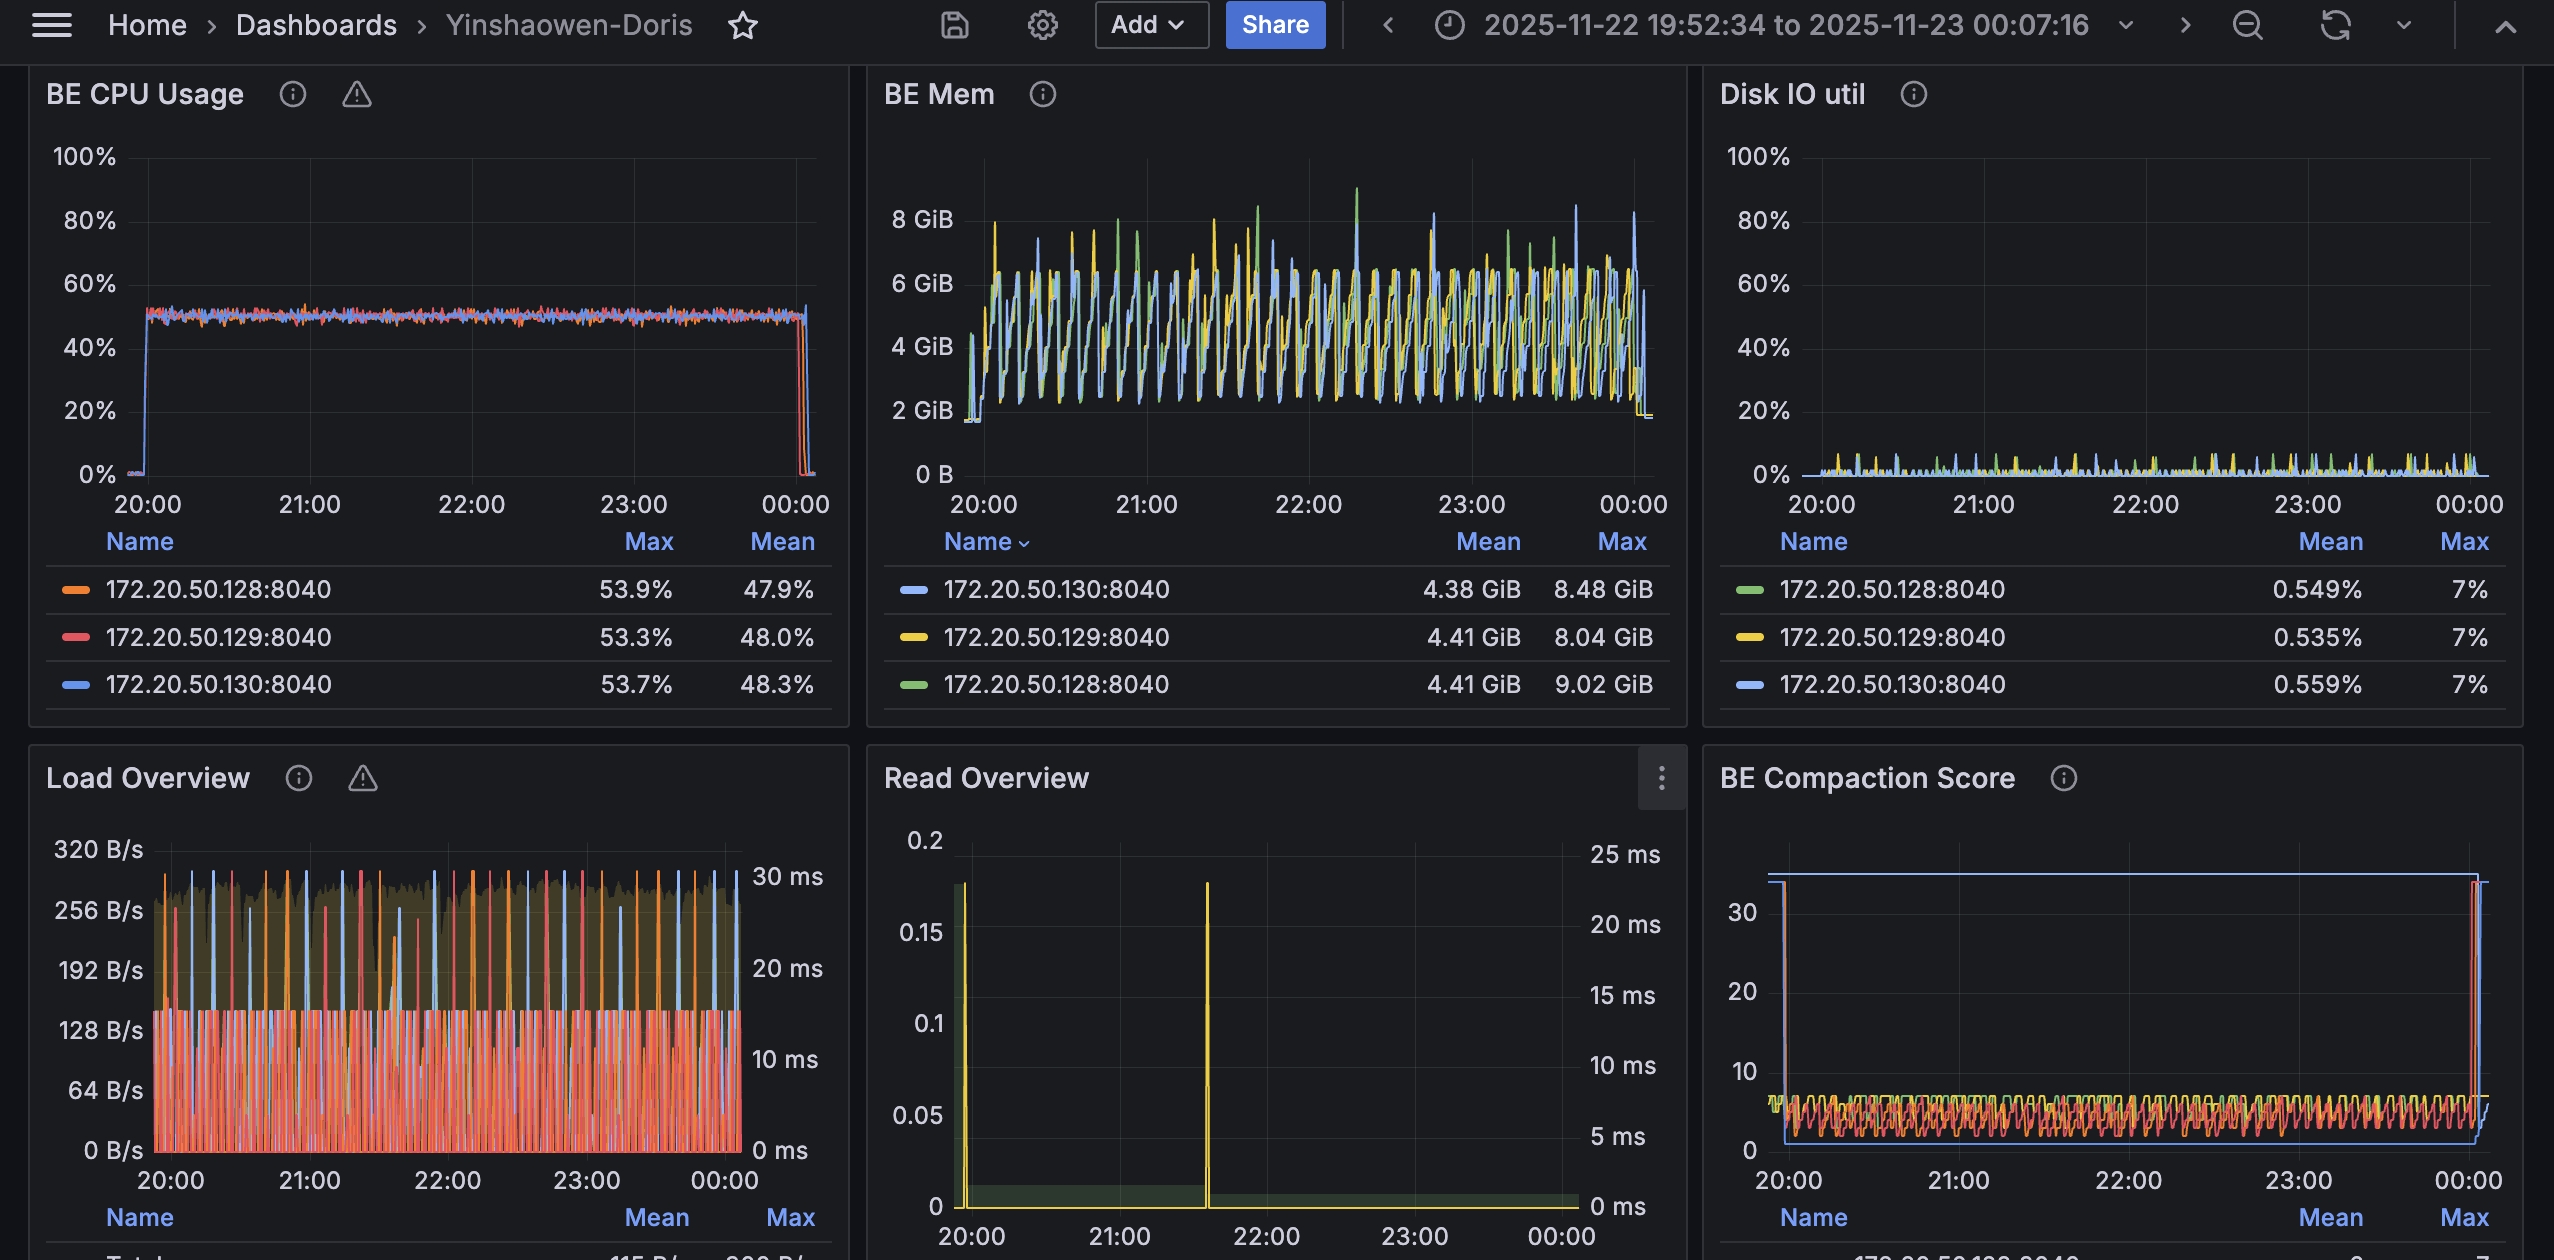
CPU 使用率: インデックス構築中、CPU 使用率は全体として約 50% で安定していました。CPU が長時間上限に達することはなく、リソースには余裕がありました。
クエリ性能
主要指標
| 指標 | 値 |
|---|---|
| BestQPS | 77.6247 |
| Recall@100 | 0.9294 |
詳細(l2_distance、100M 行)
| 同時実行数 | QPS | P95 レイテンシー | P99 レイテンシー | 平均レイテンシー |
|---|---|---|---|---|
| 10 | 46.5836 | 0.2628 | 0.2791 | 0.2145 |
| 20 | 75.3579 | 0.3251 | 0.3541 | 0.2651 |
| 30 | 77.6247 | 0.5222 | 0.5766 | 0.3860 |
| 40 | 76.6313 | 0.7089 | 0.7854 | 0.5212 |
CPU 使用率の監視
クエリの実行中は各ノードの CPU 使用率が高い水準を維持しており、クエリのワークロードが分散計算リソースを十分に活用していることがわかります。
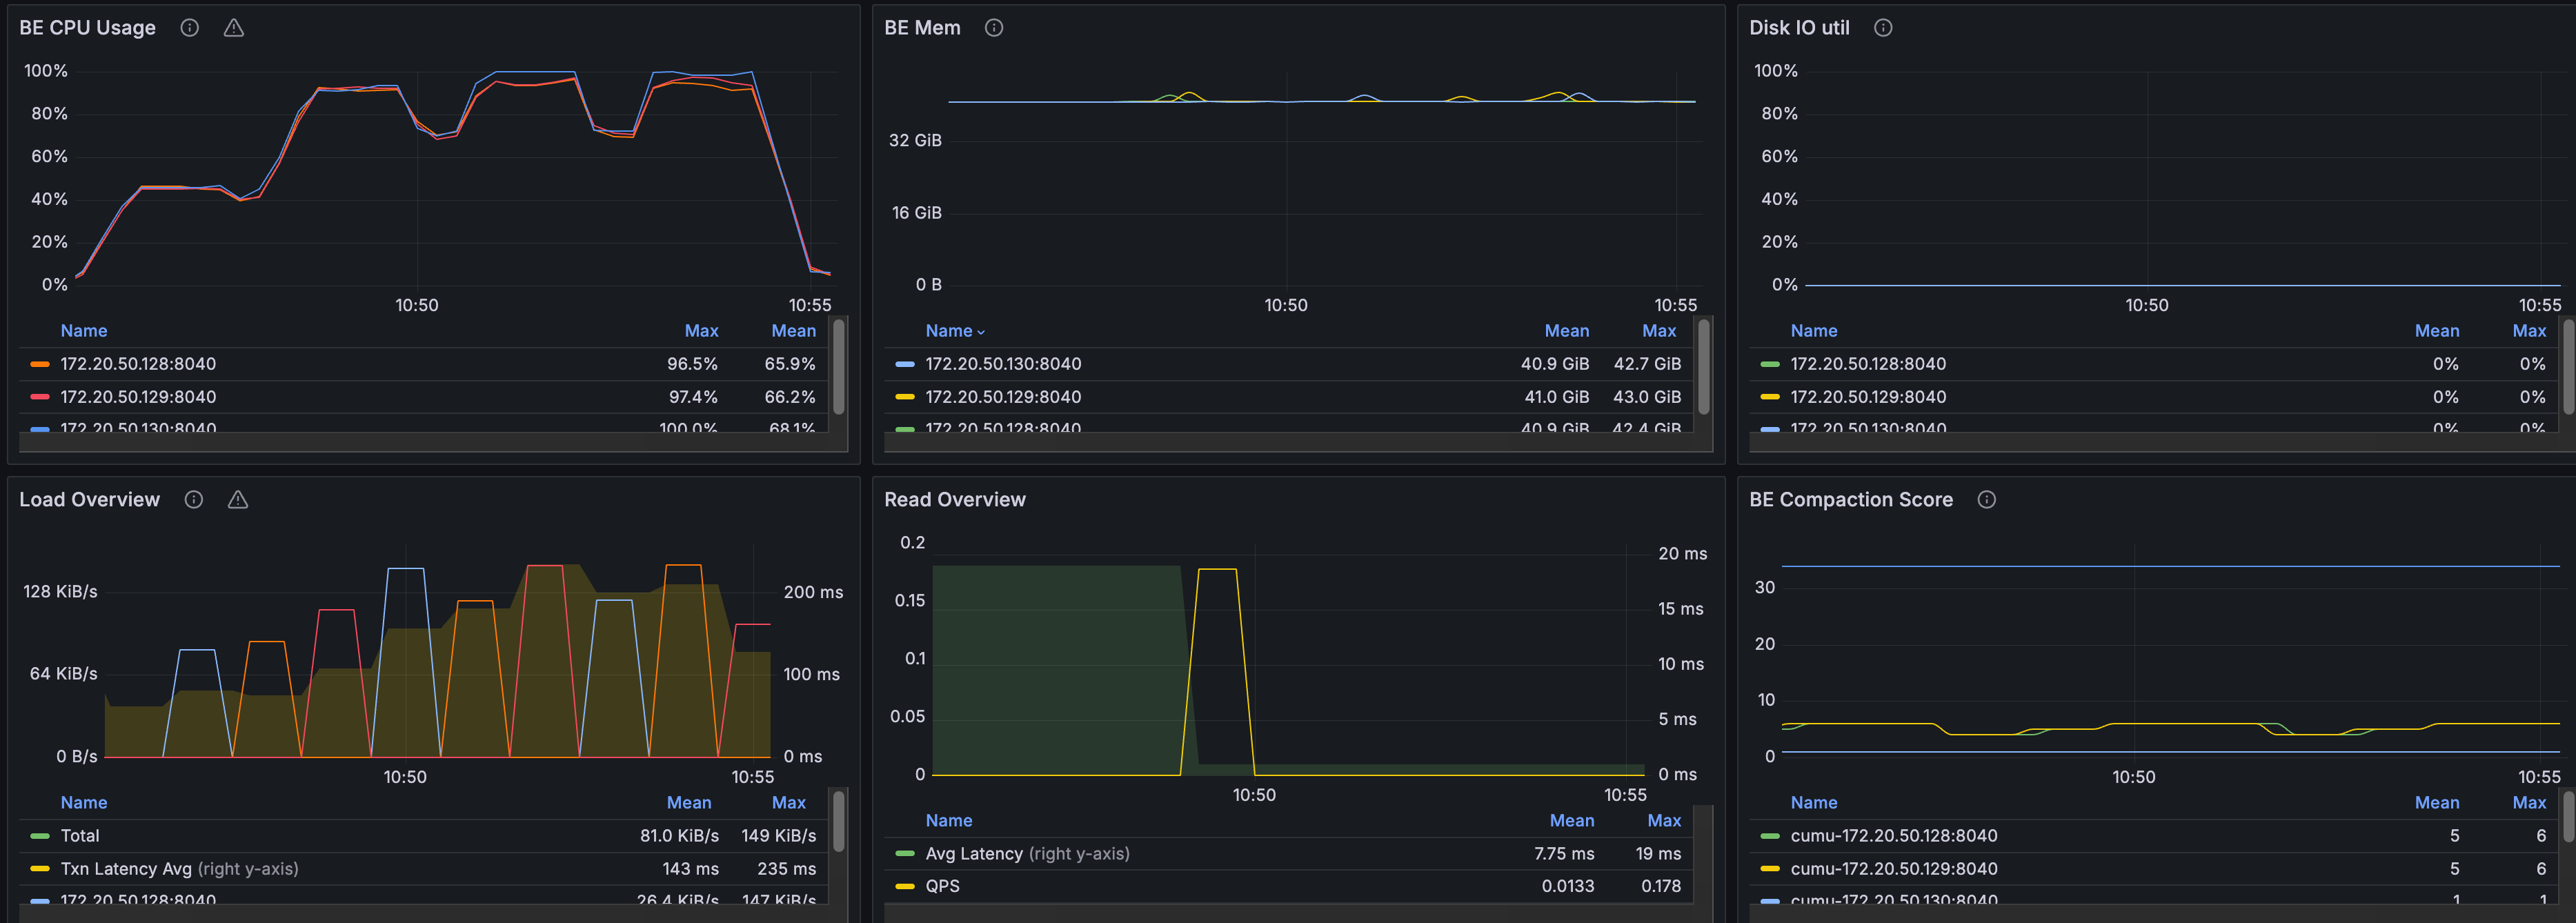
主な結論
- 単一ノードで数千万件: 数千万件規模のベクトルデータに対して、Doris の単一ノード構成は高い再現率(>=0.92)を維持しながら、ANN クエリで数百 QPS を実現できます。
- 分散構成で数億件: 100M 件のベクトルデータセットでは、複数 BE の構成とベクトルの量子化圧縮を組み合わせることで、オンラインでのベクトルクエリを引き続き提供できます(BestQPS は約 77、Recall@100 は約 0.93)。
- 水平スケーラビリティ: データ規模が単一ノードのメモリ容量を超えた場合、分散構成はオンライン検索を継続するための有効な手段です。
テスト結果を読む際の注意事項
結果を確認する際は、次の点に注意してください。
- 距離指標の違い: 単一ノードのテストでは
inner_product、分散構成のテストではl2_distanceを使用しています。絶対値を並べて直接比較することは推奨しません。 - データ規模とインデックスパラメータの違い: テストグループ間でデータ規模やインデックスパラメータ(量子化の有無など)が異なります。結果は、データ量の増加に伴う性能の変化を確認するのに適しています。
- コールドクエリの補正: 単一ノードの
Performance768D10Mテストでは、同時実行数 10 の結果からコールドクエリの影響を除いて補正しています。
再現方法
テストには VectorDBBench ツールを使用しています。
単一ノードでの再現
# Performance768D10M
export NUM_PER_BATCH=500000
vectordbbench doris ... --case-type Performance768D10M --stream-load-rows-per-batch 500000

# Performance1536D5M
export NUM_PER_BATCH=250000
vectordbbench doris ... --case-type Performance1536D5M --stream-load-rows-per-batch 250000
分散 3BE 構成での再現
export NUM_PER_BATCH=500000
vectordbbench doris ... --case-type Performance768D100M --stream-load-rows-per-batch 500000
よくある質問
Q1: 単一の 16C64GB ノードで保持できるベクトルの最大数は?
ベクトルの次元数、量子化の有無、インデックスパラメータによって異なります。このドキュメントでは、768 次元で 10M 行(約 56 GB)のデータが単一の 16C64GB ノードで安定して動作しています。データ量がさらに増える場合や次元数が高い場合は、ベクトルの量子化を有効にするか、複数 BE の分散構成を使用してください。
Q2: 分散構成のテストの QPS が単一ノードのテストより低いのはなぜですか?
両テストグループでは、距離指標、データ規模、インデックスパラメータが異なります(分散構成のテストでは PQ 量子化を有効にしています)。そのため、絶対値を直接比較することはできません。分散構成のテストは、QPS の最大化ではなく、大規模データにおける拡張性の検証を目的としています。
Q3: 100M 件のデータセットで量子化が必要なのはなぜですか?
ノードごとのメモリ上限は 64GB であり、100M 件の 768 次元ベクトルは、生データだけですでにこの容量を超えます。PQ 量子化(pq_m=384、pq_nbits=8)によりメモリ使用量を大幅に削減でき、大規模なオンライン検索が可能になります。
Q4: ロード時間にはインデックスの構築時間が含まれますか?
単一ノードのテストでは、「ロード時間」は書き込み全体にかかった時間です。インデックスは書き込み中、またはバックグラウンドの compaction 段階で構築されます。分散構成のテストでは、大規模なケースでインデックス構築のコストを評価できるよう、build index time を別に記載しています。