ベクトル量子化アルゴリズムの比較と選択
このドキュメントでは、一般的なベクトル量子化アルゴリズムを理論と実装の両面から紹介し、Apache Doris の ANN ユースケースに基づく選択指針を示します。Apache Doris は現在、最適化された Faiss を ANN ベクトルインデックスの構築と検索の中核に使用しているため、以下の SQ/PQ の仕組みの説明は、実際の Doris の動作に直接対応します。
クイックナビゲーション
知りたい内容に応じて、次のセクションを参照してください。
| 解決したいこと | 参照先 |
|---|---|
| 量子化が必要な理由を知りたい | ベクトル量子化が必要な理由 |
| 量子化方式をすぐに選びたい | Doris での選択指針 |
| SQ8/SQ4 の仕組みを知りたい | スカラー量子化(SQ) |
| PQ の原理と利点を知りたい | 直積量子化(PQ) |
| 公平なベンチマーク比較を行いたい | ベンチマーク時の考慮事項 |
| よくある質問を確認したい | FAQ |
各方式を一文で説明
- ベクトル量子化:float32 などの高精度ベクトルを低精度の表現に符号化し、許容できる範囲で再現率を犠牲にする代わりに、メモリ使用量を減らして検索を高速化します。
- SQ(スカラー量子化):各次元の精度を個別に下げます。
- PQ(直積量子化):ベクトルを複数の部分ベクトルに分割し、各部分空間でクラスタリングに基づく符号化を行います。
ベクトル量子化が必要な理由
ANN の用途、特に HNSW では、インデックスがメモリ容量によって制約されることがよくあります。量子化の基本的な考え方は、float32 などの高精度ベクトルを低精度の表現に符号化し、許容できる範囲で再現率を犠牲にする代わりにメモリ使用量を減らすことです。
Doris では、ANN インデックスの量子化方式を quantizer で制御します。
| quantizer | 意味 | float32 に対する圧縮率 |
|---|---|---|
flat | 量子化なし(品質が最も高く、メモリ使用量も最も多い) | 1x |
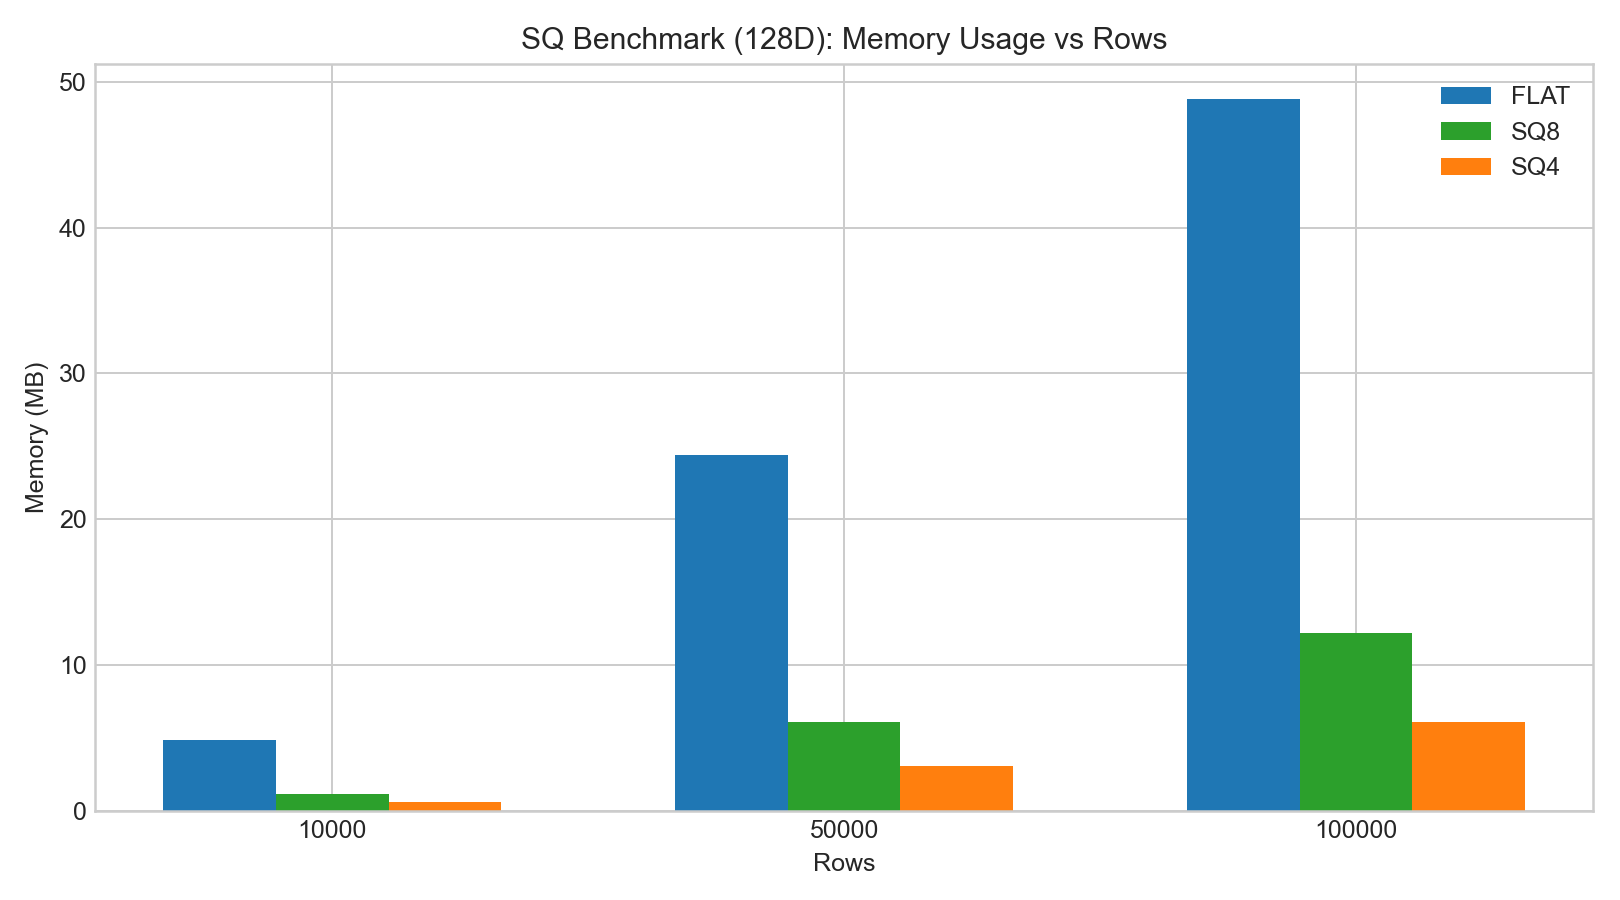
sq8 | 8 ビットのスカラー量子化 | 約 4x |
sq4 | 4 ビットのスカラー量子化 | 約 8x |
pq | 直積量子化 | pq_m と pq_nbits に依存 |
最小構成の例(HNSW + quantizer):
CREATE TABLE vector_tbl (
    id BIGINT,
    embedding ARRAY<FLOAT>,
    INDEX ann_idx (embedding) USING ANN PROPERTIES (
        "index_type" = "hnsw",
        "metric_type" = "l2_distance",
        "dim" = "768",
        "quantizer" = "sq8"
    )
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 8
PROPERTIES ("replication_num" = "3");
アルゴリズムの概要
| 方式 | 基本的な考え方 | 代表的な利点 | 主なコスト |
|---|---|---|---|
| SQ(スカラー量子化) | 各次元を個別に量子化する | メモリ使用量を大幅に削減でき、実装が単純 | 構築コストが FLAT より高く、圧縮を強めるほど再現率が低下しやすい |
| PQ(直積量子化) | 部分ベクトルに分割し、グループごとに量子化する | 一般的な用途で圧縮率とクエリ速度のバランスがよい | 学習と符号化のコストが高く、パラメータの調整が必要 |
スカラー量子化(SQ)
原理
SQ はベクトルの次元数を変えません。各次元の数値精度だけを下げます。
一般的な最小値・最大値による量子化の対応付けは次のとおりです。
max_code = (1 << b) - 1scale = (max_val - min_val) / max_codecode = round((x - min_val) / scale)
Faiss の SQ には主に次の二種類があります。
| 種類 | 値の範囲を求める方法 | 適した用途 |
|---|---|---|
| 均一 | 全次元で同じ最小値・最大値を共有する | 次元間の数値スケールが近い場合 |
| 不均一 | 次元ごとに個別に統計を求める | 次元間で数値スケールが大きく異なり、復元誤差を小さくしたい場合 |
特性
長所:
- 実装が直接的で、動作が安定しています。
- 圧縮率を予測できます(float32 の値と比べて、
sq8は約 4x、sq4は約 8x)。
制約:
- 基本的には、固定幅の区間への割り当てです。
- ある次元の値の分布が明らかに不均一な場合(長い裾を持つ分布など)、誤差が大きくなります。
Faiss のソースコードの要点(SQ)
Doris で使用する最適化された Faiss の実装では、SQ の学習時にまず最小値と最大値を求め、その後の追加段階で範囲外の値が発生するリスクを減らすため、必要に応じて値の範囲を少し広げます。簡略化すると次のようになります。
void train_Uniform(..., const float* x, std::vector<float>& trained) {
    trained.resize(2);
    float& vmin = trained[0];
    float& vmax = trained[1];
    // Scan samples to obtain min/max
    // Then expand the range based on rs_arg
}
不均一 SQ では、Faiss は全体で単一の範囲を使う代わりに次元ごとに統計を求めます。そのため、次元間で数値スケールが大きく異なるデータでは、通常はこちらのほうが適しています。
実測での傾向
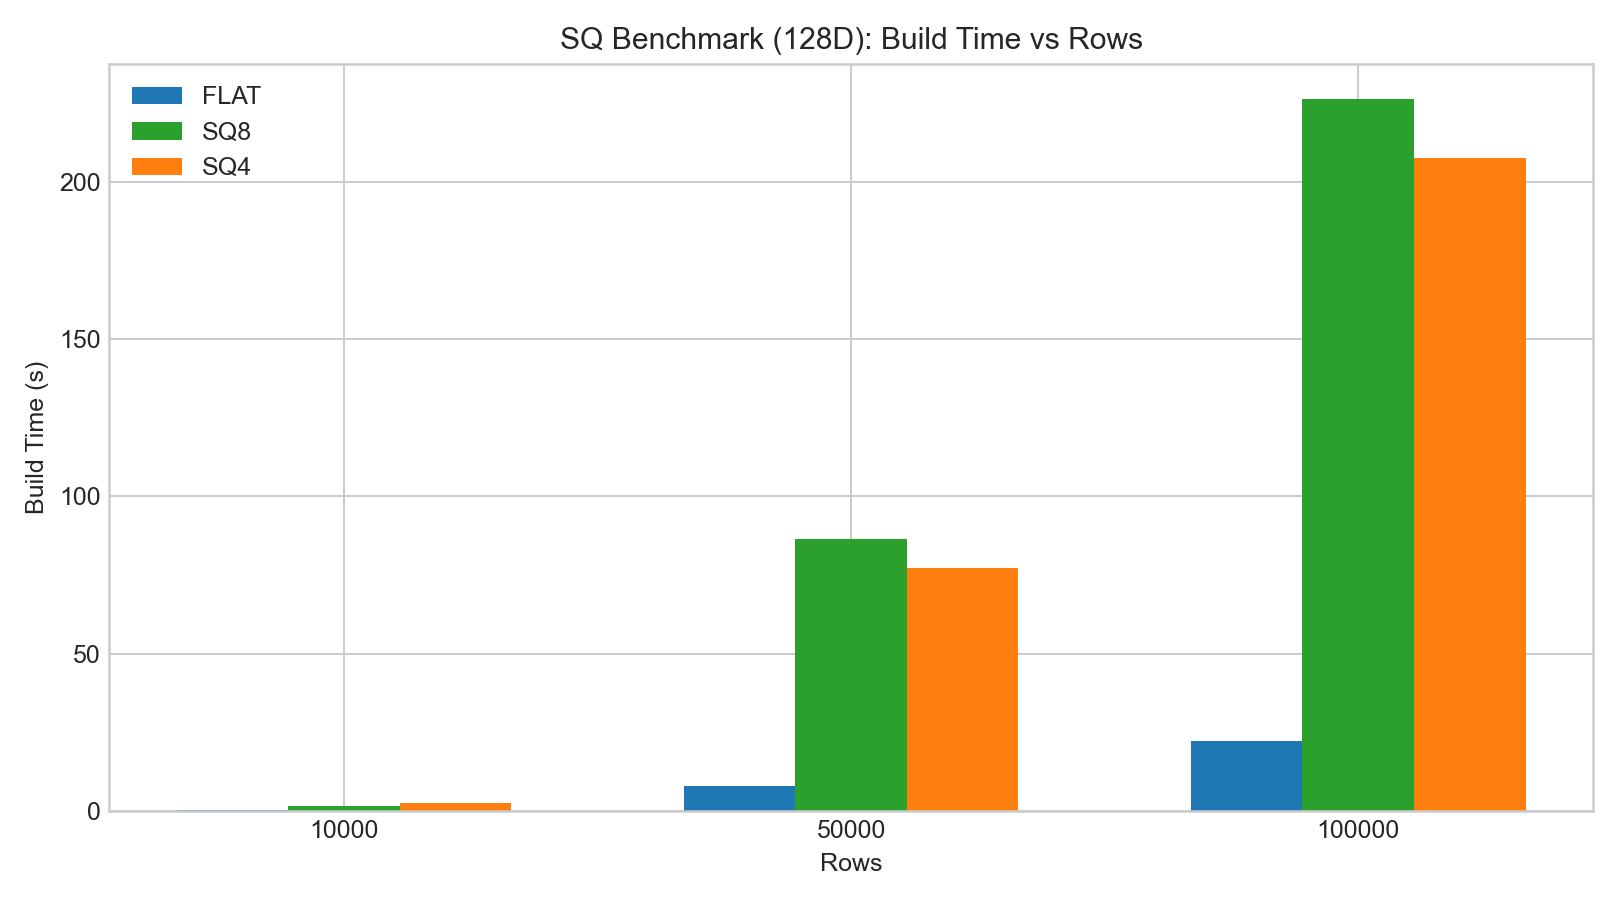
社内で実施した 128D/256D の HNSW テストでは、次の傾向が見られました。
sq8の再現率は、通常sq4より明らかに高くなります。- SQ の構築・符号化時間は FLAT より大幅に長くなります。
sq8のクエリレイテンシーは通常あまり変わりませんが、sq4では再現率の低下がより顕著です。
以下の棒グラフは、ベンチマークのサンプルデータに基づいています。
直積量子化(PQ)
原理
PQ は D 次元のベクトルを M 個の部分ベクトル(それぞれ D/M 次元)に分割し、各部分空間で k-means 量子化を行います。
主なパラメータ:
| パラメータ | 意味 | 調整の方向性 |
|---|---|---|
pq_m | 部分量子化器の数 | 値を大きくすると精度が向上する一方、学習と符号化のコストが増える |
pq_nbits | 部分ベクトルごとの符号化ビット数 | 各部分空間のコードブックのサイズ(2^pq_nbits)を決める |
PQ のクエリが高速になる理由
PQ は、距離の近似に LUT(ルックアップテーブル)を使用できます。
- クエリの各部分ベクトルから、対応する部分空間の各重心までの距離を事前に計算します。
- クエリ時にテーブル参照と加算を行い、全体の距離を推定します。
これにより、多くの場合、ベクトル全体の復元を避け、検索段階の CPU コストを削減できます。
Faiss のソースコードの要点(PQ)
同じ実装経路では、Faiss の ProductQuantizer が各部分空間のコードブックを学習し、重心を連続したメモリ領域に格納します。簡略化すると次のようになります。
void ProductQuantizer::train(size_t n, const float* x) {
    Clustering clus(dsub, ksub, cp);
    IndexFlatL2 index(dsub);
    clus.train(n * M, x, index);
    for (int m = 0; m < M; m++) {
        set_params(clus.centroids.data(), m);
    }
}
重心の配置は (M, ksub, dsub) と捉えられます。
M:部分量子化器の数。ksub:各部分空間のコードブックのサイズ(2^pq_nbits)。dsub:部分ベクトルの次元数(D / M)。
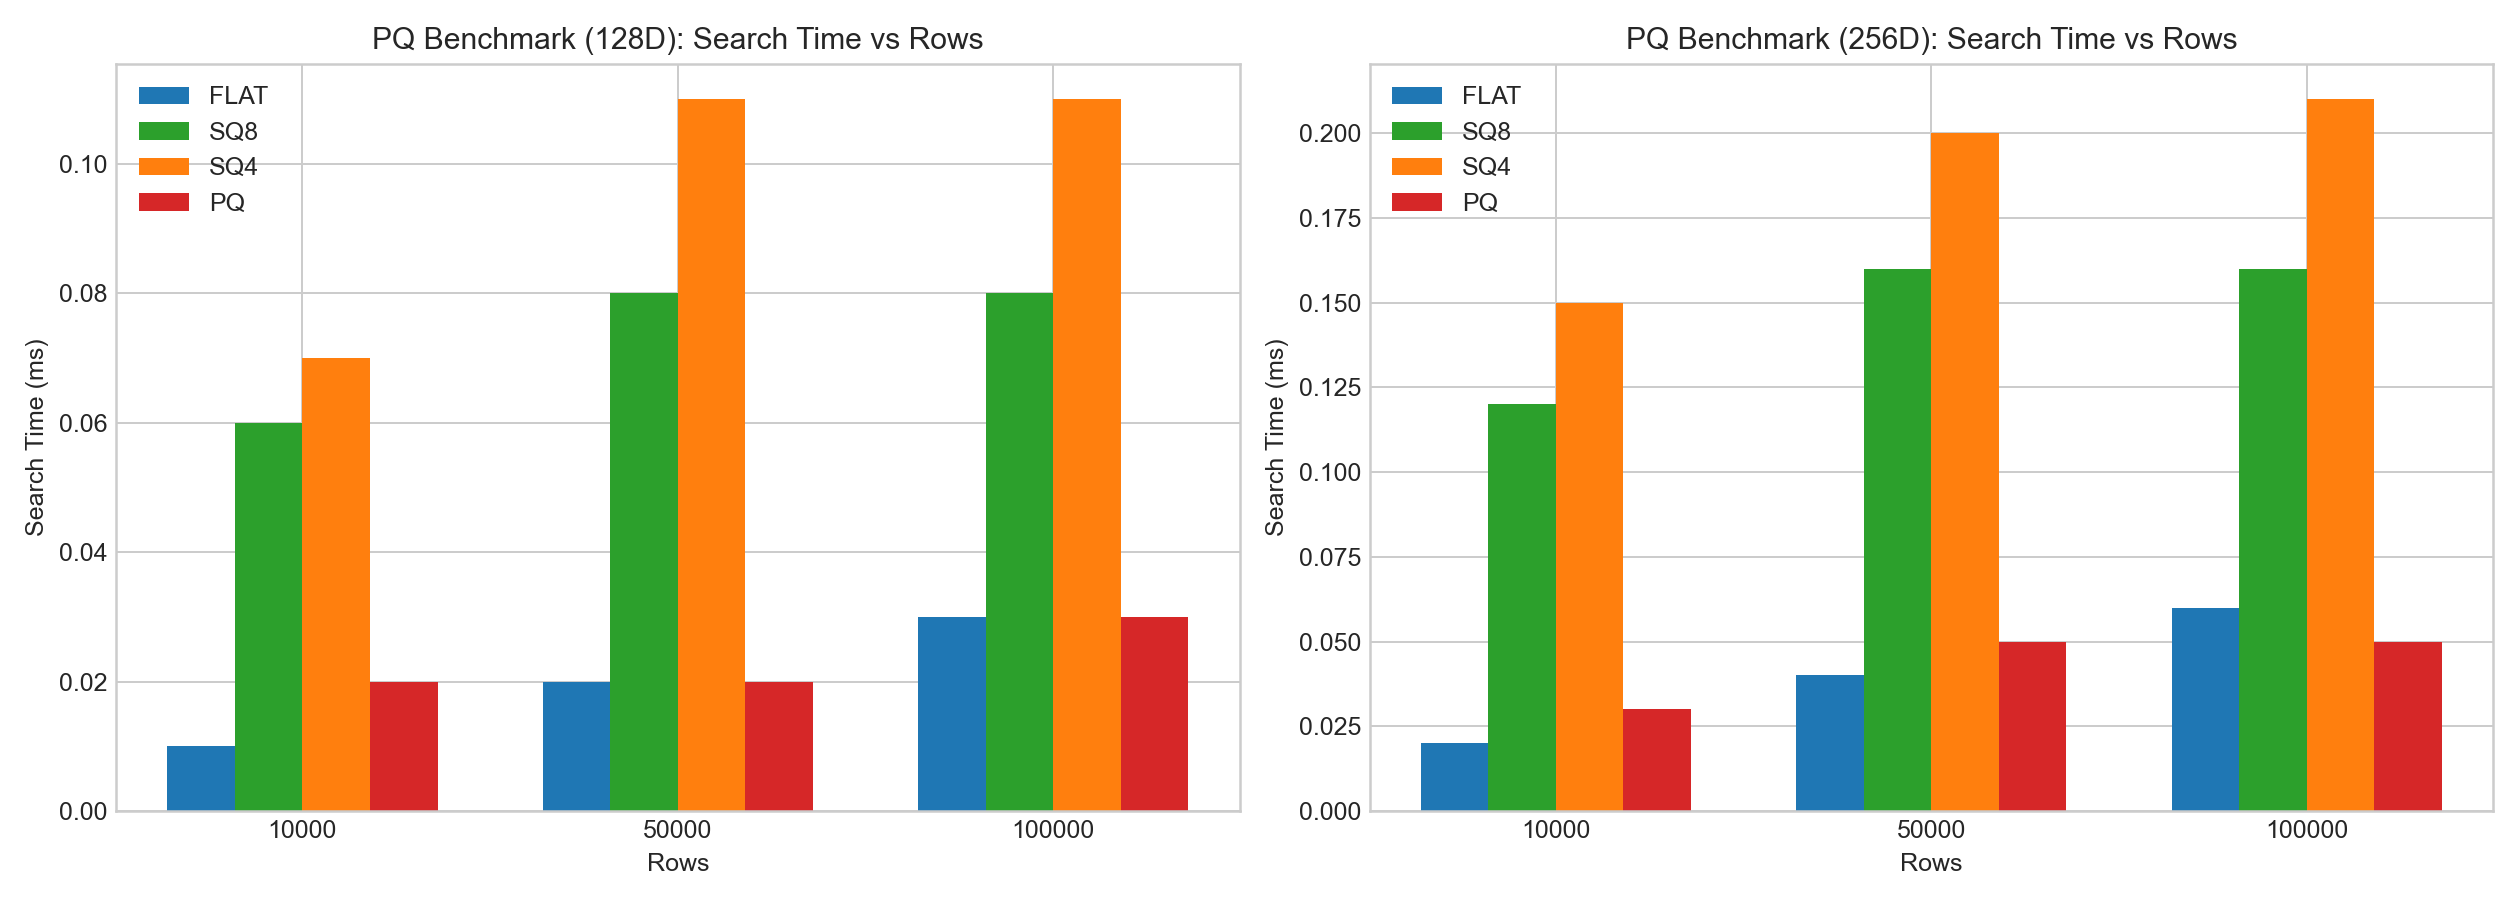
実測での傾向
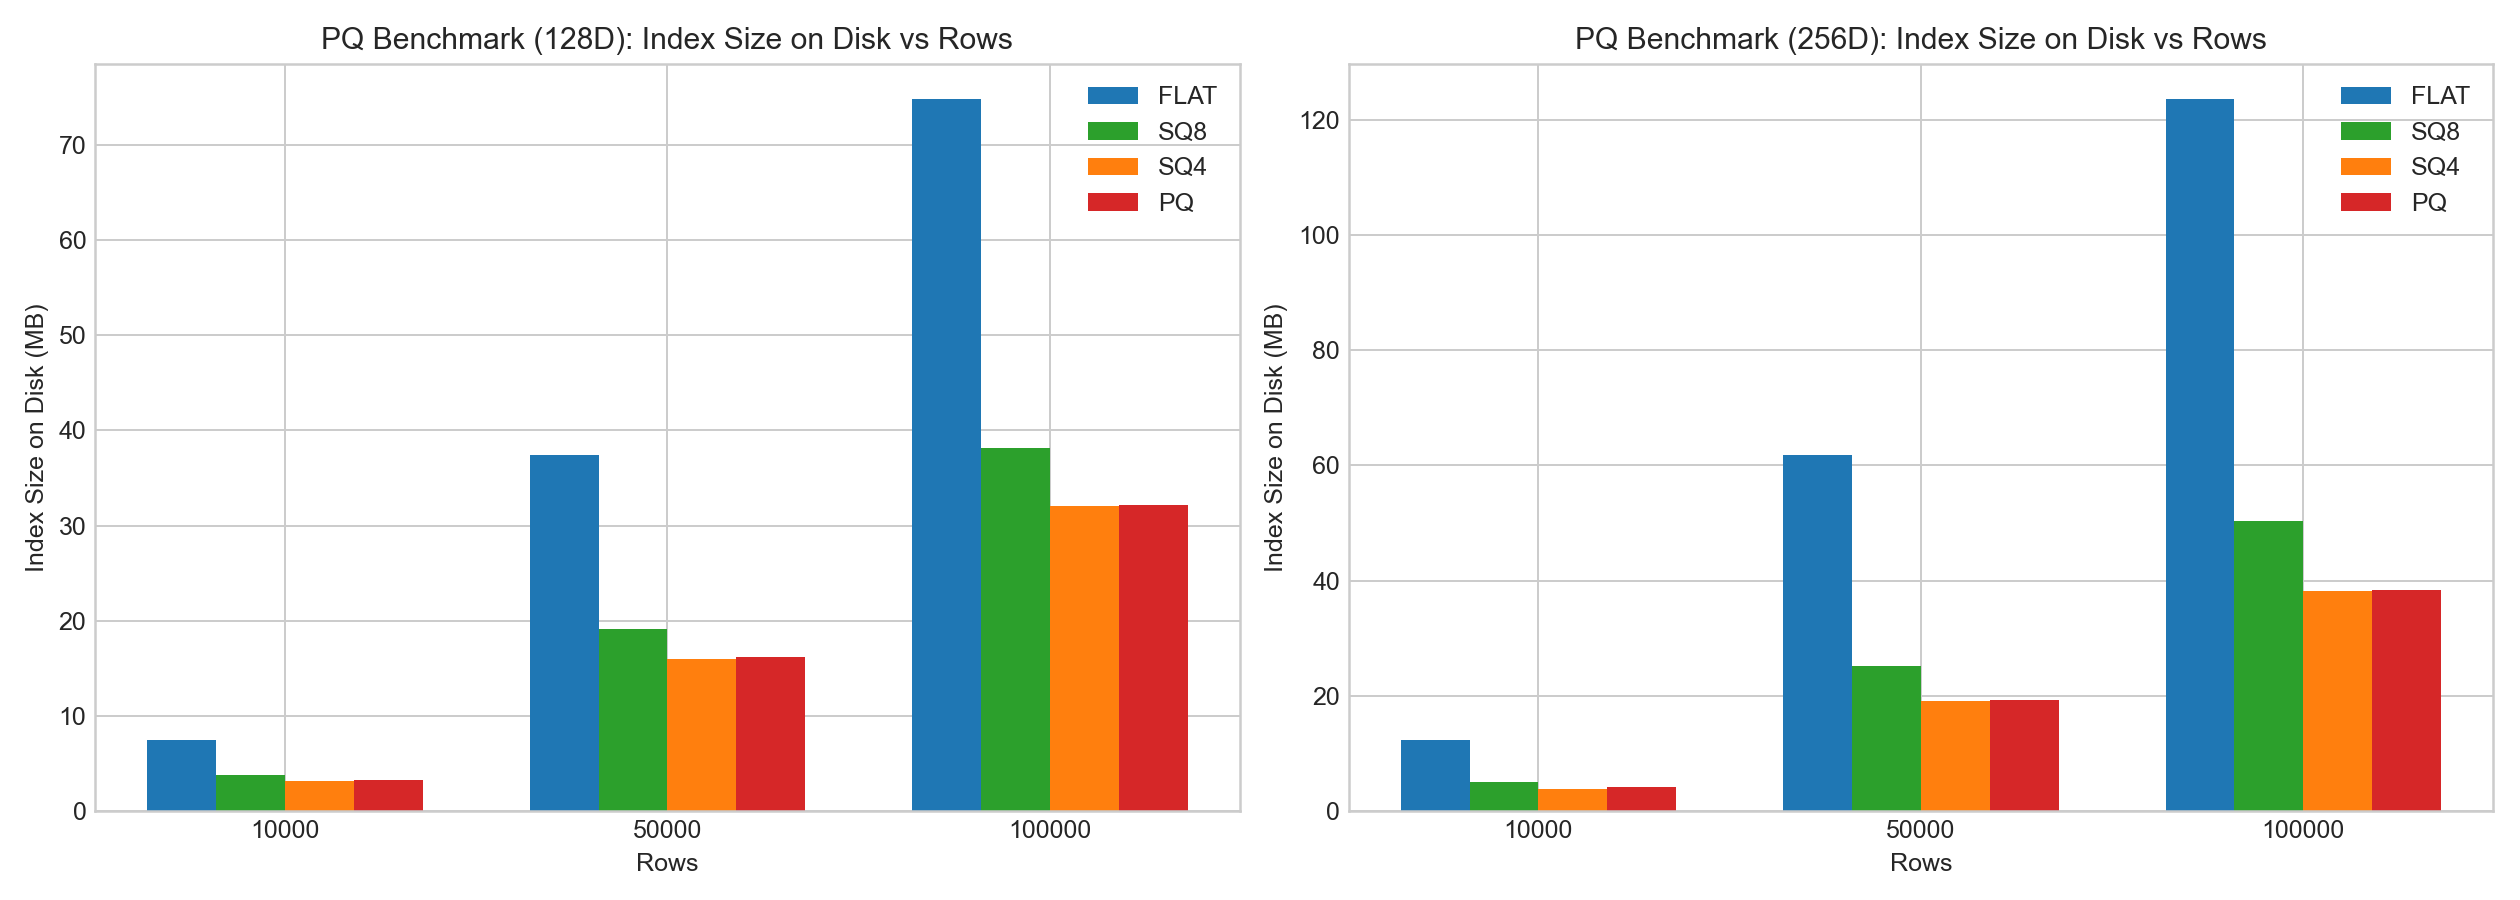
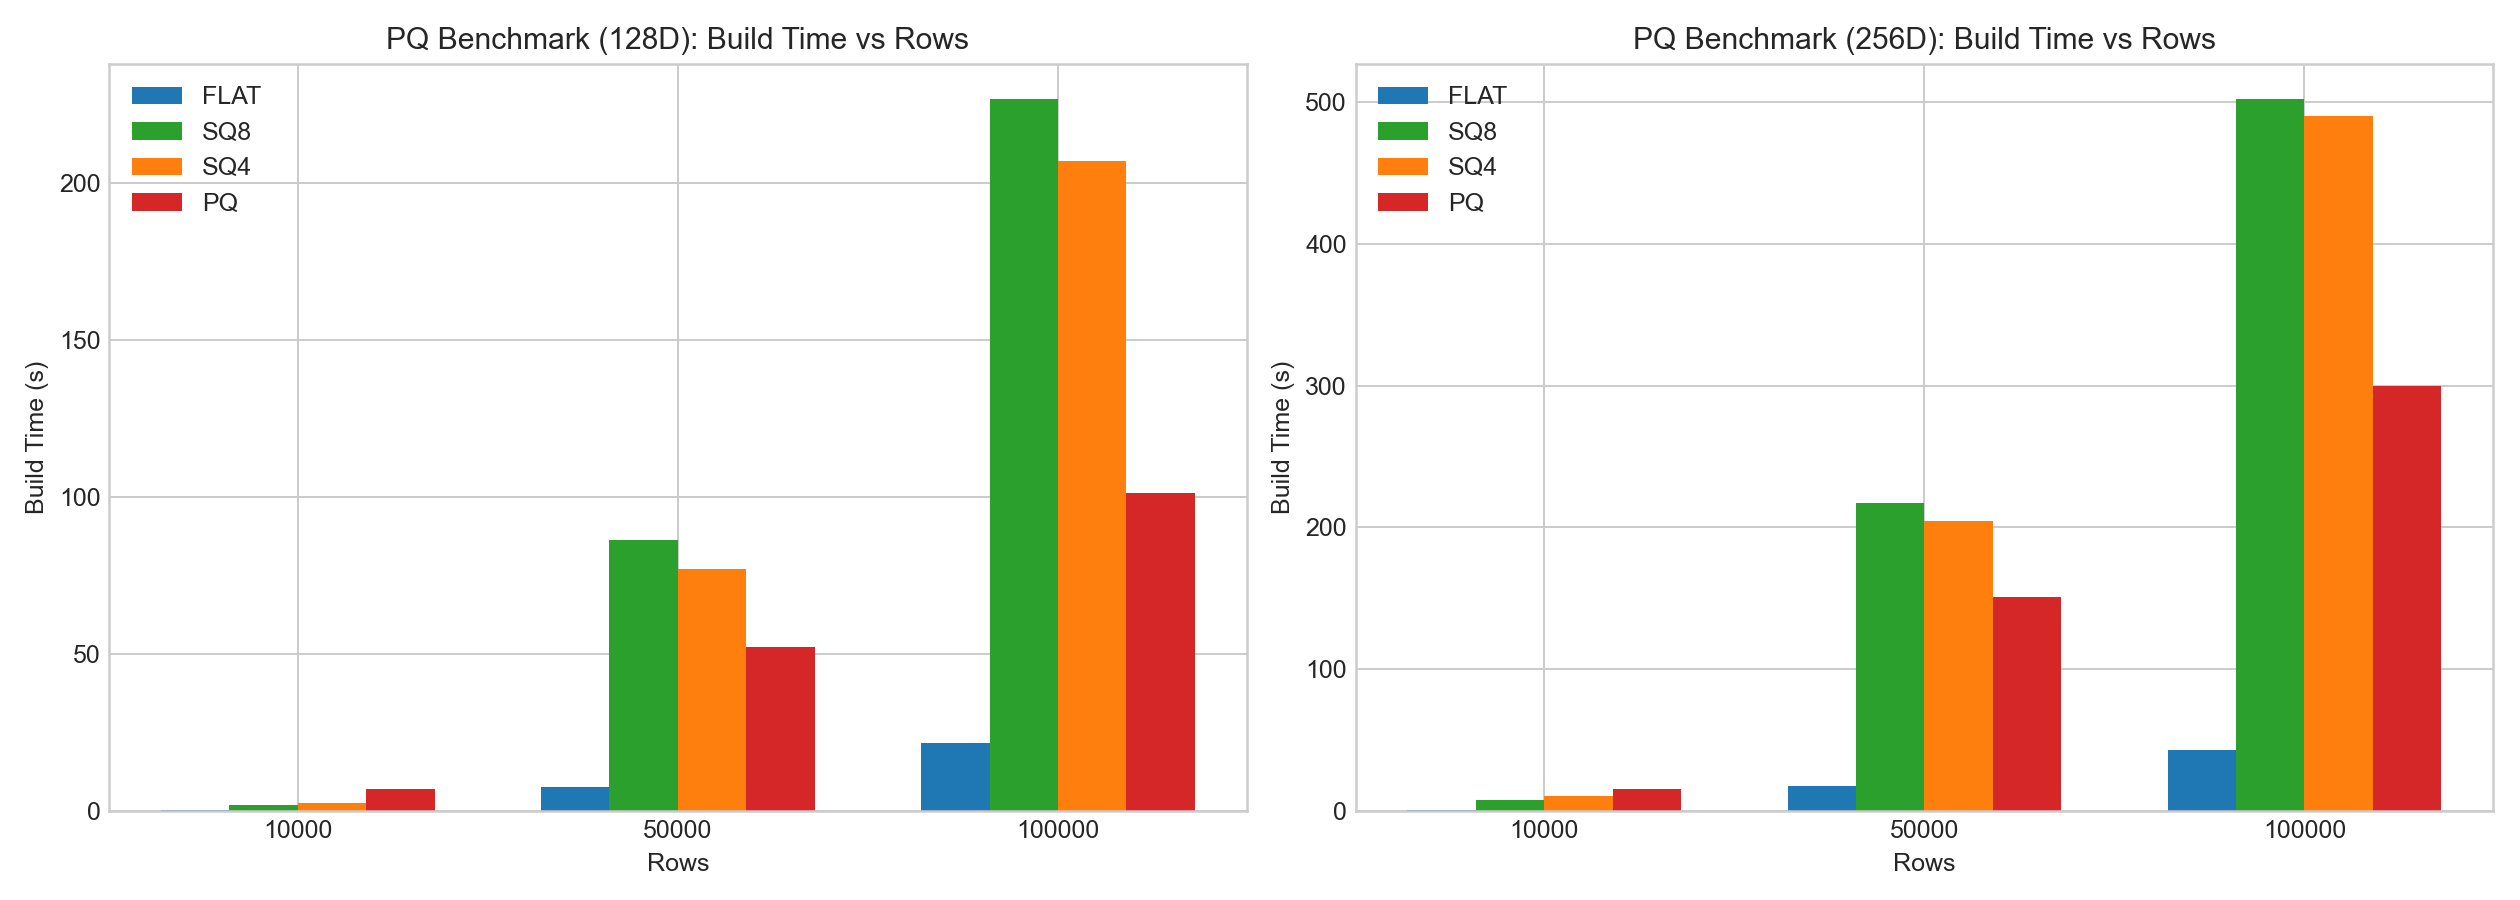
同じ社内テストでは、次の傾向が見られました。
- PQ によって明確な圧縮効果が得られます。
- PQ は学習と符号化のコストが高くなります。
- SQ と比べて、PQ は LUT を利用することで検索段階を高速化できる場合が多いものの、再現率と構築コストはデータの分布とパラメータの組み合わせに左右されます。
以下の棒グラフは、ベンチマークのサンプルデータに基づいています。
Doris での選択指針
用途に応じた選択
| 用途 | 推奨する量子化方式 | 理由 |
|---|---|---|
| メモリに余裕があり、再現率を優先する | flat | 精度の損失がなく、達成できる品質の上限が最も高い |
| 品質を安定させながら、低リスクでメモリ使用量を減らしたい | sq8 | 約 4x に圧縮でき、再現率の低下を抑えやすい |
| メモリ不足が深刻で、再現率の低下を許容できる | sq4 | 約 8x に圧縮できるが、再現率の低下がより顕著 |
| 圧縮率と性能のバランスを求め、パラメータを調整できる | pq | LUT によってクエリを高速化できるが、パラメータの調整が必要 |
推奨する検証手順
- まず
flatで基準値を作り、Recall@K とクエリレイテンシーを記録します。 - 最初に
sq8を試し、再現率と P95/P99 レイテンシーを比較します。 - それでもメモリが足りない場合は
pqを試します(pq_m = D/2から始められます)。 sq4は、再現率よりもメモリ使用量を優先する場合にのみ検討します。
ベンチマーク時の考慮事項
レイテンシーの絶対値は、ハードウェア、スレッド数、データセットと強く関係します。条件をそろえて比較する際は、結果を比較可能にするために次の変数を固定してください。
| 分類 | 固定する変数 |
|---|---|
| データ | ベクトルの次元数、データセットの分布、行数 |
| インデックス | インデックスのパラメータ、セグメントサイズ |
| クエリ | クエリ集合と正解集合 |
評価指標には、以下のすべてを含めてください。
- Recall@K
- インデックスサイズ
- 構築時間
- クエリレイテンシー(P50/P95/P99)
FAQ
Q1: sq8 と sq4 はどう選べばよいですか?
まず sq8 を選んでください。sq8 は再現率の低下を抑えながら約 4x に圧縮できます。sq4 は約 8x に圧縮できますが、再現率の低下がより顕著なため、メモリにほとんど余裕がない場合にのみ使用してください。
Q2: SQ より PQ を選ぶべきなのはどのような場合ですか?
より高い圧縮率が必要な場合、または LUT を利用して検索段階を高速化したい場合は PQ を選びます。その代わり、学習と符号化のコストが高くなり、データの分布に合わせて pq_m と pq_nbits を調整する必要があります。
Q3: 量子化は構築時間に影響しますか?
はい。どの量子化方式でも構築・符号化時間は flat より大幅に長く、PQ の学習段階は最もコストが高くなります。評価時には構築時間を別途記録してください。
Q4: 不均一 SQ は常に均一 SQ より優れていますか?
必ずしもそうではありません。次元間で数値スケールが大きく異なる場合(たとえば、一部の次元の値が本質的に大きい場合)、不均一 SQ のほうが復元誤差は小さくなります。次元間のスケールが近い場合、両者の差は限定的です。
Q5: pq_m の初期値はどう設定しますか?
pq_m = D/2 から始めて、Recall@K とクエリレイテンシーを見ながら値を上下に調整できます。pq_m を大きくすると精度が向上する一方、学習と符号化のコストも増えます。