監視とアラート
このドキュメントでは、Apache Doris クラスターの監視システムを構築する方法を説明します。Prometheus で FE と BE が公開するメトリクスを収集し、Grafana と公式ダッシュボードテンプレートで可視化します。また、後でアラートを連携できるよう、Alertmanager の設定項目を用意します。
注: Kubernetes 上にコンピュートとストレージを分離した Doris クラスターをデプロイする場合、監視の設定についてはPrometheus と Grafana のデプロイを参照してください。このドキュメントの監視アーキテクチャ、メトリクス形式、ダッシュボードの説明も適用できます。
適用シナリオ
| シナリオ | 説明 |
|---|---|
| クラスターデプロイ後の監視連携 | Doris クラスターのデプロイ後に、FE/BE の稼働メトリクスを収集してグラフに表示する場合。 |
| 複数クラスターの統合監視 | 同じ Prometheus と Grafana の構成で、複数の Doris クラスターを同時に監視する場合。 |
| トラブルシューティングと性能チューニング | JVM、クエリ、Backend タスクのダッシュボードで、異常なノードやボトルネックをすばやく特定する場合。 |
| アラートの設定(予定) | 将来的に Prometheus と Alertmanager を使い、メールや SMS などの通知先を設定する場合。 |
前提条件
- Doris クラスターのデプロイが完了し、FE と BE のプロセスが正常に稼働していること。
- FE の HTTP ポート(デフォルトは
8030)と BE の Web Server ポート(デフォルトは8040)にアクセスできること。 - Prometheus と Grafana を実行するサーバーがあり、そのサーバーからすべての FE/BE ノードにネットワーク経由でアクセスできること。
- Prometheus と Grafana の公式サイトからインストールパッケージとダッシュボードテンプレートをダウンロードできる外部ネットワーク接続があること。
ダッシュボードテンプレートのダウンロード
Doris は Grafana ダッシュボードテンプレートを二つ提供しています。クラスターのストレージモードに合うものを選び、そのままインポートしてください。テンプレートは定期的に更新されます。更新手順についてはダッシュボードの更新を参照してください。
| ストレージモード | ダッシュボードテンプレート | 備考 |
|---|---|---|
| Shared-nothing | doris-grafana-dashboard.json | ローカルストレージを使用する従来の FE / BE 構成向け。パネルは FE と BE のコンポーネントを対象とします。 |
| コンピュートとストレージの分離 | doris-grafana-dashboard-cloud.json | パネルは FE、BE / Compute Group、Meta Service を対象とします。Kubernetes と Kubernetes 以外の両方で、コンピュートとストレージを分離したクラスターに適用できます。 |
コミュニティからの、より優れたダッシュボードの提供を歓迎します。
監視アーキテクチャの概要
Doris は Prometheus と Grafana を使って監視データを収集、表示します。
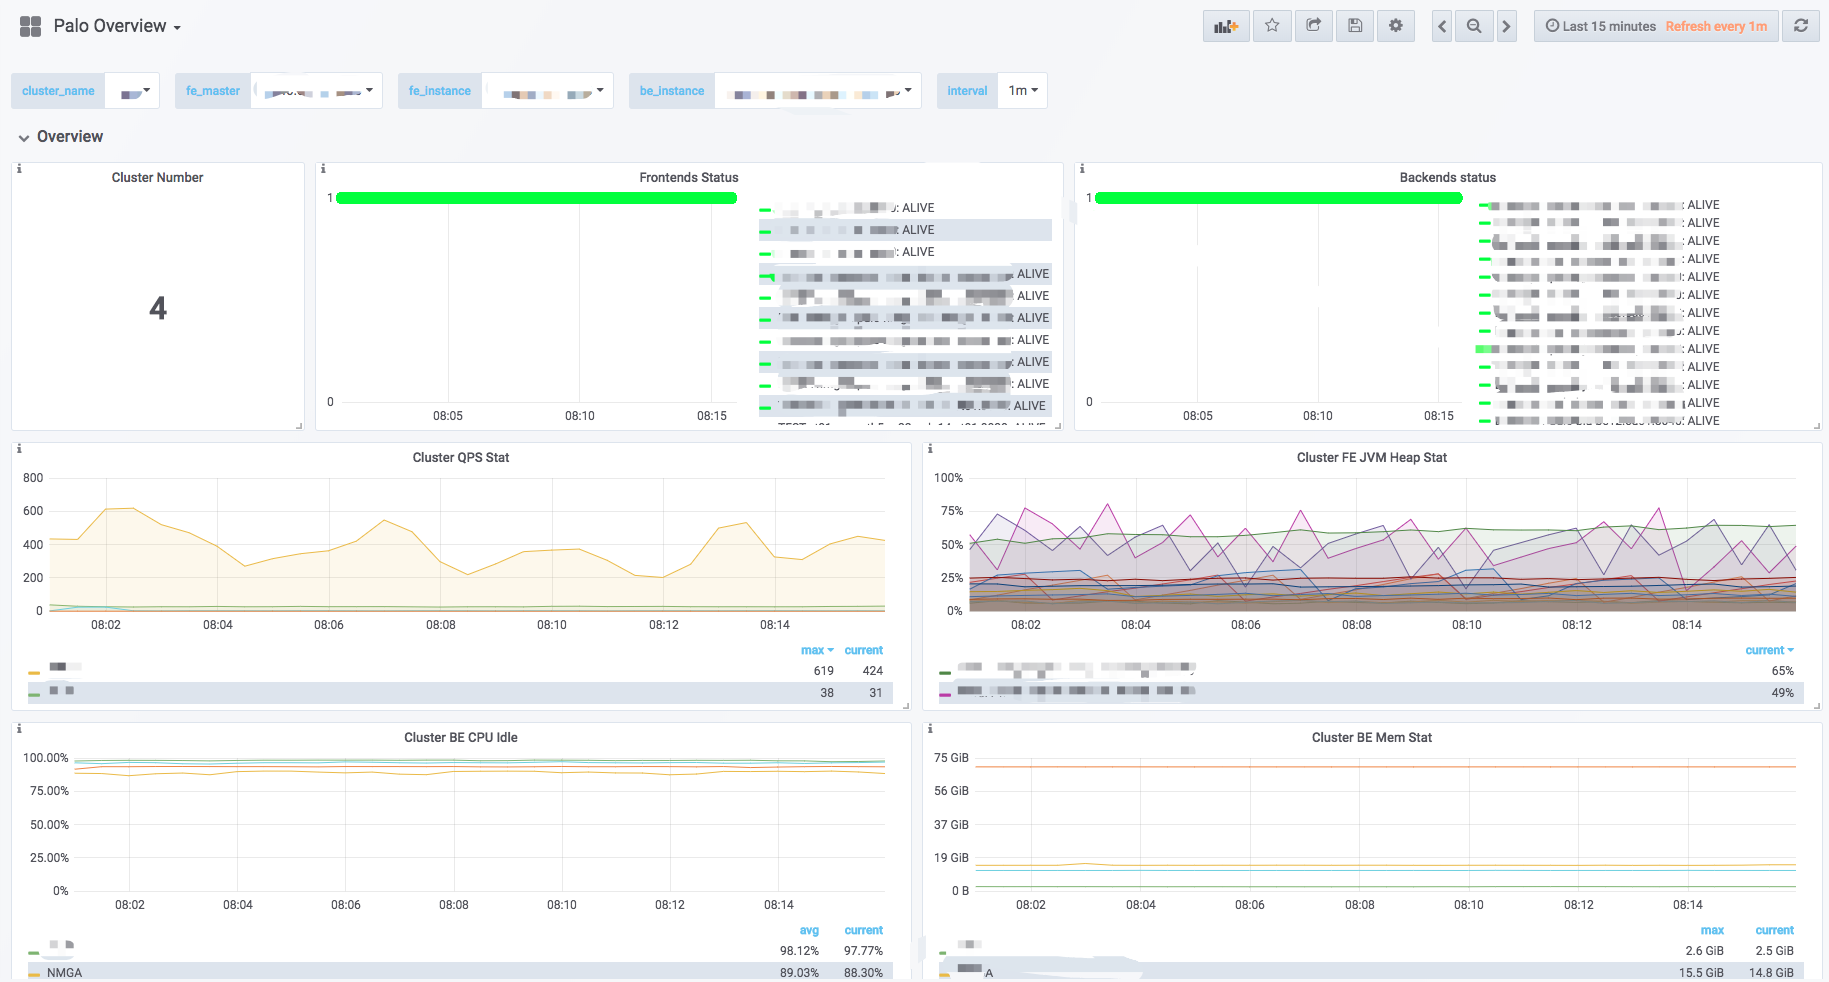
| コンポーネント | 役割 |
|---|---|
| Prometheus | オープンソースのシステム監視・アラートスイートです。Pull または Push でメトリクスを収集して独自の時系列データベース(TSDB)に保存し、多次元データ用のクエリ言語を提供します。 |
| Grafana | オープンソースのデータ分析・可視化プラットフォームです。Prometheus を含む複数の時系列データソースに対応し、設定可能なダッシュボードを通じてデータをグラフで表示します。 |
| Alertmanager | 別途デプロイする Prometheus のアラートコンポーネントです。メールや SMS などの通知ポリシーを設定できます(このドキュメントでは扱いません。公式ドキュメントを参照してください)。 |
注: このドキュメントで説明するのは、Prometheus と Grafana を使って Doris の監視データを収集、表示する方法の一例です。原則として、Doris はこれらのコンポーネントを開発・保守していません。詳細は各コンポーネントの公式ドキュメントを参照してください。
データフロー図
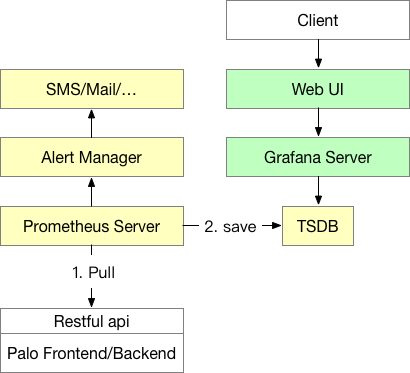
- Prometheus(黄色の部分): Prometheus Server は Prometheus のメインプロセスです。Pull 方式で Doris ノードの監視エンドポイントにアクセスし、時系列データを TSDB に保存します(TSDB は Prometheus プロセスに含まれ、別途デプロイする必要はありません)。Prometheus は Push Gateway 方式にも対応しています。監視対象システムが Push Gateway に監視データを送信し、Prometheus Server がそこからデータを取得します。
- Alertmanager: Alertmanager は Prometheus のアラートコンポーネントで、別途デプロイする必要があります(このドキュメントでは構築方法を説明しません。設定方法は公式ドキュメントを参照してください)。Alertmanager を使うと、アラートポリシーを設定し、メールや SMS などで通知を受け取れます。
- Grafana(緑色の部分): Grafana Server は Grafana のメインプロセスです。起動後、Web ページからデータソース、ユーザー、ダッシュボードのグラフなどを設定できます。エンドユーザーもこの画面で監視データを確認します。
監視データの形式
Doris の監視データは、Frontend と Backend の HTTP エンドポイントから Key-Value 形式のテキストとして公開されます。各 Key には、区別のために複数の Label を付けることもできます。クラスターのデプロイ後、ブラウザーで次のエンドポイントに直接アクセスすると、ノードのリアルタイムの監視データを確認できます。
| ノードの種類 | エンドポイント |
|---|---|
| Frontend | fe_host:fe_http_port/metrics |
| Backend | be_host:be_web_server_port/metrics |
| Broker | 提供されていません |
エンドポイントにアクセスすると、次のような結果が表示されます(FE メトリクスの例)。
# HELP  jvm_heap_size_bytes jvm heap stat
# TYPE  jvm_heap_size_bytes gauge
jvm_heap_size_bytes{type="max"} 8476557312
jvm_heap_size_bytes{type="committed"} 1007550464
jvm_heap_size_bytes{type="used"} 156375280
# HELP  jvm_non_heap_size_bytes jvm non heap stat
# TYPE  jvm_non_heap_size_bytes gauge
jvm_non_heap_size_bytes{type="committed"} 194379776
jvm_non_heap_size_bytes{type="used"} 188201864
# HELP  jvm_young_size_bytes jvm young mem pool stat
# TYPE  jvm_young_size_bytes gauge
jvm_young_size_bytes{type="used"} 40652376
jvm_young_size_bytes{type="peak_used"} 277938176
jvm_young_size_bytes{type="max"} 907345920
# HELP  jvm_old_size_bytes jvm old mem pool stat
# TYPE  jvm_old_size_bytes gauge
jvm_old_size_bytes{type="used"} 114633448
jvm_old_size_bytes{type="peak_used"} 114633448
jvm_old_size_bytes{type="max"} 7455834112
# HELP  jvm_gc jvm gc stat
# TYPE  jvm_gc gauge
<GarbageCollector>{type="count"} 247
<GarbageCollector>{type="time"} 860
# HELP  jvm_thread jvm thread stat
# TYPE  jvm_thread gauge
jvm_thread{type="count"} 162
jvm_thread{type="peak_count"} 205
jvm_thread{type="new_count"} 0
jvm_thread{type="runnable_count"} 48
jvm_thread{type="blocked_count"} 1
jvm_thread{type="waiting_count"} 41
jvm_thread{type="timed_waiting_count"} 72
jvm_thread{type="terminated_count"} 0
...
データは Prometheus 形式で表されます。次の項目を例に説明します。
# HELP  jvm_heap_size_bytes jvm heap stat
# TYPE  jvm_heap_size_bytes gauge
jvm_heap_size_bytes{type="max"} 8476557312
jvm_heap_size_bytes{type="committed"} 1007550464
jvm_heap_size_bytes{type="used"} 156375280
各フィールドの意味は次のとおりです。
#で始まる行はコメント行です。HELPはメトリクスの説明、TYPEはメトリクスのデータ型を示します。この例の型はスカラー値を表すGaugeです。ほかにCounterやHistogramなどの型があります。詳細は Prometheus の公式ドキュメントを参照してください。jvm_heap_size_bytesはメトリクス名(Key)です。type="max"は、名前がtype、値がmaxの Label です。一つのメトリクスに複数の Label を付けられます。- 最後の数値
8476557312はメトリクスの実際の値です。
監視システムのセットアップ
Doris のデプロイ後、次の順序で監視システムをセットアップします。
- Prometheus をデプロイし、FE と BE の
/metricsエンドポイントからメトリクスを収集するよう設定します。 - Grafana をデプロイし、Prometheus をデータソースに設定します。
- Grafana に Doris の公式ダッシュボードテンプレートをインポートします。
- Grafana の画面でダッシュボードを確認し、必要に応じて調整します。
Prometheus のデプロイ
1. ダウンロードと展開
Prometheus 公式サイトから最新版をダウンロードします。ここでは 2.43.0-linux-amd64 バージョンを例に使用します。監視サービスを実行する予定のマシンで、ダウンロードした tar ファイルを展開します。
2. 設定ファイルの作成
設定ファイル prometheus.yml を開きます。このファイルは YAML 形式なので、インデントと空白を揃えてください。ここでは、最も簡単な静的ファイル方式で監視を設定します。Prometheus は、ノードの追加や削除を動的に検出できるさまざまなサービスディスカバリー方式にも対応しています。
設定例:
# my global config
global:
  scrape_interval:     15s # Global scrape interval, default is 1m, set to 15s here
  evaluation_interval: 15s # Global rule evaluation interval, default is 1m, set to 15s here

# Alertmanager configuration
alerting:
  alertmanagers:
  - static_configs:
    - targets:
      # - alertmanager:9093

# A scrape configuration containing exactly one endpoint to scrape:
# Here it's Prometheus itself.
scrape_configs:
  # The job name is added as a label `job=<job_name>` to any timeseries scraped from this config.
  - job_name: 'DORIS_CLUSTER' # Each Doris cluster is called a job. You can give the job a name here as the name of the Doris cluster in the monitoring system.
    metrics_path: '/metrics' # Specify the RESTful API path for retrieving metrics. Combined with the host:port in targets below, Prometheus eventually scrapes metrics via host:port/metrics_path.
    static_configs: # Configure the target addresses of FE and BE separately. All FEs and BEs are written into their respective groups.
      - targets: ['fe_host1:8030', 'fe_host2:8030', 'fe_host3:8030']
        labels:
          group: fe # The fe group is configured here, containing 3 Frontends.

      - targets: ['be_host1:8040', 'be_host2:8040', 'be_host3:8040']
        labels:
          group: be # The be group is configured here, containing 3 Backends.

  - job_name: 'DORIS_CLUSTER_2' # You can monitor multiple Doris clusters in one Prometheus. Another Doris cluster configuration starts here. Configuration is the same as above; details omitted.
    metrics_path: '/metrics'
    static_configs:
      - targets: ['fe_host1:8030', 'fe_host2:8030', 'fe_host3:8030']
        labels:
          group: fe

      - targets: ['be_host1:8040', 'be_host2:8040', 'be_host3:8040']
        labels:
          group: be
主なフィールド:
| フィールド | 説明 |
|---|---|
scrape_interval | 全体の収集間隔です。15s を推奨します。 |
evaluation_interval | 全体のルール評価間隔です。15s を推奨します。 |
job_name | Doris クラスターごとに一つのジョブを割り当てます。監視システムでクラスターを識別する名前になります。 |
metrics_path | メトリクスのエンドポイントパスで、/metrics に固定します。 |
static_configs.targets | FE/BE ノードの host:port の一覧です。FE のデフォルトポートは 8030、BE は 8040 です。 |
labels.group | ノードグループのラベルです。fe と be を推奨します。 |
3. Prometheus の起動
次のコマンドで Prometheus をバックグラウンド起動し、Web ポートを 8181 に設定します。
nohup ./prometheus --web.listen-address="0.0.0.0:8181" &
起動すると、Prometheus はすぐにデータの収集を開始し、data ディレクトリに保存します。
4. Prometheus の停止
現時点では、Prometheus にプロセスを停止する正式な方法はありません。kill -9 を直接使用できます。また、Prometheus をサービスとして登録し、サービスとして起動・停止することもできます。
5. Prometheus へのアクセス
ブラウザーからポート 8181 にアクセスし、Prometheus の画面を開きます。ナビゲーションバーの Status -> Targets をクリックすると、ジョブごとにグループ化された監視対象ノードが表示されます。正常な場合、すべてのノードが UP となり、データを収集できていることを示します。Endpoint をクリックすると、現在の監視値を確認できます。
ノードの状態が UP でない場合、まず Doris の /metrics エンドポイント(監視データの形式を参照)にアクセスできるか確認するか、Prometheus のドキュメントを参照して問題を解決してください。
高度な使い方については、Prometheus の公式ドキュメントを参照してください。
Grafana のデプロイ
1. ダウンロードと展開
Grafana 公式サイトから最新版をダウンロードします。ここでは 8.5.22.linux-amd64 バージョンを例に使用します。監視サービスを実行する予定のマシンで、ダウンロードした tar ファイルを展開します。
2. 設定ファイルの作成
設定ファイル conf/defaults.ini を開きます。次の設定項目だけを確認し、その他はデフォルト値のままにします。
# Path to where grafana can store temp files, sessions, and the sqlite3 db (if that is used)
data = data

# Directory where grafana can store logs
logs = data/log

# Protocol (http, https, socket)
protocol = http

# The ip address to bind to, empty will bind to all interfaces
http_addr =

# The http port to use
http_port = 8182
3. Grafana の起動
次のコマンドで Grafana をバックグラウンド起動します。アクセスポートは上で設定した 8182 です。
nohup ./bin/grafana-server &
4. Grafana の停止
現時点では、Grafana にプロセスを停止する正式な方法はありません。kill -9 を直接使用できます。また、Grafana をサービスとして登録し、サービスとして起動・停止することもできます。
5. Grafana へのアクセス
ブラウザーからポート 8182 にアクセスし、Grafana の画面を開きます。デフォルトのユーザー名とパスワードはどちらも admin です。
6. データソースの設定
初回ログイン後、画面の案内に従ってデータソースを設定します。ここでのデータソースは、前の手順でデプロイした Prometheus インスタンスです。
データソースの設定画面にある項目は次のとおりです。
| フィールド | 説明 |
|---|---|
| Name | データソースの任意の名前です。例: doris_monitor_data_source。 |
| Type | Prometheus を選択します。 |
| URL | Prometheus の Web アドレスを入力します。例: http://host:8181。 |
| Access | Server モードを選択し、Grafana が稼働するサーバー経由で Prometheus にアクセスします。 |
| その他のオプション | デフォルト値のままにします。 |
画面下部の Save & Test をクリックします。Data source is working と表示されれば、データソースを利用できます。
7. ダッシュボードのインポート
データソースを利用できることを確認したら、次の手順で Doris の公式ダッシュボードテンプレートをインポートします。
- 左側のナビゲーションバーにある
+アイコンをクリックし、ダッシュボードの追加を開始します。 - このドキュメントのダッシュボードテンプレートのダウンロードにある JSON ファイルをダウンロードします。
- 画面上部の
New dashboard->Import dashboard->Upload .json Fileをクリックし、ダウンロードした JSON ファイルをインポートします。 - インポート後、ダッシュボードに名前を付けられます。デフォルト名は
Doris Overviewです。データソースには、先ほど作成したdoris_monitor_data_sourceを選択します。 Importをクリックするとインポートが完了し、Doris ダッシュボードが表示されます。
高度な使い方については、Grafana の公式ドキュメントを参照してください。
ダッシュボードの説明
ダッシュボードの内容はバージョンの更新に伴い変更される場合があります。このドキュメントは最新の内容を保証しません。
上部バー

| 要素 | 説明 |
|---|---|
| 左上 | ダッシュボード名です。 |
| 右上 | 現在の監視対象期間です。ドロップダウンから期間を選び、自動更新間隔を指定できます。 |
cluster_name | Prometheus の設定ファイルにある各 job_name に対応し、Doris クラスターを表します。切り替えると、下のグラフに選択したクラスターの監視情報が表示されます。 |
fe_master | 対象クラスターの Master Frontend ノードです。 |
fe_instance | 対象クラスターのすべての Frontend ノードです。切り替えると、下のグラフに選択した Frontend の監視情報が表示されます。 |
be_instance | 対象クラスターのすべての Backend ノードです。切り替えると、下のグラフに選択した Backend の監視情報が表示されます。 |
interval | レート関連メトリクスのサンプリング間隔です(15s にすると一部のグラフが空になる場合があります)。 |
行
Grafana では、Row はグラフのグループです(上図の Overview や Cluster Overview など)。Row をクリックすると折りたためます。現在のダッシュボードには次の Row が含まれます(随時更新されます)。
| Row | 説明 |
|---|---|
| Overview | すべての Doris クラスターを集約した表示です。 |
| Cluster Overview | 選択したクラスターを集約した表示です。 |
| Query Statistic | 選択したクラスターのクエリ関連の監視情報です。 |
| FE JVM | 選択した Frontend の JVM 監視情報です。 |
| BE | 選択したクラスターの Backend を集約した表示です。 |
| BE Task | 選択したクラスターの Backend タスク情報です。 |
グラフ
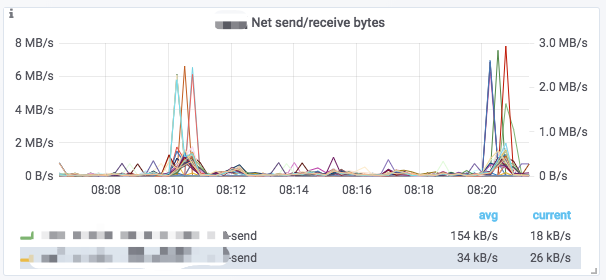
一般的なグラフには、通常、次の要素があります。
- 左上の
iアイコンにカーソルを合わせると、グラフの説明が表示されます。 - グラフの下にある凡例をクリックすると、単一のメトリクスが表示されます。もう一度クリックすると、すべてのメトリクスの表示に戻ります。
- グラフ上でドラッグすると、期間を選択できます。
- タイトル内の
[]には、選択したクラスター名が表示されます。 - 値によって左側の Y 軸または右側の Y 軸に対応します。凡例の末尾にある
-rightで区別できます。 - グラフ名 ->
Editをクリックすると、グラフを編集できます。
ダッシュボードの更新
公式ダッシュボードテンプレートが更新されたら、次の手順で既存のダッシュボードを上書きします。
- Grafana の左側のバーにある
+アイコンをクリックしてから、Dashboardをクリックします。 - 左上の
New dashboardをクリックしてから、右側のImport dashboardをクリックします。 Upload .json Fileをクリックし、最新のテンプレートファイルを選択します。- データソースを選択します。
Import (Overwrite)をクリックすると、テンプレートの更新が完了します。
FAQ
Q: Prometheus の Targets でノードの状態が DOWN です。どうすればよいですか?
Prometheus サーバーから FE/BE ノードへのネットワーク接続を確認してください。対象のアドレスとポートが正しいこと、および /metrics エンドポイントに直接アクセスできることを確認してください。
Q: ブラウザーから FE/BE の /metrics にアクセスできません。どうすればよいですか?
FE の http_port(デフォルトは 8030)と BE の webserver_port(デフォルトは 8040)が開いていること、およびノードのプロセスが正常に稼働していることを確認してください。
Q: Grafana に Data source is not working と表示されます。どうすればよいですか?
Grafana のデータソース URL が Prometheus の実際の待ち受けアドレスと一致するか確認し、Grafana サーバーからネットワーク経由で Prometheus にアクセスできることを確認してください。
Q: ダッシュボードの一部のグラフが空です。どうすればよいですか?
interval が短すぎないか確認してください(たとえば 15s ではレート型のグラフにデータが表示されない場合があります)。また、Prometheus が該当するジョブのメトリクスを正常に収集しているか確認してください。
Q: YAML 設定ファイルの解析に失敗します。どうすればよいですか?
YAML ではインデントと空白が厳密に扱われます。インデントに Tab 文字が使われていないか、インデントの深さが揃っているか確認してください。
Q: Broker ノードの監視データがありません。どうすればよいですか?
現在のバージョンの Broker は /metrics エンドポイントを提供していません。