リソースグループ: BE ノードの物理的分離とリソースグループ管理
リソースグループは、ストレージとコンピュートを統合したアーキテクチャで、異なるワークロードを物理的に分離する仕組みです。BE ノードにタグを付けてクラスターノードを複数のリソースグループに分け、テーブルのレプリカをグループ間に配置します。これにより、ユーザーや業務ごとに専用の計算リソースとストレージリソースを利用でき、互いに干渉しません。
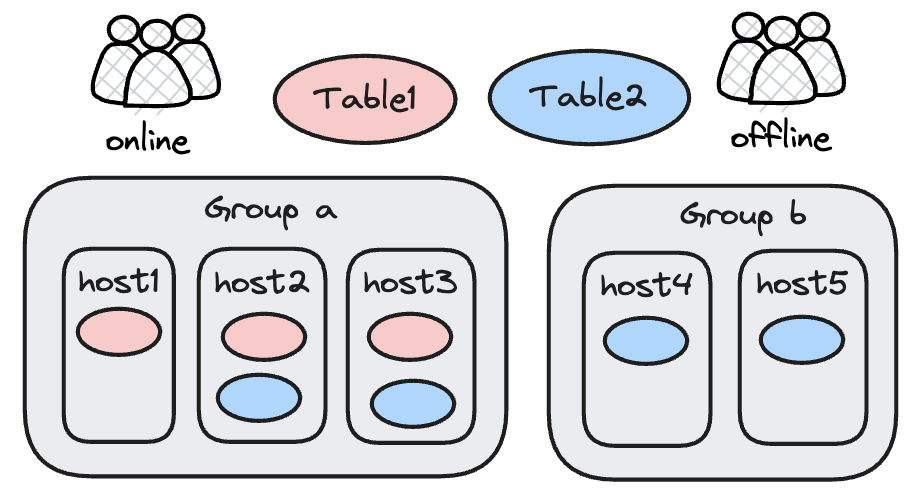
仕組み
リソースグループは、基本的にはテーブルのレプリカ配置ポリシーです。主な仕組みは次のとおりです。
- タグによって BE ノードを異なるグループに分けます。各グループは
group_aやgroup_bなどのタグ名で識別します。 - テーブルのレプリカを異なるリソースグループに配置します。たとえば、table1 の 3 個のレプリカをすべて group_a に配置し、table2 の 4 個のレプリカのうち 2 個を group_a、残りの 2 個を group_b に配置できます。
- クエリ実行時には、ユーザーに紐付けられたリソースグループによって、そのグループ内のノードにあるレプリカと計算リソースだけを使用できます。
利点と制約:
| 項目 | 説明 |
|---|---|
| 障害の分離 | リソースグループごとに独立した BE を使用します。あるグループで BE に障害が発生しても、他のグループのクエリには影響しません |
| ロードの制約 | ロードでは複数のレプリカへの書き込みが成功する必要があります。残りのレプリカがクォーラム要件を満たさない場合、ロードは失敗します |
| ストレージのオーバーヘッド | 各リソースグループに、テーブルのレプリカが少なくとも一つ必要です。リソースグループが増えるほど、保存するレプリカも増えます |
代表的なユースケース
| シナリオ | 説明 |
|---|---|
| 読み書きの分離 | クラスターを Online と Offline の二つのリソースグループに分けます。Online は高並行・低レイテンシーのクエリを処理し、Offline は ETL ジョブを処理します。データは 3 個のレプリカで保存し、そのうち 2 個を Online グループ、1 個を Offline グループに配置します |
| 複数の業務の分離 | 複数の業務部門がデータを共有しない場合に、業務部門ごとに独立したリソースグループを割り当てます。複数の物理クラスターを一つの大きなクラスターに統合して、一元管理する構成に相当します |
| 複数のユーザーの分離 | 複数のユーザーが同じ業務テーブルを共有しつつ、リソース競合を避けるために独立したリソースグループを使用します。テーブルのレプリカを複数作成して、それぞれを対応するリソースグループに配置し、各ユーザーを自身のリソースグループに紐付けます |
リソースグループの設定
前提条件
- 複数の BE ノードを持ち、ストレージとコンピュートを統合したモードでデプロイされた Doris クラスター。
ALTER SYSTEM権限(通常は admin ユーザーが保有します)。
手順の概要
- BE ノードにタグを設定し、リソースグループに分けます。
- テーブルを作成または変更する際に、リソースグループ間のレプリカ分散ポリシーを指定します。
- ユーザーをリソースグループに紐付けて、クエリで利用できる範囲を制限します。
ステップ 1: BE ノードにタグを設定する
現在のクラスターに 6 台の BE ノード(host1 から host6)があるとします。初期状態では、すべてのノードがデフォルトのリソースグループ(Default)に属しています。
6 台のノードを 3 つのリソースグループに分けます。
alter system modify backend "host1:9050" set ("tag.location" = "group_a");
alter system modify backend "host2:9050" set ("tag.location" = "group_a");
alter system modify backend "host3:9050" set ("tag.location" = "group_b");
alter system modify backend "host4:9050" set ("tag.location" = "group_b");
alter system modify backend "host5:9050" set ("tag.location" = "group_c");
alter system modify backend "host6:9050" set ("tag.location" = "group_c");
実行後、host[1-2] は group_a、host[3-4] は group_b、host[5-6] は group_c に属します。
注意: BE が属せるリソースグループは一つだけです。
ステップ 2: リソースグループごとにレプリカを分散する
リソースグループを定義したら、テーブルの作成時に replication_allocation プロパティを設定し、各リソースグループに保存するレプリカ数を指定します。
例: UserTable の 3 個のレプリカを、3 つの異なるリソースグループに配置します。
create table UserTable
(k1 int, k2 int)
distributed by hash(k1) buckets 1
properties(
    "replication_allocation"="tag.location.group_a:1, tag.location.group_b:1, tag.location.group_c:1"
)
実行後、UserTable のデータは、それぞれ group_a、group_b、group_c のノード上に 3 個のレプリカとして保存されます。
この時点のノードのグループ分けとデータ配置は次のとおりです。
┌────────────────────────────────────────────────────┐
│                                                    │
│         ┌──────────────────┐  ┌──────────────────┐ │
│         │ host1            │  │ host2            │ │
│         │  ┌─────────────┐ │  │                  │ │
│ group_a │  │   replica1  │ │  │                  │ │
│         │  └─────────────┘ │  │                  │ │
│         │                  │  │                  │ │
│         └──────────────────┘  └──────────────────┘ │
│                                                    │
├────────────────────────────────────────────────────┤
├────────────────────────────────────────────────────┤
│                                                    │
│         ┌──────────────────┐  ┌──────────────────┐ │
│         │ host3            │  │ host4            │ │
│         │                  │  │  ┌─────────────┐ │ │
│ group_b │                  │  │  │   replica2  │ │ │
│         │                  │  │  └─────────────┘ │ │
│         │                  │  │                  │ │
│         └──────────────────┘  └──────────────────┘ │
│                                                    │
├────────────────────────────────────────────────────┤
├────────────────────────────────────────────────────┤
│                                                    │
│         ┌──────────────────┐  ┌──────────────────┐ │
│         │ host5            │  │ host6            │ │
│         │                  │  │  ┌─────────────┐ │ │
│ group_c │                  │  │  │   replica3  │ │ │
│         │                  │  │  └─────────────┘ │ │
│         │                  │  │                  │ │
│         └──────────────────┘  └──────────────────┘ │
│                                                    │
└────────────────────────────────────────────────────┘
データベース単位で共通のレプリカポリシーを設定する
データベースに多数のテーブルがある場合、テーブルごとにレプリカポリシーを変更するのは手間がかかります。Doris では、データベース単位で共通のレプリカ分散ポリシーを設定できます。テーブル単位の設定は、データベース単位の設定より優先されます。
例: db1 には 4 つのテーブルがあります。table1 には専用のレプリカポリシーが必要で、残りの 3 つのテーブルはデータベースのデフォルトポリシーを使用します。
デフォルトのレプリカポリシーを group_c:1, group_b:2 として db1 を作成します。
CREATE DATABASE db1 PROPERTIES (
    "replication_allocation" = "tag.location.group_c:1, tag.location.group_b:2"
)
table1 を作成し、そのポリシーを group_a:1, group_b:2 で上書きします。
CREATE TABLE table1
(k1 int, k2 int)
distributed by hash(k1) buckets 1
properties(
    "replication_allocation"="tag.location.group_a:1, tag.location.group_b:2"
)
table2、table3、table4 の CREATE TABLE 文では replication_allocation を指定する必要はありません。これらのテーブルは db1 のポリシーを自動的に継承します。
データベースのレプリカ分散ポリシーを変更しても、既存のテーブルには影響しません。
ステップ 3: ユーザーをリソースグループに紐付ける
set property 文を使うと、ユーザーが指定したリソースグループ内のノードでのみクエリを実行できるように制限できます。
set property for 'user1' 'resource_tags.location' = 'group_a';
set property for 'user2' 'resource_tags.location' = 'group_b';
set property for 'user3' 'resource_tags.location' = 'group_a, group_b, group_c';
この設定後、user1 が UserTable をクエリすると、group_a 内のノード上のレプリカにのみアクセスし、group_a の計算リソースだけを使用します。user3 は、どのリソースグループのレプリカと計算リソースも使用できます。
バージョンによる違い:
| バージョン | デフォルトの動作 |
|---|---|
| 2.0.2 以前 | ユーザーの resource_tags.location が空の場合、タグによる制限を受けず、どのリソースグループも使用できます |
| 2.0.3 以降 | 通常のユーザーはデフォルトで default リソースグループのみを使用できます。root ユーザーと admin ユーザーは、どのリソースグループも使用できます |
resource_tags.location プロパティを変更した後、その変更を反映するにはユーザーが再接続する必要があります。
ロードジョブへのリソースグループの割り当て
ロードジョブ(INSERT、Broker Load、Routine Load、Stream Load など)で使用するリソースは、次の二つに分かれます。
| リソースの種類 | 役割 | リソースグループによる制限 |
|---|---|---|
| 計算リソース | データソースの読み取り、データの変換と分散 | あり。リソースグループによって、使用できる計算リソースの範囲が制限されます |
| 書き込みリソース | データのエンコード、圧縮、ディスクへの書き込み | なし。書き込みリソースはレプリカが配置されたノードによって決まり、制限できません |
書き込み処理はデータのレプリカがあるノードで実行する必要があります。一方、計算リソースには任意のノードを選択できます。そのため、リソースグループが制限できるのは、ロードジョブの計算部分だけです。