ピアキャッシュ読み取り:他の BE やコンピュートグループから File Cache を読み取る(コンピュートとストレージの分離)
ピアキャッシュ読み取りは、コンピュートとストレージを分離したモードで、File Cache に目的のブロックがない場合に使用されます。BE のローカル File Cache にブロックがない場合、まず同じコンピュートグループまたは別のコンピュートグループにある他の BE の File Cache に問い合わせます。他の BE にもブロックがない場合にのみ、オブジェクトストレージから読み取ります。影響するのはコールドリードの経路だけで、ローカルキャッシュにヒットする読み取りは変わりません。
コンピュートグループをまたぐピアキャッシュ読み取りは、Doris 4.2.0 から実験的機能として利用でき、デフォルトでは無効です。使用するには、対象の BE で enable_cache_read_from_peer = true を明示的に設定してください。
ユースケース
| シナリオ | ピア読み取りの動作 | 利点 |
|---|---|---|
| コンピュートグループ内でのスケールアウト | スケールアウトやタブレットのリバランス後、新しい BE での最初の読み取りは、オブジェクトストレージではなく、以前そのタブレットを処理していた BE からキャッシュ済みブロックを取得する | リバランス後の性能低下を短縮し、オブジェクトストレージへのトラフィックを削減できる |
| コンピュートグループをまたぐコールドリード | 現在のコンピュートグループにキャッシュがなく、別のグループが同じデータをすでに読み取っている場合、そのグループの BE からブロックを読み取る | コールドクエリのレイテンシーを抑え、オブジェクトストレージからの読み取りを減らせる |
| グループをまたぐフィル | 「フィル用コンピュートグループ」を指定する。その BE にもブロックがない場合、BE はオブジェクトストレージからブロックを取得し、自身の File Cache に書き込んでから、要求元の BE に返す | 指定したグループがオブジェクトストレージへのアクセスを担い、キャッシュにもコピーを保持する |
性能の参考値
TPC-H の 1 TB データセットを使ったコールドリードのテストでは、ピアキャッシュ読み取りはオブジェクトストレージから直接読み取る場合の約2倍の速さでした。実際の改善幅は、他の BE がすでにデータを保持しているかどうか、およびピア間のネットワークレイテンシーとオブジェクトストレージのレイテンシーの差によって変わります。
前提条件
- コンピュートとストレージを分離したデプロイメント。統合モードではピア読み取りは機能しません。
- すべての BE で File Cache が有効であること(
enable_file_cache = true)。 enable_cache_read_from_peer = trueを明示的に設定すること(デフォルトはfalse)。- グループをまたぐフィルを使用する場合は、フィル用コンピュートグループの ID(
compute_group_id)。確認方法はフィル用コンピュートグループの指定を参照してください。
制限事項
- Doris の内部テーブルのみをサポートします。外部テーブル(Hive、Iceberg など)のデータキャッシュではピア読み取りは使用されません。
- ピア読み取りは、ローカルの File Cache にブロックがない場合にのみ実行されます。ウォームアップジョブによる読み取りや、フィルサーバー自身が行うオブジェクトストレージからの読み取りが、再びピア読み取りを経由することはありません。
enable_cache_read_from_peerは、同じグループ内とグループをまたぐピア読み取りの両方を制御します。現在、同じグループ内のピア読み取りを維持しながら、グループをまたぐピア読み取りだけを無効にすることはできません。 候補は FE から取得され、他のコンピュートグループの BE も含まれます。- フィルサーバーは、小さなファイルのマージによって生成されたファイル(Packed File)をまだサポートしていません。このような要求は通常どおりオブジェクトストレージにフォールバックします。
- 複数の AZ にまたがるデプロイメントでは、グループをまたぐピア読み取りによって AZ 間のネットワークトラフィックが発生し、追加費用がかかる場合があります。
- ピア読み取りはベストエフォートです。ピアから読み取るかどうか、どの BE から読み取るかは、候補リスト、タイムアウト、フォールバックの処理によって決まります。
動作の仕組み
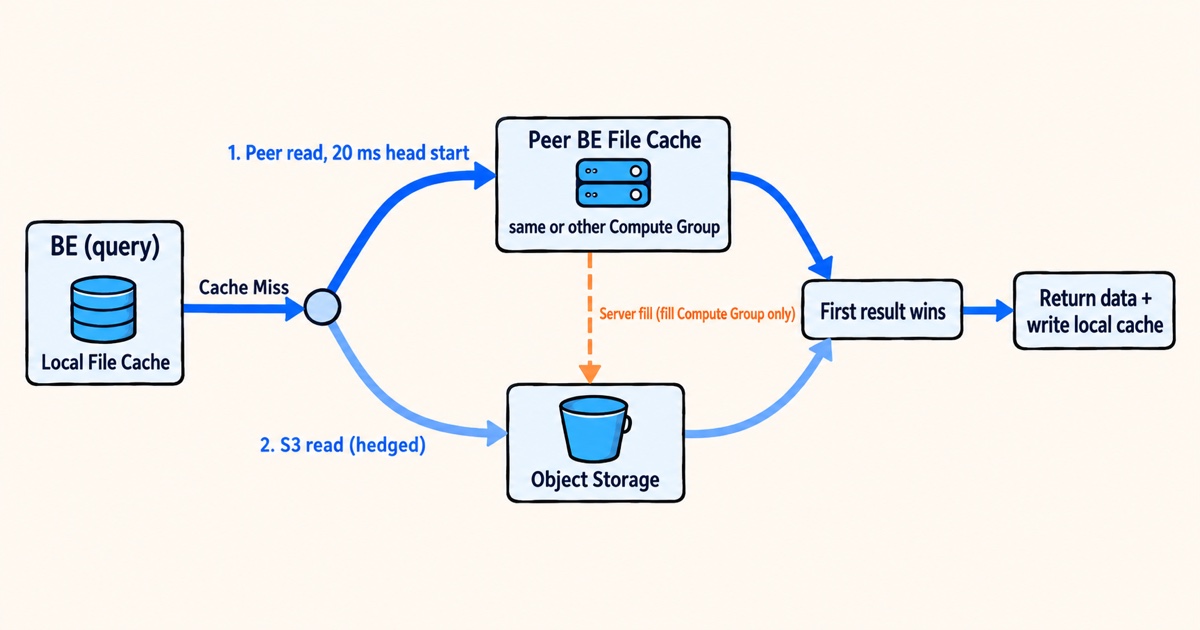
読み取り経路
- ブロックを読み取るクエリは、最初にローカルの File Cache を確認し、ヒットした場合はそのデータを返します。
- ブロックがない場合、BE はそのタブレットのピア候補をすでに保持しているか確認します。候補がなければ、この読み取りはオブジェクトストレージに直接進み、BE はバックグラウンドで FE に候補を問い合わせます。現在の要求は候補の取得を待ちません。
- 候補がある場合、ピア読み取りとオブジェクトストレージからの読み取りを競わせます(
enable_peer_s3_race。デフォルトで有効)。BE は先にピア読み取りを送信し、peer_race_hedge_delay_ms(デフォルト 20 ms)の先行時間を与えます。その間にピアから応答があれば、オブジェクトストレージへの読み取りは送信されません。 - 先に結果を返した方が採用されます。どちらの場合もデータはローカルの File Cache に書き込まれるため、以降の読み取りはローカルでヒットします。
- ピア読み取りに失敗した場合、オブジェクトストレージにフォールバックし、クエリはエラーになりません。失敗には、候補がブロックを保持していない場合、RPC エラー、同時実行枠が埋まっている場合、タイムアウトが含まれます。
enable_peer_s3_race が無効な場合、または同時に競わせる読み取りの数が max_concurrent_peer_races(デフォルト 64)を超えた場合、BE は順番に読み取ります。候補を順に試し、すべて失敗した後にのみオブジェクトストレージから読み取ります。
通常、コールドクエリでは多数の読み取りが同時に発生します。セグメントフッターの最初の読み取りで候補の取得が始まるため、同じクエリ内で同じタブレットを後から読み取る際にはピア読み取りを使用できます。最初のコールドリードがオブジェクトストレージに進むのは想定どおりの動作です。
候補の取得元
| 取得元 | 説明 | 優先度 |
|---|---|---|
| リバランス元の BE | コンピュートグループのスケールアウトやタブレットのリバランス中、FE が移動先の BE に送るウォームアップ要求によって、移動元の BE が候補として記録される。balance_type が without_warmup の場合はウォームアップ要求が送信されず、候補も記録されない | 最優先 |
| FE が返すタブレットの配置情報 | ローカルに候補がない場合、BE は各コンピュートグループでそのタブレットを保持する BE をバックグラウンドで FE に問い合わせ、リストの末尾に追加する | 低い |
| 手動設定 | HTTP インターフェース /api/peer_cache?op=set から書き込む(タブレットのピア情報の確認と調整を参照)。通常はテストとトラブルシューティングにのみ使用する | 書き込んだ順 |
候補の選択と順序の変更
- BE は各タブレットへの読み取りを最後に成功させたコンピュートグループを記憶し、そのグループの候補を最初に試します。
- ブロックを保持していない候補はリストの末尾に移動されるため、次の読み取りでは別の候補を試します。RPC が
peer_rpc_failure_eviction_threshold(デフォルト 3)回連続で失敗した候補は除外されます。 - すべての候補でブロックが見つからない読み取りが
peer_all_miss_cooldown_threshold(デフォルト 5)回連続すると、タブレットはpeer_all_miss_cooldown_duration_s(デフォルト 300 秒)のクールダウンに入ります。クールダウン中の読み取りは、オブジェクトストレージに直接進みます。 peer_candidate_expiry_s(デフォルト 3600 秒)の間使用されなかった候補エントリはメモリから削除されます。次にブロックが見つからなかったとき、FE から候補を再取得します。
バージョン 4.2.0 以降、ピア読み取りでは、タブレット間で共有するアドレス単位のサーキットブレーカーを使用します。あるアドレスへの接続または RPC が cache_peer_read_failure_threshold 回連続で失敗すると(デフォルトは 3、有効な最小値は 1)、そのアドレスへの読み取りは cache_peer_read_circuit_open_seconds 秒間停止します(デフォルトは 30、負の値は 0 として扱います)。その期間が過ぎると、復旧確認のための要求が1件だけ許可されます。この仕組みは、タブレットの候補の除外や、すべての候補でブロックが見つからなかった後のクールダウンとは独立して動作します。
グループをまたぐフィル
要求元の BE に peer_cache_fill_compute_group_id が設定されており、選択された候補がそのコンピュートグループに属する場合、要求にはフィルフラグが付けられます。受信側の BE がブロックを保持しておらず、enable_peer_server_cache_fill が有効な場合(デフォルト)、受信側の BE はオブジェクトストレージからブロックを読み取り、自身の File Cache に書き込んでから返します。
フィルには max_concurrent_peer_server_fills(デフォルト 32)による同時実行数の上限と、peer_server_cache_fill_timeout_ms(デフォルト 6000 ms)によるタイムアウトがあります。上限に達した場合やフィルがタイムアウトした場合、要求元の BE はオブジェクトストレージにフォールバックします。
設定
以下のパラメータはすべて BE の設定です。スレッドプールのパラメータを除き、実行時に変更できます。詳細は実行時のパラメータ変更を参照してください。
ピア読み取りの確認または無効化
ピア読み取りはデフォルトで無効です。使用するには、File Cache を有効にし、BE の be.conf で enable_cache_read_from_peer=true を設定するか、後述する動的設定エンドポイントを使用します。同じグループ内とグループをまたぐ読み取りは同時に有効になり、FE が候補を自動的に提供します。MySQL クライアントから現在の値を確認します。
SHOW BACKEND CONFIG LIKE 'enable_cache_read_from_peer';
無効にするには、すべての BE の be.conf に次を設定します。
enable_cache_read_from_peer = false
無効にすると、ローカルにブロックがない場合はオブジェクトストレージに直接進み、peer_read_async_warmup など、ピア読み取りに依存するバランス調整戦略は効果を失います。
フィル用コンピュートグループの指定
グループをまたぐコールドリード時に、特定のコンピュートグループにオブジェクトストレージからの取得と自身のキャッシュへのフィルを担当させるには、次の手順で設定します。
-
対象コンピュートグループの ID を確認します。
SHOW BACKENDSのTag列にあるcompute_group_idがコンピュートグループ ID です。compute_group_nameではありません。SHOW BACKENDS\G*************************** 1. row ***************************
BackendId: 10001
Host: 10.0.0.1
...
Tag: {"cloud_unique_id" : "1:xxx:yyy", "compute_group_id" : "cg_write_01", "compute_group_name" : "write_group", "compute_group_status" : "NORMAL", "location" : "default"} -
クエリを実行するコンピュートグループのすべての BE に、次を設定します。
peer_cache_fill_compute_group_id = cg_write_01 -
フィル用コンピュートグループの BE で、
enable_peer_server_cache_fillがtrue(デフォルト)であることを確認します。
実行時のパラメータ変更
スレッドプールのパラメータを除き、このページのすべてのパラメータは実行時に変更できます。変更を be_custom.conf に保存するには、persist=true を追加します。
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?enable_cache_read_from_peer=false&persist=true"
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?peer_race_hedge_delay_ms=30"
パラメータ
有効化と競合読み取り
| パラメータ | デフォルト | 説明 |
|---|---|---|
enable_cache_read_from_peer | false | ピア読み取りの主スイッチ。有効にすると、ローカルの File Cache にブロックがない場合、同じコンピュートグループと他のコンピュートグループの BE を先に試す |
enable_peer_s3_race | true | ピア読み取りとオブジェクトストレージからの読み取りを競わせるかどうか。無効な場合は候補を順に試し、すべて失敗した後にのみオブジェクトストレージから読み取る |
peer_race_hedge_delay_ms | 20 | ピア読み取りに与える先行時間(ミリ秒)。その間にピアから応答があれば、オブジェクトストレージへの読み取りは送信されない。0 にすると両方を同時に開始する |
max_concurrent_peer_races | 64 | 単一 BE で同時に競わせる読み取りの最大数。この上限を超えた読み取りは順番に処理される |
フィル設定
| パラメータ | デフォルト | 説明 |
|---|---|---|
peer_cache_fill_compute_group_id | "" | 要求元に設定する。フィルを担当するコンピュートグループの ID(名前ではなく compute_group_id)。選択した候補がこのグループに属する場合、要求にフィルフラグが付く |
enable_peer_server_cache_fill | true | 提供側に設定する。フィルフラグ付きの要求を受け付けるかどうか。ブロックがローカルにキャッシュされていなければ、オブジェクトストレージから読み取り、ローカルの File Cache に書き込んで返す |
peer_server_cache_fill_timeout_ms | 6000 | 提供側で単一のフィルを待つ最大時間(ミリ秒)。タイムアウトすると要求元はオブジェクトストレージにフォールバックする |
max_concurrent_peer_server_fills | 32 | 提供側で同時に実行できるフィルの最大数。上限を超えた要求は拒否され、要求元はオブジェクトストレージにフォールバックする |
候補の管理
| パラメータ | デフォルト | 説明 |
|---|---|---|
peer_rpc_failure_eviction_threshold | 3 | RPC がこの回数だけ連続で失敗すると、候補を除外する |
peer_all_miss_cooldown_threshold | 5 | すべての候補でブロックが見つからない読み取りが何回連続すると、タブレットがクールダウンに入るか |
peer_all_miss_cooldown_duration_s | 300 | クールダウンの長さ(秒)。クールダウン中、そのタブレットの読み取りはオブジェクトストレージに直接進む |
peer_candidate_expiry_s | 3600 | 候補エントリの有効期限(秒)。最後の使用時点から計測する。期限切れのエントリは削除され、次にブロックが見つからなかったときに FE から再取得される |
peer_candidate_cleanup_interval_s | 3600 | 期限切れ候補を削除するバックグラウンドジョブの実行間隔(秒) |
スレッドプールとキュー
| パラメータ | デフォルト | 説明 |
|---|---|---|
peer_fetch_queue_timeout_ms | 100 | 提供側。ピア読み取り要求が処理キューでこの時間(ミリ秒)を超えて待つと拒否し、要求元が速やかにオブジェクトストレージへフォールバックできるようにする |
brpc_peer_fetch_pool_threads | -1 | 提供側。ピア読み取り要求を処理するスレッド数。ロードなどの負荷が高い RPC から分離されている。-1 は max(64, 2 × CPU cores) を意味する。静的パラメータで、変更には BE の再起動が必要 |
brpc_peer_fetch_pool_max_queue_size | -1 | このスレッドプールのキュー長。-1 は max(4096, 128 × CPU cores) を意味する。静的パラメータ |
min_peer_race_s3_thread_num / max_peer_race_s3_thread_num | 0 / 32 | 要求元。競合読み取り中にオブジェクトストレージからの読み取りを行うスレッドプールのサイズ。静的パラメータ |
副作用と注意点
グループをまたぐピア読み取りは、コンピュートグループ間の分離を弱めます。あるグループのクエリが別のグループのネットワーク、ディスク、File Cache の読み取り能力を使用します。フィルを設定している場合は、別のグループがそのクエリのためにオブジェクトストレージの帯域幅も消費します。クエリが消費するリソースは、そのクエリ自身のコンピュートグループ内に収まらなくなります。
フィルは提供側 BE のローカル File Cache にデータを書き込むため、その BE が使用する頻度の高いデータをキャッシュから追い出す可能性があります。
競合読み取りを有効にすると、一部のキャッシュミスでは、短時間ながらピア RPC とオブジェクトストレージからの読み取りの両方が発生します。20 ms の先行時間はこの重複を減らしますが、なくすことはできません。
ピアへのヒットは保証されません。提供側で同時実行枠やフィル枠が埋まっている場合、ブロックがない場合、タイムアウトした場合は、いずれもオブジェクトストレージにフォールバックします。競合読み取りが有効な場合、コールドクエリは通常、オブジェクトストレージから直接読み取る場合より遅くなりませんが、必ず速くなるわけでもありません。
複数の AZ にまたがるデプロイメントでは、グループをまたぐピア読み取りに AZ 間トラフィックの料金がかかります。
可観測性とトラブルシューティング
クエリプロファイルのカウンター
ピア読み取りのカウンターは、プロファイルの SegmentIterator ノードにあり、他の File Cache カウンターと並んでいます。プロファイルの取得方法と読み方はクエリプロファイルを参照してください。
| カウンター | 意味 | 確認できること |
|---|---|---|
NumPeerIOTotal | ピアから提供された読み取りの回数 | クエリがピア読み取りを使用したかどうか |
PeerIOUseTimer | ピア読み取り経路で費やした合計時間 | ピア経路自体が遅いかどうか |
SameCGPeerIOTotal / SameCGPeerBytesRead / SameCGPeerIOTime | 同じグループ内でのピア読み取りの回数、バイト数、所要時間 | ピア読み取りの大半がコンピュートグループ内で完結しているかどうか |
CrossCGPeerIOTotal / CrossCGPeerBytesRead / CrossCGPeerIOTime | グループをまたぐピア読み取りの回数、バイト数、所要時間 | グループをまたぐ読み取りが発生したか、どれだけのトラフィックが生じたか |
PeerRaceWin / S3RaceWin | ピア/オブジェクトストレージが競合読み取りに勝った回数。enable_peer_s3_race = true の場合のみ意味がある | S3RaceWin の方が大幅に多ければ、この環境ではピア経路の方が速いわけではない |
PeerLazyFetch / PeerLazyFetchTime | タブレットに候補がない場合に始まる、FE からのバックグラウンドでの候補取得の回数と所要時間 | 最初の読み取りがピアに向かわなかった理由 |
PeerCacheNodes | クエリが実際に読み取ったピアノード | データの取得元となった BE |
InvertedIndexNumPeerIOTotal / InvertedIndexPeerIOUseTimer と SegmentFooterIndexNumPeerIOTotal / SegmentFooterIndexPeerIOUseTimer は、それぞれ転置インデックスファイル、およびセグメントフッターと内部インデックスについて、ピア読み取りの回数と所要時間を記録します。インデックスの読み取りでもピアにヒットしたかどうかを確認できます。
BE の bvar メトリクス
curl http://<be_host>:<brpc_port>/vars で確認します(brpc_port のデフォルトは 8060)。要求元(読み取りを実行する BE)のメトリクスは次のとおりです。
| メトリクス | 意味 |
|---|---|
cached_remote_reader_peer_read | 実行されたピア読み取りの回数 |
cached_remote_reader_s3_read | 実行されたオブジェクトストレージからの読み取りの回数 |
peer_race_peer_win / peer_race_s3_win | ピア/オブジェクトストレージが競合読み取りに勝った回数 |
peer_same_compute_group_read / peer_cross_compute_group_read | 成功した、同じグループ内/グループをまたぐピア読み取りの回数 |
peer_lazy_fetch_triggered | FE からのバックグラウンドでの候補取得の回数 |
peer_cache_reader_peer_latency | ピア RPC のレイテンシー |
提供側(キャッシュを提供する BE)のメトリクスは次のとおりです。
| メトリクス | 意味 |
|---|---|
file_cache_get_by_peer_num / file_cache_get_by_peer_success_num / file_cache_get_by_peer_failed_num | 受信したピア読み取り要求の数と、成功数・失敗数 |
file_cache_get_by_peer_queue_timeout_num | キュー内で peer_fetch_queue_timeout_ms を超えて待ったために拒否された要求の数 |
peer_server_fill_requested / peer_server_fill_success | 要求されたフィルと完了したフィルの数 |
peer_server_fill_timeout / peer_server_fill_rejected | タイムアウトしたフィルと、空き枠がないため拒否されたフィルの数 |
値の読み方は次のとおりです。
cached_remote_reader_peer_readが多く、cached_remote_reader_s3_readが少ない場合、全体としてピア読み取りが機能しています。peer_race_s3_winがpeer_race_peer_winを明らかに上回る場合、この環境ではピア経路の方が速いわけではありません。peer_race_hedge_delay_msを増やすか、ピア読み取りを無効にします。peer_cross_compute_group_readが多い場合、グループをまたぐトラフィックが発生しています。グループ間の分離への影響を確認してください。peer_server_fill_requestedが多い一方でpeer_server_fill_successが少なく、peer_server_fill_timeoutが多い場合、フィル用コンピュートグループに過負荷または設定ミスが生じています。
タブレットのピア情報の確認と調整
BE は、単一のタブレットの候補を表示・変更するために、webserver_port(デフォルト 8040)で /api/peer_cache を公開しています。主にトラブルシューティングに使用します。
タブレットの候補、最後に読み取りに成功したコンピュートグループ、連続してブロックが見つからなかった回数、クールダウン状態を表示します。
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show&tablet_id=<tablet_id>"
{
    "tablet_id": 10086,
    "candidates": [
        {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01", "last_access_time_ms": 1758441600000, "consecutive_rpc_failures": 0}
    ],
    "last_successful_compute_group_id": "cg_write_01",
    "fetching_from_fe": false,
    "consecutive_all_miss": 0,
    "cooldown_until_ms": 0
}
この BE 上で候補を持つすべてのタブレットを一覧表示します。limit のデフォルトは 1000 です。
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show_all&limit=100"
タブレットの候補を強制的に設定します(JSON のリクエストボディ)。
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=set&tablet_id=<tablet_id>" \
    -H "Content-Type: application/json" \
    -d '{
        "candidates": [
            {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01"}
        ],
        "last_successful_compute_group_id": "cg_write_01",
        "consecutive_all_miss": 0,
        "cooldown_until_ms": 0
    }'
タブレットの候補を削除するか、クールダウンを解除します。
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=remove&tablet_id=<tablet_id>"
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=reset_cooldown&tablet_id=<tablet_id>"
ベストプラクティス
- キャッシュウォームアップと併用します。ウォームアップは事前にオブジェクトストレージからデータを取得し、ピア読み取りはクエリ実行時に他の BE から取得します。既知の使用頻度が高いデータはウォームアップで準備し、ウォームアップで取得しなかったデータのコールドリードはピア読み取りで処理します。
- スケーリング前にピア読み取りを有効にしておきます。スケールアウトやタブレットのリバランス後、新しい BE は移動元 BE のキャッシュを再利用できます。
balance_type = peer_read_async_warmupと組み合わせると、マッピングが直ちに切り替わり、ピア読み取りが切り替え時の性能変動を抑えます。詳細はコンピュートグループのスケーリングを参照してください。 - 読み書き分離構成では、書き込み用コンピュートグループをフィル用グループにします。読み取り専用グループでコールドリードが発生した場合、書き込み用グループがオブジェクトストレージからデータを取得し、コピーを保持できます。詳細は読み書き分離における File Cache 最適化のベストプラクティスを参照してください。
- コンピュートグループ間を厳密に分離する必要がある場合や、クラスタが複数の AZ にまたがり、AZ 間トラフィックの料金が問題になる場合は、ピア読み取りを無効にします(
enable_cache_read_from_peer = false)。 - 調整前にメトリクスを確認します。
PeerRaceWin/S3RaceWinと bvar を使ってピアが競合読み取りに勝っているか確認し、peer_race_hedge_delay_msの調整または競合読み取りの無効化を判断します。
よくある質問
Q: 最初のコールドリードがオブジェクトストレージに進んだのはなぜですか?
BE がそのタブレットの候補をまだ保持していない場合、現在の要求は FE からの応答を待ちません。バックグラウンドで候補を取得する間、オブジェクトストレージから読み取ります。同じクエリ内での同じタブレットに対する後続の読み取りや、以降のクエリではピア読み取りを使用できます。プロファイルの PeerLazyFetch が 0 を超えていれば、この状況を示しています。
Q: クエリがピア読み取りを使用したことを確認するには?
プロファイルの NumPeerIOTotal、SameCGPeerIOTotal、CrossCGPeerIOTotal、PeerCacheNodes を確認します。BE では cached_remote_reader_peer_read も増加しているはずです。
Q: コンピュートグループ内のピア読み取りだけを許可し、グループをまたぐピア読み取りを禁止できますか?
現在はできません。enable_cache_read_from_peer が両方のピア読み取りを制御し、FE が返す候補にはすべてのコンピュートグループの BE が含まれます。
Q: ピア読み取りを無効にするには?
すべての BE で enable_cache_read_from_peer = false を設定します。実行時にも変更できます。その後、ローカルにブロックがない場合はオブジェクトストレージから直接読み取ります。
Q: S3RaceWin が PeerRaceWin より大幅に多い場合、どうすればよいですか?
この環境では、通常、ピアとのネットワークレイテンシーやピア BE の高負荷が原因で、ピアからの読み取りがオブジェクトストレージからの読み取りより速くありません。peer_race_hedge_delay_ms を増やしてカウンターを確認するか、ピア読み取りを無効にします。
Q: あるタブレットでピア読み取りが一度も使われません。
/api/peer_cache?op=show&tablet_id=<tablet_id> を実行します。candidates が空なら、候補はまだ取得されていません。cooldown_until_ms がゼロ以外なら、タブレットはクールダウン中です。op=reset_cooldown で解除できます。
Q: グループをまたぐフィルが機能しません。
次の順に確認してください。要求元の peer_cache_fill_compute_group_id に、名前ではなくコンピュートグループ ID を設定していること。選択された候補が実際にそのグループに属していること(op=show の出力にある compute_group_id)。フィル側の enable_peer_server_cache_fill が true であること。そして、peer_server_fill_rejected または peer_server_fill_timeout が増加していないかを確認します。