Arrow Flight SQL に基づく高速データ転送リンク
このドキュメントで説明する Arrow Flight SQL の高速データ転送機能は、現在実験的な機能です。本番環境での使用は推奨しません。使用中に問題が発生した場合は、メーリングリストまたは GitHub Issue で報告してください。
Doris 2.1 以降、Arrow Flight SQL プロトコルに基づく高速データ転送リンクが実装され、複数の言語から SQL を使用して Doris の大量のデータを高速に読み取れるようになりました。MySQL Client や JDBC/ODBC ドライバーを使う方法と比べ、シナリオによっては性能が数十倍から数百倍向上します。Arrow Flight SQL は、同じプロトコルに対応するデータベースとシームレスに連携できる汎用 JDBC ドライバーも提供します。
適用シナリオ
- 分析のために Doris から大規模なデータを一括エクスポートする場合(MySQL/JDBC プロトコルと比べて数十倍から数百倍の性能向上)。
- 後続のデータ分析で Apache Arrow や Pandas などの列指向形式を使用し、行から列への変換コストを避けたい場合。
- DBeaver などの BI ツールから Arrow Flight SQL プロトコルを使用して Doris にアクセスする場合。
- Spark や Flink などのビッグデータコンポーネントから、Doris のデータを Arrow 形式で高速に読み取る場合。
実装の仕組み
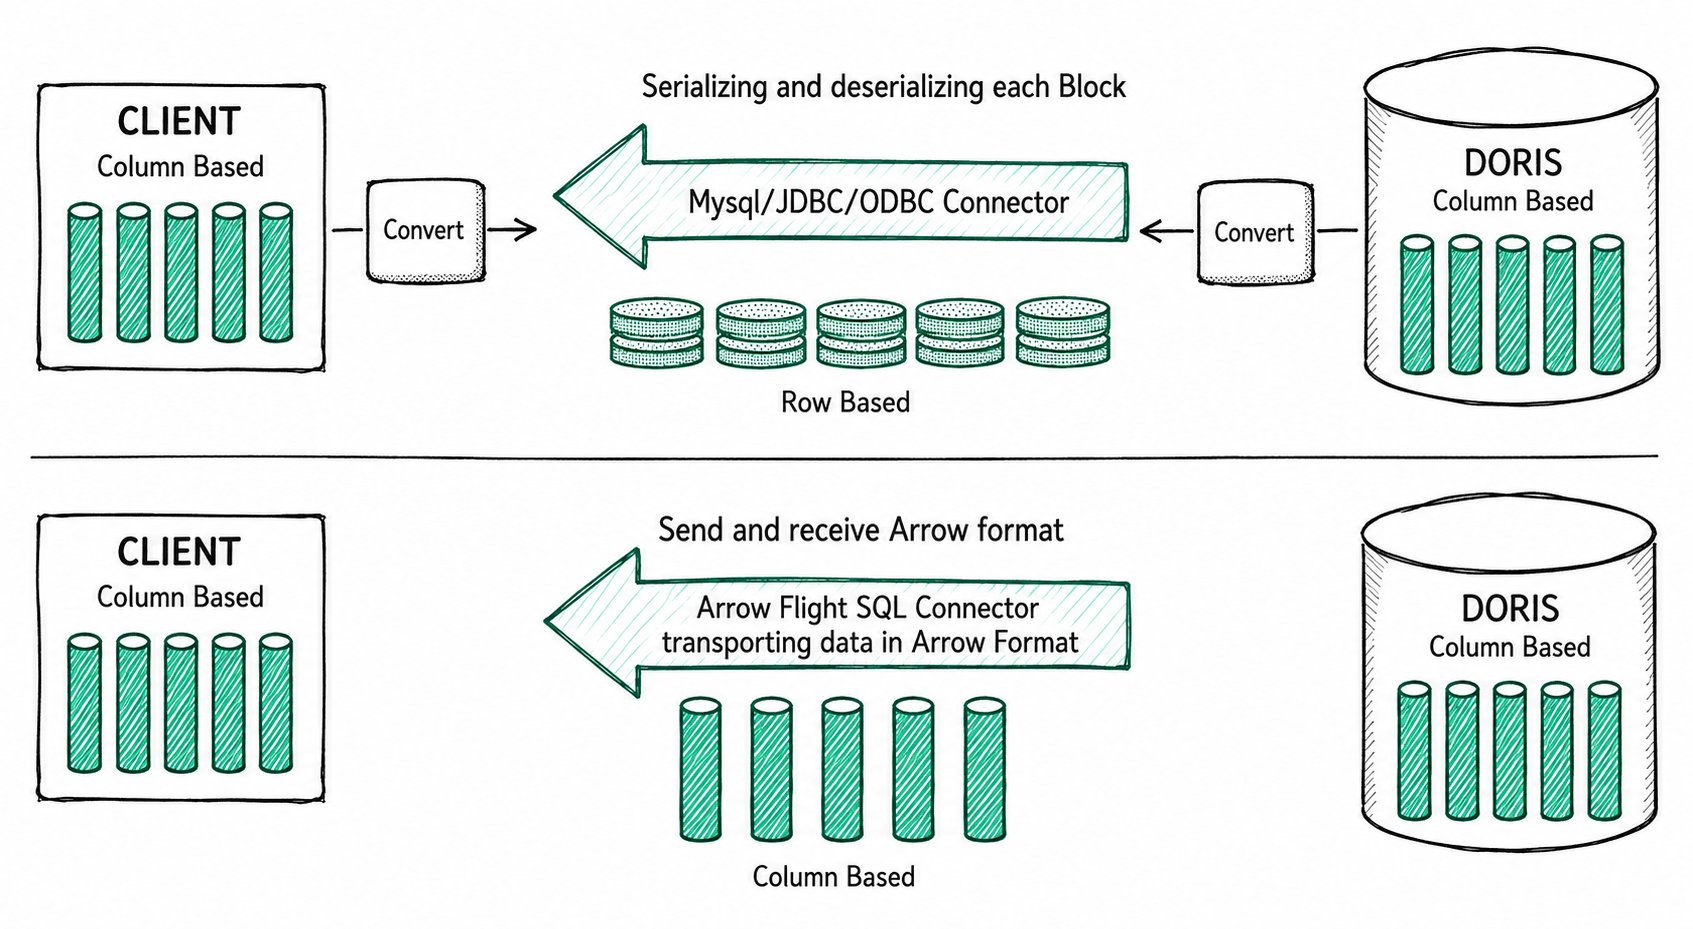
Doris では、クエリ結果は列指向形式の Block として構成されます。2.1 より前のバージョンでは、MySQL Client または JDBC/ODBC ドライバーを介してクエリ結果をクライアントに転送する際、列指向の Block を行ベースの Bytes にシリアライズし、クライアント側で再び列指向形式にデシリアライズする必要がありました。
Arrow Flight SQL に基づく高速データ転送リンクでは、クライアントも Arrow の列指向形式に対応していれば、転送プロセス全体でシリアライズとデシリアライズを完全に回避し、それらに伴う時間と性能のコストをなくせます。
関連資料:
- Apache Arrow の公式インストールチュートリアル:Apache Arrow
- Doris による Arrow Flight プロトコルの実装方法:Doris support Arrow Flight SQL protocol
サーバー側の設定
Arrow Flight SQL を使用する前に、Doris の FE と BE で Arrow Flight SQL サービスを有効にする必要があります。
fe/conf/fe.confのarrow_flight_sql_portを、8070などの使用可能なポートに変更します。be/conf/be.confのarrow_flight_sql_portを、8050などの使用可能なポートに変更します。- クラスターを再起動します。
fe.conf と be.conf に設定する arrow_flight_sql_port は、同じ値にしないでください。
正常に起動したかどうかは、次のように確認します。
| 役割 | ログファイル | キーワード |
|---|---|---|
| FE | fe/log/fe.log | Arrow Flight SQL service is started |
| BE | be/log/be.INFO | Arrow Flight Service bind to host |
4.1.5 以降の型マッピングとリソース解放
バージョン 4.1.5 以降、Arrow スキーマは、ネストされた ARRAY / MAP / STRUCT 値に含まれる子フィールドの論理型メタデータと null 許容属性を保持します。DATETIME にはタイムゾーンのないタイムスタンプを使用し、TIMESTAMPTZ にはセッションのタイムゾーンが付与されたタイムスタンプを使用します(Z は UTC に正規化されます)。それぞれのタイムゾーンの意味に従って解析してください。サポート範囲外のタイムスタンプは、切り捨てやラップアラウンドではなくエラーになります。
読み取りが完了する前に結果ストリームを閉じると、対応するクエリがキャンセルされ、リソースが解放されます。クライアントは Reader / Statement を適切に閉じてください。Coordinator を保持する必要がある外部テーブルのバッチスキャンでは、FE の設定項目 arrow_flight_deferred_query_idle_timeout_second のデフォルトは 3600 秒です。この期限がクエリ実行タイムアウトより短くなることはなく、Coordinator を解放してもセッションは閉じられません。
バージョン 4.1.5 以降、Arrow Flight クエリは MySQL プロトコルの SQL 結果キャッシュと、MySQL のポイントクエリの短絡処理経路を明示的に迂回します。クエリ自体は通常どおり実行されます。
Python での使用方法
Python ADBC Driver を使用して Doris に接続すると、データを非常に高速に読み取れます。必要な Python のバージョンは 3.9 以上です。以下では、DDL、DML、Session 変数の設定、Show 文など、ADBC Driver を使った一般的なデータベース操作を示します。
1. 依存パッケージをインストールする
ADBC Driver は PyPI で公開されており、pip でインストールできます。
pip install adbc_driver_manager
pip install adbc_driver_flightsql
使用するには、コード内で次のモジュールをインポートします。
import adbc_driver_manager
import adbc_driver_flightsql.dbapi as flight_sql

>>> print(adbc_driver_manager.__version__)
1.1.0
>>> print(adbc_driver_flightsql.__version__)
1.1.0
2. 接続を確立する
Doris の Arrow Flight SQL サービスと連携するクライアントを作成する際は、FE Host、Arrow Flight Port、ユーザー名、パスワードを指定する必要があります。
FE と BE の Arrow Flight SQL サービスがそれぞれポート 8070 と 8050 で動作し、ユーザー名とパスワードが user / pass であるとします。接続手順は次のとおりです。
conn = flight_sql.connect(uri="grpc://{FE_HOST}:{fe.conf:arrow_flight_sql_port}", db_kwargs={
            adbc_driver_manager.DatabaseOptions.USERNAME.value: "user",
            adbc_driver_manager.DatabaseOptions.PASSWORD.value: "pass",
        })
cursor = conn.cursor()
接続が確立したら、返された Cursor を使用して SQL 経由で Doris を操作し、テーブルの作成、メタデータの取得、データの取り込み、クエリなどを実行できます。
3. DDL を実行してメタデータを取得する
cursor.execute() 関数に SQL を渡して、テーブルの作成やメタデータの取得を行います。
cursor.execute("DROP DATABASE IF EXISTS arrow_flight_sql FORCE;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("create database arrow_flight_sql;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show databases;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("use arrow_flight_sql;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("""CREATE TABLE arrow_flight_sql_test
    (
         k0 INT,
         k1 DOUBLE,
         K2 varchar(32) NULL DEFAULT "" COMMENT "",
         k3 DECIMAL(27,9) DEFAULT "0",
         k4 BIGINT NULL DEFAULT '10',
         k5 DATE,
    )
    DISTRIBUTED BY HASH(k5) BUCKETS 5
    PROPERTIES("replication_num" = "1");""")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show create table arrow_flight_sql_test;")
print(cursor.fetchallarrow().to_pandas())
StatusResult が 0 を返した場合、クエリは正常に実行されています(この設計は JDBC との互換性のためです)。
  StatusResult
0            0

  StatusResult
0            0

                   Database
0         __internal_schema
1          arrow_flight_sql
..                      ...
507             udf_auth_db

[508 rows x 1 columns]

  StatusResult
0            0

  StatusResult
0            0
                   Table                                       Create Table
0  arrow_flight_sql_test  CREATE TABLE `arrow_flight_sql_test` (\n  `k0`...
4. データを取り込む
INSERT INTO を実行し、作成したテーブルに少量のテストデータを取り込みます。
cursor.execute("""INSERT INTO arrow_flight_sql_test VALUES
        ('0', 0.1, "ID", 0.0001, 9999999999, '2023-10-21'),
        ('1', 0.20, "ID_1", 1.00000001, 0, '2023-10-21'),
        ('2', 3.4, "ID_1", 3.1, 123456, '2023-10-22'),
        ('3', 4, "ID", 4, 4, '2023-10-22'),
        ('4', 122345.54321, "ID", 122345.54321, 5, '2023-10-22');""")
print(cursor.fetchallarrow().to_pandas())
次の出力は、取り込みが成功したことを示します。
  StatusResult
0            0
大量のデータを Doris に取り込む場合は、pydoris を使用して Stream Load を実行することを推奨します。
5. クエリを実行する
先ほどデータをロードしたテーブルに対して、集計、ソート、Set Session Variable 操作を含むクエリを実行します。
cursor.execute("select * from arrow_flight_sql_test order by k0;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("set exec_mem_limit=2000;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show variables like \"%exec_mem_limit%\";")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("select k5, sum(k1), count(1), avg(k3) from arrow_flight_sql_test group by k5;")
print(cursor.fetch_df())
出力:
   k0            k1    K2                k3          k4          k5
0   0       0.10000    ID       0.000100000  9999999999  2023-10-21
1   1       0.20000  ID_1       1.000000010           0  2023-10-21
2   2       3.40000  ID_1       3.100000000      123456  2023-10-22
3   3       4.00000    ID       4.000000000           4  2023-10-22
4   4  122345.54321    ID  122345.543210000           5  2023-10-22

[5 rows x 6 columns]

  StatusResult
0            0

    Variable_name Value Default_Value Changed
0  exec_mem_limit  2000    2147483648       1

           k5  Nullable(Float64)_1  Int64_2 Nullable(Decimal(38, 9))_3
0  2023-10-22         122352.94321        3            40784.214403333
1  2023-10-21              0.30000        2                0.500050005

[2 rows x 5 columns]
データを列指向形式のまま保持するには、次のいずれかの方法でクエリ結果を取得してください。
cursor.fetchallarrow():Arrow 形式を返します。cursor.fetch_df():Pandas DataFrame を直接返します。
cursor.fetchall() は使用しないでください。列指向データを行ベースの形式に戻すため、実質的に mysql-client を使う場合と同じになります。クライアント側で列から行への変換が追加される分、mysql-client より遅くなることもあります。
6. 完全なサンプル
# Doris Arrow Flight SQL Test

# step 1, library is released on PyPI and can be easily installed.
# pip install adbc_driver_manager
# pip install adbc_driver_flightsql
import adbc_driver_manager
import adbc_driver_flightsql.dbapi as flight_sql

# step 2, create a client that interacts with the Doris Arrow Flight SQL service.
# Modify arrow_flight_sql_port in fe/conf/fe.conf to an available port, such as 8070.
# Modify arrow_flight_sql_port in be/conf/be.conf to an available port, such as 8050.
conn = flight_sql.connect(uri="grpc://{FE_HOST}:{fe.conf:arrow_flight_sql_port}", db_kwargs={
            adbc_driver_manager.DatabaseOptions.USERNAME.value: "root",
            adbc_driver_manager.DatabaseOptions.PASSWORD.value: "",
        })
cursor = conn.cursor()

# interacting with Doris via SQL using Cursor
def execute(sql):
    print("\n### execute query: ###\n " + sql)
    cursor.execute(sql)
    print("### result: ###")
    print(cursor.fetchallarrow().to_pandas())

# step3, execute DDL statements, create database/table, show stmt.
execute("DROP DATABASE IF EXISTS arrow_flight_sql FORCE;")
execute("show databases;")
execute("create database arrow_flight_sql;")
execute("show databases;")
execute("use arrow_flight_sql;")
execute("""CREATE TABLE arrow_flight_sql_test
    (
         k0 INT,
         k1 DOUBLE,
         K2 varchar(32) NULL DEFAULT "" COMMENT "",
         k3 DECIMAL(27,9) DEFAULT "0",
         k4 BIGINT NULL DEFAULT '10',
         k5 DATE,
    )
    DISTRIBUTED BY HASH(k5) BUCKETS 5
    PROPERTIES("replication_num" = "1");""")
execute("show create table arrow_flight_sql_test;")


# step4, insert into
execute("""INSERT INTO arrow_flight_sql_test VALUES
        ('0', 0.1, "ID", 0.0001, 9999999999, '2023-10-21'),
        ('1', 0.20, "ID_1", 1.00000001, 0, '2023-10-21'),
        ('2', 3.4, "ID_1", 3.1, 123456, '2023-10-22'),
        ('3', 4, "ID", 4, 4, '2023-10-22'),
        ('4', 122345.54321, "ID", 122345.54321, 5, '2023-10-22');""")


# step5, execute queries, aggregation, sort, set session variable
execute("select * from arrow_flight_sql_test order by k0;")
execute("set exec_mem_limit=2000;")
execute("show variables like \"%exec_mem_limit%\";")
execute("select k5, sum(k1), count(1), avg(k3) from arrow_flight_sql_test group by k5;")

# step6, close cursor
cursor.close()
Java での使用方法
Java 側には接続方法が 3 つあります。それぞれの特徴と選択の目安は次のとおりです。
| 接続方法 | URL の形式 | 戻り値の形式 | 推奨されるシナリオ |
|---|---|---|---|
JDBC (jdbc:arrow-flight-sql) | jdbc:arrow-flight-sql://... | JDBC ResultSet(行) | 後続の分析で行ベースの形式を使用する場合、または BI ツールや既存の JDBC コードとの互換性が必要な場合 |
| Flight ADBC Driver | grpc://... | Arrow(列指向) | 後続の分析で Arrow / 列指向形式を使用し、最高の性能を重視する場合 |
| Flight JDBC Driver (ADBC wrapper) | jdbc:arrow-flight-sql://... | Arrow(列指向) | Flight ADBC Driver と同じ用途で、プロジェクトで jdbc:arrow-flight-sql 形式の URL を使い続ける必要がある場合 |
接続方法ごとの性能を試すには、JDBC/Java Arrow Flight SQL Sample のデモを参照してください。期待される結果は Add Arrow Flight Sql demo for Java に記載されています。Java の Arrow Flight SQL 接続方法と従来の jdbc:mysql の性能比較については、GitHub Issue 25514(セクション 6.2) を参照してください。
補足の推奨事項:
- JDBC の
ResultSetと Arrow データのどちらを解析する場合も、解析にかかる時間はデータの読み取り自体にかかる時間より長くなります。Arrow Flight SQL によるjdbc:mysql://からの改善が限定的な場合は、まずデータの解析処理に時間がかかりすぎていないか確認してください。 - どの接続方法でも、JDK 17 は JDK 1.8 より高速にデータを読み取ります。
- データ量が非常に多い場合、Arrow Flight SQL は
jdbc:mysql://より少ないメモリで動作します。メモリに制約がある場合は、Arrow Flight SQL を先に試してください。 - 上記 3 つの方法に加え、ネイティブの
FlightClientを使用して Arrow Flight Server に直接接続することもできます。こちらは柔軟性が高く、複数の Endpoint からの並列読み取りに対応します。Flight ADBC Driver 自体もFlightClientを基に接続を作成しており、FlightClientを直接使うより簡単です。
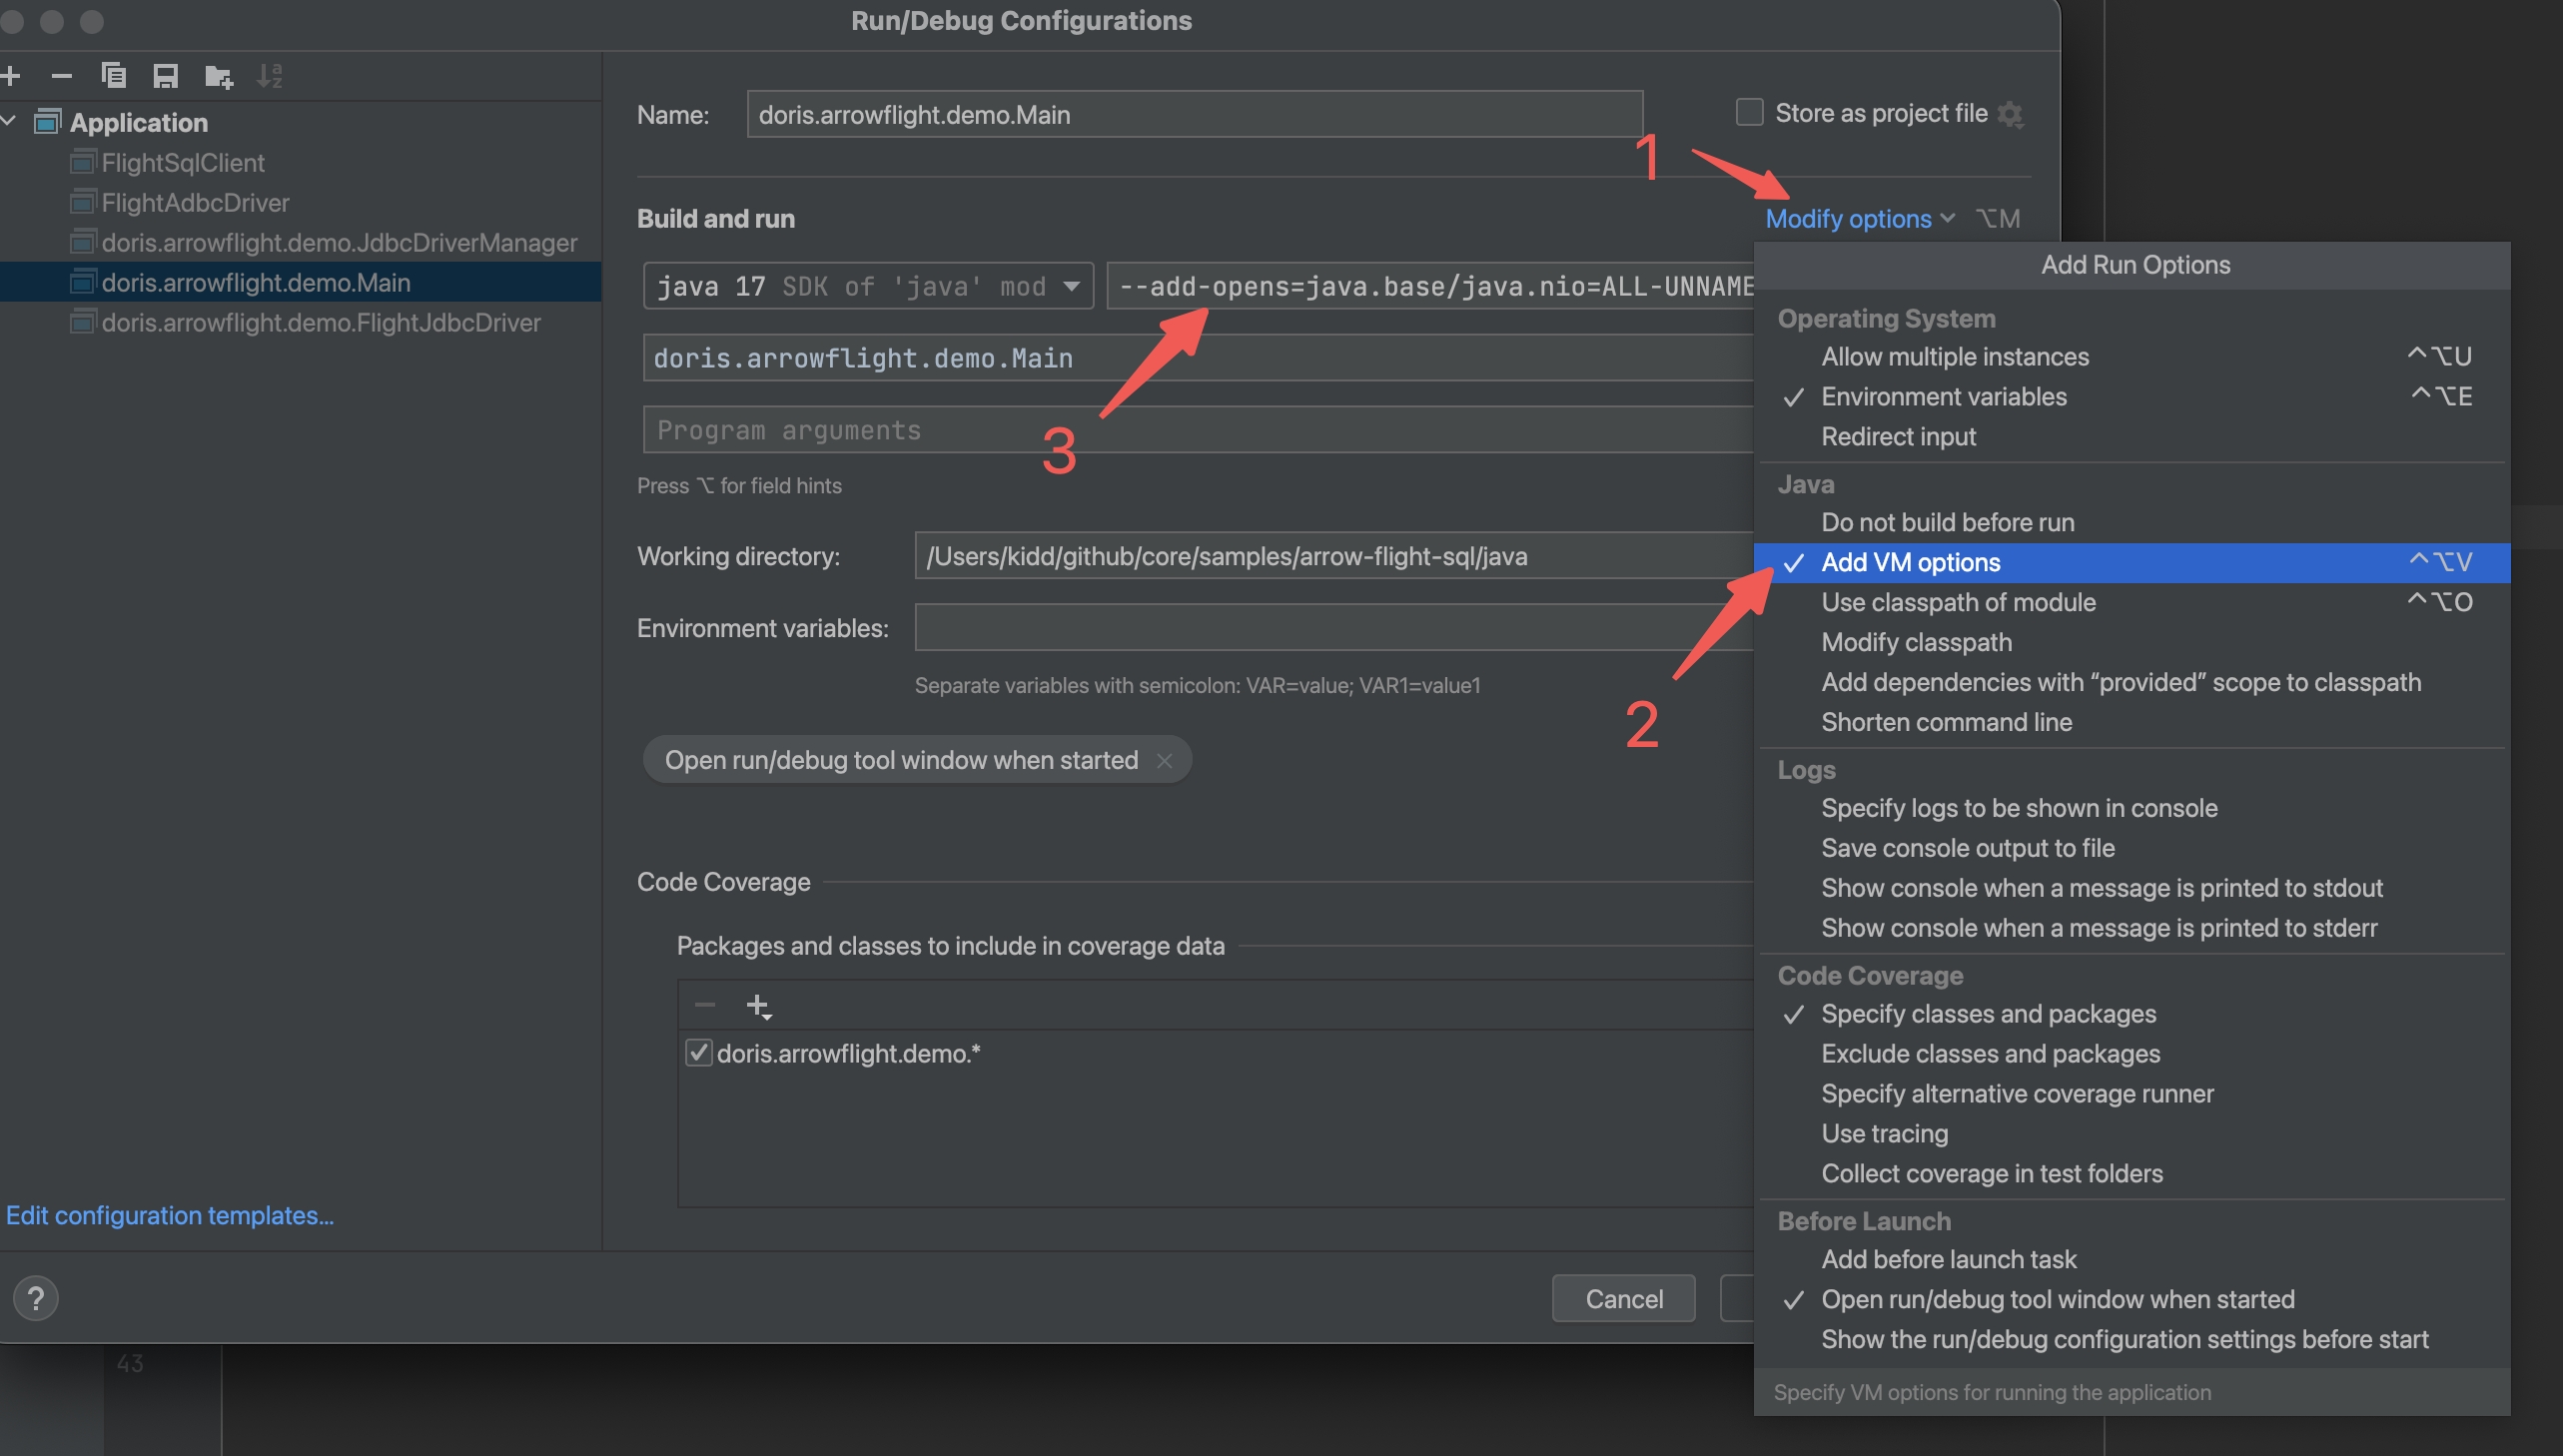
Java 9 以降を使用する場合は、JDK の内部機能の一部を公開するため、Java コマンドに --add-opens=java.base/java.nio=ALL-UNNAMED を追加する必要があります。追加しないと、次のいずれかのエラーが発生します。
module java.base does not "opens java.nio" to unnamed modulemodule java.base does not "opens java.nio" to org.apache.arrow.memory.corejava.lang.NoClassDefFoundError: Could not initialize class org.apache.arrow.memory.util.MemoryUtil (Internal; Prepare)
追加方法は 2 つあります。
# Option 1: Add via command-line argument directly
$ java --add-opens=java.base/java.nio=ALL-UNNAMED -jar ...

# Option 2: Add via environment variable
$ env _JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" java -jar ...
IntelliJ IDEA でデバッグする場合は、Run/Debug Configurations の Build and run にこの引数を追加します。下図を参照してください。
オプション 1:jdbc:arrow-flight-sql
Arrow Flight SQL プロトコル用のオープンソース JDBC ドライバーは、標準の JDBC API と互換性があります。これにより、ほとんどの BI ツールが JDBC 経由で Doris にアクセスでき、Apache Arrow データの高速転送にも対応します。使い方は MySQL JDBC ドライバーと似ており、接続 URL の jdbc:mysql プロトコルを jdbc:arrow-flight-sql プロトコルに置き換えるだけです。クエリ結果は引き続き JDBC の ResultSet データ構造で返されます。
POM の依存関係:
<properties>
    <arrow.version>17.0.0</arrow.version>
</properties>
<dependencies>
    <dependency>
        <groupId>org.apache.arrow</groupId>
        <artifactId>flight-sql-jdbc-core</artifactId>
        <version>${arrow.version}</version>
    </dependency>
</dependencies>
接続コードの例:
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.Statement;

Class.forName("org.apache.arrow.driver.jdbc.ArrowFlightJdbcDriver");
String DB_URL = "jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}?useServerPrepStmts=false"
        + "&cachePrepStmts=true&useSSL=false&useEncryption=false";
String USER = "root";
String PASS = "";

Connection conn = DriverManager.getConnection(DB_URL, USER, PASS);
Statement stmt = conn.createStatement();
ResultSet resultSet = stmt.executeQuery("select * from information_schema.tables;");
while (resultSet.next()) {
    System.out.println(resultSet.toString());
}

resultSet.close();
stmt.close();
conn.close();
オプション 2:Flight ADBC Driver / Flight JDBC Driver
JDBC を使う方法に加え、Java では Driver を作成して Doris から直接データを読み取り、Arrow 形式で返すこともできます。以下の例では、ADBC Driver と JDBC Driver(ADBC wrapper)を使って Doris Arrow Flight Server に接続する方法を示します。
POM の依存関係:
<properties>
    <adbc.version>0.15.0</adbc.version>
</properties>

<dependencies>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-jdbc</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-core</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-manager</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-sql</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-flight-sql</artifactId>
        <version>${adbc.version}</version>
    </dependency>
</dependencies>
Flight ADBC Driver
接続コードの例:
// 1. new driver
final BufferAllocator allocator = new RootAllocator();
FlightSqlDriver driver = new FlightSqlDriver(allocator);
Map<String, Object> parameters = new HashMap<>();
AdbcDriver.PARAM_URI.set(parameters, Location.forGrpcInsecure("{FE_HOST}", {fe.conf:arrow_flight_sql_port}).getUri().toString());
AdbcDriver.PARAM_USERNAME.set(parameters, "root");
AdbcDriver.PARAM_PASSWORD.set(parameters, "");
AdbcDatabase adbcDatabase = driver.open(parameters);

// 2. new connection
AdbcConnection connection = adbcDatabase.connect();
AdbcStatement stmt = connection.createStatement();

// 3. execute query
stmt.setSqlQuery("select * from information_schema.tables;");
QueryResult queryResult = stmt.executeQuery();
ArrowReader reader = queryResult.getReader();

// 4. load result
List<String> result = new ArrayList<>();
while (reader.loadNextBatch()) {
    VectorSchemaRoot root = reader.getVectorSchemaRoot();
    String tsvString = root.contentToTSVString();
    result.add(tsvString);
}
System.out.printf("batchs %d\n", result.size());

// 5. close
reader.close();
queryResult.close();
stmt.close();
connection.close();
Flight JDBC Driver (ADBC wrapper)
接続コードの例:
final Map<String, Object> parameters = new HashMap<>();
AdbcDriver.PARAM_URI.set(
        parameters,"jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}?useServerPrepStmts=false&cachePrepStmts=true&useSSL=false&useEncryption=false");
AdbcDriver.PARAM_USERNAME.set(parameters, "root");
AdbcDriver.PARAM_PASSWORD.set(parameters, "");
try (
        BufferAllocator allocator = new RootAllocator();
        AdbcDatabase db = new JdbcDriver(allocator).open(parameters);
        AdbcConnection connection = db.connect();
        AdbcStatement stmt = connection.createStatement()
) {
    stmt.setSqlQuery("select * from information_schema.tables;");
    AdbcStatement.QueryResult queryResult = stmt.executeQuery();
    ArrowReader reader = queryResult.getReader();
    List<String> result = new ArrayList<>();
    while (reader.loadNextBatch()) {
        VectorSchemaRoot root = reader.getVectorSchemaRoot();
        String tsvString = root.contentToTSVString();
        result.add(tsvString);
    }
    long etime = System.currentTimeMillis();
    System.out.printf("batchs %d\n", result.size());

    reader.close();
    queryResult.close();
    stmt.close();
}  catch (Exception e) {
    e.printStackTrace();
}
型マッピング
バージョン 4.1.4 以降、Arrow Flight SQL が返す DATETIME / DATETIMEV2 の値は、タイムゾーン情報を持たない Arrow タイムスタンプになります。一方、TIMESTAMPTZ は引き続きタイムゾーン情報を持つタイムスタンプとして返されます。
4.1.4 より前は、DATETIME にタイムゾーン情報があると示されていたため、クライアントがローカルタイムゾーンで解析すると、余分なタイムゾーンオフセットが適用されていました。アップグレード後は、DATETIME 列をタイムゾーンのないローカル時刻として解析してください。
同じバージョンでは、次の型メタデータも修正されています。
GetTablesメタデータエンドポイントで、DATEV2の Arrow 型がDate(MILLISECOND)からDate(DAY)に修正されました。ARRAY/MAP/STRUCTのメタデータは、プレースホルダーの型ではなく、実際の子フィールドの型を報告するようになりました。
サードパーティーコンポーネントとの連携
BI ツール(DBeaver など)
Doris v2.1.8 以降、DBeaver などの BI ツールは arrow-flight-sql プロトコルを使用して Doris に接続できます。設定方法については、以下を参照してください。
Spark と Flink
Arrow Flight には、Spark と Flink を公式にサポートする計画はありません(GitHub Issue を参照)。ただし、バージョン 24.0.0 以降、次のコネクターは Arrow Flight SQL 経由での Doris へのアクセスに対応しており、読み取り性能が数倍向上すると見込まれます。
以前、コミュニティでは Spark-Flight-Connector を参考にして、Spark から FlightClient 経由で Doris に接続するテストを行いました。得られた結論は次のとおりです。
- Arrow と Doris Block 間の変換は、CSV と Doris Block 間の変換より 10 倍高速です。
- Arrow は Map や Array などの複合型をより適切にサポートします。
- Arrow データは圧縮効率が高く、転送時のネットワーク負荷を抑えられます。
ただし、Doris Arrow Flight では、複数ノードからの並列読み取りはまだ実装されていません。クエリ結果は、返される前に単一の BE ノードに集約されます。単純な一括データエクスポートでは、Tablet 単位の並列読み取りに対応する Doris Spark Connector ほどの性能が出ない場合があります。
Spark から Arrow Flight SQL を使用して Doris に接続したい場合は、次のオープンソースプロジェクトを参考にして独自に実装できます。
高度な設定
複数 BE からの並列結果返却
デフォルトでは、Doris はすべての BE ノードからのクエリ結果を単一の BE ノードに集約します。プロトコルごとの動作は次のとおりです。
- MySQL/JDBC クエリ:FE が集約先の BE ノードにクエリ結果を要求します。
- Arrow Flight SQL クエリ:FE がその BE ノードの IP/Port を Endpoint に格納して ADBC Client に返します。その後、ADBC Client がこの Endpoint にデータを要求します。
シナリオ 1:単純な SELECT による取得(Join/Sort/ウィンドウ関数なし)
クエリが、Join、Sort、ウィンドウ関数などデータのシャッフルを引き起こす演算子を含まず、Doris からデータを取得するだけの単純な SELECT であれば、Tablet 単位に分割できます。Doris Spark/Flink Connector は、次の 2 ステップで並列読み取りを実装しています。
-
EXPLAIN SQLを実行します。FE が返すクエリプランには、ScanOperator 内にすべての Tablet ID の一覧が含まれます。 -
この Tablet ID 一覧に基づいて元の SQL を複数の SQL 文に分割し、各文が一部の Tablet だけを読み取るようにします。例:
SELECT * FROM t1 TABLET(10001,10002) limit 1000;分割した SQL 文は並列に実行できます。詳細は Support select table sample を参照してください。
シナリオ 2:最外層に集計があるクエリ
select k1, sum(k2) from xxx group by k1 形式のクエリでは、Doris v3.0.4 以降、次の設定を使用すると各 BE ノードがそれぞれの結果を個別に返せます。
set enable_parallel_result_sink=true;
FE から返された Endpoint 一覧を受け取ると、ADBC Client は複数の BE ノードから並列に結果を取得します。実装の詳細は support parallel result sink を参照してください。
集計結果が小さい場合、複数の BE から結果を返すと RPC の負荷が増えます。
理論上、最外層がソートであるクエリを除けば、どのクエリでも BE ノードごとに並列で結果を返せます。ただし、これはまだ実装されていません。
複数の BE で同じ外部アクセス IP を共有する
FE ノードにはクラスター外部からアクセスできる一方、すべての BE ノードにはクラスター内部からしかアクセスできないデプロイ構成があります。
- MySQL Client または JDBC で Doris に接続してクエリを実行する場合は、FE が結果を返すため動作します。
- Arrow Flight SQL で Doris に接続する場合は、ADBC Client がクエリ結果を取得するために BE ノードへ直接接続する必要があるため、クエリを実行できません。
本番環境では、通常、BE ノードをクラスター外部に公開するのは容易ではありません。すべての BE ノードの前段に Nginx などのリバースプロキシを配置し、Nginx に接続する外部クライアントを BE ノードへランダムに振り分けることができます。ただし、デフォルトでは Arrow Flight SQL のクエリ結果は特定の BE ノードにランダムに保存されます。そのノードと Nginx の振り分け先が異なる場合、BE 内部でデータの転送処理が発生します。
Doris v2.1.8 以降、すべての BE ノードの be.conf にある public_host と arrow_flight_sql_proxy_port に、複数の BE ノードが共有する外部アクセス IP とポートを設定できます。これにより、クエリ結果が適切に転送され、ADBC Client に返されます。
public_host={nginx ip}
arrow_flight_sql_proxy_port={nginx port}
FAQ
1. i/o timeout エラー
Q: エラーメッセージ全体は connection error: desc = "transport: Error while dialing: dial tcp <ip:arrow_flight_port>: i/o timeout" です。
A: エラーメッセージ内の <ip:arrow_flight_port> が指すノードの役割に応じて、次の 2 つのケースを確認します。
ケース 1:<ip:arrow_flight_port> が FE ノードの IP と arrow_flight_port を指す場合
- FE ノードの Arrow Flight Server が正常に起動したか確認します。
fe/log/fe.logにArrow Flight SQL service is startedがあれば、正常に起動しています。 - FE の Arrow Flight Server が正常に起動している場合は、クライアントマシンからこの IP に
pingできるか確認します。できない場合は、FE ノードで外部からアクセス可能な IP を有効にし、クラスターを再デプロイする必要があります。
ケース 2:<ip:arrow_flight_port> が BE ノードの IP と arrow_flight_port を指す場合
- BE ノードの Arrow Flight Server が正常に起動したか確認します。
be/log/be.INFOにArrow Flight Service bind to hostがあれば、正常に起動しています。 - BE の Arrow Flight Server が正常に起動している場合は、クライアントマシンからこの IP に
pingできるか確認します。
BE ノードがクラスターの内部ネットワーク上にあることが分かっている場合は、次のいずれかの方法を使用します。
- 各 BE ノードで外部からアクセス可能な IP を有効にします。Doris v2.1.8 以降、その BE ノードの
be.confにあるpublic_hostをこの IP に設定し、すべての BE ノードのpublic_hostもそれぞれクライアントからアクセス可能な IP に設定します。 - 複数の BE で同じ外部アクセス IP を共有する セクションを参照し、すべての BE ノードの前段にリバースプロキシを追加します。
BE が完全に内部ネットワーク上にあるか不明な場合は、次の手順で確認します。
- BE ノードのマシンで
ifconfigを実行し、すべての IP を取得します。そのうちの 1 つは<ip:arrow_flight_port>内の IP、およびshow backendsが表示する IP と一致するはずです。 ifconfigで返されたほかの各 IP に、順番にpingします。- クライアントから到達できる IP があれば、その IP を
public_hostに設定します。どの IP にも到達できなければ、その BE ノードは完全に内部ネットワーク上にあります。
2. JDBC または Java で Arrow Flight SQL に接続する際の module java.base does not "opens java.nio"... エラー
Q: エラーメッセージ全体は、次のいずれかです。
module java.base does not "opens java.nio" to unnamed modulemodule java.base does not "opens java.nio" to org.apache.arrow.memory.corejava.lang.NoClassDefFoundError: Could not initialize class org.apache.arrow.memory.util.MemoryUtil (Internal; Prepare)
A: 次の方法で解決します。
fe/conf/fe.confのJAVA_OPTS_FOR_JDK_17に--add-opens=java.base/java.nio=ALL-UNNAMEDが含まれているか確認します。含まれていなければ追加します。- Java での使用方法 の注意事項を参照し、Java コマンドに
--add-opens=java.base/java.nio=ALL-UNNAMEDを追加します。 - IntelliJ IDEA でデバッグする場合は、
Run/Debug ConfigurationsのBuild and runに--add-opens=java.base/java.nio=ALL-UNNAMEDを追加します。
3. ARM 環境での arrow flight schema timeout エラー
Q: エラーメッセージ全体は get flight info statement failed, arrow flight schema timeout, TimeoutException: Waited 5000 milliseconds for io.grpc.stub.Client です。
A: Linux カーネルのバージョンが 4.19.90 以下の場合は、4.19.279 以降にアップグレードするか、古いバージョンの Linux カーネル環境で Doris BE を再コンパイルする必要があります。具体的なコンパイル方法については、docs/dev/install/source-install/compilation-arm を参照してください。
原因: 古い Linux カーネルには Arrow との互換性の問題があります。Arrow Record Batch の構築中に cpp: arrow::RecordBatch::MakeEmpty() が停止するため、BE の Arrow Flight Server が FE の RPC リクエストに 5000ms 以内に応答できず、FE はクライアントに RPC タイムアウトエラーを返します。Spark と Flink も Doris からの読み取り時に、返却前のクエリ結果を Arrow Record Batch に変換するため、同じ問題が当てはまります。
KylinV10 SP2 と SP3 の Linux カーネルバージョンは 4.19.90-24.4.v2101.ky10.aarch64 までで、それ以上にはアップグレードできません。この場合は、KylinV10 上で Doris BE を再コンパイルする必要があります。新しい ldb_toolchain でコンパイルしても問題が続く場合は、古い ldb_toolchain v0.17 でのコンパイルを試してください。ARM 環境からインターネットに接続できない場合は、Huawei Cloud が ARM + KylinV10、Alibaba Cloud が x86 + KylinV10 を提供しています。
4. jdbc:arrow-flight-sql のバッチごとの読み取りサイズを変更する方法
Q: シナリオによっては、性能を向上させるためにバッチサイズを変更する必要があります。
A: org.apache.arrow.adbc.driver.jdbc.JdbcArrowReader の makeJdbcConfig メソッド内にある setTargetBatchSize(デフォルトは 1024)を変更し、変更したファイルをローカルディレクトリの同じパスに保存して元のファイルを上書きすると、変更が有効になります。
5. ADBC v0.10 は並列読み取りに対応していない
Q: ADBC v0.10 の JDBC と Java ADBC/JDBC Driver は、並列読み取りに対応していますか?
A: 対応していません。stmt.executePartitioned() メソッドが実装されていないためです。複数の Endpoint からの並列読み取りを実装するには、ネイティブの FlightClient を使用する必要があります。呼び出しの流れは次のようになります。
sqlClient = new FlightSqlClient
execute   = sqlClient.execute(sql)
endpoints = execute.getEndpoints()
for (FlightEndpoint endpoint : endpoints) { ... }
また、ADBC v0.10 のデフォルトの AdbcStatement は実際には JdbcStatement です。executeQuery の後、行ベースの JDBC ResultSet が Arrow の列指向形式に再変換されます。Java ADBC の機能は ADBC 1.0.0 でさらに充実すると見込まれます。詳細は GitHub Issue を参照してください。
6. URL でデータベース名を指定する
Q: URL でデータベース名を指定できますか?
A: Arrow v15.0 の時点では、Arrow JDBC Connector は URL でのデータベース名の指定に対応していません。たとえば、jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}/test?useServerPrepStmts=false で test データベースを指定しても効果はありません。SQL の use database を手動で実行する必要があります。Arrow v18.0 では URL でのデータベース名の指定に対応していますが、実際の使用時にはまだバグがあります。
7. Python ADBC で Cannot disable autocommit 警告が表示される
Q: 警告メッセージ全体は Warning: Cannot disable autocommit; conn will not be DB-API 2.0 compliant です。
A: Python を使用する場合、この警告は無視できます。Python ADBC Client の問題であり、クエリには影響しません。
8. Python の grpc: received message larger than max エラー
Q: エラーメッセージ全体は grpc: received message larger than max (20748753 vs. 16777216) です。
A: Python: grpc: received message larger than max #2078 を参照し、Database Option に adbc_driver_flightsql.DatabaseOptions.WITH_MAX_MSG_SIZE.value を追加してください。
9. invalid bearer token エラー
Q: クライアントから invalid bearer token エラーが報告されます。
A: 次の対処を行えます。
-
現在のユーザーの最大接続数を変更します。
SET PROPERTY FOR 'root' 'max_user_connections' = '10000'; -
fe.confに次の 2 項目を追加して FE を再起動します。qe_max_connection=30000
arrow_flight_token_cache_size=8000
原因:長時間維持される接続の保持機構
ADBC Client と Arrow Flight Server の間の接続は、実質的に長時間維持される接続です。Auth Token、Connection、Session は Server 側にキャッシュする必要があります。接続が作成されると、1 つのクエリが終了してもすぐには閉じられません。クリーンアップするには、クライアントから close() リクエストを送る必要があります。実際にはクライアントが close() を送らないことが多く、Auth Token、Connection、Session が Server 側に長期間残ります。デフォルトでは 3 日後にタイムアウトするか、接続数が arrow_flight_token_cache_size の上限を超えると LRU によって削除されます。
原因:デフォルトの接続数上限が小さすぎる
Doris v2.1.8 の時点では、Arrow Flight 接続と MySQL/JDBC 接続は、次の接続数上限を共有します。
- FE 上の全ユーザーの合計接続数:
qe_max_connection、デフォルトは1024。 - ユーザーごとの接続数:
UserPropertyのmax_user_connections、デフォルトは100。
Arrow Flight SQL は JDBC を使用していた場面の代替としてよく使われますが、JDBC 接続はクエリ終了後すぐに解放されます。そのため、Arrow Flight SQL を使用する際には Doris のデフォルトの接続数上限が小さすぎることが多く、接続数が arrow_flight_token_cache_size を超え、使用中の接続が削除される原因になります。
10. JDBC または Java で Datetime 型を読み取るとタイムスタンプが返される
Q: JDBC または Java から Arrow Flight SQL に接続して Datetime 型を読み取ると、整形された時刻(2025-03-03 17:23:28Z など)ではなく、タイムスタンプ(1740993808 など)が返されます。
A: JDBC または Java から Arrow Flight SQL に接続して Datetime 型を読み取る場合は、タイムスタンプを自分で変換する必要があります。Add java parsing datetime type in arrow flight sql sample #48578 を参照してください。Python Arrow Flight SQL は Datetime 型に対して 2025-03-03 17:23:28Z を返しますが、JDBC または Java は 1740993808 を返します。
11. JDBC または Java JDBC Client で Array のネスト型を読み取る際のエラー
Q: エラーメッセージ全体は Configuration does not provide a mapping for array column 2 です。
A: sample/arrow-flight-sql を参考に、Java ADBC Client に切り替えることを推奨します。
Python ADBC Client、Java ADBC Client、Java JDBC DriverManager は、いずれも Array のネスト型を問題なく読み取れます。この問題は、JDBC または Java JDBC Client を使用して Arrow Flight SQL に接続した場合にのみ発生します。Arrow Flight JDBC は Arrow が公式に開発したものではなく、サードパーティーのデータベース企業である Dremio が開発したもので、互換性が低めです。ほかにも互換性の問題が見つかっているため、Java ADBC Client の使用を優先して推奨します。