BigQuery
このドキュメントでは、Google BigQuery から Apache Doris にデータを移行する方法を説明します。全体の流れでは、オブジェクトストレージを中間ストレージとして使用します。
- BigQuery の Export ステートメントを使用して、データを GCS(Google Cloud Storage)にエクスポートします。
- Doris に対応するターゲットテーブルを作成します。
- Doris の S3 Load 機能を使用して、GCS から Doris にデータを取り込みます。仕組みの詳細については、S3 Load を参照してください。
注意事項
移行を開始する前に、よくある問題を避けるため、次の点に注意してください。
- テーブルスキーマの設計: BigQuery のテーブルスキーマに基づいて、適切な Doris のデータモデル、パーティション分割、バケット分割の方法を選択します。テーブル作成に関するその他の指針については、ロードのベストプラクティスを参照してください。
- JSON 型のエクスポート: BigQuery は JSON 型の Parquet 形式でのエクスポートをサポートしていません。代わりに JSON 形式でエクスポートしてください。
- TIME 型のエクスポート: BigQuery の TIME 型をエクスポートする際は、事前に STRING 型にキャストしてください。
- 複合型のインポート: 複合型(Struct/Array/Map)を含む Parquet/ORC ファイルには、現時点では TVF Load を使用する必要があります。
データ型のマッピング
移行前に、次の規則に従って BigQuery のフィールドに対応するカラムを Doris に作成します。
| BigQuery | Doris | 備考 |
|---|---|---|
| Array | Array | |
| BOOLEAN | BOOLEAN | |
| DATE | DATE | |
| DATETIME/TIMESTAMP | DATETIME | |
| JSON | JSON | |
| INT64 | BIGINT | |
| NUMERIC | DECIMAL | |
| FLOAT64 | DOUBLE | |
| STRING | VARCHAR/STRING | VARCHAR の最大長は 65535 |
| STRUCT | STRUCT | |
| TIME | STRING | エクスポート前に STRING 型にキャスト |
| OTHER | UNSUPPORTED | 現時点でサポートされていない型 |
移行手順
ステップ 1: Doris にターゲットテーブルを作成する
BigQuery のテーブルを Doris に移行する前に、まずスキーマが一致する Doris のテーブルを作成します。
BigQuery に次のテーブルとサンプルデータがすでに存在するとします。
CREATE OR REPLACE TABLE test.sales_data (
    order_id      INT64,
    customer_name STRING,
    order_date    DATE,
    amount        NUMERIC(10,2),
    country       STRING
)
PARTITION BY  order_date;


INSERT INTO test.sales_data (order_id, customer_name, order_date, amount, country) VALUES
(1, 'Alice', '2025-04-08', 99.99, 'USA'),
(2, 'Bob', '2025-04-08', 149.50, 'Canada'),
(3, 'Charlie', '2025-04-09', 75.00, 'UK'),
(4, 'Diana', '2025-04-10', 200.00, 'Australia');
このスキーマに基づいて、Doris に UNIQUE KEY のパーティションテーブルを作成できます。パーティションカラムは BigQuery のパーティションカラムに合わせ、日単位で分割します。
CREATE TABLE `sales_data` (
  order_id      INT,
  order_date    DATE NOT NULL,
  customer_name VARCHAR(128),
  amount        DECIMAL(10,2),
  country       VARCHAR(48)
) ENGINE=OLAP
UNIQUE KEY(`order_id`,`order_date`)
PARTITION BY RANGE(`order_date`) (
PARTITION p20250408 VALUES [('2025-04-08'), ('2025-04-09')),
PARTITION p20250409 VALUES [('2025-04-09'), ('2025-04-10')),
PARTITION p20250410 VALUES [('2025-04-10'), ('2025-04-11'))
)
DISTRIBUTED BY HASH(`order_id`) BUCKETS 16
PROPERTIES (
 "dynamic_partition.enable" = "true",
 "dynamic_partition.time_unit" = "DAY",
 "dynamic_partition.end" = "5",
 "dynamic_partition.prefix" = "p",
 "dynamic_partition.buckets" = "16",
 "replication_num" = "1"
);
ステップ 2: BigQuery のデータを GCS にエクスポートする
2.1 Export ステートメントを使用して Parquet ファイルをエクスポートする
BigQuery の EXPORT DATA を使用して、ターゲットテーブルを GCS にエクスポートします。
EXPORT DATA
  OPTIONS (
    uri = 'gs://mybucket/export/sales_data/*.parquet',
    format = 'PARQUET')
AS (
  SELECT *
  FROM test.sales_data
);
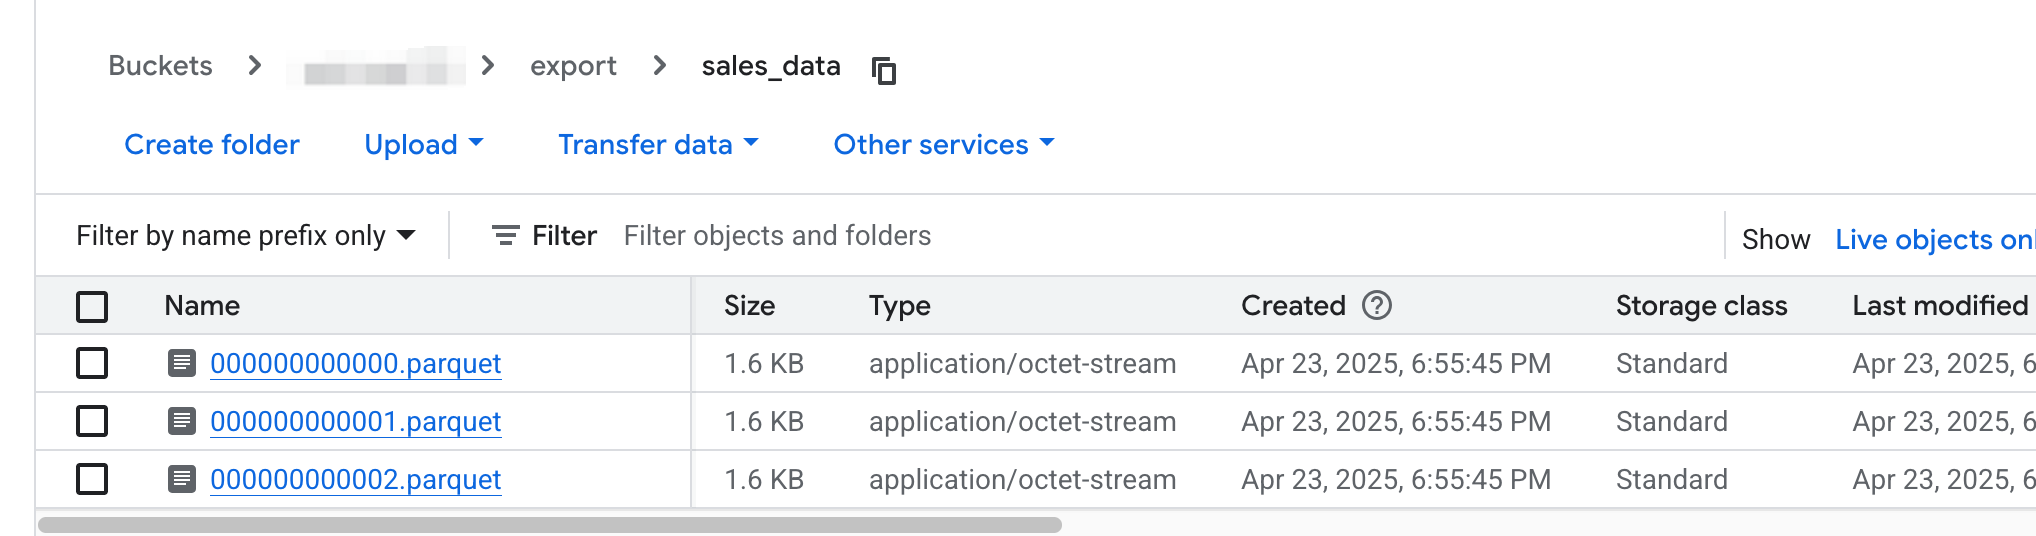
2.2 GCS 上のエクスポート済みファイルを確認する
上記のコマンドは、sales_data を GCS にエクスポートします。各パーティションから、連番のファイル名を持つファイルが一つ以上生成されます。詳細については、データのエクスポートを参照してください。
ステップ 3: S3 Load でデータを Doris にインポートする
インポートには S3 Load を使用します。S3 Load は非同期のデータインポート方法です。ジョブを送信すると、Doris がデータソースからデータを取得します。 データソースには、AWS S3、GCS、Azure など、S3 プロトコルと互換性のあるオブジェクトストレージを使用できます。
この方法は、大量のデータをバックグラウンドで非同期に処理する場合に適しています。同期処理が必要なデータインポートについては、TVF Load を参照してください。
注: 複合型(Struct/Array/Map)を含む Parquet/ORC ファイルには、現時点では TVF Load を使用する必要があります。
3.1 単一ファイルからデータをインポートする
次の LOAD LABEL ステートメントを使用して、GCS 上の単一の Parquet ファイルからデータをインポートします。
LOAD LABEL sales_data_2025_04_08
(
    DATA INFILE("s3://mybucket/export/sales_data/000000000000.parquet")
    INTO TABLE sales_data
    FORMAT AS "parquet"
    (order_id, order_date, customer_name, amount, country)
)
WITH S3
(
    "provider" = "GCP",
    "s3.endpoint" = "storage.asia-southeast1.rep.googleapis.com",
    "s3.region" = "asia-southeast1",
    "s3.access_key" = "<ak>",
    "s3.secret_key" = "<sk>"
);
3.2 SHOW LOAD でジョブの状態を確認する
S3 Load のジョブは非同期で送信されるため、SHOW LOAD を使用して、指定したラベルのインポート状態を確認します。
mysql> show load where label = "sales_data_2025_04_08"\G
*************************** 1. row ***************************
        JobId: 17956078
        Label: sales_data_2025_04_08
        State: FINISHED
      Progress: 100.00% (1/1)
          Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=2
      TaskInfo: cluster:storage.asia-southeast1.rep.googleapis.com; timeout(s):3600; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: NULL
    CreateTime: 2025-04-10 17:50:53
  EtlStartTime: 2025-04-10 17:50:54
EtlFinishTime: 2025-04-10 17:50:54
LoadStartTime: 2025-04-10 17:50:54
LoadFinishTime: 2025-04-10 17:50:54
          URL: NULL
    JobDetails: {"Unfinished backends":{"5eec1be8612d4872-91040ff1e7208a4f":[]},"ScannedRows":2,"TaskNumber":1,"LoadBytes":91,"All backends":{"5eec1be8612d4872-91040ff1e7208a4f":[10022]},"FileNumber":1,"FileSize":1620}
TransactionId: 766228
  ErrorTablets: {}
          User: root
      Comment:
1 row in set (0.00 sec)
3.3 インポート中のエラーに対処する
複数のインポートジョブがある場合は、次のステートメントを使用して、失敗したインポートとその原因を確認します。
mysql> show load where state='CANCELLED' and label like "label_test%"\G
*************************** 1. row ***************************
        JobId: 18312384
        Label: label_test123
        State: CANCELLED
      Progress: 100.00% (3/3)
          Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=4; dpp.norm.ALL=0
      TaskInfo: cluster:storage.asia-southeast1.rep.googleapis.com; timeout(s):14400; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: type:ETL_QUALITY_UNSATISFIED; msg:quality not good enough to cancel
    CreateTime: 2025-04-15 17:32:59
  EtlStartTime: 2025-04-15 17:33:02
EtlFinishTime: 2025-04-15 17:33:02
LoadStartTime: 2025-04-15 17:33:02
LoadFinishTime: 2025-04-15 17:33:02
          URL: http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342
    JobDetails: {"Unfinished backends":{"7602ccd7c3a4854-95307efca7bfe341":[]},"ScannedRows":4,"TaskNumber":1,"LoadBytes":188,"All backends":{"7602ccd7c3a4854-95307efca7bfe341":[10022]},"FileNumber":3,"FileSize":4839}
TransactionId: 769213
  ErrorTablets: {}
          User: root
      Comment:
上記の例はデータ品質エラー(ETL_QUALITY_UNSATISFIED)です。具体的な原因を調べるには、返された URL にアクセスしてください。たとえば、次のエラーは、データがテーブルスキーマで定義された country カラムの実際の長さを超えていることを示します。
[root@VM-10-6-centos ~]$ curl "http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342"
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [USA] schema length: 1; actual length: 3; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Canada] schema length: 1; actual length: 6; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [UK] schema length: 1; actual length: 2; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Australia] schema length: 1; actual length: 9; . src line [];
データ品質エラーが発生した場合、誤りのある行を一部スキップしてよいなら、S3 Load の PROPERTIES でエラー許容率を設定します。パラメータの詳細については、ロード設定パラメータを参照してください。
3.4 複数ファイルからデータをインポートする
大量の過去データを移行する場合は、バッチインポート戦略を使用します。
- バッチの分割: 各バッチが Doris の一つ、または少数のパーティションに対応するようにします。
- バッチごとのデータ量: システムへの負荷と、インポート失敗後の再試行コストを抑えるため、各バッチのデータ量を 100 GB 以下にすることを推奨します。
- バッチスクリプト: s3_load_file_demo.sh を参照してください。このスクリプトは、オブジェクトストレージの指定ディレクトリ内にあるファイルの一覧を分割し、複数の S3 Load ジョブをバッチ単位で Doris に送信します。
よくある質問
Q1: BigQuery の JSON 型を Parquet 形式で直接エクスポートできないのはなぜですか?
BigQuery は現時点で、JSON 型の Parquet 形式でのエクスポートをサポートしていません。エクスポート時の format を JSON に設定し、Doris では対応する JSON カラムでデータを受け取ります。
Q2: BigQuery の TIME 型は Doris にどのようにマッピングしますか?
BigQuery の TIME 型はエクスポート時に STRING 型にキャストし、Doris の STRING カラムに格納する必要があります。
Q3: インポートが ETL_QUALITY_UNSATISFIED で失敗した場合はどうすればよいですか?
このエラーは、データが品質要件を満たしていないことを示します。次の手順で対処してください。
URLフィールドをSHOW LOADの結果で確認し、curlで詳細なエラーログを取得します。- ログから原因を特定します。一般的な原因には、カラム長の超過や型の不一致があります。
- ターゲットテーブルのスキーマを調整するか、
max_filter_ratioを S3 Load のPROPERTIESで設定して、誤りのある行を一部スキップします。
Q4: Struct/Array/Map を含む Parquet/ORC ファイルを S3 Load でインポートできますか?
いいえ。これらの複合型を含むファイルには、現時点では TVF Load を使用する必要があります。
Q5: 大量の過去データを移行するとき、単一ジョブの失敗による再試行コストを抑えるにはどうすればよいですか?
パーティションごとに 100 GB 以下のバッチに分けてインポートし、s3_load_file_demo.sh スクリプトでバッチを分割して送信します。