Broker Load
Broker Load は MySQL API を通じて開始します。Doris は LOAD 文の指定に従って、リモートデータソースからデータを能動的に取得します。これは非同期インポート方式です。投入後は SHOW LOAD 文でインポートの進捗と結果を確認してください。
この方式は非推奨であり、バージョン 5.0 で削除される予定です。代わりに "insert into table select xxx from tvf or catalog table" を使用してください。
Broker Load は、次のような場合に適しています。
- ソースデータがオブジェクトストレージや HDFS などのリモートシステムに保存されている。
- 一回のインポートで扱うデータ量が大きい(GB ~ TB 規模)。
- Doris に並列度と再試行を制御させながら、データをバッチ単位で非同期にインポートしたい。
Lakehouse / TVF の HDFS TVF または S3 TVF と
INSERT INTOを組み合わせてデータをインポートすることもできます。現在、TVF を使ったINSERT INTOは同期インポートですが、Broker Load は非同期インポートです。
Doris の初期のバージョンでは、S3 Load と HDFS Load はどちらも WITH BROKER を使って特定の Broker プロセスに接続していました。その後、S3 Load と HDFS Load は追加の Broker プロセスを必要としなくなりましたが、Broker Load と似た構文を引き続き使用しています。この経緯と構文の類似性から、S3 Load、HDFS Load、Broker Load を総称して Broker Load と呼びます。
制限事項
次の表に Broker Load の対応範囲を示します。
| 項目 | 対応範囲 |
|---|---|
| ストレージのバックエンド | S3 プロトコル、HDFS プロトコル、その他のプロトコル(対応する Broker プロセスが必要) |
| ファイルパスのパターン | ワイルドカード *、?、[abc]、[a-z] と、範囲展開 {1..10}、{a,b,c}。完全な構文についてはファイルパスパターンを参照してください。 |
| データ形式 | CSV、JSON、PARQUET、ORC |
| 圧縮形式 | PLAIN、GZ、LZO、BZ2、LZ4FRAME、DEFLATE、LZOP、LZ4BLOCK、SNAPPYBLOCK、ZLIB、ZSTD |
基本原理
インポートジョブを投入すると、次の処理が行われます。
- FE は現在の BE 数とファイルサイズに基づいて実行計画を作成し、複数の BE に配布します。
- 各 BE はデータの一部を担当し、Broker からデータを取得して変換し、Doris に書き込みます。
- すべての BE がインポートを完了すると、FE がインポートの成否を最終判定します。
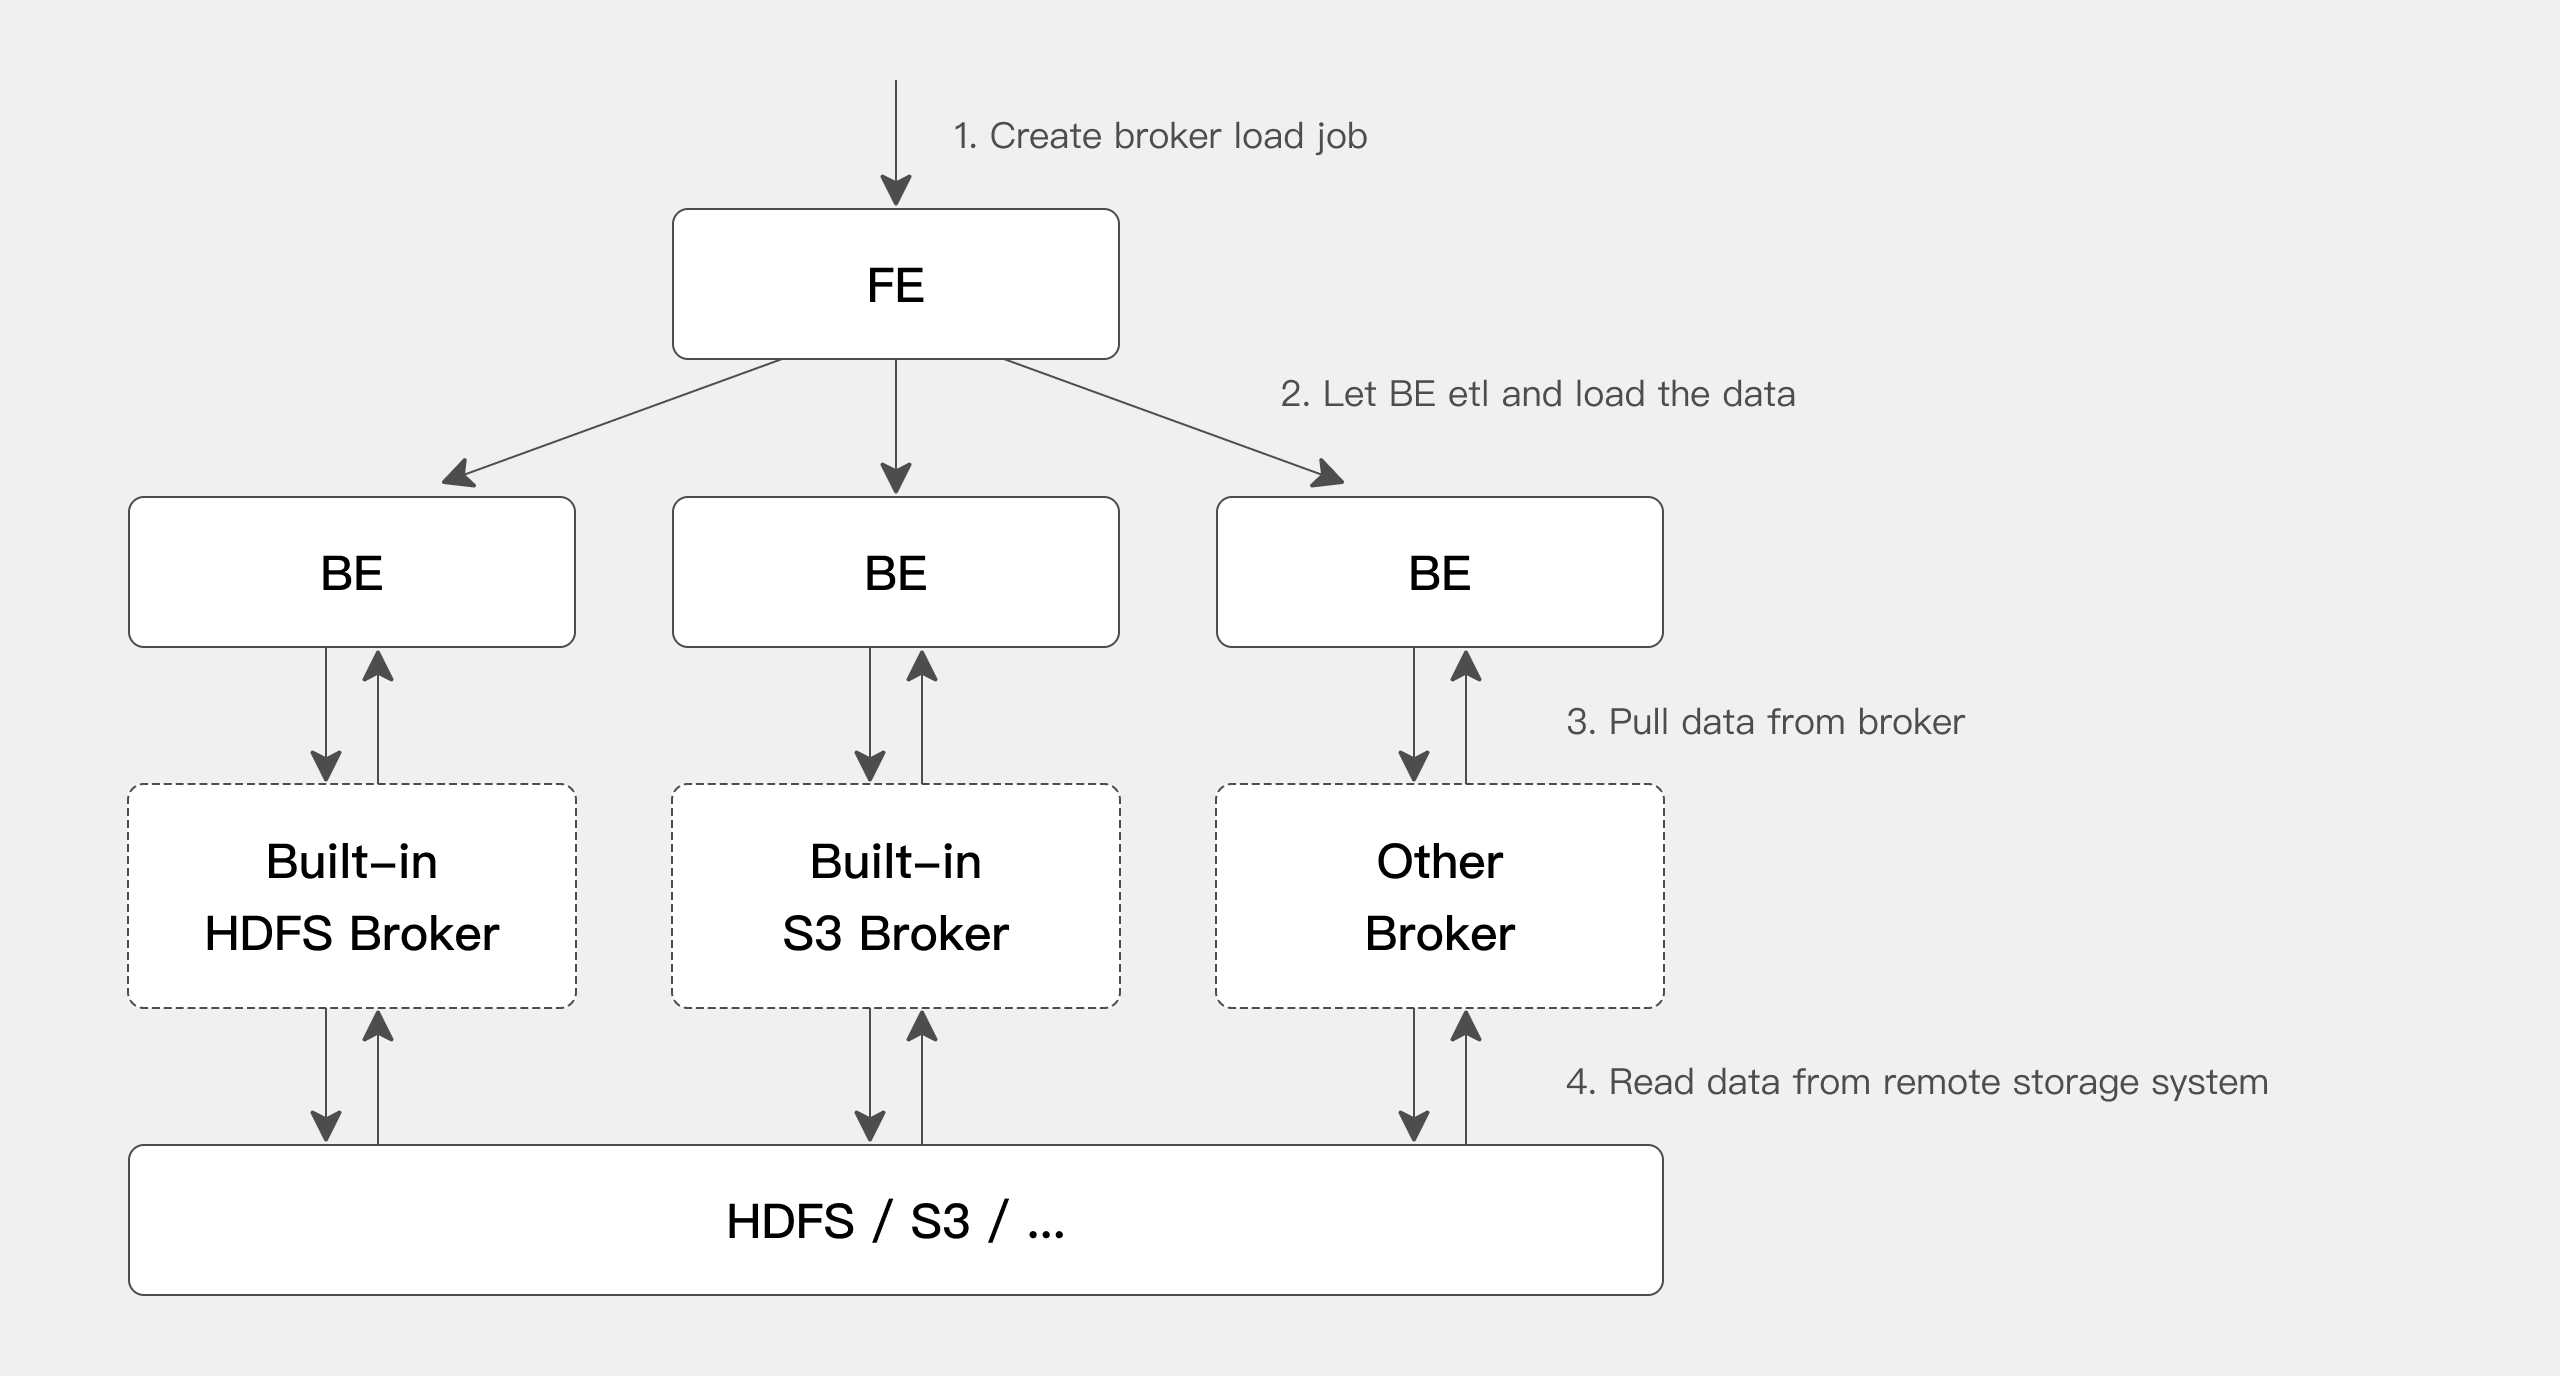
BE は Broker プロセスを通じてリモートストレージシステムからデータを読み取ります。Broker を導入する主な目的は次のとおりです。
- エコシステムとの互換性:Broker の規格に従って Java で開発できるため、ビッグデータのエコシステムにあるさまざまなストレージシステムに対応しやすくなります。
- 障害の分離:Broker プロセスを BE プロセスから分離することで、BE の安定性が向上します。
BE は HDFS と S3 を標準でサポートしているため、HDFS または S3 からのインポートに追加の Broker プロセスを起動する必要はありません。独自の Broker 実装を使用する場合は、対応する Broker プロセスをデプロイする必要があります。
クイックスタート
このセクションでは S3 Load を例に、手順全体を示します。完全な構文については、SQL マニュアルの Broker Load を参照してください。
事前確認
1. Doris のテーブル権限
Broker Load には、対象テーブルに対する INSERT 権限が必要です。この権限がない場合は、GRANT コマンドで付与してください。
2. S3 の認証情報と接続情報
AWS S3 を例にすると、必要な情報は次のように確認できます(他のオブジェクトストレージでも参考にしてください)。
| 情報 | 確認方法 |
|---|---|
| AK / SK | Access keys は、AWS コンソールの My Security Credentials で確認または作成します。 |
| REGION | バケット作成時に選択します。バケット一覧からも確認できます。 |
| ENDPOINT | AWS ドキュメント:S3 エンドポイントを参照してください。 |
インポートジョブの作成
ステップ 1:S3 に CSV ファイルを用意する
次の内容で brokerload_example.csv を作成します。
1,Emily,25
2,Benjamin,35
3,Olivia,28
4,Alexander,60
5,Ava,17
6,William,69
7,Sophia,32
8,James,64
9,Emma,37
10,Liam,64
ステップ 2:Doris に対象テーブルを作成する
CREATE TABLE testdb.test_brokerload(
    user_id            BIGINT       NOT NULL COMMENT "user id",
    name               VARCHAR(20)           COMMENT "name",
    age                INT                   COMMENT "age"
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
ステップ 3:Broker Load ジョブを投入する
バケット名と S3 認証情報を実際の値に置き換えてください。
LOAD LABEL broker_load_2022_04_01
(
    DATA INFILE("s3://your_bucket_name/brokerload_example.csv")
    INTO TABLE test_brokerload
    COLUMNS TERMINATED BY ","
    FORMAT AS "CSV"
    (user_id, name, age)
)
WITH S3
(
    "provider" = "S3",
    "AWS_ENDPOINT" = "https://s3.us-west-2.amazonaws.com",
    "AWS_ACCESS_KEY" = "<your-ak>",
    "AWS_SECRET_KEY"="<your-sk>",
    "AWS_REGION" = "us-west-2",
    "compress_type" = "PLAIN"
)
PROPERTIES
(
    "timeout" = "3600"
);
provider フィールドには、実際に使用するオブジェクトストレージのプロバイダーを指定します。Doris がサポートする provider の値は次のとおりです。
| provider | プロバイダー |
|---|---|
S3 | Amazon AWS |
AZURE | Microsoft Azure |
GCP | Google GCP |
OSS | Alibaba Cloud |
COS | Tencent Cloud |
OBS | Huawei Cloud |
BOS | Baidu Cloud |
一覧にないプロバイダー(MinIO など)の場合は、S3(AWS 互換モード)を試すことができます。
インポートジョブの確認
Broker Load は非同期インポートです。SHOW LOAD コマンドで具体的な結果を確認できます。
mysql> show load order by createtime desc limit 1\G;
*************************** 1. row ***************************
         JobId: 41326624
         Label: broker_load_2022_04_01
         State: FINISHED
      Progress: ETL:100%; LOAD:100%
          Type: BROKER
       EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=27
      TaskInfo: cluster:N/A; timeout(s):1200; max_filter_ratio:0.1
      ErrorMsg: NULL
    CreateTime: 2022-04-01 18:59:06
  EtlStartTime: 2022-04-01 18:59:11
 EtlFinishTime: 2022-04-01 18:59:11
 LoadStartTime: 2022-04-01 18:59:11
LoadFinishTime: 2022-04-01 18:59:11
           URL: NULL
    JobDetails: {"Unfinished backends":{"5072bde59b74b65-8d2c0ee5b029adc0":[]},"ScannedRows":27,"TaskNumber":1,"All backends":{"5072bde59b74b65-8d2c0ee5b029adc0":[36728051]},"FileNumber":1,"FileSize":5540}
1 row in set (0.01 sec)
インポートジョブのキャンセル
Broker Load ジョブの状態が CANCELLED または FINISHED でなければ、手動でキャンセルできます。キャンセル時にはジョブのラベルを指定します。構文については CANCEL LOAD を参照してください。
たとえば、ラベルが broker_load_2022_04_01 のインポートジョブをデータベース demo でキャンセルするには、次のコマンドを実行します。
CANCEL LOAD FROM demo WHERE LABEL = "broker_load_2022_04_01";
コンピュートグループの割り当て
ストレージとコンピュートの分離モードでは、Broker Load は次の優先順位でコンピュートグループを選択します。
use db@cluster文で指定されたコンピュートグループ。- ユーザープロパティ
default_compute_groupで指定されたコンピュートグループ。 - 現在のユーザーに権限があるコンピュートグループから一つ。
ストレージとコンピュートの統合モードでは、ユーザープロパティ resource_tags.location で指定されたコンピュートグループを選択します。指定がない場合は、default という名前のコンピュートグループを使用します。
リファレンス
インポートコマンドの構文
LOAD LABEL load_label
(
data_desc1[, data_desc2, ...]
[format_properties]
)
WITH [S3|HDFS|BROKER broker_name]
[broker_properties]
[load_properties]
[COMMENT "comments"];
WITH 句はストレージシステムへのアクセス方法を指定し、broker_properties にはその方法の設定パラメータを指定します。
| 句 | 説明 |
|---|---|
S3 | S3 プロトコルを使用するストレージシステム。 |
HDFS | HDFS プロトコルを使用するストレージシステム。 |
BROKER broker_name | その他のプロトコルを使用するストレージシステム。使用可能な broker_name は SHOW BROKER で確認できます。詳しくは、後述の「その他の Broker によるインポート」を参照してください。 |
インポート設定パラメータ
ロードプロパティ
| プロパティ名 | 型 | デフォルト | 説明 |
|---|---|---|---|
timeout | Long | 14400 | インポートのタイムアウト(秒)。範囲は 1 ~ 259200 秒です。 |
max_filter_ratio | Float | 0.0 | 許容する不正データの最大割合。デフォルトでは不正データを許容しません。値の範囲は 0 ~ 1 です。エラー率がこの値を超えるとインポートは失敗します。WHERE 条件で除外された行は不正データに含まれません。 |
strict_mode | Boolean | false | strict モードを有効にするかどうか。 |
partial_columns | Boolean | false | 列の部分更新を使用するかどうか。Merge on Write が有効な Unique Key テーブルでのみ有効です。 |
timezone | String | "Asia/Shanghai" | このインポートで使用するタイムゾーン。タイムゾーンに関連するすべての関数の結果に影響します。 |
load_parallelism | Integer | 8 | 各 BE で同時実行するインスタンス数の上限。 |
send_batch_parallelism | Integer | 1 | データ送信時のシンクノードの並列度。memtable-on-sink が無効な場合にのみ有効です。 |
load_to_single_tablet | Boolean | false | パーティションごとに一つのタブレットのみにインポートするかどうか。ランダムバケットを使用する OLAP テーブルでのみ指定できます。 |
priority | HIGH / NORMAL / LOW | NORMAL | インポートジョブの優先度。 |
フォーマットプロパティ
| パラメータ名 | 型 | デフォルト | 説明 |
|---|---|---|---|
skip_lines | Integer | 0 | CSV ファイルの先頭から指定した行数をスキップします。形式が csv_with_names または csv_with_names_and_types の場合は無効です。 |
trim_double_quotes | Boolean | false | フィールドの外側の二重引用符を除去するかどうか。 |
enclose | String | "" | フィールドに改行や区切り文字が含まれる場合に使用する囲み文字。たとえば、区切り文字が ,、囲み文字が ' の場合、'b,c' は一つのフィールドとして解析されます。 |
escape | String | "" | 囲み文字をエスケープするための文字。たとえば、エスケープ文字が \、囲み文字が ' の場合、フィールド 'b,\'c' は 'b,'c' として正しく解析されます。 |
- フォーマットパラメータは、区切り文字や引用符の処理など、ソースファイルの解析方法を定義します。
PROPERTIES句(LOAD文の内側)に指定します。 - ロードパラメータは、タイムアウトや再試行など、インポートの動作を制御します。最も外側の
PROPERTIESブロック(LOAD文の外側)に指定します。
LOAD LABEL s3_load_example (
    DATA INFILE("s3://bucket/path/file.csv")
    INTO TABLE users
    COLUMNS TERMINATED BY ","
    FORMAT AS "CSV"
    (user_id, name, age)
    PROPERTIES (
        "trim_double_quotes" = "true"  -- Format parameter
    )
)
WITH S3 (
    ...
)
PROPERTIES (
    "timeout" = "3600"  -- Load parameter
);
fe.conf のシステムレベル設定
次の Broker Load のシステムレベル設定は、すべての Broker Load インポートジョブに適用されます。主に fe.conf を変更して調整します。
| 設定項目 | 型 | デフォルト | 説明 |
|---|---|---|---|
min_bytes_per_broker_scanner | Long | 67108864 (64 MB) | 一つの BE が処理するデータ量の下限(バイト)。 |
max_bytes_per_broker_scanner | Long | 536870912000 (500 GB) | 一つの BE が処理するデータ量の上限(バイト)。一回のインポートジョブで扱えるデータ量の上限は、おおむね max_bytes_per_broker_scanner * number of BE nodes です。より大量のデータを扱う場合は、この値を適宜増やしてください。 |
max_broker_concurrency | Integer | 10 | 一つのジョブでのインポートの最大並列度。 |
default_load_parallelism | Integer | 8 | BE ノードごとの同時実行インスタンス数の上限。 |
broker_load_default_timeout_second | Integer | 14400 | Broker Load インポートのデフォルトタイムアウト(秒)。 |
インポートの並列度の計算
処理するデータ量の下限、最大並列度、ソースファイルのサイズ、クラスタ内の現在の BE 数によって、インポートの並列度が決まります。
Concurrency of this import = Math.min(source file size / min_bytes_per_broker_scanner, max_broker_concurrency, number of current BE nodes * load_parallelism)
Amount processed by a single BE for this import = source file size / concurrency of this import
セッション変数
| セッション変数 | 型 | デフォルト | 説明 |
|---|---|---|---|
time_zone | String | "Asia/Shanghai" | デフォルトのタイムゾーン。インポート時にタイムゾーン関連の関数の結果に影響します。 |
send_batch_parallelism | Integer | 1 | データ送信時のシンクノードの並列度。memtable-on-sink が無効な場合にのみ有効です。 |
インポート例
次の典型的なシナリオで、Broker Load の一般的な使い方を示します。
シナリオ 1:HDFS から TXT ファイルをインポートする
LOAD LABEL demo.label_20220402
(
    DATA INFILE("hdfs://host:port/tmp/test_hdfs.txt")
    INTO TABLE `load_hdfs_file_test`
    COLUMNS TERMINATED BY "\t"
    (id,age,name)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
)
PROPERTIES
(
    "timeout"="1200",
    "max_filter_ratio"="0.1"
);
シナリオ 2:NameNode HA 構成の HDFS からインポートする
LOAD LABEL demo.label_20220402
(
    DATA INFILE("hdfs://hafs/tmp/test_hdfs.txt")
    INTO TABLE `load_hdfs_file_test`
    COLUMNS TERMINATED BY "\t"
    (id,age,name)
)
with HDFS
(
    "hadoop.username" = "user",
    "fs.defaultFS"="hdfs://hafs",
    "dfs.nameservices" = "hafs",
    "dfs.ha.namenodes.hafs" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.hafs.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.hafs.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.hafs" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
PROPERTIES
(
    "timeout"="1200",
    "max_filter_ratio"="0.1"
);
シナリオ 3:ワイルドカードで二組のファイルを指定し、二つのテーブルにインポートする
Broker Load は、ファイルパスでワイルドカード(*、?、[...])と範囲パターン({1..10})をサポートします。完全な構文については、ファイルパスパターンを参照してください。
LOAD LABEL example_db.label2
(
    DATA INFILE("hdfs://host:port/input/file-10*")
    INTO TABLE `my_table1`
    PARTITION (p1)
    COLUMNS TERMINATED BY ","
    (k1, tmp_k2, tmp_k3)
    SET (
        k2 = tmp_k2 + 1,
        k3 = tmp_k3 + 1
    ),
    DATA INFILE("hdfs://host:port/input/file-20*")
    INTO TABLE `my_table2`
    COLUMNS TERMINATED BY ","
    (k1, k2, k3)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
ワイルドカードで file-10* と file-20* の二組のファイルを指定し、それぞれ my_table1 と my_table2 にインポートします。my_table1 にはパーティション p1 にインポートし、ソースファイルの二列目と三列目の値はそれぞれ 1 を加算して取り込みます。
シナリオ 4:ワイルドカードで HDFS からデータを一括インポートする
LOAD LABEL example_db.label3
(
    DATA INFILE("hdfs://host:port/user/doris/data/*/*")
    INTO TABLE `my_table`
    COLUMNS TERMINATED BY "\\x01"
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
区切り文字には Hive で一般的に使われるデフォルトの区切り文字 \\x01 を指定し、ワイルドカード * で data ディレクトリ配下のすべてのサブディレクトリにあるすべてのファイルを指定します。
シナリオ 5:Parquet 形式のデータをインポートする
LOAD LABEL example_db.label4
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    FORMAT AS "parquet"
    (k1, k2, k3)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
FORMAT AS を指定しない場合、デフォルトではファイルの拡張子から形式が判定されます。
シナリオ 6:ファイルパスからパーティションフィールドを抽出する
LOAD LABEL example_db.label5
(
    DATA INFILE("hdfs://host:port/input/city=beijing/*/*")
    INTO TABLE `my_table`
    FORMAT AS "csv"
    (k1, k2, k3)
    COLUMNS FROM PATH AS (city, utc_date)
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
my_table の列は k1, k2, k3, city, utc_date です。
ディレクトリ hdfs://hdfs_host:hdfs_port/user/doris/data/input/dir/city=beijing には、次のファイルが含まれます。
hdfs://hdfs_host:hdfs_port/input/city=beijing/utc_date=2020-10-01/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=beijing/utc_date=2020-10-02/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=tianji/utc_date=2020-10-03/0000.csv
hdfs://hdfs_host:hdfs_port/input/city=tianji/utc_date=2020-10-04/0000.csv
ファイルには k1, k2, k3 の三列だけが含まれます。city と utc_date の二列はファイルパスから抽出されます。
シナリオ 7:インポートするデータをフィルタリングする
LOAD LABEL example_db.label6
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    (k1, k2, k3)
    SET (
        k2 = k2 + 1
    )
    PRECEDING FILTER k1 = 1
    WHERE k1 > k2
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
ソースデータで k1 = 1 を満たし、変換後に k1 > k2 を満たす行だけがインポートされます。
シナリオ 8:ファイルパスから時間パーティションフィールドを抽出する
LOAD LABEL example_db.label7
(
    DATA INFILE("hdfs://host:port/user/data/*/test.txt")
    INTO TABLE `tbl12`
    COLUMNS TERMINATED BY ","
    (k2,k3)
    COLUMNS FROM PATH AS (data_time)
    SET (
        data_time=str_to_date(data_time, '%Y-%m-%d %H%%3A%i%%3A%s')
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username" = "user"
);
時間に %3A が含まれています。HDFS のパスでは : を使用できないため、すべての : を %3A に置き換えています。
パスには次のファイルが含まれます。
/user/data/data_time=2020-02-17 00%3A00%3A00/test.txt
/user/data/data_time=2020-02-18 00%3A00%3A00/test.txt
テーブル定義:
CREATE TABLE IF NOT EXISTS tbl12 (
    data_time DATETIME,
    k2        INT,
    k3        INT
) DISTRIBUTED BY HASH(data_time) BUCKETS 10
PROPERTIES (
    "replication_num" = "3"
);
シナリオ 9:MERGE を使ってインポートする
LOAD LABEL example_db.label8
(
    MERGE DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    (k1, k2, k3, v2, v1)
    DELETE ON v2 > 100
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
)
PROPERTIES
(
    "timeout" = "3600",
    "max_filter_ratio" = "0.1"
);
my_table は Unique Key テーブルである必要があります。インポートするデータで v2 > 100 の場合、その行は削除として扱われます。インポートのタイムアウトは 3600 秒で、許容するエラー率は 10% です。
シナリオ 10:source_sequence 列を指定して置換順序を保証する
LOAD LABEL example_db.label9
(
    DATA INFILE("hdfs://host:port/input/file")
    INTO TABLE `my_table`
    COLUMNS TERMINATED BY ","
    (k1,k2,source_sequence,v1,v2)
    ORDER BY source_sequence
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
my_table は Sequence 列を指定した Unique Key モデルのテーブルである必要があります。データの順序は、ソースデータの source_sequence 列の値によって保証されます。
シナリオ 11:json_root と jsonpaths を使って JSON をインポートする
LOAD LABEL example_db.label10
(
    DATA INFILE("hdfs://host:port/input/file.json")
    INTO TABLE `my_table`
    FORMAT AS "json"
    PROPERTIES(
      "json_root" = "$.item",
      "jsonpaths" = "[\"$.id\", \"$.city\", \"$.code\"]"
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
jsonpaths は column list および SET (column_mapping) と組み合わせて使用することもできます。
LOAD LABEL example_db.label10
(
    DATA INFILE("hdfs://host:port/input/file.json")
    INTO TABLE `my_table`
    FORMAT AS "json"
    (id, code, city)
    SET (id = id * 10)
    PROPERTIES(
      "json_root" = "$.item",
      "jsonpaths" = "[\"$.id\", \"$.city\", \"$.code\"]"
    )
)
with HDFS
(
    "fs.defaultFS"="hdfs://host:port",
    "hadoop.username"="user"
);
JSON ファイルのルートノードにある JSON オブジェクトをインポートするには、jsonpaths を $. に設定します。つまり、PROPERTIES("jsonpaths"="$.") を指定します。
詳細設定
S3 Load の URL アクセス形式
S3 SDK はデフォルトで仮想ホスト形式のアクセスを使用します。ただし、一部のオブジェクトストレージシステムでは仮想ホスト形式が有効になっていないか、サポートされていません。use_path_style パラメータを追加すると、パス形式を強制できます。
WITH S3
(
    "AWS_ENDPOINT" = "AWS_ENDPOINT",
    "AWS_ACCESS_KEY" = "AWS_ACCESS_KEY",
    "AWS_SECRET_KEY"="AWS_SECRET_KEY",
    "AWS_REGION" = "AWS_REGION",
    "use_path_style" = "true"
)
S3 Load の一時的な認証情報
S3 プロトコルをサポートするオブジェクトストレージへのアクセスには、一時的な認証情報(TOKEN)を使用できます。
WITH S3
(
    "AWS_ENDPOINT" = "AWS_ENDPOINT",
    "AWS_ACCESS_KEY" = "AWS_TEMP_ACCESS_KEY",
    "AWS_SECRET_KEY" = "AWS_TEMP_SECRET_KEY",
    "AWS_TOKEN" = "AWS_TEMP_TOKEN",
    "AWS_REGION" = "AWS_REGION"
)
HDFS の認証
1. 簡易認証
簡易認証では、Hadoop の設定 hadoop.security.authentication を simple に設定します。
(
    "username" = "user",
    "password" = ""
);
username にアクセスするユーザーを指定し、パスワードは空にします。
2. Kerberos 認証
この認証方式には、次の情報が必要です。
| パラメータ | 説明 |
|---|---|
hadoop.security.authentication | 認証方式に kerberos を指定します。 |
hadoop.kerberos.principal | Kerberos プリンシパルを指定します。 |
hadoop.kerberos.keytab | Kerberos キータブファイルのパスを指定します。このファイルは Broker プロセスが稼働するサーバー上の絶対パスに置き、Broker プロセスからアクセスできる必要があります。 |
kerberos_keytab_content | キータブファイルを base64 エンコードした内容を指定します。hadoop.kerberos.keytab とどちらか一方を使用してください。 |
例:
(
    "hadoop.security.authentication" = "kerberos",
    "hadoop.kerberos.principal" = "doris@YOUR.COM",
    "hadoop.kerberos.keytab" = "/home/doris/my.keytab"
)
(
    "hadoop.security.authentication" = "kerberos",
    "hadoop.kerberos.principal" = "doris@YOUR.COM",
    "kerberos_keytab_content" = "ASDOWHDLAWIDJHWLDKSALDJSDIWALD"
)
Kerberos 認証を使用する場合は、krb5.conf ファイルが必要です。このファイルには Kerberos の設定情報が含まれ、通常は /etc ディレクトリにインストールされます。KRB5_CONFIG 環境変数でデフォルトの場所を変更することもできます。krb5.conf の内容例を次に示します。
[libdefaults]
    default_realm = DORIS.HADOOP
    default_tkt_enctypes = des3-hmac-sha1 des-cbc-crc
    default_tgs_enctypes = des3-hmac-sha1 des-cbc-crc
    dns_lookup_kdc = true
    dns_lookup_realm = false

[realms]
    DORIS.HADOOP = {
        kdc = kerberos-doris.hadoop.service:7005
    }
HDFS HA モード
この設定は、HA モードで構成された HDFS クラスタへのアクセスに使用します。
| パラメータ | 説明 |
|---|---|
dfs.nameservices | HDFS サービスの名前(ユーザー定義)を指定します。例:"dfs.nameservices" = "my_ha"。 |
dfs.ha.namenodes.xxx | ユーザー定義の NameNode 名を指定します(複数ある場合はコンマで区切ります)。xxx は dfs.nameservices で定義した名前です。例:"dfs.ha.namenodes.my_ha" = "my_nn"。 |
dfs.namenode.rpc-address.xxx.nn | NameNode の RPC アドレスを指定します。nn は dfs.ha.namenodes.xxx に指定した NameNode 名です。例:"dfs.namenode.rpc-address.my_ha.my_nn" = "host:port"。 |
dfs.client.failover.proxy.provider.[nameservice ID] | クライアントが NameNode に接続する際に使用するプロバイダーを指定します。デフォルトは org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider です。 |
例:
(
    "fs.defaultFS" = "hdfs://my_ha",
    "dfs.nameservices" = "my_ha",
    "dfs.ha.namenodes.my_ha" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.my_ha.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.my_ha.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.my_ha" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
HA モードは、前述の二つの認証方式のどちらとも組み合わせられます。たとえば、簡易認証で HA 構成の HDFS にアクセスする場合は次のように指定します。
(
    "username"="user",
    "password"="passwd",
    "fs.defaultFS" = "hdfs://my_ha",
    "dfs.nameservices" = "my_ha",
    "dfs.ha.namenodes.my_ha" = "my_namenode1, my_namenode2",
    "dfs.namenode.rpc-address.my_ha.my_namenode1" = "nn1_host:rpc_port",
    "dfs.namenode.rpc-address.my_ha.my_namenode2" = "nn2_host:rpc_port",
    "dfs.client.failover.proxy.provider.my_ha" = "org.apache.hadoop.hdfs.server.namenode.ha.ConfiguredFailoverProxyProvider"
)
その他の Broker によるインポート
その他のリモートストレージシステムに対応する Broker は、Doris クラスタのオプションのプロセスです。主にリモートストレージ上のファイルやディレクトリの読み書きをサポートします。現在、Doris は次のリモートストレージシステム向けの Broker 実装を提供しています。
- Tencent Cloud CHDFS
- Tencent Cloud GFS
- JuiceFS
以前のバージョンでは、Doris はさまざまなオブジェクトストレージシステム向けの Broker もサポートしていました。しかし現在、オブジェクトストレージからのインポートには WITH S3 が推奨され、WITH BROKER は推奨されません。
Broker はステートレスな Java プロセスであり、RPC サービスポートを通じてサービスを提供します。リモートストレージの読み書きのために、POSIX に似たファイル操作(open、pread、pwrite など)をカプセル化します。Broker はその他の情報を記録しません。リモートストレージの接続情報、ファイル情報、権限情報など、必要な情報はすべて RPC 呼び出しのパラメータとして渡す必要があります。
Broker はデータ経路としてのみ機能し、計算には参加しないため、メモリ使用量は少なくなります。通常、Doris システムには一つ以上の Broker プロセスをデプロイします。同じ種類の Broker は名前(Broker 名)を持つグループを形成します。
Broker 情報
Broker 情報は名前と認証情報の二つの部分から構成されます。一般的な構文は次のとおりです。
WITH BROKER "broker_name"
(
    "username" = "xxx",
    "password" = "yyy",
    "other_prop" = "prop_value",
    ...
);
名前(Broker 名)
WITH BROKER "broker_name" 句で既存の Broker 名を指定します。Broker 名は、ALTER SYSTEM ADD BROKER コマンドで Broker プロセスを追加するときにユーザーが指定した名前です。通常、一つの名前は一つ以上の Broker プロセスに対応し、Doris はその名前で利用可能な Broker プロセスを選択します。クラスタ内の既存の Broker は SHOW BROKER で確認できます。
Broker 名はユーザーが定義した名前にすぎず、Broker の種類を表すものではありません。
認証情報
必要な認証情報は Broker の種類やアクセス方法によって異なります。通常、WITH BROKER "broker_name" の後に続くプロパティマップにキーと値のペアとして指定します。
各種 Broker の接続設定
Alibaba Cloud OSS
(
    "fs.oss.accessKeyId" = "",
    "fs.oss.accessKeySecret" = "",
    "fs.oss.endpoint" = ""
)
Baidu Cloud BOS
BOS を使用する場合は、対応する SDK パッケージをダウンロードしてください。具体的な設定と使用方法については、BOS HDFS の公式ドキュメントを参照してください。ダウンロードして展開した後、JAR パッケージを Broker の lib ディレクトリに配置します。
(
    "fs.bos.access.key" = "xx",
    "fs.bos.secret.access.key" = "xx",
    "fs.bos.endpoint" = "xx"
)
Huawei Cloud OBS
(
    "fs.obs.access.key" = "xx",
    "fs.obs.secret.key" = "xx",
    "fs.obs.endpoint" = "xx"
)
JuiceFS
(
    "fs.defaultFS" = "jfs://xxx/",
    "fs.jfs.impl" = "io.juicefs.JuiceFileSystem",
    "fs.AbstractFileSystem.jfs.impl" = "io.juicefs.JuiceFS",
    "juicefs.meta" = "xxx",
    "juicefs.access-log" = "xxx"
)
GCS
Broker 経由で GCS にアクセスする場合、Project ID は必須です。その他のパラメータは省略できます。すべてのパラメータ設定については、GCS の設定を参照してください。
(
    "fs.gs.project.id" = "Your Project ID",
    "fs.AbstractFileSystem.gs.impl" = "com.google.cloud.hadoop.fs.gcs.GoogleHadoopFS",
    "fs.gs.impl" = "com.google.cloud.hadoop.fs.gcs.GoogleHadoopFileSystem",
)
FAQ とトラブルシューティング
よくあるエラー
1. インポートエラー:Scan bytes per broker scanner exceed limit:xxx
「インポートのタイムアウト」のセクションを参照してください。FE の設定項目 max_bytes_per_broker_scanner と max_broker_concurrency を変更します。
2. インポートエラー:failed to send batch または TabletWriter add batch with unknown id
query_timeout と streaming_load_rpc_max_alive_time_sec を適宜調整します。
3. インポートエラー:LOAD_RUN_FAIL; msg:Invalid Column Name:xxx
PARQUET または ORC のデータでは、ファイルヘッダーの列名が Doris テーブルの列名と一致する必要があります。例:
(tmp_c1,tmp_c2)
SET
(
    id=tmp_c2,
    name=tmp_c1
)
これは、Parquet または ORC ファイルから (tmp_c1, tmp_c2) という名前の列を取得し、Doris テーブルの (id, name) 列に対応付けることを意味します。SET を指定しない場合は、column 内の列がマッピングに使用されます。
注意:一部の Hive バージョンが直接生成した ORC ファイルでは、ファイルヘッダーが Hive メタデータではなく
(_col0, _col1, _col2, ...)になるため、Invalid Column Nameエラーが発生することがあります。その場合はSETでマッピングしてください。
4. インポートエラー:Failed to get S3 FileSystem for bucket is null/empty
バケット情報が誤っているか、バケットが存在しないか、バケットの形式がサポートされていません。たとえば、GCS で _ を含むバケット名(s3://gs_bucket/load_tbl など)を作成すると、GCS へのアクセス時に S3 クライアントがエラーを返します。バケットパスの作成時には _ を使用しないことを推奨します。
5. インポートのタイムアウト
インポートのデフォルトの timeout は 4 時間です。タイムアウトが発生しても、最大タイムアウトを単純に引き上げることは推奨されません。一回のインポートに 4 時間以上かかる場合は、対象ファイルを分割して複数のバッチでインポートすることを推奨します。タイムアウトを大幅に長くすると、一回の失敗後に再試行するコストが非常に高くなるためです。
次の式を使うと、Doris クラスタが一回のインポートで処理できると見込まれる最大データ量を概算できます。
Expected maximum import file data volume = 14400s * 10M/s * number of BEs

For example, if the number of BEs in the cluster is 10:
Expected maximum import file data volume = 14400s * 10M/s * 10 = 1440000M ≈ 1440G

Note: A typical user environment may not reach 10M/s, so it is recommended to split files larger than 500G before importing.
関連情報
Broker Load の構文とベストプラクティスの詳細は、Broker Load コマンドのマニュアルを参照してください。MySQL クライアントのコマンドラインで HELP BROKER LOAD を実行して、ヘルプを確認することもできます。