継続データロードの概要
Doris の継続データロードは実験的機能であり、Doris 4.1.5 以降でサポートされています。
Doris は Streaming Job を通じて、複数のデータソースから Doris テーブルへ継続的にデータロードできます。Job の送信後、Doris はロードジョブを継続して実行し、ソースからデータをリアルタイムで読み取って Doris テーブルに書き込みます。
このドキュメントでは、次の質問に答えます。
- 継続データロードでサポートされるデータソースと同期モードは何ですか?
- SQL Mapping Sync と Auto Table Creation Sync はどのように選択しますか?
- ジョブの状態はどのように遷移し、自動リカバリはどのように機能しますか?
- 日常の運用でロードジョブを表示、停止、再開、削除するにはどうしますか?
- FE と Job の共通設定パラメータには何がありますか?
サポートされるデータソースと同期モード
継続データロードでは、次のデータソースと同期モードがサポートされます。S3 通知と一回限りのデータロードは Doris 4.1.6 以降でサポートされます。
| データソース | サポートバージョン | SQL Mapping Sync | Auto Table Creation Sync | 設定ガイド |
|---|---|---|---|---|
| MySQL | 5.6, 5.7, 8.0.x | SQL Mapping による MySQL CDC | Auto Table Creation による MySQL CDC | Amazon RDS MySQL · Amazon Aurora MySQL |
| PostgreSQL | 14, 15, 16, 17 | SQL Mapping による PostgreSQL CDC | Auto Table Creation による PostgreSQL CDC | Amazon RDS PostgreSQL · Amazon Aurora PostgreSQL |
| OceanBase | MySQL 互換モード | - | Auto Table Creation による OceanBase CDC | - |
| S3 | - | S3 継続データロード | - | - |
上流の列型を Doris 型にマッピングする方法については、MySQL、PostgreSQL、OceanBase のデータ型マッピングを参照してください。
同期方法の選択
SQL Mapping Sync と Auto Table Creation Sync は、基盤となるメカニズムが完全に異なる 2 つの継続データロード方法であり、「テーブル数」の違いではありません。Auto Table Creation Sync は include_tables を使って単一テーブルのみを同期することもできます。したがって、選択は必要な機能に基づいて行ってください。
機能比較
| 機能 | SQL Mapping Sync | Auto Table Creation Sync |
|---|---|---|
| 基盤メカニズム | Job + TVF(INSERT INTO tbl SELECT * FROM tvf()) | Job + ネイティブなデータベース全体の DDL(FROM src TO DATABASE db) |
| 対象レベル | 既存の Doris テーブル | Doris データベースコンテナ |
| 同期範囲 | 単一テーブル | 1 つから複数のテーブル、データベース全体まで(include_tables で制御) |
| 自動テーブル作成 | テーブルを事前に作成する必要があります | 初回同期時に主キー テーブルを自動作成します |
| SQL の柔軟性 | 列マッピング、フィルタリング、変換(SELECT 句)をサポート | 対象テーブルの名前変更と非キー列の除外をサポートします。SQL 式、行フィルタリング、データ変換はサポートしません |
| セマンティック保証 | exactly-once | at-least-once |
| 必要な権限 | Load | Load + Create(テーブルを自動作成する場合) |
| 代表的なシナリオ | SQL 式、型変換、条件付きフィルタリングが必要なリアルタイム同期 | データベース全体またはテーブル群のミラー レプリケーション。単純な対象テーブル名の変更や列の削減が可能 |
選択の推奨
- データに SQL 処理を適用する必要がある、または exactly-once セマンティクスに厳しい要件がある → SQL Mapping Sync を選択します
- Doris にテーブルを自動作成させ、1 つの設定でテーブル群を同期したい → Auto Table Creation Sync を選択します
- データソースが OceanBase → 現在は MySQL 互換モードの Auto Table Creation Sync のみがサポートされています
- データソースが S3 オブジェクトストレージ → SQL Mapping Sync のみがサポートされます(S3 TVF を使用)
ジョブ状態の遷移
Streaming Job は実行中に次の状態間を遷移します。SQL Mapping Sync と Auto Table Creation Sync は同じステートマシンに従います。
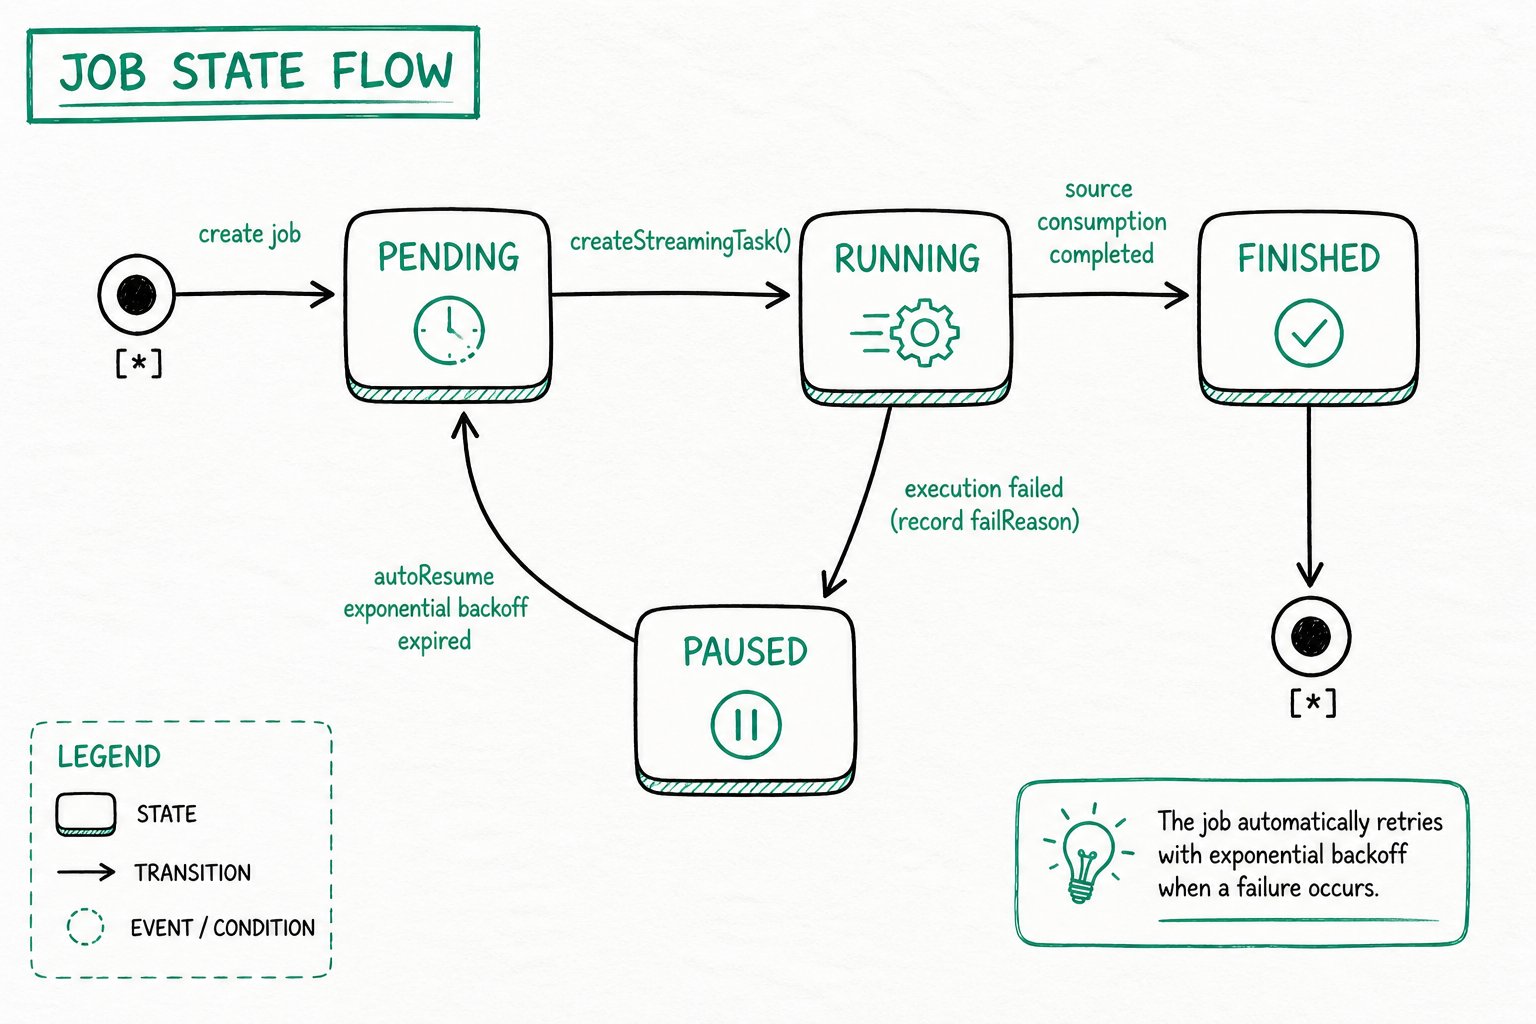
状態の説明
| 状態 | 意味 |
|---|---|
| PENDING | ジョブは作成済みですが、まだサブタスクがスケジュールされていません。次のスケジューリングラウンドで StreamingTask を作成するまで待機します。 |
| RUNNING | サブタスクが生成されて実行中です。ソースから増分データを読み取り、Doris に書き込みます。 |
| FINISHED | ソースの消費が完全に完了し、ジョブは終了しています。S3 TVF ジョブは、すべてのファイルのロード後にこの状態になります。 |
| PAUSED | サブタスクが失敗するとジョブは自動的に一時停止され、failReason が記録されます。原因は select * from jobs(...) の ErrorMsg フィールドで確認できます。 |
自動リカバリ(autoResume)
ジョブが PAUSED になると、スケジューラは 指数バックオフ戦略 により定期的にリカバリを試みます。リカバリするとジョブは PENDING に戻り、サブタスクの作成を続行します。手動操作は必要ありません。ネットワークの揺らぎや短時間の上流利用不可など、一時的な障害は自動的に吸収されます。
シナリオごとに適切なコマンドを使用してください。
- すぐに再開する、またはトラブルシューティング後に手動で開始する:
RESUME JOBを使用します - 完全に停止して以降はスケジュールしない:
PAUSE JOB(手動で一時停止したジョブは autoResume で起動されません)またはDROP JOBを使用します
CDC タスクの ID と失敗処理
4.1.5 以降、Streaming CDC は書き込み、テーブルメタデータのクエリ、スキーマ変更に固定の管理者 ID ではなく、ジョブ作成者の Doris identity を使用します。作成者には対象テーブルに対する LOAD、自動テーブル作成には CREATE、スキーマ同期には対応する ALTER とテーブルを可視化する権限が必要です。実行中に権限を取り消すと、後続タスクにも影響します。ジョブに記録された作成者の権限付与を確認してください。
cdc_stream() に基づく Streaming INSERT タスクが失敗しても、通常のタスク再試行フローには入りません。jobs() と tasks() でエラーを確認し、ソースまたは権限の問題を修正して、ジョブの状態に応じて再開してください。失敗したタスクが自動的に再生されるとは考えないでください。
共通操作
ロード状態の表示
すべての Streaming タイプの Insert Job をクエリします。
select * from jobs("type"="insert") where ExecuteType = "STREAMING";
結果列:
| 列 | 説明 |
|---|---|
| ID | Job ID |
| NAME | Job 名 |
| Definer | Job の定義者 |
| ExecuteType | Job のスケジューリングタイプ:ONE_TIME/RECURRING/STREAMING/MANUAL |
| RecurringStrategy | 繰り返し戦略。通常の Insert で使用され、ExecuteType=Streaming の場合は空です |
| Status | Job の状態 |
| ExecuteSql | Job の Insert SQL ステートメント |
| CreateTime | Job の作成時刻 |
| SucceedTaskCount | 成功したタスク数 |
| FailedTaskCount | 失敗したタスク数 |
| CanceledTaskCount | キャンセルされたタスク数 |
| Comment | Job のコメント |
| Properties | Job のプロパティ |
| CurrentOffset | Job が処理を完了したオフセット。ExecuteType=Streaming の場合のみ設定されます |
| EndOffset | データソースから取得した最大の EndOffset。ExecuteType=Streaming の場合のみ設定されます |
| LoadStatistic | Job の統計情報 |
| ErrorMsg | Job のエラーメッセージ |
| JobRuntimeMsg | Job の実行時ヒント |
| LagBytes | ソースログ(MySQL / OceanBase の binlog または PostgreSQL の WAL)におけるバックログのバイト数。-1 は現在値を利用できないことを示します。たとえば S3 データソースや完全なスナップショットフェーズなどです。 |
| LastSourceEventTimestamp | コミット済みオフセットに記録された最新のソースイベントのタイムスタンプ(Unix 秒)。利用できない場合は空です。 |
| LastTaskSuccessTime | 直近の Task が正常に完了した時刻 |
タスク状態の表示
Job ID で Job 配下のすべてのサブタスクをクエリします。
select * from tasks("type"="insert") where jobId='<job_id>';
結果列:
| 列 | 説明 |
|---|---|
| TaskId | Task ID |
| JobID | JobID |
| JobName | Job 名 |
| Label | ロードに使用される Task のラベル |
| Status | Task の状態 |
| ErrorMsg | Task の失敗メッセージ |
| CreateTime | Task の作成時刻 |
| StartTime | Task の開始時刻 |
| FinishTime | Task の終了時刻 |
| LoadStatistic | Task の統計情報 |
| User | Task の実行者 |
| RunningOffset | Task が現在同期しているオフセット情報。Job.ExecuteType=Streaming の場合のみ設定されます |
ロードジョブの一時停止
指定したジョブを手動で一時停止します(一時停止したジョブは autoResume で起動されません)。
PAUSE JOB WHERE jobname = <job_name>;
ロードジョブの再開
PAUSED 状態のジョブを再開します。
RESUME JOB WHERE jobName = <job_name>;
ロードジョブの削除
指定したジョブを完全に削除します。削除後、そのジョブはスケジュールされません。
DROP JOB WHERE jobName = <job_name>;
共通パラメータ
FE 設定パラメータ
| パラメータ | デフォルト | 説明 |
|---|---|---|
| max_streaming_job_num | 1024 | Streaming ジョブの最大数 |
| job_streaming_task_exec_thread_num | 10 | StreamingTask の実行に使用するスレッド数 |
| max_streaming_task_show_count | 100 | メモリに保持する StreamingTask 実行レコードの最大数 |
Job 共通ロード設定パラメータ
次のパラメータは CREATE JOB ... PROPERTIES (...) で設定します。特に指定がない限り、MySQL、PostgreSQL、OceanBase の継続データロードジョブで使用できます。
| パラメータ | デフォルト | 説明 |
|---|---|---|
max_interval | 10 | 上流に新しいデータがない場合のアイドルスケジューリング間隔(秒)。1 以上の整数のみ受け付け、10s などの単位サフィックスはサポートしません。 |
compute_group | 現在のセッションまたはユーザーのデフォルト計算グループ | コンピュートとストレージの分離モードでのみサポートされます。ジョブを実行する計算グループを指定します。明示的に設定する値を空にすることはできず、ユーザーにはその計算グループに対する USAGE 権限が必要です。このパラメータを設定せず、現在のセッションにもユーザーにも利用可能なデフォルト計算グループがない場合、ジョブの作成に失敗します。 |
session.<variable_name> | 対応するセッション変数のデフォルト値 | TVF モードでのみサポートされます。Job の INSERT タスクにセッション変数を設定します。たとえば session.insert_max_filter_ratio です。変数名と値は有効な Doris セッション変数でなければなりません。 |
Job Property として使用する offset は、CDC ジョブの初期位置を設定しません。ジョブの作成時に、FROM MYSQL、FROM POSTGRES、FROM OCEANBASE、または cdc_stream(...) のソースパラメータで初期位置を設定してください。CDC ジョブを一時停止した後は、ALTER JOB ... PROPERTIES ("offset" = '<json_offset>') によって位置をリセットできます。MySQL と OceanBase では {"file":"binlog.000001","pos":"154"} を使用し、PostgreSQL では {"lsn":"12345678"} を使用します。ALTER JOB が受け付けるのは正確な JSON オフセットだけです。
制限事項
同期範囲、自動テーブル作成、一貫性セマンティクス(exactly-once / at-least-once)については 機能比較 で説明しています。このセクションでは、サポートされない制約と動作のみを示します。
主キー テーブル
主キーを持つ上流テーブルのみ同期できます(どちらの同期方法でも同じです)。対応する Doris テーブルは Unique Key テーブルです。Auto Table Creation Sync では自動作成され、SQL Mapping Sync ではユーザーが作成します。主キーのないテーブルはサポートされません。
スキーマ変更(DDL)
DDL 同期は Auto Table Creation Sync 方法 にのみ適用されます。SQL Mapping Sync 方法 では DDL を一切同期しません。cdc_stream() テーブル関数は常に schema_change_enabled を false に強制します。
- MySQL、PostgreSQL、OceanBase:同期されるのは
ADD COLUMNとDROP COLUMNのみです。列型の変更、RENAME COLUMN、主キー・制約・インデックス・パーティションの変更は同期されません。Doris で手動適用してください。ソース固有の動作と制限については、MySQL、PostgreSQL、OceanBase のスキーマ変更同期を参照してください。
Auto Table Creation Sync では、スキーマ変更同期がデフォルトで有効です。現在、Doris にはこれを無効にする SQL プロパティはありません。
FAQ
MySQL 接続エラー:Public Key Retrieval is not allowed
原因: 設定された MySQL ユーザーは SHA256 パスワード認証を使用しており、TLS などのプロトコル経由でパスワードを送信する必要があります。
解決策 1: JDBC URL に allowPublicKeyRetrieval=true パラメータを追加します。
jdbc:mysql://127.0.0.1:3306?allowPublicKeyRetrieval=true
解決策 2: MySQL ユーザーの認証方式を mysql_native_password に変更します。
ALTER USER 'username'@'%' IDENTIFIED WITH mysql_native_password BY 'password';
FLUSH PRIVILEGES;