システムアーキテクチャ
このドキュメントでは、Apache Doris のシステムアーキテクチャについて、次の二つのデプロイメント方式の主要コンポーネントと、それらがどのように連携するかを説明します。
- ストレージ・コンピュート統合型アーキテクチャ:データの保存と計算を統合した従来の FE + BE アーキテクチャです。
- ストレージ・コンピュート分離型アーキテクチャ:メタデータ、コンピュート、ストレージを三つのレイヤーに分離します。
用途: アーキテクチャの選択、アーキテクチャの学習、運用面の理解。
ストレージ・コンピュート統合型アーキテクチャ
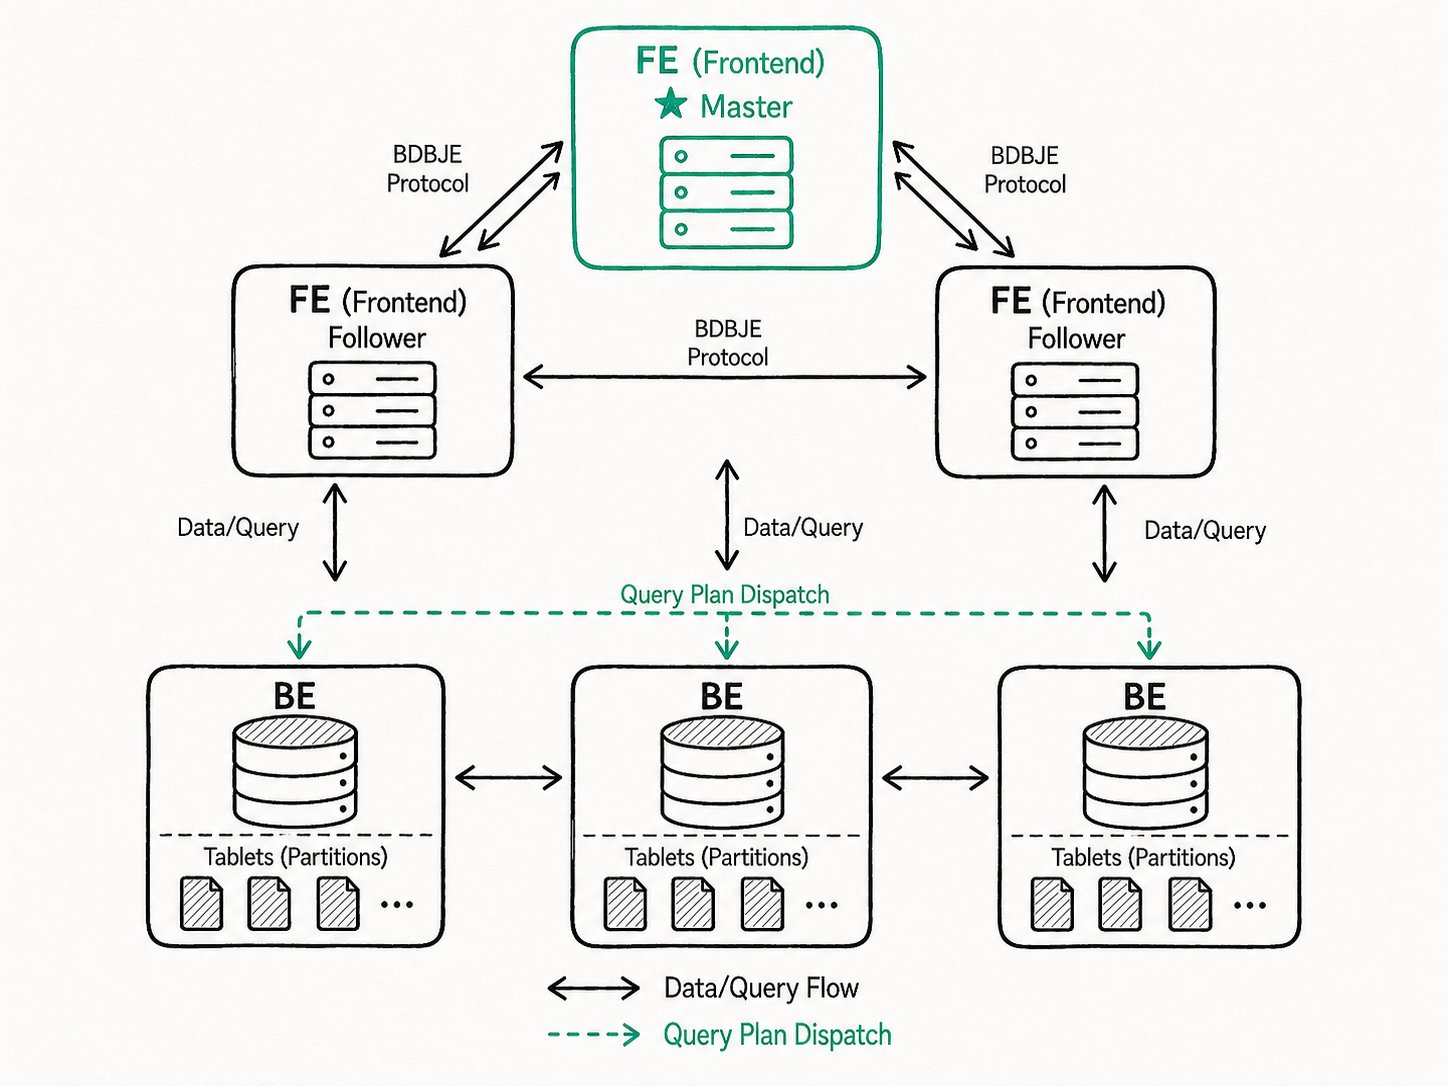
ストレージ・コンピュート統合型アーキテクチャは、Apache Doris の従来のデプロイメント方式です。**Frontend(FE)とBackend(BE)**の二種類のプロセスで構成されます。
主要コンポーネント
Frontend(FE)ノード
FE は Apache Doris のエントリーノードであり、調整と制御を担当します。
| 役割 | 説明 |
|---|---|
| ユーザーリクエストの処理 | MySQL プロトコルと互換性があり、標準 SQL をサポートします |
| クエリの解析と計画 | 字句解析 -> 意味解析 -> 論理プランの生成 -> CBO による最適化 -> 実行の指示 |
| メタデータ管理 | データベースとテーブルのスキーマ、レプリカの分布、ユーザー権限、クラスターの構成、ロードの状態を管理します |
| ノード管理 | ハートビートの検出、負荷分散、レプリカの修復、スケールアウトとスケールインを管理します |
FE はメタデータのストレージエンジンとして BDB JE を使用し、トランザクション機能をサポートします。ZooKeeper などの外部コンポーネントに依存しないため、デプロイと保守が簡単です。
Backend(BE)ノード
BE は計算とストレージを担当するノードです。
| 機能 | 説明 |
|---|---|
| カラム型ストレージ | データを列ごとに編成し、エンコーディングと圧縮を組み合わせて I/O 効率を高めます |
| データのシャーディング(Tablet) | データを水平方向に分割します。Tablet はレプリカのスケジューリングにおける最小単位です |
| 複数のレプリカ | 各 Tablet にはデフォルトで3つのレプリカがあり、異なる BE ノードに分散されます |
| ベクトル化実行 | 列指向のメモリレイアウトと SIMD による高速化を組み合わせ、幅の広いテーブルの集計で5~10倍の性能を実現します |
| パイプラインエンジン | スレッド数を制限しながら複数の CPU コアで並列処理を行い、スレッドの過剰な増加を防ぎます |
FE の高可用性
本番環境では複数の FE ノードをデプロイします。ロールの種類は次のとおりです。
| ロール | 役割 | 選出への参加 |
|---|---|---|
| Master | メタデータを読み書きし、Follower と Observer に同期します | 参加する |
| Follower | メタデータを読み取り、Master に障害が発生した場合は選出に参加します | 参加する |
| Observer | メタデータを読み取り、クエリの同時実行能力のみを拡張します | 参加しない |
メタデータの変更には、整合性を確保するためにノードの過半数による確認が必要です。
アーキテクチャの特徴
- シンプルで保守しやすい:プロセスは FE と BE の二種類だけです。
- 高性能:コンピュートノードがローカルストレージに直接アクセスするため、ネットワークのオーバーヘッドが小さくなります。
- 高可用性:複数のレプリカと自動的な障害分離を組み合わせています。
- 水平スケーリング:FE と BE の両方がオンラインでのスケールアウトをサポートします。
ストレージ・コンピュート分離型アーキテクチャ
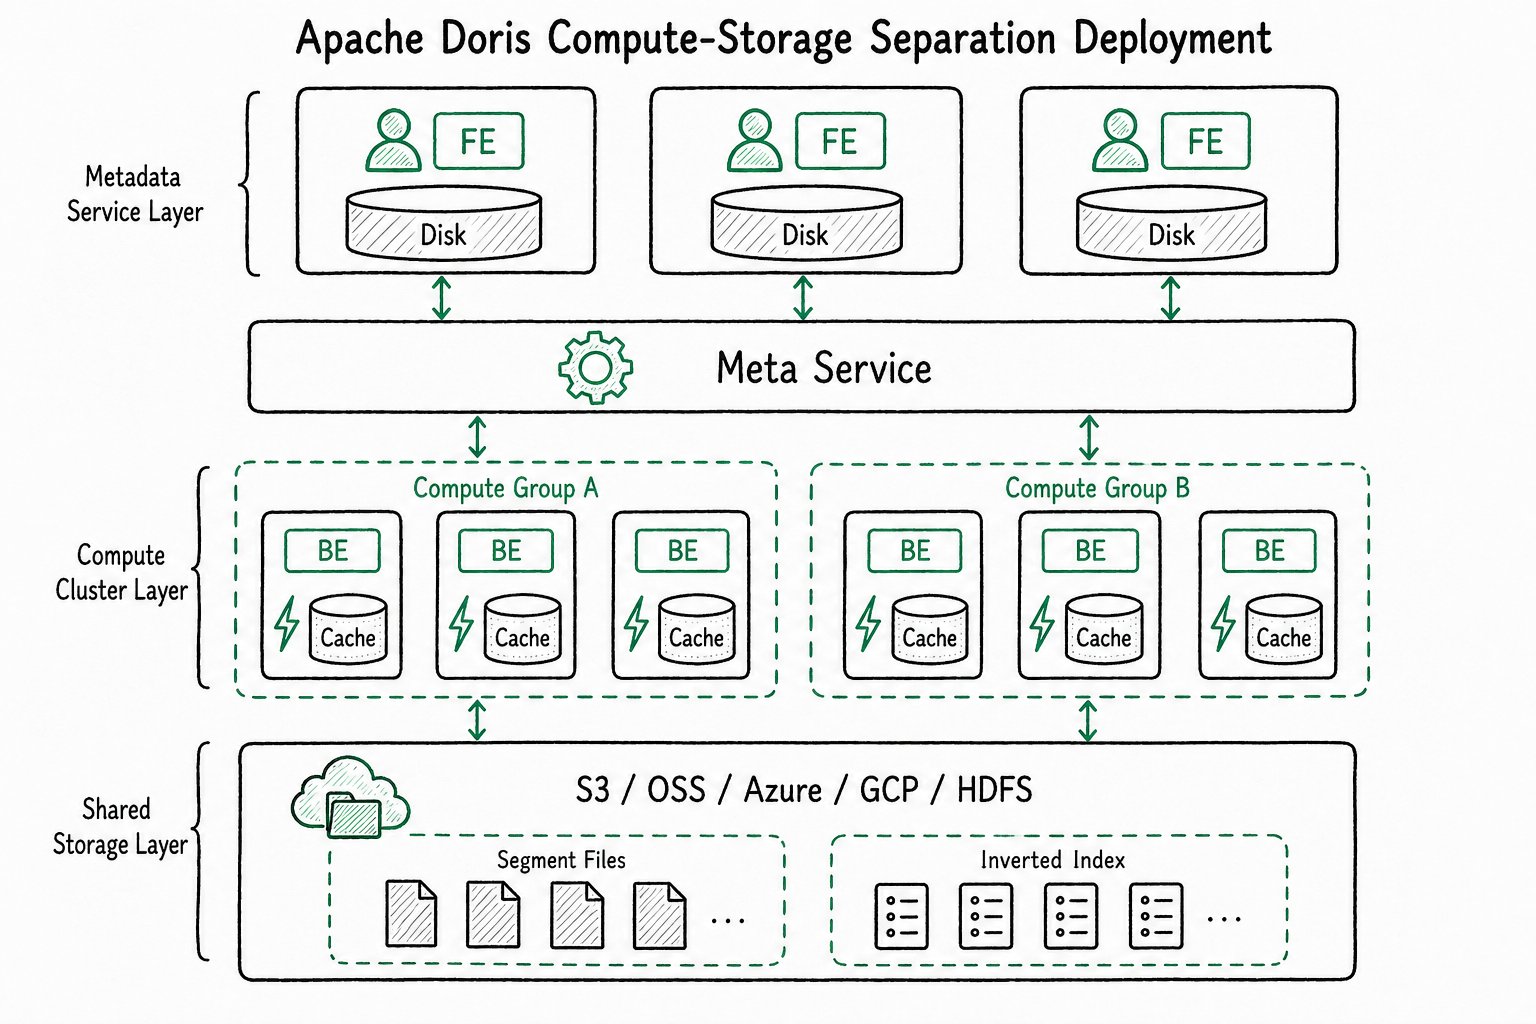
バージョン 3.0 で導入されたこのアーキテクチャでは、コンピュートレイヤーとストレージレイヤーを完全に分離し、それぞれを独立して柔軟にスケーリングできます。
主要コンポーネント
ストレージ・コンピュート分離型アーキテクチャでも FE ノードは維持され、引き続きユーザーリクエストの受け付けとクエリの解析を担当します。データレイヤーのメタデータを管理するために、新たに Meta Service が追加されます。
FE Frontend ノード
ストレージ・コンピュート分離型アーキテクチャでも、FE の役割は変わりません。
| 役割 | 説明 |
|---|---|
| ユーザーリクエストの処理 | MySQL プロトコルと互換性があり、標準 SQL をサポートし、認証と権限の検証を行います |
| クエリの解析と計画 | 字句解析 -> 意味解析 -> 論理プラン -> CBO による最適化 -> 実行の指示 |
| SQL レイヤーのメタデータ | データベースとテーブルのスキーマ、ユーザー権限、クラスターの構成を管理します |
メタデータレイヤー(Meta Service)
水平方向にスケーリングできるステートレスなサービスです。
| 役割 | 説明 |
|---|---|
| データ取り込みのトランザクション | バージョン管理と競合検出を行います |
| Tablet のメタデータ | データのバージョンとファイル一覧を管理します |
| Rowset のメタデータ | 復旧とガベージコレクションに使用する差分データの情報を管理します |
| クラスターのリソース | コンピュートグループのリソース割り当てとスケジューリングを行います |
コンピュートレイヤー
コンピュートレイヤーは複数のコンピュートクラスターで構成され、各クラスターには複数のステートレスな BE ノードが含まれます。コンピュートクラスターは同じデータを共有しますが、計算リソースはそれぞれ独立しています。
| 機能 | 説明 |
|---|---|
| 独立したリソース | 各コンピュートクラスターが異なる業務ワークロードを独立して処理します |
| ステートレスな BE | データを永続的に保存せず、アクセス頻度の高いデータだけをキャッシュします |
| 柔軟なスケーリング | ノードを追加または削除しても、ほかのコンピュートクラスターには影響しません |
| ローカルキャッシュ | アクセス頻度の高いデータを LRU ポリシーに従ってキャッシュし、アクセス遅延を減らします |
共有ストレージレイヤー
ストレージレイヤーは、セグメントファイルや転置インデックスファイルを含むすべてのデータファイルを永続的に保存します。
| サポートする種類 | 例 |
|---|---|
| オブジェクトストレージ | S3、OSS、COS、OBS、MinIO |
| 分散ファイルシステム | HDFS |
| Ceph | RGW、CephFS |
アーキテクチャの特徴
- コンピュートの柔軟なスケーリング:需要に応じてリソースを増減でき、負荷のピークと谷があるワークロードに適しています。
- ワークロードの分離:異なる業務チームがデータを共有しながら、計算リソースを独立させられます。
- 低いストレージコスト:オブジェクトストレージなど、低コストの選択肢を利用できます。
- 分単位のスケーリング:計算リソースをすばやく調整できます。
比較と選択
コンポーネントの機能比較
二つのアーキテクチャでは、コンポーネントの役割が次のように異なります。
| 比較項目 | ストレージ・コンピュート統合型 | ストレージ・コンピュート分離型 |
|---|---|---|
| FE ノード | すべてのメタデータを保存します | SQL レイヤーのメタデータのみを保存します |
| BE ノード | ステートフル(データを保存します) | ステートレス(アクセス頻度の高いデータのみをキャッシュします) |
| データの保存場所 | BE のローカルディスク | 共有ストレージレイヤー。BE のローカルディスクはキャッシュとして使用します |
| スケーリングの対象 | ストレージとコンピュートを一緒にスケーリングします | コンピュートとストレージを独立してスケーリングできます |
| ストレージコスト | 高い(SSD) | 低い(オブジェクトストレージ) |
| 運用の複雑さ | 低い | 高い(外部ストレージに依存します) |
| クエリのレイテンシー | 低い(ローカル I/O) | キャッシュミス時はやや高くなります。キャッシュヒット時は統合型アーキテクチャと同じです |
選択の指針
利用シナリオに応じて適切なアーキテクチャを選択します。
| シナリオ | ストレージ・コンピュート統合型 | ストレージ・コンピュート分離型 |
|---|---|---|
| 開発・テスト環境、簡単な試行 | ✓ | |
| 共有ストレージ(HDFS / Ceph / オブジェクトストレージ)が利用できない | ✓ | |
| 専任の DBA がおらず、複数のチームがそれぞれ保守する | ✓ | |
| 柔軟なスケーリングや Kubernetes によるコンテナ化が不要 | ✓ | |
| すでにパブリッククラウドにデプロイしている | ✓ | |
| 信頼性の高い共有ストレージシステムが利用できる | ✓ | |
| Kubernetes によるコンテナ化やプライベートクラウドでの柔軟なスケーリングが必要 | ✓ | |
| 複数のコンピュートクラスターでデータを共有する | ✓ | |
| 保守を担当する専任のプラットフォームチームがある | ✓ |
主要な技術モジュール
ストレージエンジン
カラム型ストレージと圧縮
データを列ごとに編成するため、クエリで使用する列だけを読み取り、I/O を削減します。辞書エンコーディング、ビットマップ圧縮、RLE などのアルゴリズムを組み合わせることで、高い圧縮率を実現します。
インデックス構造
| インデックスの種類 | 用途 |
|---|---|
| ソート済み複合キー(最大3列) | 同時実行数の多いレポート処理でのプルーニング |
| Min/Max | 数値型に対する等価条件と範囲条件での絞り込み |
| BloomFilter | カーディナリティの高い列に対する等価条件での絞り込み |
| 転置インデックス | 任意のフィールドに対する高速検索と全文検索 |
データモデル
| モデル | 特徴 | 用途 |
|---|---|---|
| Duplicate モデル | 明細データを保持します | ファクトテーブルの明細の保存 |
| Primary Key モデル | 一意の主キーを持ち、同じ主キーの行は上書きされます | 行単位の更新 |
| Aggregate モデル | 同じ主キーの行が自動的に集約されます | 事前集約による高速化 |
クエリエンジン
MPP 分散クエリ
複雑なクエリを複数のステージに分解し、複数の BE ノードで並列処理します。分散シャッフル結合をサポートし、大規模なテーブル同士の結合を効率的に処理します。
ベクトル化実行
列指向のメモリレイアウトと SIMD 命令を組み合わせ、幅の広いテーブルの集計で5~10倍の性能を実現します。
パイプライン実行エンジン
スレッド数を制限しながら複数の CPU コアで並列処理を行うことで、スレッドの過剰な増加を防ぎます。また、オペレーター間のデータコピーとメモリ割り当てのオーバーヘッドを削減します。
クエリオプティマイザー
| オプティマイザー | 戦略 |
|---|---|
| RBO | 定数畳み込み、サブクエリの書き換え、述語のプッシュダウン |
| CBO | コスト推定と結合順序の変更 |
| HBO | 過去のクエリを利用して繰り返し実行されるクエリを高速化します |
Runtime Filter
実行時にフィルターを動的に生成し、スキャンノードにプッシュダウンして処理するデータ量を減らします。サポートする種類には In、Min/Max、BloomFilter があります。
高可用性の仕組み
複数のレプリカとクォーラムプロトコル
- デフォルトで3つのレプリカを保存します。
- 書き込みが成功するには、過半数のレプリカ(たとえば2つ)による確認が必要です。
- 一部のノードに障害が発生してもデータは失われず、クラスターは利用可能な状態を維持します。
障害の自動分離
- ノードのハートビートのタイムアウトやレプリカの破損を検出します。
- ノードを利用不可としてマークし、そのノードへのタスクの割り当てを停止します。
- 正常なレプリカから不足しているレプリカを自動的に再作成します。
- 復旧後、差分データを自動的に同期します。
FE の高可用性
Paxos に似たコンセンサスプロトコルにより、メタデータの整合性を確保します。Master に障害が発生すると、Follower が自動的に新しい Master を選出します。この切り替えをユーザーが意識する必要はありません。
FAQ
Q: ストレージ・コンピュート統合型と分離型のアーキテクチャの主な違いは何ですか?
統合型アーキテクチャでは、BE ノードがデータの保存と計算の両方を担当し、データはローカルディスクに保存されます。分離型アーキテクチャでは、データは共有ストレージレイヤー(S3 や HDFS など)に保存され、BE ノードはローカルキャッシュを使用してクエリを高速化するステートレスなコンピュートノードとして動作します。分離型アーキテクチャでは、コンピュートとストレージのリソースを独立して柔軟にスケーリングできます。
Q: ストレージ・コンピュート分離型アーキテクチャは、どのような場合に選択すべきですか?
分離型アーキテクチャは、すでにパブリッククラウドにデプロイしている場合、Kubernetes によるコンテナ化が必要な場合、信頼性の高い共有ストレージシステム(HDFS、Ceph、オブジェクトストレージ)を利用できる場合、複数のコンピュートクラスターでデータを共有する必要がある場合、保守を担当する専任のプラットフォームチームがある場合に適しています。シンプルな用途や開発・テスト環境には、統合型アーキテクチャのほうが適しています。
Q: ストレージ・コンピュート分離型アーキテクチャでは、BE ノードはデータを保存しますか?
分離型アーキテクチャの BE ノードはステートレスで、データ自体を永続的には保存しません。ただし、オブジェクトストレージのランダム読み取り性能が比較的低いことや、ネットワーク転送によるオーバーヘッドが引き起こす遅延を抑えるため、BE ノードはローカル SSD にアクセス頻度の高いデータをキャッシュします。このキャッシュには LRU 方式の退避ポリシーが適用されます。
Q: ストレージ・コンピュート分離型アーキテクチャでの FE の役割は何ですか?
分離型アーキテクチャでも FE は維持され、主にユーザーリクエストの受け付け、SQL の解析と計画、SQL レイヤーのメタデータ管理(データベースとテーブルのスキーマ、ユーザー権限、クラスターの構成)を担当します。Tablet や Rowset のメタデータなど、データレイヤーのメタデータは、新たに追加された Meta Service が管理します。
Q: Doris はどのように高可用性を実現しますか?
Doris は複数のレプリカとクォーラムプロトコルによって高可用性を実現します。各 Tablet にはデフォルトで3つのレプリカがあり、書き込みには過半数による確認が必要です。一部のノードに障害が発生した場合は、そのノードを自動的に分離し、正常なレプリカからレプリカを再作成します。FE は Paxos に似たコンセンサスプロトコルでメタデータの整合性を確保し、現在の Master に障害が発生すると、新しい Master を自動的に選出します。
Q: ストレージ・コンピュート分離型アーキテクチャでの Meta Service の役割は何ですか?
Meta Service は、分離型アーキテクチャでデータレイヤーのメタデータ管理を専門に行うステートレスなサービスです。データ取り込みのトランザクション処理(バージョン管理と競合検出)、Tablet と Rowset のメタデータ管理、コンピュートクラスターのリソース割り当てとスケジューリングを担当します。ステートレスであるため、水平方向にスケーリングしてメタデータの処理能力を高められます。
まとめ
Apache Doris は、異なるニーズに対応する二つのアーキテクチャを提供します。
| アーキテクチャ | 用途 |
|---|---|
| ストレージ・コンピュート統合型 | 性能を優先し、運用リソースが限られ、規模を管理しやすい場合 |
| ストレージ・コンピュート分離型 | クラウドネイティブ、柔軟なスケーリング、複数のチームによるデータ共有が必要な場合 |
どちらのアーキテクチャも、データの信頼性とサービスの安定性を確保するための包括的な高可用性の仕組みを備えています。