Apache Doris の概要
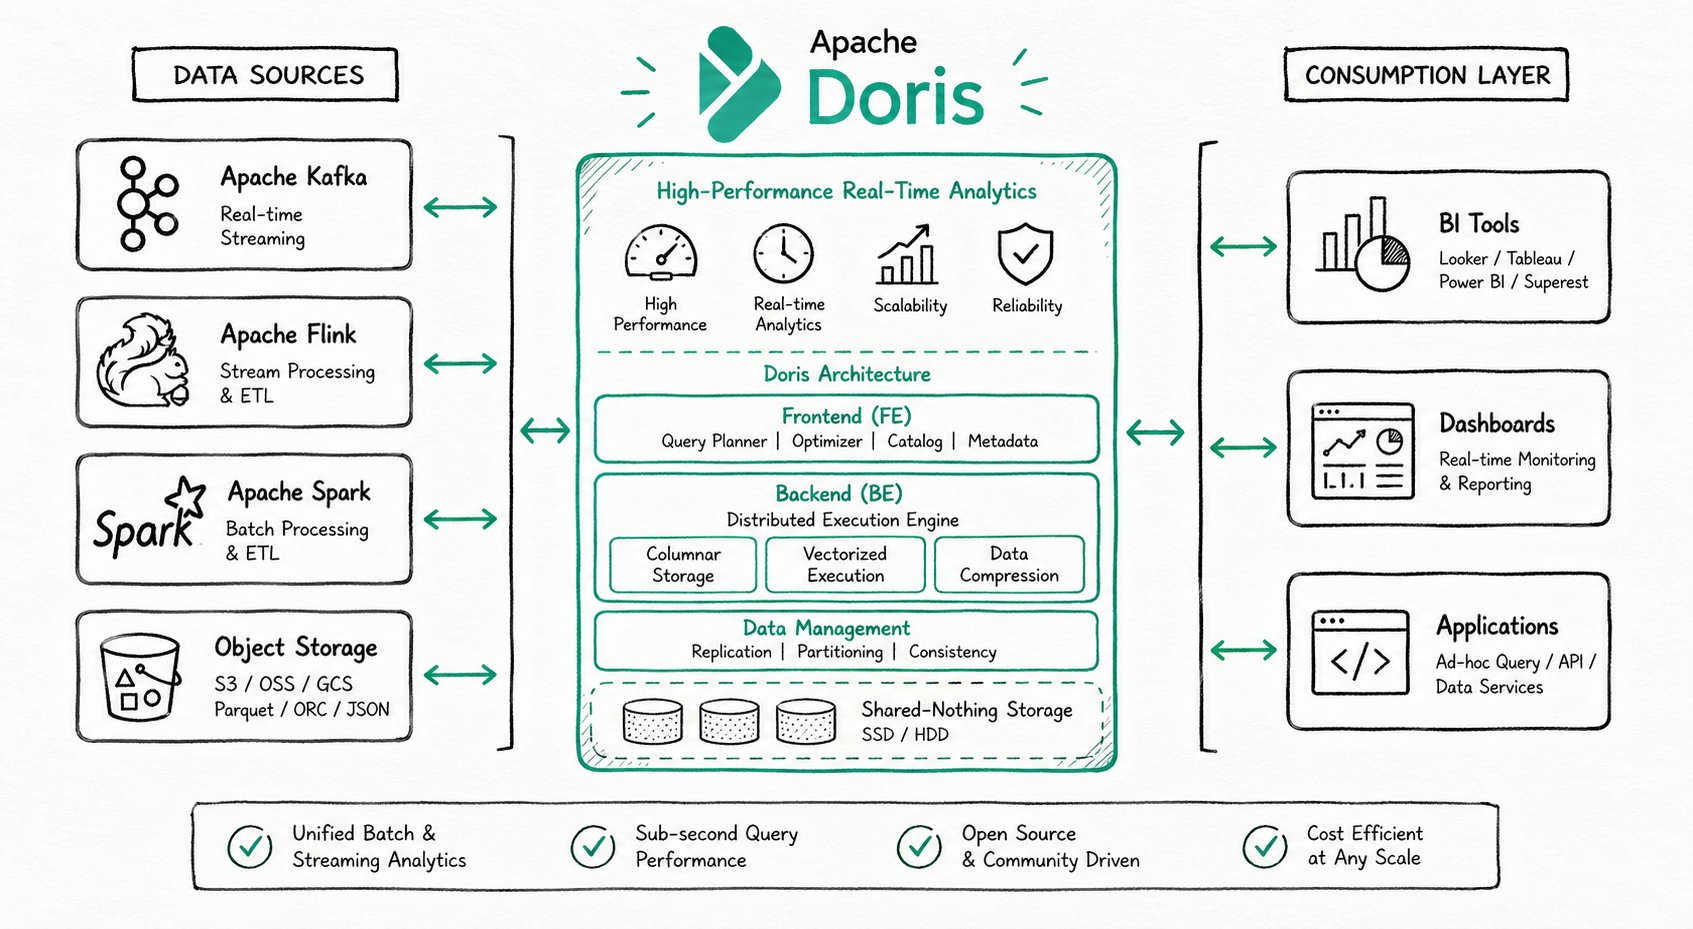
Apache Doris は MPP アーキテクチャに基づく高性能なリアルタイム分析データベースです。効率性、シンプルさ、統合性を特徴とし、大規模なデータセットに対するクエリを 1 秒未満で返します。単一のシステムで、同時実行数の多いポイントクエリと、高スループットの複雑な分析に対応します。
主な特長
| 機能 | データ |
|---|---|
| クエリのレイテンシ | < 1 秒(1 秒未満の応答) |
| 取り込みのレイテンシ | 秒単位(リアルタイムのデータ取り込み) |
| 同時実行性能 | 10,000+ QPS |
| ストレージ規模 | PB 規模 / クラスターあたり数百台のマシン |
| SQL インターフェース | MySQL プロトコル互換レイヤー、ANSI SQL 構文 |
代表的なユースケース
Apache Doris は、主に次の 3 種類の用途で利用されています。
リアルタイムデータ分析
社内外のリアルタイムレポート、ダッシュボード、ユーザー行動分析、A/B テスト基盤、ログの検索と分析。
代表例:
- リアルタイムダッシュボード:「独身の日」の注文量を秒単位で更新して監視
- ユーザープロファイル分析:オーディエンスのセグメント化と精度の高いマーケティング
- ログの検索と分析:トラブルシューティングと性能最適化
レイクハウス分析
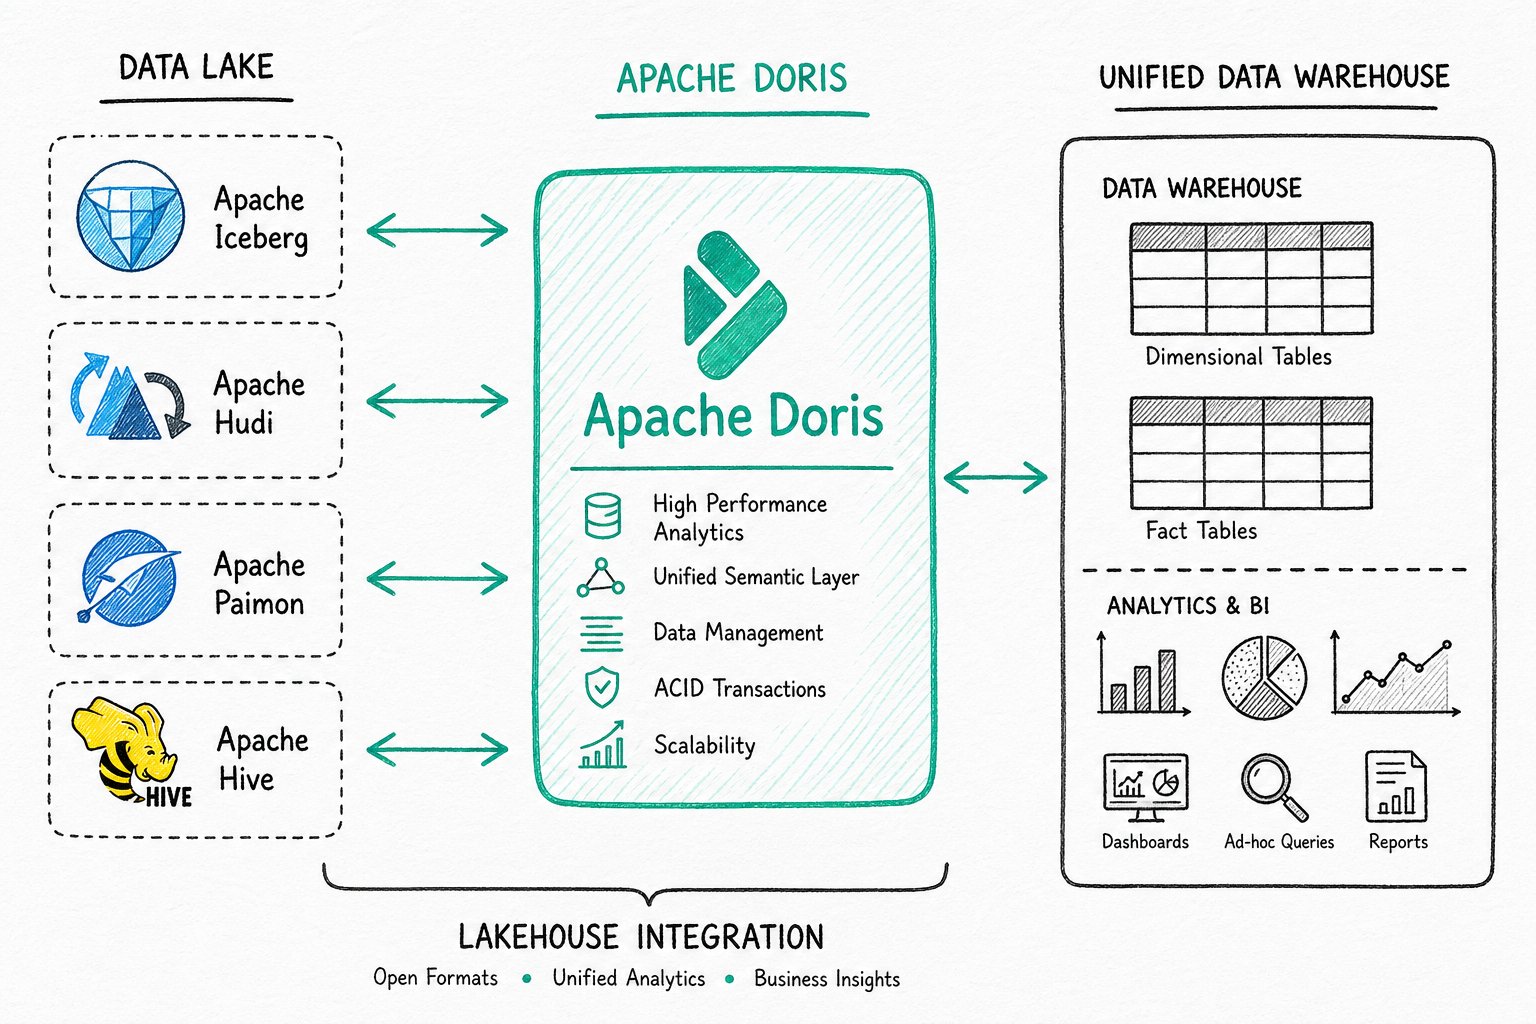
統合データウェアハウスの構築、データレイクに対する連合クエリの高速化、複数のワークロードを組み合わせた分析。
ハイブリッド検索と分析(AI データスタック)
大規模モデルの時代に向けて、Apache Doris は全文検索、ベクトル検索、AI 関数を深く統合しています。データの保存、検索、分析を網羅する AI データスタックを構築できます。
| シナリオ | 説明 |
|---|---|
| AI エージェント向け分析 | AI エージェントによるミリ秒単位のリアルタイム意思決定(不正検知、インテリジェントな推薦) |
| ハイブリッド検索と分析 | 1 つの SQL 文で、ベクトル類似度検索、キーワードによる絞り込み、集計分析を実行 |
| RAG アプリケーション | 企業のナレッジベースを使う Q&A、インテリジェントなカスタマーサービス、文書アシスタント |
| セマンティック検索 | 言語をまたぐ検索、同義語の認識、意図の理解 |
| AI オブザーバビリティ | モデル学習の監視、推論のトレース、ログ分析 |
システムアーキテクチャ
Apache Doris は MySQL プロトコルとの高い互換性を持ち、標準 SQL に対応しています。さまざまなクライアントツールからアクセスでき、BI ツールとも容易に連携できます。デプロイ時には、業務要件に応じてストレージ・コンピュート一体型アーキテクチャまたはストレージ・コンピュート分離型アーキテクチャを選べます。
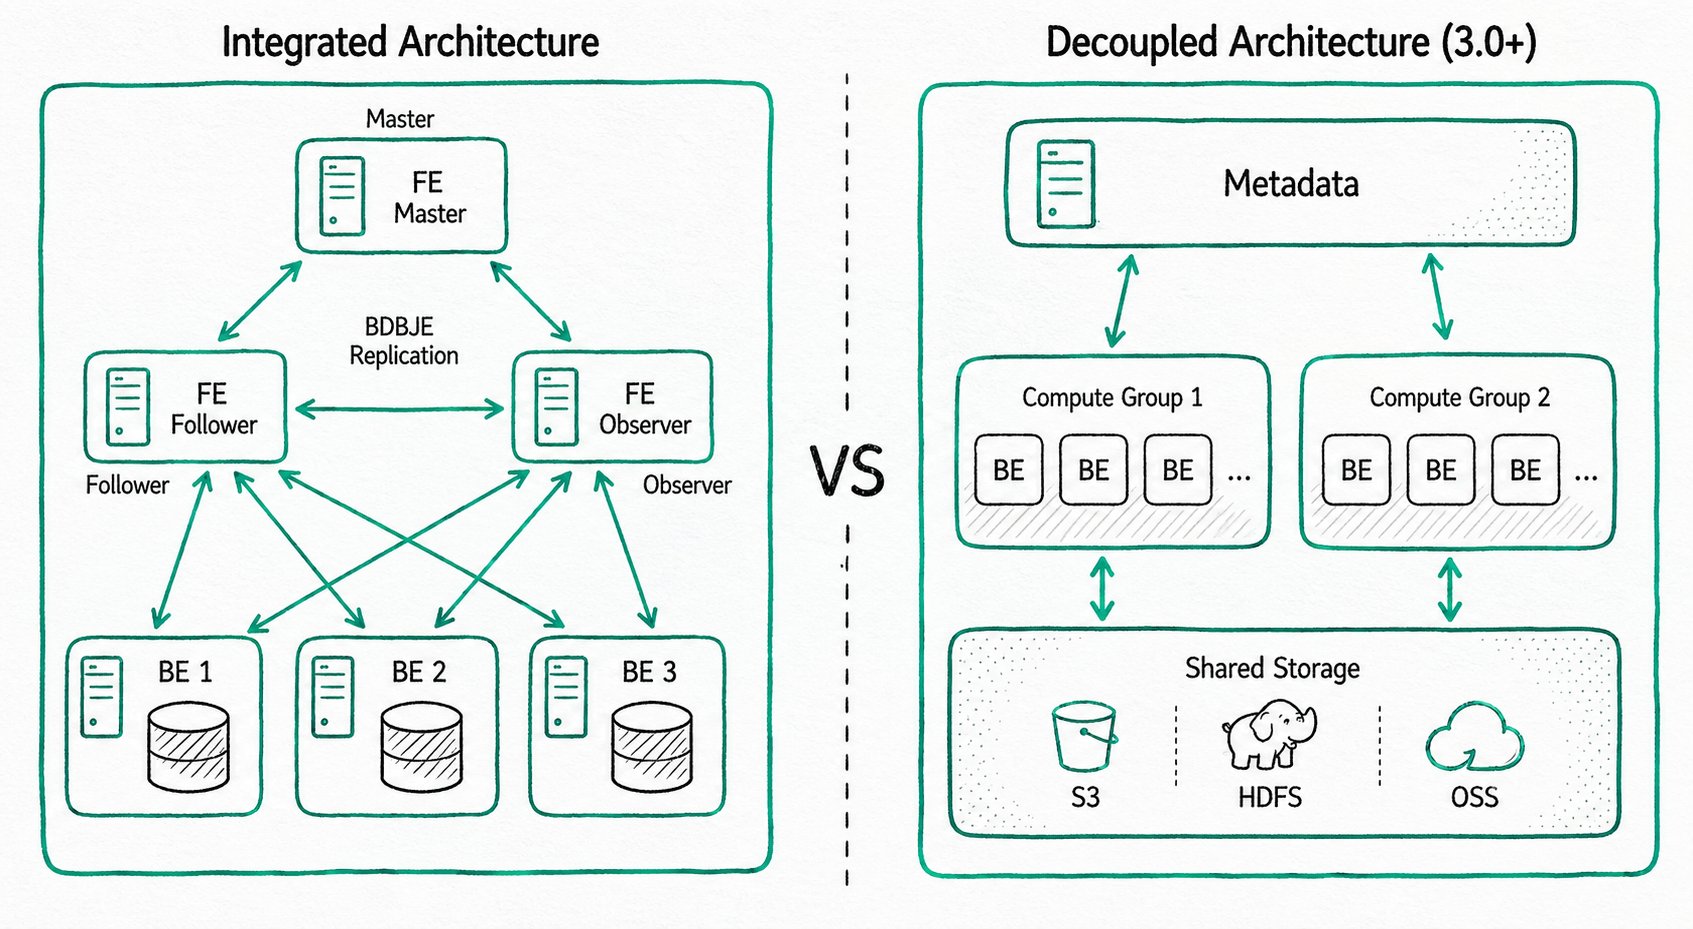
ストレージ・コンピュート一体型アーキテクチャ
次の 2 種類のプロセスからなるシンプルな構成です。
- Frontend(FE):リクエストの受信、クエリの解析、メタデータ管理、ノード管理
- Backend(BE):データの保存とクエリの実行(複数レプリカによる保存)
本番環境では、高可用性を確保するために複数の FE ノードを配置します。FE ノードには Master、Follower、Observer の 3 つの役割があります。
ストレージ・コンピュート分離型アーキテクチャ(共有ストレージ)
ストレージとコンピュートを分離することで、ストレージ容量とコンピュートリソースを独立して拡張できます。
- コンピュートレイヤー:複数のコンピュートグループを配置し、それぞれを独立したテナントとして利用可能
- ストレージレイヤー:S3、HDFS、OSS などの共有ストレージ
選び方:事業規模が管理しやすい範囲に収まり、運用のシンプルさを重視する場合は一体型を選びます。柔軟な拡張が必要な場合は分離型を選びます。
技術的な特長
ストレージエンジン
Apache Doris は列指向ストレージを採用し、列ごとにデータをエンコード、圧縮、読み取りします。高い圧縮率を実現するとともに、不要なデータのスキャンを減らし、IO と CPU リソースを効率的に使います。10,000 以上の列を持つ超ワイドテーブル向けにも最適化されており、疎な列を効率よく保存・検索できます。さまざまな業務要件に応えるため、複数のインデックス構造(Sorted Compound Key、Min/Max、BloomFilter、転置インデックス、ベクトルインデックス)とストレージモデル(Duplicate モデル、Aggregate モデル、Unique モデル)を提供します。また、強い整合性を持つ単一テーブルのマテリアライズドビューと、非同期に更新する複数テーブルのマテリアライズドビューに対応します。
- 列指向ストレージ:列ごとのエンコード、圧縮、読み取りにより、高い圧縮率と IO の削減を実現
- 複数のインデックス:Sorted Compound Key、Min/Max、BloomFilter、転置インデックス、ベクトルインデックス
- ストレージモデル:Duplicate モデル、Aggregate モデル、Unique モデル(行単位の更新に対応)
- マテリアライズドビュー:強い整合性を持つ単一テーブルのビューと、非同期に更新する複数テーブルのビュー
ベクトルインデックスと転置インデックスは、ハイブリッド検索と分析を支える主要な技術です。詳細は AI の概要を参照してください。
クエリエンジン
Apache Doris のクエリエンジンは MPP(Massively Parallel Processing)アーキテクチャに基づき、ノード間とノード内の並列実行、および大規模テーブル間の分散 Shuffle Join に対応します。複雑な複数テーブルの結合では、グローバルなクエリプランニング、分散結合戦略、Runtime Filter によってデータ転送を大幅に減らし、結合を高速化します。メモリ内の全構造を列形式に配置するベクトル化実行により、仮想関数呼び出しを減らし、キャッシュヒット率を高め、SIMD 命令を効率的に使います。これにより、ワイドテーブルの集計では 5~10 倍の性能向上を実現します。Adaptive Query Execution(AQE)と Pipeline 実行エンジンを組み合わせ、実行時の統計情報に応じてプランを動的に最適化し、マルチコア CPU を十分に活用します。
- MPP アーキテクチャ:ノード間とノード内の並列実行、大規模テーブルの分散 Shuffle Join
- ベクトル化実行:メモリ内の列形式レイアウトと SIMD 命令により、5~10 倍の性能向上
- Adaptive Query Execution(AQE):Runtime Filter による結合の動的最適化
- Pipeline 実行エンジン:マルチコア CPU 上の並列実行。スレッド数を制限して過剰な増加を抑制
ハイブリッド検索機能(AI 対応)
Apache Doris は、1 つの SQL 文で構造化データの分析、全文検索、ベクトル検索を組み合わせます。単一のシステムでベクトル類似度検索、キーワードによる絞り込み、集計分析を実行でき、データの移行や異種システムの統合は不要です。動的な JSON 構造にネイティブ対応する VARIANT 型と、秒単位でフィールドを変更できる Light Schema Change を組み合わせ、RAG アプリケーション、セマンティック検索、企業ナレッジベースなどの AI シナリオを効率的に支援します。
SELECT * FROM products
WHERE match(query_vector, 'summer breathable shoes')  -- Vector similarity search
  AND body MATCH 'breathable lightweight'           -- Full-text keyword search
  AND category_id = 1                                -- Structured filtering
GROUP BY brand
ORDER BY sales_count DESC;
- 統合アーキテクチャ:データ移行や異種システムの統合が不要
- ハイブリッドクエリの性能:1 つの SQL 文でベクトル、キーワード、集計処理を同時に実行
- VARIANT 型:動的な JSON にネイティブ対応。Light Schema Change で秒単位のフィールド変更が可能
エコシステムとの連携
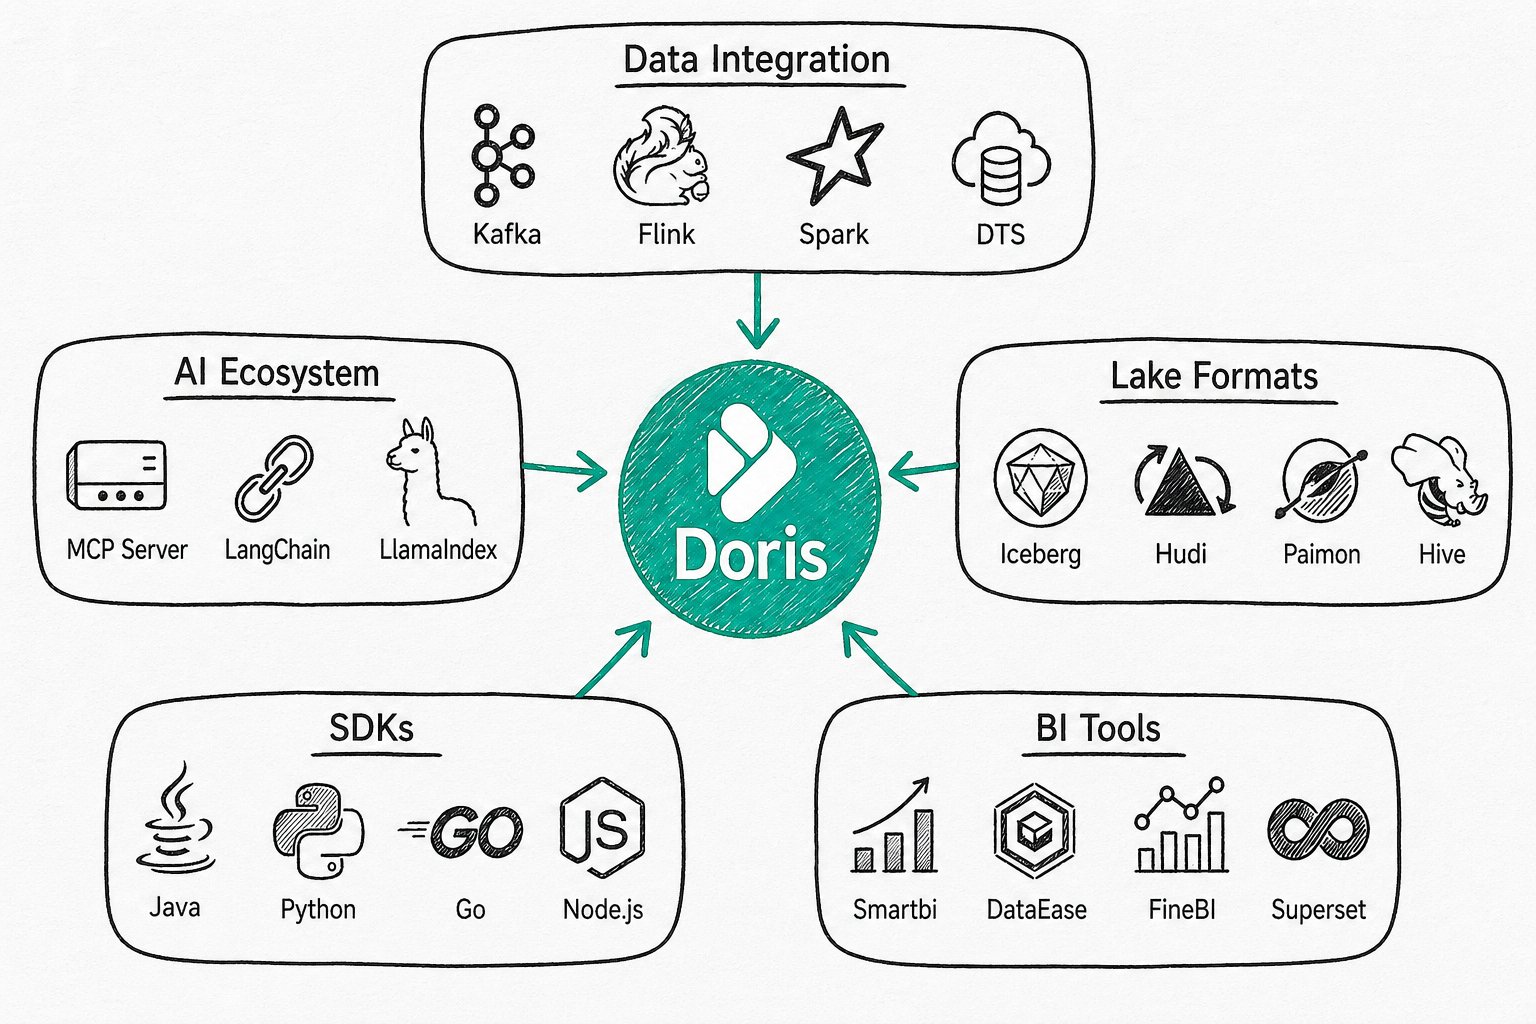
Apache Doris は、主要なデータエコシステムと深く統合されています。
コミュニティと貢献
コミュニティへの参加を歓迎します:コミュニティへの参加を参照してください。
