データモデル
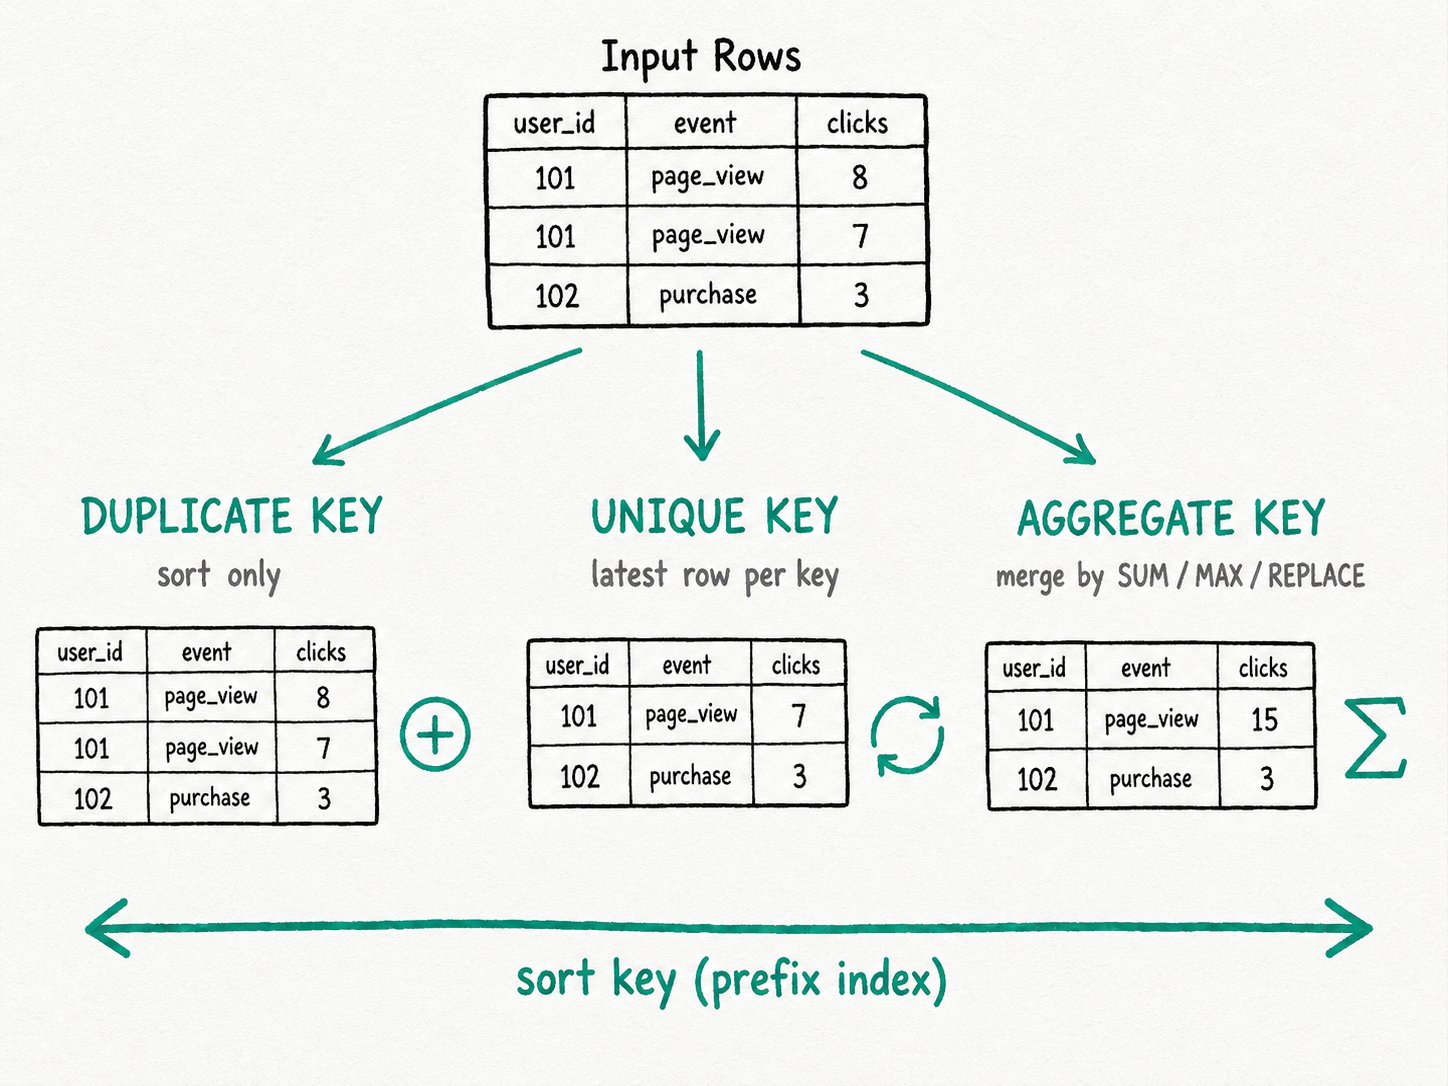
要点 Apache Doris の OLAP テーブルは、作成時に三つのモデルから一つを選びます。Duplicate Key はすべての行を保持し、Unique Key は主キーごとに最新の行を保持し、Aggregate Key は
SUMなどの列ごとの関数で行を集約します。KEY(...)句は Apache Doris がソートに使用する列を指定します。Unique と Aggregate のモデルでは、同じ列によって一意性も保証されます。モデルはCREATE TABLE時に確定するため、最初の選択によって、そのテーブルで以後実行できる書き込み、更新、クエリが決まります。
Apache Doris のデータモデルを使う理由
Apache Doris のデータモデルはスキーマ設計で最初に決める事項であり、後から変更できない事項でもあります。ALTER TABLE では列の追加や削除、パーティションの再構成、エンコーディングの変更ができます。しかし、Duplicate テーブルを Unique テーブルに変えることはできません。モデルの選択を誤った場合は、CREATE TABLE でテーブルを作り直し、データをすべて再ロードする必要があります。
- ログテーブルを Aggregate として作成すると、生の行が失われ、詳細を調べるクエリに答えられなくなります。
- 注文テーブルを Duplicate として作成すると
UPDATEが拒否されるため、CDC パイプラインで行の変更を反映できません。 - レポート用テーブルを Unique として作成すると、すべてのクエリが
SUM(clicks) GROUP BY dayであっても、ロードのたびに Merge-on-Write のインデックス処理コストがかかります。
モデルは、同じキーを持つ行を許可するかどうか、UPDATE と DELETE が何を意味するか、ストレージエンジンが同じキーを持つ行をどう扱うかを決めます。今週作るダッシュボードの形ではなく、データの性質(生のイベント、現在の状態、事前集計済みのファクト)に基づいて選んでください。
Apache Doris のデータモデルとは
Apache Doris のデータモデルは、同じキー列を持つ行に対してストレージエンジンが適用するルールです。Apache Doris には DUPLICATE KEY、UNIQUE KEY、AGGREGATE KEY の三種類があります。FE カタログでは、それぞれ DUP_KEYS、UNIQUE_KEYS、AGG_KEYS と呼びます(KeysType.java を参照)。CREATE TABLE では、列リストの直後に句を置いてキー列を指定します。
... DUPLICATE KEY(log_time, log_type)
... UNIQUE KEY(order_id)
... AGGREGATE KEY(dt, ad_id, user_id)
主な用語
- キー列:
KEY(...)句で指定する列です。ディスク上のソート順を定義し、プレフィックスインデックスに使用されます。Unique と Aggregate では一意性も保証します。 - 値列:キー列以外のすべての列です。Duplicate と Unique では書き込まれたデータをそのまま保存します。Aggregate では各値列に集約関数(
SUM、MAX、REPLACE、BITMAP_UNIONなど)を指定します。 - ソートキー:ストレージ上の配置を説明するときのキー列の別名です。どのモデルを選んでも、タブレット内のデータはキー列でソートされます。
- Duplicate Key モデル:同じキーを持つ行を許可します。行は書き込まれたとおりに追加されます。
KEY(...)句はソートにのみ使用されます。 - Unique Key モデル:キーごとに一行を保持します。同じキーへの新しい書き込みは古い行を上書きします。Merge-on-Write により、SQL の
UPDATE、DELETE、一部の列だけを指定するアップサートをサポートします。 - Aggregate Key モデル:同じキーを持つ行を、各値列に指定された関数で統合します。読み取り時には統合された行が返されます。
Apache Doris のデータモデルの仕組み
Apache Doris のデータモデルは、共通の DDL 形式を使い、ロード時とコンパクション時に三種類の行単位のルールのいずれかを適用します。
- モデルを選ぶ。
DUPLICATE KEY、UNIQUE KEY、AGGREGATE KEYのいずれかの句で、テーブルのKeysTypeを設定します。Apache Doris は残りの DDL をそのモデルに照らして検証します。Aggregate の値列には関数の指定が必要で、Unique テーブルには Merge-on-Write プロパティが適用され、Duplicate テーブルでは集約関数の指定が拒否されます。 - 列を並べる。 列リストでは、すべてのキー列を値列より前に配置する必要があります。Apache Doris は各タブレット内のデータをキー列でソートし、ソートキーの先頭 36 バイトから疎なプレフィックスインデックスを構築します。このインデックスにより、先頭のキー列に対する範囲条件や等価条件を高速に処理できます。
- ロード時にルールを適用する。 Duplicate では行を追加します。Unique ではキーを使って既存の行を検索し、行セットごとの削除ビットマップでその行に印を付け、新しい行を書き込みます。Aggregate では、各値列の関数(
SUM、MAX、REPLACEなど)を使って入力行を既存の行と統合します。 - コンパクション時に再び適用する。 バックグラウンドのコンパクションでは、同じルールで行セットを統合します。Duplicate では行を連結し、Unique では削除ビットマップが対象とする行を除外し、Aggregate では値列の関数で同じキーの行を再び集約します。
- 読み取る。 クエリには、各モデルが定めるデータの見え方が適用されます。Duplicate では追加されたすべての行、Unique ではキーごとの最新の行、Aggregate ではキーごとに統合された一行が見えます。
モデルはタブレットのメタデータに記録され、すべてのレプリカに複製されます。ALTER TABLE ... CHANGE MODEL はありません。モデルを変更するには、新しいテーブルを作成してデータを再ロードします。
クイックスタート
-- Duplicate: keep every event, sort by (log_time, log_type)
CREATE TABLE logs (
  log_time DATETIME, log_type INT, msg VARCHAR(1024)
) DUPLICATE KEY(log_time, log_type)
DISTRIBUTED BY HASH(log_type) BUCKETS 4;

-- Unique: one row per order_id, with UPDATE / DELETE support
CREATE TABLE orders (
  order_id BIGINT, status VARCHAR(20), amount DECIMAL(10,2)
) UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4;

-- Aggregate: pre-sum clicks per (dt, ad_id) at load time
CREATE TABLE ad_stats (
  dt DATE, ad_id INT, clicks BIGINT SUM
) AGGREGATE KEY(dt, ad_id)
DISTRIBUTED BY HASH(ad_id) BUCKETS 4;
期待される結果
SHOW CREATE TABLE logs\G     -- prints "DUPLICATE KEY(`log_time`, `log_type`)"
SHOW CREATE TABLE orders\G   -- prints "UNIQUE KEY(`order_id`)"
SHOW CREATE TABLE ad_stats\G -- prints "AGGREGATE KEY(`dt`, `ad_id`)"
列リストは同一ですが、ストレージエンジンによる書き込みの扱いは大きく異なります。logs に同じ行を二回挿入すると二行になります。orders で同じことをすると一行になります。ad_stats に (dt, ad_id) が一致する二行を挿入すると、clicks 列の値が合算されます。
Apache Doris のデータモデルを使うべき場面
Apache Doris のデータモデルは、今週作るダッシュボードの形ではなく、データの性質(生のイベント、現在の状態、事前集計済みのファクト)に基づいて選んでください。
適した用途
- Duplicate:生の行をクエリする追記専用データに適しています。アクセスログ、クリックストリーム、IoT の測定値、トランザクションの明細などが該当します。重複排除は行われず、述語で指定できる列にも制限はありません。
- Unique:主キーで更新するデータに適しています。MySQL や Postgres からの CDC の書き込み先、注文ステータステーブル、ユーザープロファイル、リアルタイムのディメンションテーブルなどが該当します。データの更新と削除では、
UPDATE、一部の列だけを指定するアップサート、Merge-on-Write の内部動作を説明しています。 - Aggregate:主に追記されるファクトテーブルで、決まった形式のロールアップクエリを行う場合に適しています。日別の支出、広告別のクリック数、
BITMAP_UNIONによるユニーク視聴者数などが該当します。事前集約とロールアップでは、集約関数の全種類とROLLUPによる拡張を説明しています。 - すべてのモデル:先頭のキー列は三列以下にし、文字列より整数を優先し、値を格納できる最小の型を使います。プレフィックスインデックスが参照するのは、ソートキーの先頭 36 バイトだけです。
適さない用途
- 行単位で生データを検索する必要もあるワークロードには、Aggregate は適しません。生の行は統合処理に入った時点で失われます。Duplicate を使用し、必要に応じてロールアップ用の非同期マテリアライズドビューを追加してください。
count(*)を頻繁に実行する場合、Aggregate は適しません。カウントするにはすべてのキー列を読み取って統合する必要があるため、キーの幅が広いほどコストが増えます。従来からの回避策は、値が常に1で集約関数がSUMの値列を用意することです。その場合、SUM(count)をクエリすると同等の結果が得られ、キー幅の広い Aggregate テーブルではcount(*)よりおよそ 10x 高速になります。- 追記だけを行い、更新をまったく行わない場合、Unique は適しません。Merge-on-Write のキーインデックスには、使用しない機能のためのコストがかかります。Duplicate を選んでください。
- 主キーをパーティションキーにする場合、Unique は適しません。パーティションキーは一意キーの部分集合である必要があり、その逆ではありません。
UPDATEが必要なテーブルには Duplicate は適しません。文が拒否されます。取り込み処理で再ロードするか、Unique を選んでください。- 値列に対する
UPDATEまたはDELETEが必要なテーブルには Aggregate は適しません。集約前に値列の条件を評価する方法がエンジンにないため、Aggregate のDELETE述語はキー列に制限されます。
関連資料
- テーブルモデルの概要:機能マトリクスと選択表
- Duplicate Key モデル:追記専用ストレージとソートキーの調整
- Unique Key モデル:Merge-on-Write と Merge-on-Read、一部の列の更新
- Aggregate モデル:集約関数とカスタム統合のための
AGG_STATE - テーブルモデルのベストプラクティス:列の順序、型の選択、
count(*)の調整 - プレフィックスインデックスとソートキー:キー列によるクエリ対象の絞り込み
- データの更新と削除:SQL の UPDATE、DELETE、一部の列だけを指定するアップサート、Unique Key モデルで使用できる Merge-on-Write の内部動作を説明します。
- 事前集約とロールアップ:Aggregate Key モデルの詳細に加え、ROLLUP と同期マテリアライズドビューを説明します。
- パーティショニングとバケット分割:同じキー列がパーティションの枝刈りとタブレットの配置にどう影響するかを説明します。
- Unique Key:Duplicate や Aggregate と並ぶ主キー(キーごとに一行)のモデルです。データソースがアップサートを行う場合に選びます。
