データプルーニング
要約 Apache Doris のデータプルーニングでは、クエリが実際に走査するのはテーブル全体ではなく、複数のプルーニング層を通過したデータだけです。パーティションキーと分散キー、ZoneMap の最小値・最大値統計、BloomFilter インデックス、NGram BloomFilter インデックスが、それぞれ読み取り不要なデータを除外します。効果の大部分は自動的に得られますが、管理者は DDL の選択によって制御し、EXPLAIN の出力で確認できます。
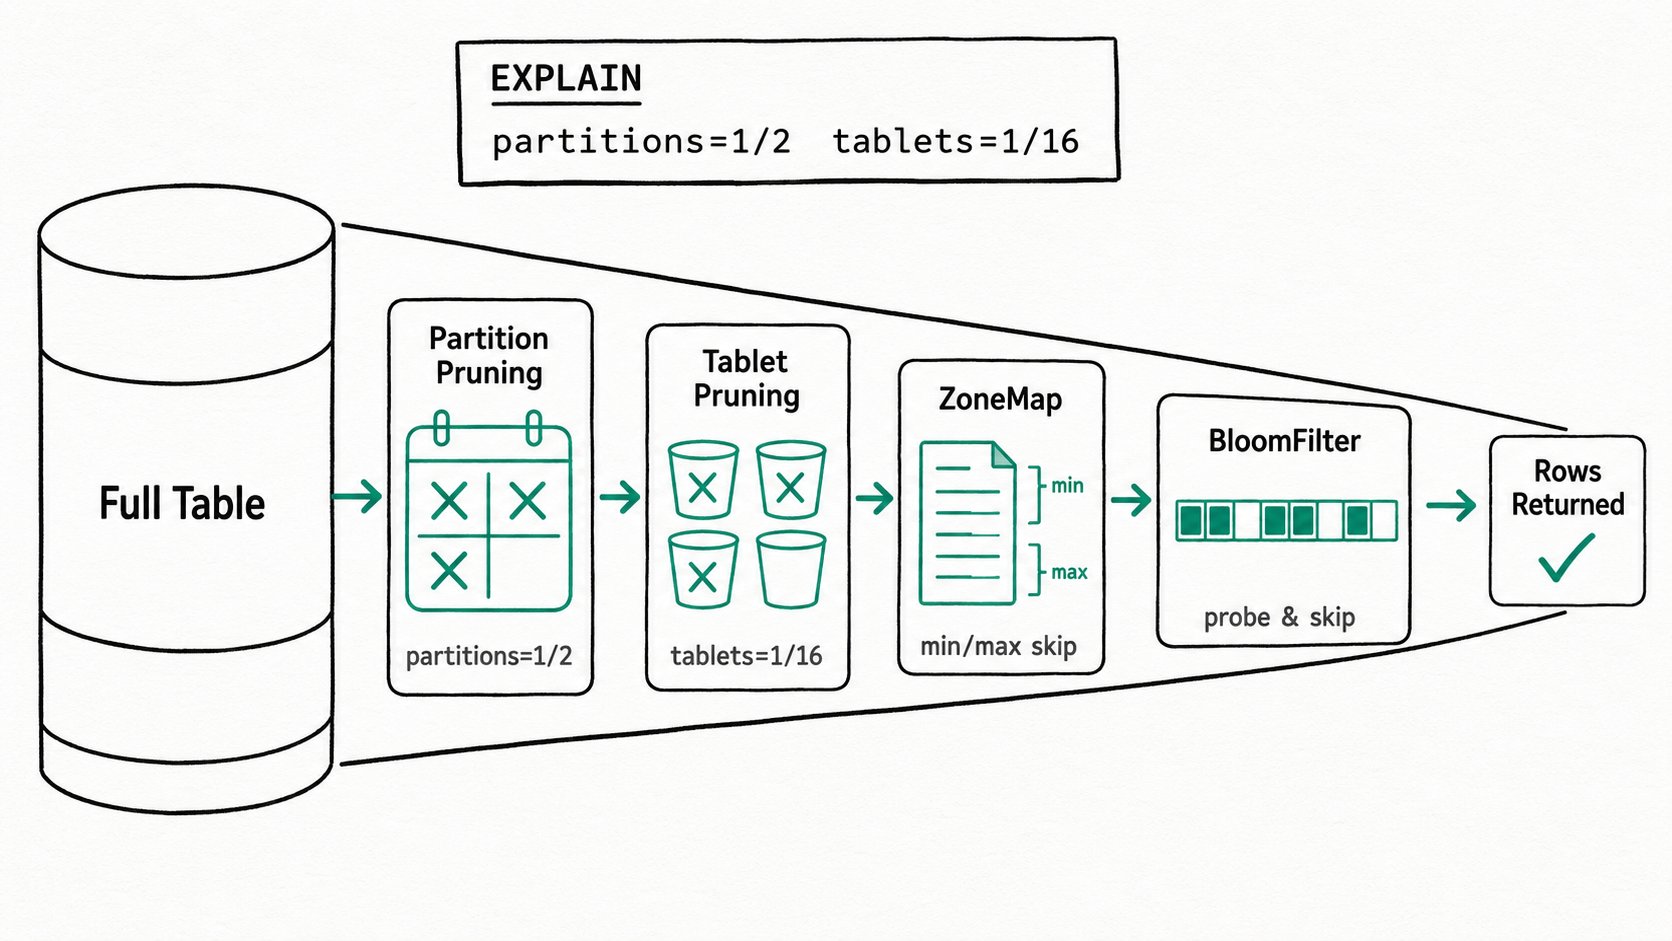
Apache Doris でデータプルーニングを使用する理由
Apache Doris のデータプルーニングを使用すると、クエリはデータの読み取り前にテーブルの大部分をスキップでき、数テラバイトのスキャンを少数のパーティションやタブレットの読み取りに減らせます。OLAP クエリを高速化する最も効果的な方法は、読み取るデータを減らすことです。一日あたり 50 GB の幅広いイベントテーブルは、一年でペタバイト規模に達しますが、ほとんどのクエリが必要とするのは一日、一人のユーザー、一つの製品といったごく一部です。プルーニングがなければ、プランナーはすべてのパーティションとタブレットにクエリを展開し、実行エンジンはディスク上のすべてのページを読み取って WHERE を評価します。
この問題は、具体的には次の三つの形で現れます。
- 365 個のパーティションを持つテーブルに対する
WHERE date BETWEEN '2026-04-01' AND '2026-04-07'クエリは、プランナーが不要なパーティションをスキップできると判断するまでは、すべてのパーティションにアクセスします。 - ハッシュ分散されたテーブルでのポイント検索(
WHERE user_id = 12345)は、オプティマイザーが述語をバケットキーに結び付けられない場合、すべてのタブレットをスキャンします。 - キー以外のカラムに対するカーディナリティの高いフィルター(
WHERE phone = '...')は、ページを除外するための統計情報がない場合、すべてのセグメントを読み取ります。
Apache Doris は、それぞれに異なるプルーニング層で対処します。これらの層は組み合わせて機能し、スキャン開始前にプランナーがパーティションとタブレットを絞り込み、その後、BE が残ったデータ内のセグメントとページをスキップします。
Apache Doris のデータプルーニングとは
Apache Doris のデータプルーニングとは、パーティション、タブレット、セグメント、カラムページにわたる読み取り経路で、データを読み取らずにスキップする各処理を組み合わせたものです。Frontend のプランナーは、テーブルのメタデータを使ってパーティションとタブレットを大まかに絞り込みます。Backend はスキャン中により細かく絞り込み、ZoneMap の最小値・最大値、BloomFilter、NGram BloomFilter、転置インデックスを使って、セグメント、カラムページ、さらには行範囲をスキップできるかどうかを判断します。
主な用語
Partition pruning:プランナーは、パーティションキーに対する範囲述語またはリスト述語を使い、タブレットを割り当てる前に不要なパーティションを除外します。Bucket (tablet) pruning:DISTRIBUTED BY HASHキーに対する等価述語により、該当する行を含み得るバケットだけをプランナーが選択できます。ZoneMap index:すべてのカラムに自動作成される、セグメントおよびページごとの最小値・最大値・NULL に関する統計情報です。範囲述語を使ってページをスキップします。BloomFilter index:カラムごとに明示的に有効化する確率的フィルターで、カーディナリティの高い等価述語やIN述語に役立ちます。NGram BloomFilter:部分文字列に対するLIKE '%abc%'述語を n-gram の BloomFilter 照会に変換する、明示的に有効化するインデックスです。Runtime filter:結合の一方の側から生成され、もう一方の側を絞り込むためにプッシュダウンされる、結合時のフィルターです。
Apache Doris のデータプルーニングの仕組み
Apache Doris のデータプルーニングは、パーティション、タブレット、セグメント/ページ、インデックス照会、ランタイムフィルターの五つの層で上位から順に機能します。各層が、次の層で処理するデータを減らします。
- パーティションプルーニング(FE)。 Nereids プランナーは
PruneOlapScanPartitionを実行し、WHERE述語をテーブルの範囲パーティションまたはリストパーティションの構造と照合して、残すパーティションの集合を求めます。EXPLAIN ではpartitions=2/4 (p2,p3)と表示されます。 - タブレットプルーニング(FE)。
PruneOlapScanTabletはバケットキーのカラムに対する等価述語を抽出し、HashDistributionPrunerを使って該当するハッシュバケットを特定します。EXPLAIN ではtablets=1/32と表示されます。 - セグメント/ページプルーニング(BE)。 残った各タブレットについて、セグメントイテレーターはカラムリーダーを開き、ZoneMap インデックスを参照します。
[min, max]が述語の範囲と重ならなければ、そのページを解凍せずに除外します。 - インデックス照会(BE)。 BloomFilter、NGram BloomFilter、転置インデックスによる照会は、行のデコード前に実行されます。一致しなければページをスキップします。一致しても、該当する行が存在するとは限らず、存在する可能性があることを示すだけです。
- ランタイムフィルター(FE/BE)。 結合では、ビルド側からフィルター(たとえば
IN (A.id_set))を生成して配信します。プローブ側のスキャンは、同じプルーニングの仕組みを実行中に利用できます。
述語評価器が実行されるまでに、テーブルの大部分は読み取られることなく除外されています。
クイックスタート
CREATE TABLE events (
  ts DATETIME, user_id BIGINT, action VARCHAR(64)
)
DUPLICATE KEY(ts, user_id)
PARTITION BY RANGE(ts) (
  PARTITION p202604 VALUES LESS THAN ("2026-05-01"),
  PARTITION p202605 VALUES LESS THAN ("2026-06-01")
)
DISTRIBUTED BY HASH(user_id) BUCKETS 16
PROPERTIES ("bloom_filter_columns" = "action");

EXPLAIN
SELECT count(*) FROM events
WHERE ts >= '2026-05-08' AND user_id = 42 AND action = 'click';
予想される結果(抜粋)
0:VOlapScanNode
  TABLE: events
  PREDICATES: ts >= '2026-05-08', user_id = 42, action = 'click'
  partitions=1/2 (p202605)
  tablets=1/16
プランナーは、日付範囲に基づいて二つのパーティションのうち一つを、user_id のハッシュに基づいて十六個のタブレットのうち一つを残しました。読み取り時には、BE が ts の ZoneMap と action の BloomFilter を使用し、残ったタブレット内のページをスキップします。手動のチューニングをしなくても、四つのプルーニング層が三つの述語を処理します。
Apache Doris のデータプルーニングを使用する場面
Apache Doris のデータプルーニングは常に有効です。重要なのは、DDL と述語によってどの層が実際に働くかです。期間を限定した分析クエリ、同時実行数の多いポイント検索、長いテキストカラムに対する部分文字列検索、スタースキーマ結合で特に効果があります。一方、不適切な BloomFilter の使用や、すべてのデータを受け入れる単一のパーティションは、よくあるアンチパターンです。
適したケース
- パーティション分割されたテーブルに対する、期間を限定した分析クエリ。日付述語をプランナーが利用できれば、データ量に伴うレイテンシーの増加を抑えられます。
- ハッシュ分散されたテーブルでの、同時実行数の多いポイント検索。最も一般的な等価述語にバケットキーを合わせます。
- 長いテキストカラムに対する部分文字列検索。NGram BloomFilter を追加すると、
LIKE '%...%'をカラムスキャンの代わりに BloomFilter 照会として処理できます。 - スタースキーマ結合。ランタイムフィルターが小さい側のキーをファクトテーブルのスキャンへ伝えます。
適さないケース
- カーディナリティの低いカラム(ステータスフラグや性別)に BloomFilter を使用する場合。ほぼすべてのページがフィルターを通過するため、ストレージだけを消費します。標準で作成される ZoneMap を使うか、インデックスを付けないでください。
- 範囲述語に BloomFilter を使用する場合。BloomFilter が答えるのは「X は集合に含まれるか」であり、「X は Y より小さいか」ではありません。範囲フィルターには ZoneMap が使用されます。
- フィルター条件に使わないカラムでバケット分割する場合。書き込み時にハッシュ分散のコストがかかる一方、読み取り時のプルーニング効果は得られません。最も選択性の高い等価述語に合うバケットキーを選んでください。
- すべてのデータを受け入れる巨大なパーティションを一つだけ作る場合。プランナーはパーティションを除外できず、タブレットとセグメントのプルーニングだけで補う必要があります。通常は時間など、クエリが実際にフィルターするカラムでパーティション分割してください。
- BloomFilter を全文検索の代わりに使う場合。フレーズ検索やトークン検索には転置インデックスを使用してください。BloomFilter が扱えるのは等価条件だけです。
関連資料
- パーティションプルーニングの最適化
- インデックスの概要:スキップインデックス
- BloomFilter インデックス
- NGram BloomFilter インデックス
- パーティション分割とバケット分割:プランナーがどのパーティションとタブレットを除外できるかを決める DDL の選択。
- 転置インデックス:テキストやカーディナリティの高い等価述語をポスティングリストの検索に変換するインデックス照会層。
- 詳説:Apache Doris のデータプルーニング(ブログ)
- MPP アーキテクチャ:プルーニングが行われる場所。パーティションとバケットのプルーニングは、フラグメントを送信する前に Nereids プランナーで実行されます。
