Iceberg
要約 Apache Doris は、読み取りだけでなく書き込みもできる Apache Iceberg エンジンです。一つの
CREATE CATALOGで、REST、HMS、Glue、S3 Tables、JDBC、DLF、Hadoop の七種類の Iceberg バックエンドに接続できます。接続後は SQL だけで、クエリ、INSERT、UPDATE、DELETE、MERGE INTO、ブランチとタグの操作、タイムトラベル、スキーマとパーティションの変更、メンテナンス(expire_snapshots、rewrite_data_files、rewrite_manifests)を実行できます。Apache Doris は V2 の位置削除と等価削除を読み書きでき、4.1 以降では V3 の削除ベクトル(Puffin)にも対応しています。
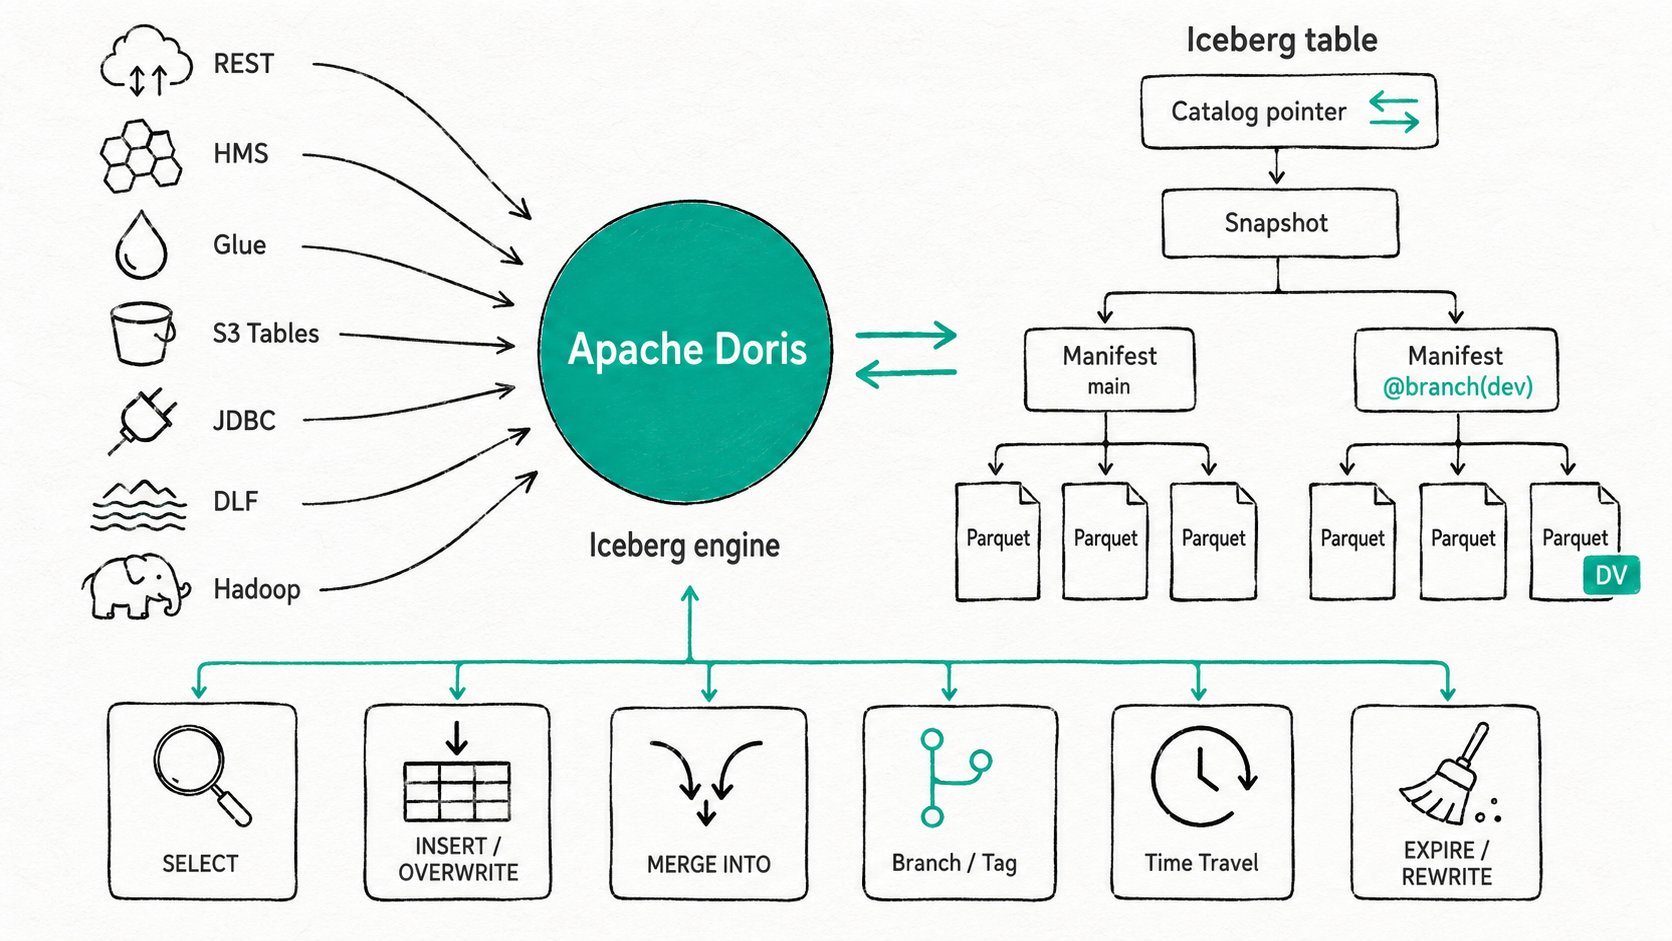
Apache Doris の Iceberg カタログを使う理由
Apache Doris の Iceberg カタログは読み書きに対応するエンジンです。ダッシュボードにデータを提供するクラスターが、Spark や Flink に処理を引き継ぐことなく、Iceberg への行の書き込み、メンテナンス、ブランチの管理も行えます。Iceberg の利点はエンジンを選ばないことです。データはオブジェクトストレージ上の Parquet ファイルに保存され、テーブルの構造はオープンな仕様で定義されます。その仕様に対応するエンジンなら、データをコピーせずに同じテーブルを読み書きできます。しかし、利用するエンジンが Iceberg を読み取り専用として扱うと、この利点は失われます。接続していくつかの SELECT 文を実行できても、行を書き込む段階で Spark や Flink を起動しなければなりません。一つのテーブルのために、二つのクラスター、二種類の SQL 方言、二組の認証情報を管理することになります。
Apache Doris は読み取りと書き込みの両方を担います。ダッシュボードにデータを提供するクラスターで、その背後の Iceberg テーブルも管理できます。
- Iceberg のファクトデータと Doris のウェアハウスを結合するフェデレーションクエリは、コピー処理を挟まずに一つの MPP 実行計画で動作します。
- ELT パイプラインは標準 SQL で Iceberg に書き戻せるため、ほかのエンジンからも新しいスナップショットをすぐに参照できます。
- コンパクション、スナップショットの期限切れ処理、マニフェストの書き換えは、別途 Spark ジョブを用意せず、
ALTER TABLE ... EXECUTEで実行できます。
このページでは Iceberg 固有の機能を説明します。異なる種類のカタログをまたぐフェデレーションについてはマルチカタログ、Iceberg、Hive、Paimon に共通する書き込み機能についてはデータレイクのテーブル管理を参照してください。
Apache Doris の Iceberg カタログとは
Apache Doris の Iceberg カタログは、Iceberg の Java ライブラリ上に構築されたネイティブコネクターです。Iceberg のカタログ API を直接使用するため、コミットは Spark や Trino と同じ処理経路を通り、それらのエンジンが変換なしで読み取れるスナップショットを作成します。
主な用語
- カタログの種類:テーブル名を現在のメタデータへのポインターに対応付けるメタストアのバックエンドです。Doris は
rest、hms、glue、s3tables、dlf、jdbc、hadoopの七種類に対応します。 - フォーマットバージョン:V1(追記専用)、V2(位置削除と等価削除を利用するマージオンリード)、V3(Puffin ファイルに保存する削除ベクトル、行リネージ、デフォルト値)があります。Doris は V1 から V3 を読み取り、デフォルトでは V2 で書き込みます。V3 への書き込みにはフォーマットバージョン 4.1+ が必要です。
- スナップショット:変更不可能な Iceberg テーブルのバージョンです。コミットのたびに新しいスナップショットが作成されます。
- ブランチとタグ:スナップショットを指す名前付き参照です。ブランチは新しいコミットに伴って移動しますが、タグは固定されます。Doris では読み取り(
@branch(name)、@tag(name))と DDL(ALTER TABLE ... CREATE BRANCH)の両方で利用できます。 - 位置削除、等価削除、削除ベクトル:Iceberg が行単位の削除を記録する三つの方法です。位置削除はファイルパスと行の位置で対象を指定し、等価削除は列の値で照合します。削除ベクトルは、データファイルごとの Roaring ビットマップを付随する Puffin ファイルに保存します。
Apache Doris の Iceberg カタログの仕組み
Apache Doris の Iceberg カタログは、七種類のメタストアバックエンドのいずれかを通じて接続します。現在のスナップショット、またはブランチ、タグ、タイムトラベルで指定した対象に対してクエリを計画し、行単位の削除を読み取り時に反映します。書き込みは Iceberg のカタログ API を通じてコミットします。
- 一度接続します。
CREATE CATALOG ... PROPERTIES ('type' = 'iceberg', 'iceberg.catalog.type' = '<backend>', ...)でメタストアとストレージシステムを登録します。カタログへの接続設定は FE の再起動後も保持されます。 - スナップショットに対して実行計画を作ります。 クエリが Iceberg テーブルを参照すると、FE は現在のスナップショット(またはブランチ、タグ、タイムトラベルで指定した対象)を特定します。次にマニフェストリストを読み、最小値と最大値の統計を使ってパーティションとデータファイルを絞り込み、フィルターをプッシュダウンします。BE ワーカーは残った Parquet または ORC ファイルをストリーミングで読み取ります。
- 削除を読み取り時に反映します。 位置削除は
<file_path, row_position>による左アンチ結合として適用します。等価削除は削除スキーマに基づいて照合します。V3 の削除ベクトルはビットマップの参照としてスキャンに組み込まれ、カーディナリティの高い削除では結合より低コストです。 - 書き込みをアトミックにコミットします。
INSERT、INSERT OVERWRITE、CTAS、UPDATE、DELETE、MERGE INTOは Doris のIcebergTransactionを通ります。BE のライターは Parquet ファイル(または V3 の新規テーブルを書き換える場合は削除ベクトル)を準備します。FE はマニフェストリストを組み立て、テーブルのポインターを切り替えるようカタログに要求します。競合した場合は、書き込みが部分的に反映される代わりに、スナップショットの不一致を示す明確なエラーで文が失敗します。 - その場でメンテナンスします。 スナップショットの期限切れ処理、データファイルのコンパクション、マニフェストの書き換え、ブランチの早送り、スナップショットのチェリーピックは、
ALTER TABLE <t> EXECUTE <action>(...)で実行し、同じカタログ API を通じてコミットします。外部スケジューラーや別の Spark ジョブは不要です。
クイックスタート
CREATE CATALOG iceberg_rest PROPERTIES (
  'type' = 'iceberg',
  'iceberg.catalog.type' = 'rest',
  'uri' = 'http://rest:8181',
  'warehouse' = 's3://lake/wh',
  's3.endpoint' = 'http://minio:9000',
  's3.access_key' = 'admin', 's3.secret_key' = 'password'
);

SWITCH iceberg_rest;
CREATE DATABASE IF NOT EXISTS sales;
CREATE TABLE sales.orders (id BIGINT, region STRING, amount DECIMAL(10,2), ts DATETIME)
  PARTITION BY LIST (region, day(ts)) ()
  PROPERTIES ('format-version' = '2');

INSERT INTO sales.orders VALUES (1, 'bj', 99.50, '2026-05-08 10:00:00');
ALTER TABLE sales.orders CREATE BRANCH dev;
INSERT INTO sales.orders@branch(dev) VALUES (2, 'sh', 12.00, '2026-05-08 11:00:00');
ALTER TABLE sales.orders EXECUTE expire_snapshots('retain_last' = '5');
期待される結果
+----------+
| count(*) |
+----------+
|        1 |  -- main branch
|        2 |  -- dev branch (SELECT ... FROM sales.orders@branch(dev))
+----------+
同じ REST エンドポイントに接続した Trino や Spark からも、Doris が書き込んだスナップショットを参照できます。
Apache Doris の Iceberg カタログを使う場面
Apache Doris の Iceberg カタログは、レイクハウスのフェデレーション分析、SQL だけで行う Iceberg への ELT、ブランチを使うワークフロー、その場でのメンテナンスに適しています。一方、高頻度の単一行更新や Hudi への書き込みには適していません。
適しているケース
- Iceberg と Apache Doris のウェアハウスをまたぐフェデレーション分析。先に Apache Doris へデータをコピーする必要がありません。
- JDBC、Kafka、Hive のソースから、整えたデータをすべて SQL で Iceberg に書き込む ELT パイプライン。
- Git のように変更を分離するチームのワークフロー。開発用ブランチに書き込み、検証してから
fast_forwardで main ブランチを進めます。 FOR VERSION AS OFや名前付きタグを使用する、再現可能なバックフィルや監査。- 定期的なコンパクションが必要なストリーミングジョブ。
rewrite_data_filesとexpire_snapshotsで小さなファイルの増加を抑えます。 - Hive からの移行。Doris で Iceberg テーブルを作成し、切り替え中は両方に書き込んでから Hive 側のコピーを廃止します。
適していないケース
- 高頻度の行単位更新。Iceberg のコミットはスナップショット単位で行うため、文ごとのオーバーヘッドは Doris の Unique Key テーブルよりはるかに大きくなります。単一行を低遅延で反映する必要がある CDC の書き込み先には、Doris の内部テーブルを使用してください。
- V1 Iceberg テーブルに対する DELETE や UPDATE。行単位の DML にはフォーマットバージョン 2 または 3 が必要です。作成時に
'format-version' = '2'を指定するか、テーブルをアップグレードしてください。 - Hudi への書き込み。現在、Doris は Hudi の読み取りに対応しています。Hudi への書き込みには Spark または Flink を使用してください。
- カタログをまたぐトランザクション。二つの Iceberg カタログ、または Iceberg テーブルと Doris テーブルに書き込む文は、単一の ACID 単位にはなりません。一方にいったん書き込み、もう一方へ複製してください。
- メンテナンスを省略する運用。
expire_snapshotsを実行しないと、ストレージとメタデータが際限なく増え、タイムトラベルの読み取りが遅くなります。定期実行を設定してください。 - 複数のライターが同時に書き込む環境でのファイルシステム型(
hadoop)カタログ。ファイルベースのカタログにはロックサービスがありません。複数ライターの構成では REST、HMS、Glue、JDBC、DLF のいずれかを使用してください。
関連資料
- Iceberg カタログのリファレンス:DDL、DML、ブランチとタグ、タイムトラベル、テーブルアクションの構文全体と、各機能のバージョンに関する注記。
- データレイクのテーブル管理:Doris が Iceberg、Hive、Paimon に提供する書き込みとライフサイクル管理の機能。
- マルチカタログ:Iceberg、Hive、JDBC、ES、内部ウェアハウスを三部構成の名前で扱う Doris のフェデレーションの仕組み。
- カタログ連携:HMS、Glue、REST、S3 Tables、DLF、JDBC、Hadoop のバックエンド別の接続方法。
- レイクハウスの概要:Doris の幅広いフェデレーション分析に Iceberg がどう位置付けられるか。
- Doris と Iceberg のベストプラクティス:パーティション変換、タイムトラベル、V2 DML、PyIceberg との連携を試せる REST と MinIO のデモ。
- iceberg_meta() テーブル関数:Iceberg の Java API を直接使わずに、スナップショット、マニフェスト、ファイル、参照、履歴を照会できます。
