Parquet リーダーの最適化
要約 Apache Doris は、C++ ネイティブのベクトル化 Parquet リーダーを外部カタログと TVF 向けに提供します。Java や Arrow を経由する往復処理は不要です。このリーダーは、ファイル内の統計情報を使ってロウグループ全体や個々のページを除外し、辞書 ID に対して述語を評価し、ペイロード列より先にフィルタ列を読み込みます。リモートからの読み込みをまとめてリクエスト数を減らすため、多くのクエリでは不要な列をデコードせずに処理を終えられます。
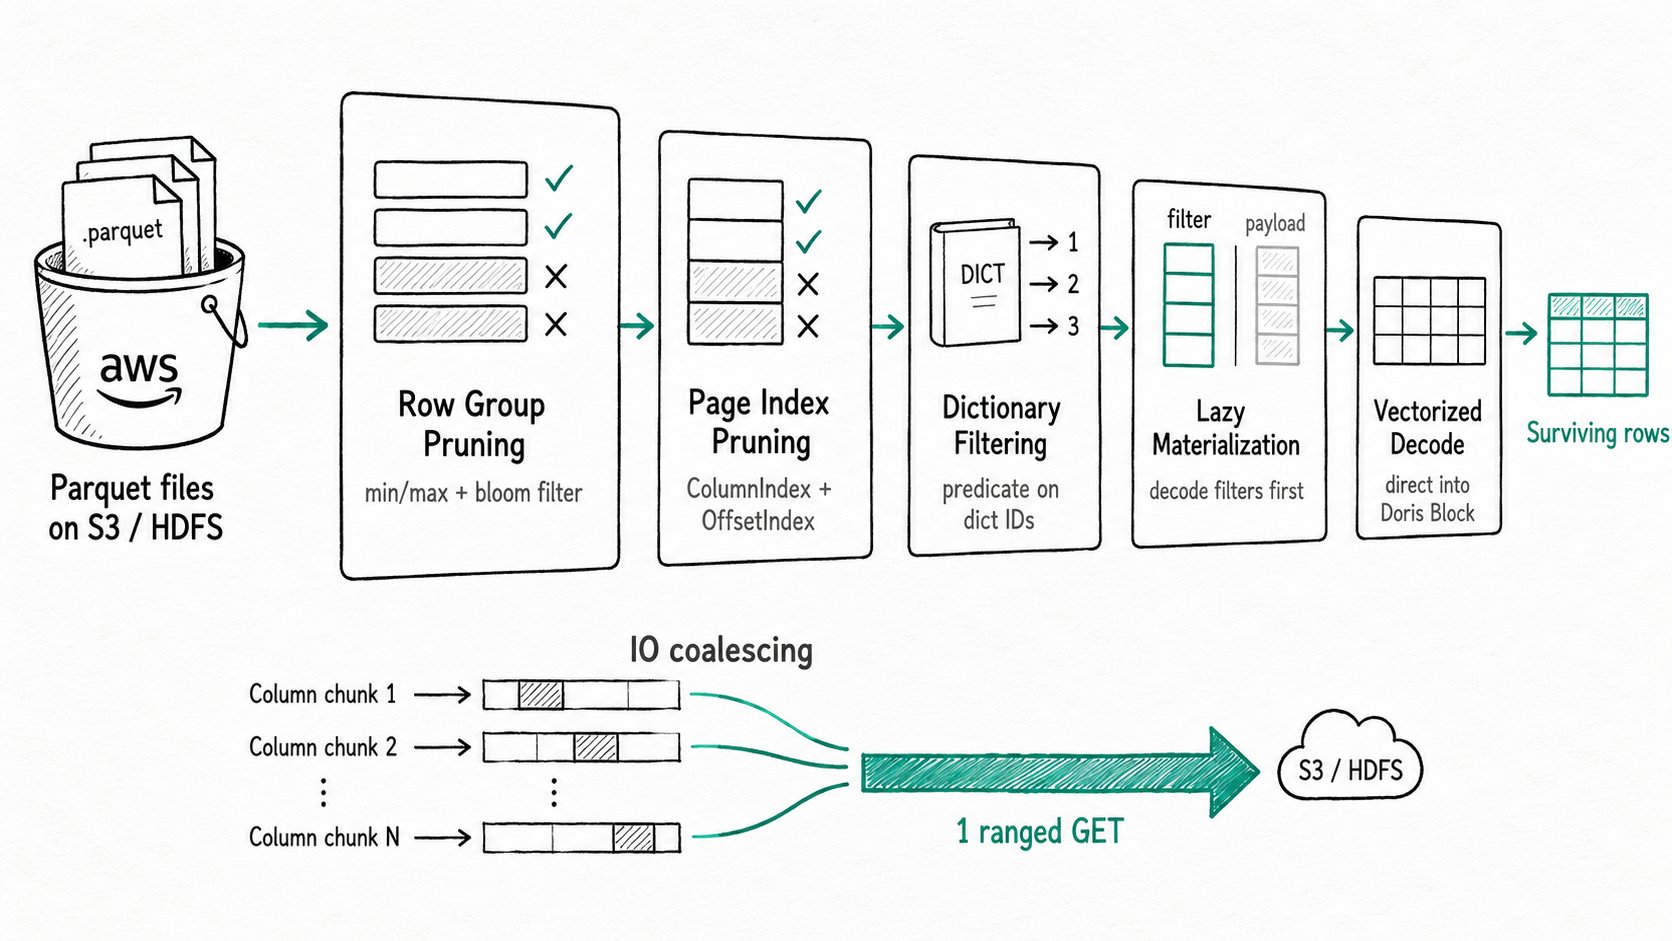
Apache Doris の Parquet リーダーを使う理由
Apache Doris のネイティブ Parquet リーダーは、レイクハウスのスキャンで支配的な三つのコスト、すなわちオブジェクトストレージからのデータ取得、ページの展開とデコード、エンジンの実行時表現への値の変換を削減するために設計されています。S3 上の Hive テーブルや Iceberg テーブルも、最終的には Parquet ファイルの集合です。単純なリーダーでは、クエリのたびにこれら三つのコストが発生します。
このコストは、レイクハウスのクエリをチューニングしたことがあれば見覚えのある、次のようなケースで表れます。
WHERE order_date >= '2026-04-01'というフィルタで、ファイル内のロウグループごとの最小値と最大値をリーダーが参照しないため、すべての Parquet ファイルの全ロウグループをスキャンしてしまう。WHERE user_id = 12345のような一点検索で、その ID を含み得るロウグループが一つしかなくても、user_id列全体を読み込んでしまう。- S3 上の列数が多いイベントテーブルに対する
SELECT *で、列チャンクごとに一回、ファイルあたり数百回もの小さな HTTP GET が発生する。 country = 'JP'のような述語で、列が辞書エンコードされており、各行につき整数比較一回で判定できるにもかかわらず、数百万行にわたる UTF-8 データを展開してデコードしてしまう。
Apache Doris の Parquet リーダーは、ページをストレージから読み出す前に、これらの無駄を回避するように設計されています。
Apache Doris の Parquet リーダーとは
Apache Doris の Parquet リーダーは、Parquet のメタデータを読み取り、利用可能な各粒度(ロウグループ、ページ、辞書、列)で不要なデータを除外し、ベクトル化実行エンジンが使用する Block 形式に値を直接デコードする C++ ネイティブのコンポーネントです。この処理経路で Java ライブラリや Arrow を経由する往復処理はありません。
主な用語
Row group:Parquet ファイルを分割し、並列読み込みを可能にする単位です。各列の最小値、最大値、NULL 値の件数に関する統計情報を持ちます。PageIndex:ページ単位の統計情報と各ページのバイトオフセットを提供する、Parquet のオプション構造(ColumnIndex と OffsetIndex)です。これにより、リーダーは目的のページへ直接シークできます。Lazy materialization:最初にフィルタ列をデコードし、条件に合致した行についてのみペイロード列を取得する、二段階の読み込みです。Dictionary filtering:列チャンクの辞書ページに対して述語を一度評価し、その結果得られた辞書 ID の集合と各行を比較する処理です。
Apache Doris の Parquet リーダーの仕組み
Apache Doris の Parquet リーダーは五段階のパイプラインで動作し、各段階で次の段階が調べるデータを減らします。
- ロウグループの除外。 ファイルを開くと、リーダーは各ロウグループの列統計情報を調べ、述語が最小値と最大値の範囲に一致し得ない場合はロウグループ全体を除外します。ファイルに Parquet Bloom フィルタがあれば、同じ段階でこれも調べます。どちらの判定も列ページを取得する前にメタデータだけを使って行われます。
enable_parquet_filter_by_min_maxとenable_parquet_filter_by_bloom_filterで制御します。 - PageIndex によるページの除外。 残った各ロウグループについて、リーダーは ColumnIndex と OffsetIndex を解析し、最小値と最大値が条件に一致し得ないページを個別に除外します。OffsetIndex は残った各ページのバイト範囲を示すため、除外したデータをスキャンせずに次のページへ直接進めます。BE 設定の
enable_parquet_page_indexで切り替えます。 - 辞書フィルタリング。 列チャンクが辞書エンコードされており、述語が単一スロットの式である場合、リーダーは辞書ページだけをデコードして述語を評価し、辞書 ID に対して作用するように述語を書き換えます。その後のデータページの処理は、ビットパックされた整数の比較になります。
- 遅延マテリアライズ。 残った行も組み立てる必要があります。リーダーは列をフィルタ列(述語が参照する列)とペイロード列に分け、フィルタ列をデコードして行の選択ビットマップを作成します。その後、条件に合致した行についてのみペイロード列を取得します。セッション変数
enable_parquet_lazy_matで制御し、デフォルトでは有効です。 - I/O の統合と直接デコード。 ロウグループ内で隣接する列チャンクを一回の範囲指定読み込みにまとめるため、エンジンは多数の HTTP GET の代わりに一回の HTTP GET を発行します。デコードされた値は Arrow を経由せず、Doris のベクトル化された列に直接格納されます。
その結果、実行エンジンに渡される行はすでに条件との一致が確認されており、デコードされる列もクエリで要求されたものだけになります。
クイックスタート
SELECT region, count(*) AS orders, sum(amount) AS revenue
FROM s3(
  "uri"    = "s3://demo-bucket/orders/year=2026/*.parquet",
  "format" = "parquet",
  "s3.endpoint"   = "https://s3.us-east-1.amazonaws.com",
  "s3.access_key" = "AK...",
  "s3.secret_key" = "SK..."
)
WHERE order_date >= '2026-04-01' AND status = 'PAID'
GROUP BY region;
期待される結果(プロファイルの抜粋)
VFileScanNode
  FilteredRowGroups:           18 / 24
  FilteredPages:               210 / 980
  LazyReadFilteredRows:        92.1%
  RemoteIOMergedRanges:        14 (from 96 chunks)
リーダーは日付の述語に基づき、18 個のロウグループを全 24 個のうちから除外し、残ったロウグループ内で status の PageIndex を使って 210 ページを除外しました。遅延マテリアライズにより、全行のうち条件に一致しなかった 92.1% について region と amount のデコードを省略しました。九十六個の列チャンクは、S3 への 14 回の範囲指定 GET にまとめられました。
Apache Doris の Parquet リーダーを使う場面
Apache Doris の Parquet リーダーは、クエリが Parquet を読み込むときに自動的に使用されます。重要なのは、リーダーが最適化を活用できる状態にすることです。
適したケース
- データファイルに Parquet を使用する Hive、Iceberg、Hudi、Paimon のカタログ。
- s3() と
hdfs()の TVF を使ったファイルの直接分析。 - 列数の多いテーブルに対する選択性の高いクエリ。述語を多く使うフィルタほど、遅延マテリアライズで読み飛ばせるデータが増えます。
- 書き込み側が統計情報を記録した列に対する等価述語と範囲述語。
- 一点検索や
IN述語を使用する、辞書エンコードされた文字列列。
適さないケース
- 数千個もの小さな Parquet ファイルで構成されるテーブル。各ファイルのフッターを解析する必要があり、各チャンクには少なくとも一回の範囲指定読み込みが必要なため、ファイルごとのオーバーヘッドが支配的になります。ファイルを 128 MB から 1 GB 程度にコンパクションしてください。
- 列統計情報や PageIndex を書き込まずに作成されたファイル。リーダーには除外の判断材料がなく、全件スキャンに切り替わります。書き込み側で統計情報を有効にしてください(Spark 3.2 以降と parquet-mr 1.11 以降はいずれも PageIndex を書き込みます)。
- 深くネストした struct フィールドに対する選択性の高い述語。一部の最適化(ページインデックス、辞書フィルタリング)は複合型に対して無効になり、リーダーは残った行をすべて処理します。可能であればアクセスパスをフラット化するか、トップレベルの列を使用してください。
- 古い Hive の書き込み処理によって INT96 として書き込まれた DATETIME 列。INT96 の統計情報は破損していることが多く、リーダーはこれらの列に対する最小値と最大値による除外を行いません。書き込み側を制御できる場合は、タイムスタンプを INT64 で書き込んでください。INT96 については Hive カタログの注意事項を参照してください。
関連資料
- Parquet ファイル形式のリファレンス:ユーザーが設定できる項目(
enable_parquet_lazy_mat、enable_parquet_page_index、BE のバッファサイズ設定)と、各項目が使用できるバージョン。 - S3/HDFS 上のファイルの分析:
s3()とhdfs()の TVF を使用して Parquet ファイルを直接クエリする方法。 - データプルーニング:Parquet リーダーによる最適化も含め、Doris がデータの読み込みを省略する仕組みの全体像。
- ベクトル化実行:リーダーがデコードしたデータを受け取るエンジンと、Arrow を経由する往復処理を省く利点。
- データキャッシュ:デコードされた Parquet ページをローカルにキャッシュし、繰り返しスキャンするときにリモートからの読み込みを省略する方法。
- メタデータキャッシュ:Parquet リーダーによるデータの除外処理が依存する、スキーマ、パーティション、ファイル一覧の FE 側キャッシュ。
- マルチカタログ:S3、HDFS、Hive、Iceberg、Paimon 上の Parquet テーブルを Doris に接続する方法。
- カタログ連携:Parquet ファイルを保持するカタログについて、データソースごとに説明したコネクタのリファレンス。
- 次世代データレイクハウスの構築(Apache Doris ブログ):ネイティブ Parquet リーダーを最初に公開した記事。
- Iceberg:この最適化によって Parquet スキャンが特に直接的に高速化される、レイクハウスのテーブル形式。
