パーティショニングとバケット分割
要約 Apache Doris の各テーブルは二段階で分割されます。
PARTITION BY句は列の値(通常は日付)で行を分け、DISTRIBUTED BY句は各パーティションを N 個のタブレットに分割します。パーティションを使うと、プランナーは大きな単位で不要なデータを読み取り対象から外せ、運用時にはデータをアーカイブできます。バケットを使うと、クラスターは読み取りと書き込みを並列化できます。パーティションキーにはクエリで絞り込む日付列を、バケットキーにはカーディナリティの高い等価条件に使う列を選び、残りのバケット数の調整はBUCKETS AUTOに任せます。
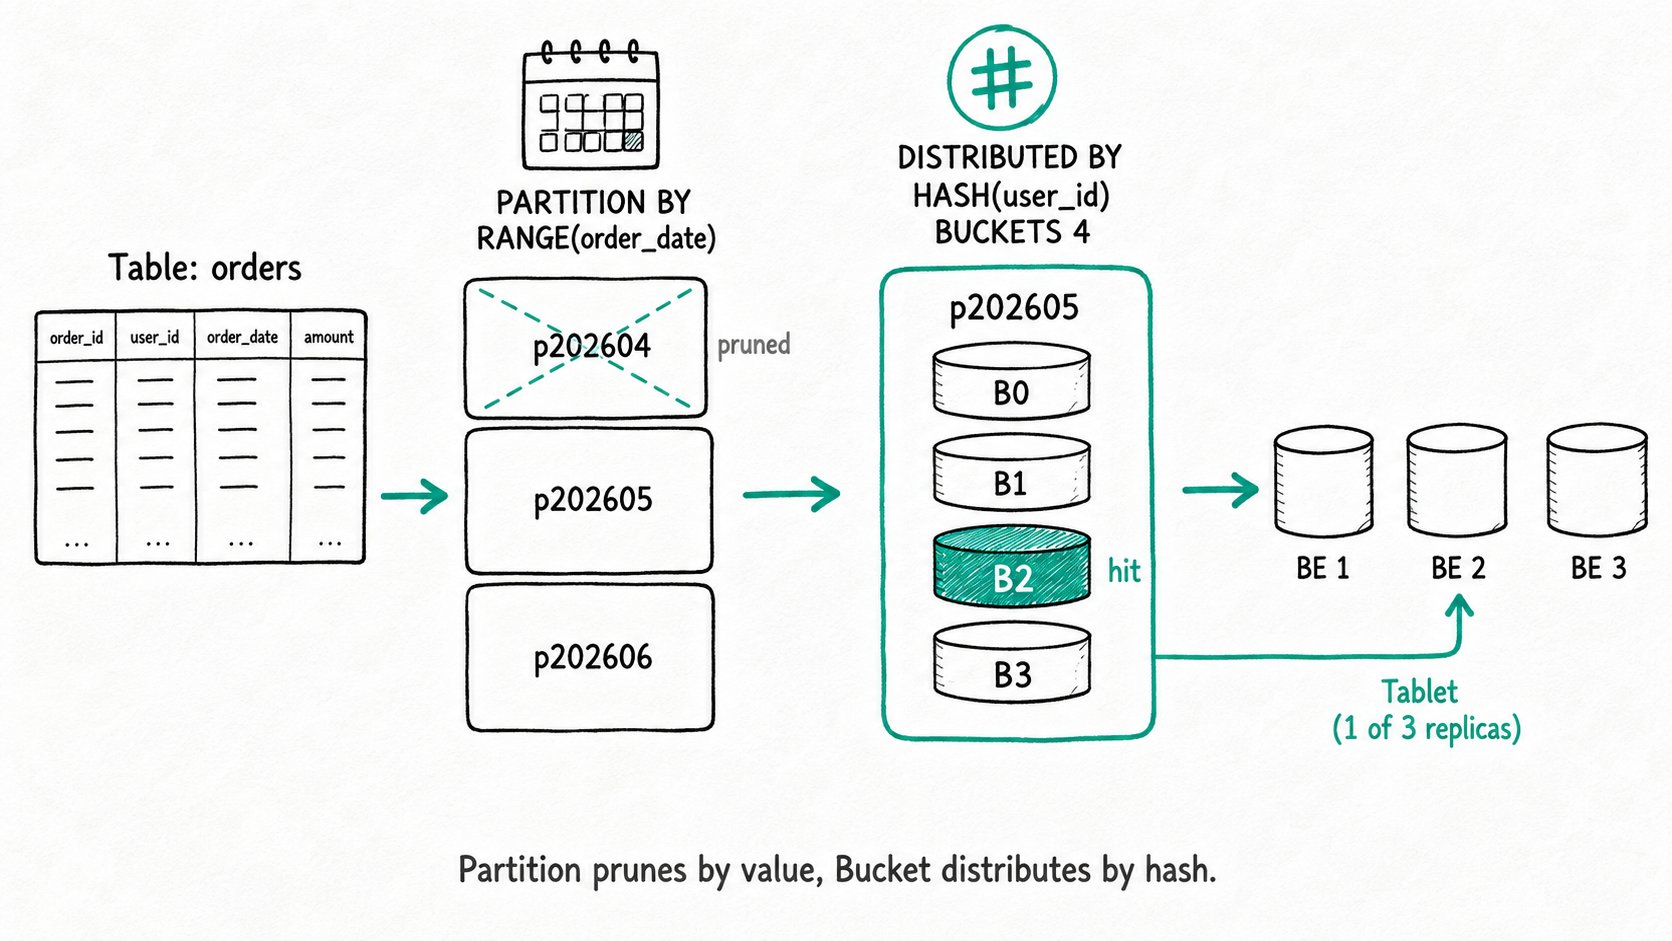
Apache Doris でパーティショニングとバケット分割を使う理由
Apache Doris のパーティショニングとバケット分割は、テーブルが一台のマシンに収まらなくなると現れる三つの問題に対処します。すべてのデータを走査するクエリ、一つの BE に負荷が集中する単一タブレットのテーブル、そして何時間もかかる削除処理です。
- 365 日分のイベントテーブルに対する
WHERE date BETWEEN '2026-04-01' AND '2026-04-07'クエリは、プランナーが残りの 358 日をスキップできると判断できなければ、すべての日付の全行を読み取ります。 - 4 TB のテーブルを一つのタブレットにロードすると、一つの BE の CPU 使用率が 100% になり、ほかの九つの BE はアイドル状態になります。クラスターには並列処理能力があっても、テーブルの構成がそれを利用できません。
- 前四半期のデータを削除する処理が、メタデータの変更ではなく、数時間かかる
DELETEジョブになります。
パーティショニングは一つ目と三つ目の問題を、バケット分割は二つ目の問題を解決します。この二つによって、各行の格納先と、クエリ時にアクセスする BE が決まります。
Apache Doris のパーティショニングとバケット分割とは
Apache Doris のパーティショニングとバケット分割は、すべてのテーブルに適用される二段階の物理配置です。PARTITION BY 句は列の値に基づいてテーブルを重複しない部分集合(Range または List)に分け、DISTRIBUTED BY 句は各パーティションを、レプリケーションと並列処理の単位である固定数のタブレットにさらに分割します。行はまず値に応じてパーティションに割り当てられ、次にハッシュ(またはランダムな割り当て)によってタブレットに割り当てられます。
主な用語
Partition:一つ以上の KEY 列に対する Range または List で定義される行の部分集合です。不要なデータの読み取りを省く処理、アーカイブ、TTL の単位です。Bucket:ハッシュまたはランダムな割り当てによって作られる、パーティションの一部分です。各バケットはレプリカごとに一つのタブレットに対応します。Tablet:物理的なデータシャードです。BE 内でのレプリケーション、スケジューリング、並列処理の単位です。PARTITION BY RANGE / LIST:DDL で宣言する明示的なパーティショニングです。Range は時間や数値の範囲に、List は地域やテナントなど列挙可能な区分に適しています。AUTO PARTITION:書き込み時に必要に応じて作成されるパーティションです。Range ではdate_trunc(col, 'month')、List では列挙値に基づきます。静的なパーティション一覧の代わりになります。DISTRIBUTED BY HASH(col) BUCKETS N:ハッシュで分散するシャードです。crc32(col) % Nでバケットを選び、colに対する等価条件があればバケットプルーニングが可能になります。DISTRIBUTED BY RANDOM BUCKETS N:キーを使わずに行をバケットへ分散します。偏りを避けられますが、バケットプルーニングはできません。Duplicate Key テーブルでのみ使用できます。BUCKETS AUTO:FE がestimate_partition_size、BE 数、ディスク数に基づいてバケット数を決めます。パーティションごとに設定します。
Apache Doris のパーティショニングとバケット分割の仕組み
Apache Doris では、パーティショニングとバケット分割により、INSERT からディスクまでの行の経路が、パーティション選択とタブレット選択の二段階で決まります。
- 行をパーティションに割り当てます。 プランナーがパーティション式を評価します。Range パーティションではソート済みの区間一覧を二分探索し、List パーティションではハッシュマップから値を検索します。一致するパーティションがない場合、Auto Partition はその場で作成します。
- 行をバケットに割り当てます。 ハッシュ分散では
crc32(bucket_cols) % bucket_numを計算します。ランダム分散ではラウンドロビンでタブレットを選びます(load_to_single_tablet = trueの場合はバッチ全体を一つのタブレットに格納します)。 - そのタブレットのレプリカに書き込みます。 各タブレットには、異なる BE 上に N 個のレプリカ(デフォルトでは 3 個)があります。Coordinator がすべてのレプリカに行をストリーミングします。
- クエリ時に読み取り対象を絞り込みます(FE)。
PruneOlapScanPartitionはWHERE述語をパーティションツリーと照合します。PruneOlapScanTabletはバケットキーの等価条件を抽出し、HashDistributionPrunerにハッシュ先のバケットを問い合わせます。EXPLAIN では、残った対象がpartitions=1/365やtablets=1/32と表示されます。 - 残ったタブレットを並列に走査します(BE)。 残った各タブレットが並列走査の単位です。パイプラインエンジンはそれらを BE の各コアに分配します。そのため、4 台の BE 上の 16 タブレットを対象とするクエリは、セッションの調整なしで 16 並列で実行されます。
ディスク上の階層は Table → Partition → Tablet → Rowset → Segment です。コンパクションとレプリケーションはタブレット単位で動作するため、パーティション数とバケット数はクエリの並列度と運用コストの両方を左右します。プランナーが対象のパーティションとタブレットを選んだ後に実行される段階的なプルーニングについては、データプルーニングを参照してください。
クイックスタート
CREATE TABLE orders (
  order_id   BIGINT,
  user_id    BIGINT,
  order_date DATE NOT NULL,
  amount     DECIMAL(10,2)
)
DUPLICATE KEY(order_id, user_id)
AUTO PARTITION BY RANGE (date_trunc(order_date, 'month')) ()
DISTRIBUTED BY HASH(user_id) BUCKETS 16;

INSERT INTO orders VALUES
  (1, 100, '2026-04-15', 99.00),
  (2, 200, '2026-05-02', 50.00);

EXPLAIN SELECT SUM(amount) FROM orders
WHERE order_date >= '2026-05-01' AND user_id = 200;
期待される結果(抜粋)
0:VOlapScanNode
  TABLE: orders
  PREDICATES: order_date >= '2026-05-01', user_id = 200
  partitions=1/2 (p20260501000000)
  tablets=1/16
二か月分のデータから二つのパーティションが自動的に作成されました。プランナーは日付条件によって一つのパーティションを、user_id の等価条件によって十六個のうち一つのタブレットを選んだため、クエリはテーブルの 1/32 を読み取ります。書き込みは十六個すべてのタブレットに分散するため、一回のロードで十六個の BE ワーカーを並列に使用します。
Apache Doris のパーティショニングとバケット分割を使う場面
Apache Doris のパーティショニングは、プルーニングやアーカイブが必要な時系列テーブルや列挙可能な区分を持つテーブルに適しています。バケット分割は、一つのタブレットでは走査や書き込みの処理が追いつかない大きさのテーブルに適しています。
適した用途
- 時系列のファクトテーブル(イベント、注文、ログ)。タイムスタンプに対する Range または Auto Range により、プランナーは一般的なダッシュボードクエリでほぼすべてのパーティションをスキップでき、一か月分の削除はメタデータの変更で済みます。
user_id、device_idなど、カーディナリティが高く等価条件に使われる列に対する同時実行数の多いポイントクエリ。その列でハッシュバケット分割すると、一つのクエリがアクセスするタブレットは一つになります。- テナントや地域など、安定した列挙可能な区分を持つテーブル。テナントで List パーティションを作成すれば、そのパーティションを削除してテナントのデータを除去できます。
- 値の範囲を予測できず、データを増分ロードするテーブル。
AUTO PARTITION BY RANGE(date_trunc(...))は最初の書き込み時にパーティションを作成するため、パーティション管理用の DDL が不要になります。 - 同じキーで二つの大きなテーブルを結合し、多数のノードに処理が広がるケース。両テーブルのバケットキーを合わせて Colocate Join を有効にすると、シャッフルを省けます。
適さない用途
- クエリが絞り込みに使わない、カーディナリティの低い列(ステータスフラグや、値が 5 種類の国など)によるパーティショニング。プランナーはスキップできるパーティションがなく、利用されないパーティションのメタデータ負担だけが生じます。
- 絞り込みに使わない列によるバケット分割。書き込み時にハッシュ計算のコストがかかっても、プルーニングの効果はありません。最も選択性の高い等価条件に使う列を選び、該当する列がなければ
RANDOMを使用します。 - カーディナリティの低い列(たとえば
gender)によるバケット分割。二つの値では 16 個のバケットに分散できず、負荷が集中するタブレットと使われないタブレットが生じます。カーディナリティの高い列を選ぶか、複数の列をバケットキーとして組み合わせます。 - パーティションあたり数百個のバケット。ドキュメント上の上限はパーティションあたり 128 個です。それを超えると書き込みスループットが下がり、FE のメモリ消費量が増えます(タブレット 10 million 個あたり FE メモリ 100 GB が目安)。先にパーティションを設計し、その後でバケットを設計します。
- サイズが数 MB の小さなタブレット。各タブレットには FE のメタデータとコンパクション処理が必要です。圧縮後のサイズでタブレットあたり 1 GB から 10 GB を目安とします(Unique Key テーブルでは 10 GB 未満に抑えます)。
- Unique テーブルや Aggregate テーブルでのランダムなバケット分割。ランダム分散ではマージの正しさを保てないため、Duplicate テーブルでのみ使用できます。
関連資料
- 基本概念:パーティションとバケットを図で解説
- 手動パーティショニング:Range、List、および四つの Range 形式
- 自動パーティショニング:書き込み時に必要に応じてパーティションを作成
- データのバケット分割:方式、キー、バケット数の選び方
- データプルーニング:パーティションとタブレットの選択後に実行される段階的なプルーニング
ALTER TABLE PARTITIONリファレンス- MPP アーキテクチャ:Bucket Shuffle と Colocate Join は、ここで選んだバケット配置を利用してネットワークシャッフルを回避します。
- Unique Key:パーティション列を一意キーの部分集合にする必要があるテーブルモデルです。そうしないと重複排除が正しく機能しません。
