パイプライン実行エンジン
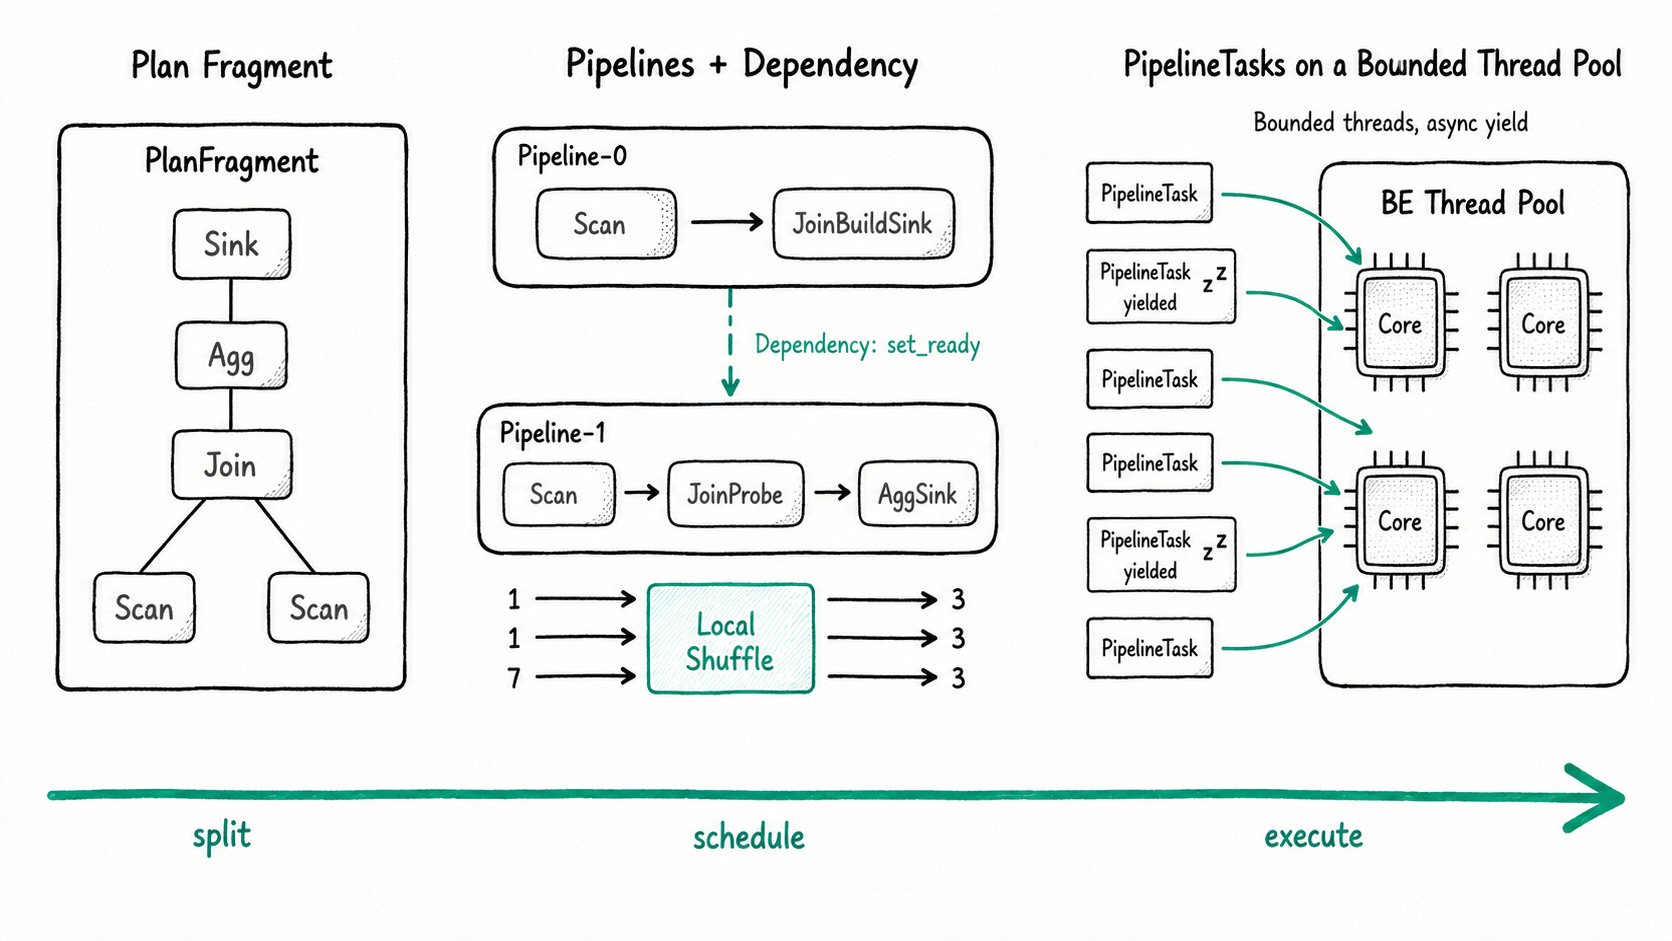
要約 Apache Doris では、パイプライン実行エンジンが v3.0 以降唯一の実行エンジンとなり、従来の Volcano モデルに取って代わりました。各クエリフラグメントは、ソースから始まりシンクで終わるパイプラインの DAG に分割され、BE の CPU 割り当てに基づいて上限が定められた固定サイズの BE スレッドプール上で PipelineTask として実行されます。オペレーターはブロックせずに実行を譲り、Dependency が DAG 内の処理を調整し、Local Shuffle が BE 内の偏ったデータを再分散します。
Apache Doris でパイプライン実行エンジンを使う理由
Apache Doris のパイプライン実行エンジンは、従来の Volcano モデルでは解決できなかった三つの問題に対処します。同時実行時に際限なく増えるスレッド数、データの偏った結合や集約で遊休状態になる CPU コア、そして推測に頼らざるを得ないフラグメントインスタンス単位のチューニングです。以前の Apache Doris の Volcano モデルでは、フラグメントインスタンスごとに専用の OS スレッドを割り当てていました。同時実行するクエリが数件なら問題ありませんが、百件になると状況は変わります。数千ものスレッドが積み上がり、その大半が IO や他のスレッドを待ってブロックされます。やがて BE はカーネルスケジューラーへの過大な負荷とメモリ不足に陥り、処理すべき仕事がなくなる前に処理できなくなります。
旧エンジンには、さらに二つの問題がありました。幅の広いテーブルの集約や、偏ったデータに対する結合では、CPU コアを十分に活用できませんでした。あるバケットに 7 行、ほかのバケットにそれぞれ 1 行ある場合、7 行を処理するタスクが律速となり、残りのクラスタはその完了を待つことになります。また、フラグメントインスタンス単位の同時実行数の調整にはパラメーターが多すぎて、推測に頼る必要がありました。
パイプライン実行エンジンは、これら三つの問題すべてに対処します。スレッド数には上限があり、クエリ数に応じて際限なく増えることはありません。オペレーターは処理を進められないときに実行を譲るため、スレッドを占有せずに解放できます。また、Local Shuffle は BE 内で偏ったデータを再分散し、処理時間の長いタスクを短縮します。
Apache Doris のパイプライン実行エンジンとは
Apache Doris のパイプライン実行エンジンは、各 PlanFragment をパイプラインの DAG に変換し、上限のある BE スレッドプール上でスケジュールする、プッシュ型の非同期クエリ実行モデルです。FE はクエリを Plan にコンパイルして PlanFragment(BE ごとに一つ)に分割し、各 BE は受け取ったフラグメントを Pipeline の DAG に分割します。Pipeline は、一つの SourceOperator(スキャンまたは Exchange)から始まり、一つの SinkOperator(ネットワークシャッフルまたはハッシュテーブルへの書き込み)で終わるオペレーターの連なりです。その間には任意の数のオペレーターを配置できます。互いの完了を待つ必要がある Pipeline は、Dependency によって調整されます。各 Pipeline は並列実行スロットごとに一つずつ、複数の PipelineTask となり、BE 全体で共有する固定サイズのスレッドプール上で実行されます。
主な用語
PlanFragment:FE が一つの BE に送る処理単位です。通常、一つのクエリには複数の PlanFragment があります。Pipeline:一つの BE 上のオペレーターの連なりです。複数の PipelineTask として並列に実行されます。PipelineTask:並列実行スロットに割り当てられた Pipeline の実行インスタンスです。ブロックされたとき、またはタイムスライスが終了したときに実行を譲り、スレッドを解放します。Operator:連なりを構成するノードです。実体化が必要な PlanNode は、Sink と Source の組に分割されることがあります。Join はJoinBuildOperatorとJoinProbeOperator、Agg はAggSinkOperatorとAggSourceOperator、Sort はSortSinkOperatorとSortSourceOperatorになります。Dependency:Pipeline 間で準備が整ったことを知らせるシグナルです。Pipeline-0 がハッシュテーブルの構築を終えてset_readyを呼び出すと、Pipeline-1 のプローブ処理が再開します。- Local Shuffle(Local Exchange):BE 内で HASH または Round Robin を使ってデータを再分配する Pipeline Breaker です。これにより、スキャン時のデータの偏りが結合処理に持ち込まれるのを防ぎます。
parallel_pipeline_task_num:フラグメントごとの並列度を設定するセッション変数です。デフォルトの0は CPU コア数の半分を意味し、通常は変更しないことを推奨します。
Apache Doris のパイプライン実行エンジンの仕組み
Apache Doris のパイプライン実行エンジンは、六つの段階で動作します。FE がフラグメントを計画して送信し、各 BE がフラグメントをパイプラインの DAG に変換し、PipelineTask を生成します。その後、上限のあるスレッドプールでタスクを実行し、Local Shuffle で偏ったデータを再分散し、並列スキャンで遅いバケットによるクエリの停滞を防ぎます。
- FE による計画、分割、送信。 FE はクエリをコンパイルし、BE 間のシャッフルに使う
ExchangeNodeとDataSinkを挿入して、各 PlanFragment を BE に送信します。 - BE による各フラグメントのパイプライン DAG への変換。 ブロッキングオペレーター(ハッシュテーブルの構築、ソート、集約)は、一つの Pipeline を終える Sink と、次の Pipeline を始める Source になります。Dependency が DAG 内の処理を結び付け、Join のプローブ処理は構築側の
set_readyを待ちます。 - PipelineTask の生成。 各 Pipeline は N 個の PipelineTask になります。N 個すべてが同じ Operator の連なりを共有し、タスクごとの LocalState(担当するスキャン範囲、ハッシュテーブルのパーティション、出力バッファ)が異なります。
- 上限のあるスレッドプールでの実行。 PipelineTask は、BE の CPU 割り当てに基づいてサイズが決まる固定サイズのプールに投入されます(上書きする場合は
pipeline_executor_sizeを使用します)。タスクは、タイムスライスが終了する(pipeline_task_exec_time_slice、デフォルトは 100ms)か、Dependency でブロックされるまでループ内で実行されます。どちらの場合も実行を譲り、スレッドは次の実行可能なタスクを処理します。 - 必要に応じた Local Shuffle。 プランナーが、データの偏りがあり得る入力に対する結合、集約、またはウィンドウ関数を検出すると、Local Exchange を挿入します。上流のタスクがバッチを送り込み、下流のタスクが再分散されたバッチを取り出します。これにより、
(1, 1, 7)が(3, 3, 3)に均され、各コアがほぼ同時に処理を終えられます。 - 並列スキャン。 ScanOperator は内部で複数の Scanner を動的に生成します。各 Scanner は 1~2 百万行を受け取り、その場で展開とフィルタリングを行って、結果を DataQueue に送ります。ScanOperator が DataQueue から結果を取り出すため、遅いバケットがクエリ全体を停滞させません。
クイックスタート
パイプライン実行エンジンは v3.0 以降でデフォルトで有効になっており、有効化のための操作は不要です。調整が必要になる可能性がある設定は parallel_pipeline_task_num です。
-- Inspect the default (0 means "half the CPU cores")
SHOW VARIABLES LIKE 'parallel_pipeline_task_num';

-- Pin parallelism for one heavy query without touching the session
SELECT /*+ SET_VAR(parallel_pipeline_task_num=16) */
       l_orderkey, COUNT(*) AS lines, SUM(l_extendedprice) AS gross
FROM lineitem
GROUP BY l_orderkey
ORDER BY gross DESC
LIMIT 100;

-- See the resulting plan and Local Exchange placement
EXPLAIN SELECT /*+ SET_VAR(parallel_pipeline_task_num=16) */
        l_orderkey, COUNT(*) FROM lineitem GROUP BY l_orderkey;
想定される結果
+-------------+-------+----------------+
| l_orderkey  | lines | gross          |
+-------------+-------+----------------+
|     7382118 |     7 |  431295.18     |
|     ...                              |
+-------------+-------+----------------+
このヒントが適用されるのは、このクエリだけです。EXPLAIN では、パイプライン ID、Local Exchange の配置(計画された場合)、オペレーターの連なりを確認できます。プロファイリングを有効にすると、ランタイムプロファイルには PipelineTask ごとの ExecTime、YieldCounts、MemoryReserveFailedTimes が表示されます。実際のワークロードのチューニングに使うのは、これらの指標です。
Apache Doris のパイプライン実行エンジンはいつ使うべきか
Apache Doris のパイプライン実行エンジンは v3.0 以降のすべてのクエリでデフォルトで動作します。そのため、実際に検討すべきなのは、使用するかどうかではなく、いつ調整するかです。同時実行する多様なワークロード、結合が多いクエリやデータの偏ったクエリ、長時間のスキャンではデフォルト設定を使ってください。parallel_pipeline_task_num を上書きするのは、プロファイリングで実際のボトルネックが確認された場合だけにしてください。
適したケース
- v3.0 以降のすべての Apache Doris ワークロード。ほかの実行エンジンはありません。
- BE を共有する多様な同時実行ワークロード。上限のあるスレッドプールにより、クエリ同士の干渉を抑えられます。
- 偏った入力に対して結合や集約を多用するクエリ。Local Shuffle が処理量の偏りを均し、時間のかかるタスクが全体の実行時間を引き延ばすのを防ぎます。
- バケット間の処理量にばらつきがある長時間のスキャン。並列スキャンにより、遅いバケットがほかの処理を停滞させるのを防ぎます。
避けるべきケースや注意点
- アドホッククエリごとに
parallel_pipeline_task_numを調整すること。デフォルト値は調整済みです。長時間実行されるフラグメントで CPU が遊休状態にあることをプロファイリングで確認した場合にのみ値を上げてください。逆に、同時実行数が多いクエリや単純なポイントクエリでは1に下げてください。 enable_pipeline_engineやexperimental_enable_pipeline_x_engineの有効化を勧める古い情報をそのまま使うこと。これらは 2.x 系での実験的な切り替え設定でした。3.0 以降は Volcano モデルが削除されたため、設定しても効果はありません。- このエンジンをベクトル化実行と混同すること。両者は別のレイヤーです。ベクトル化実行はオペレーターがバッチに対して何をするかを決め、Pipeline はそのバッチを各コアでどうスケジュールするかを決めます。もう一方については、ベクトル化実行を参照してください。
- 数千 QPS で処理する、主キーによる単一行の検索。複数の PipelineTask を生成するコストに見合う効果は得られません。このような場合は、重いプランナーを経由しない高同時実行ポイントクエリの経路を使用してください。
関連資料
- パイプライン実行エンジンのリファレンス:Dependency の規則、Local Shuffle の計画、並列スキャンの仕組みを含むアーキテクチャ全体を説明します。
- 並列度のチューニング:シナリオ別に
parallel_pipeline_task_numを設定するタイミングと方法を、安全なデフォルト値の表とともに説明します。 - データの偏りへの対処:プランナーが自動的に解消できなかったクエリの偏りに対処する、Local Shuffle と対になる実践的な方法です。
- ベクトル化実行:Pipeline がスケジュールするオペレーターのレイヤーです。Pipeline と混同されがちですが、両者は独立した仕組みです。
- Workload Group:CPU と同時実行数の制限に使うグループごとの cgroup に、パイプラインスレッドを割り当てるレイヤーです。
- Apache Doris 実行エンジンの進化:Doris が Volcano から Pipeline、さらに PipelineX へ移行した設計の経緯を説明します。
- MPP アーキテクチャ:Pipeline Engine の上位で動作する BE 間のコーディネーターです。一つの SQL をフラグメントの DAG に分割し、各フラグメントを BE に割り当てます。
