リソースグループ
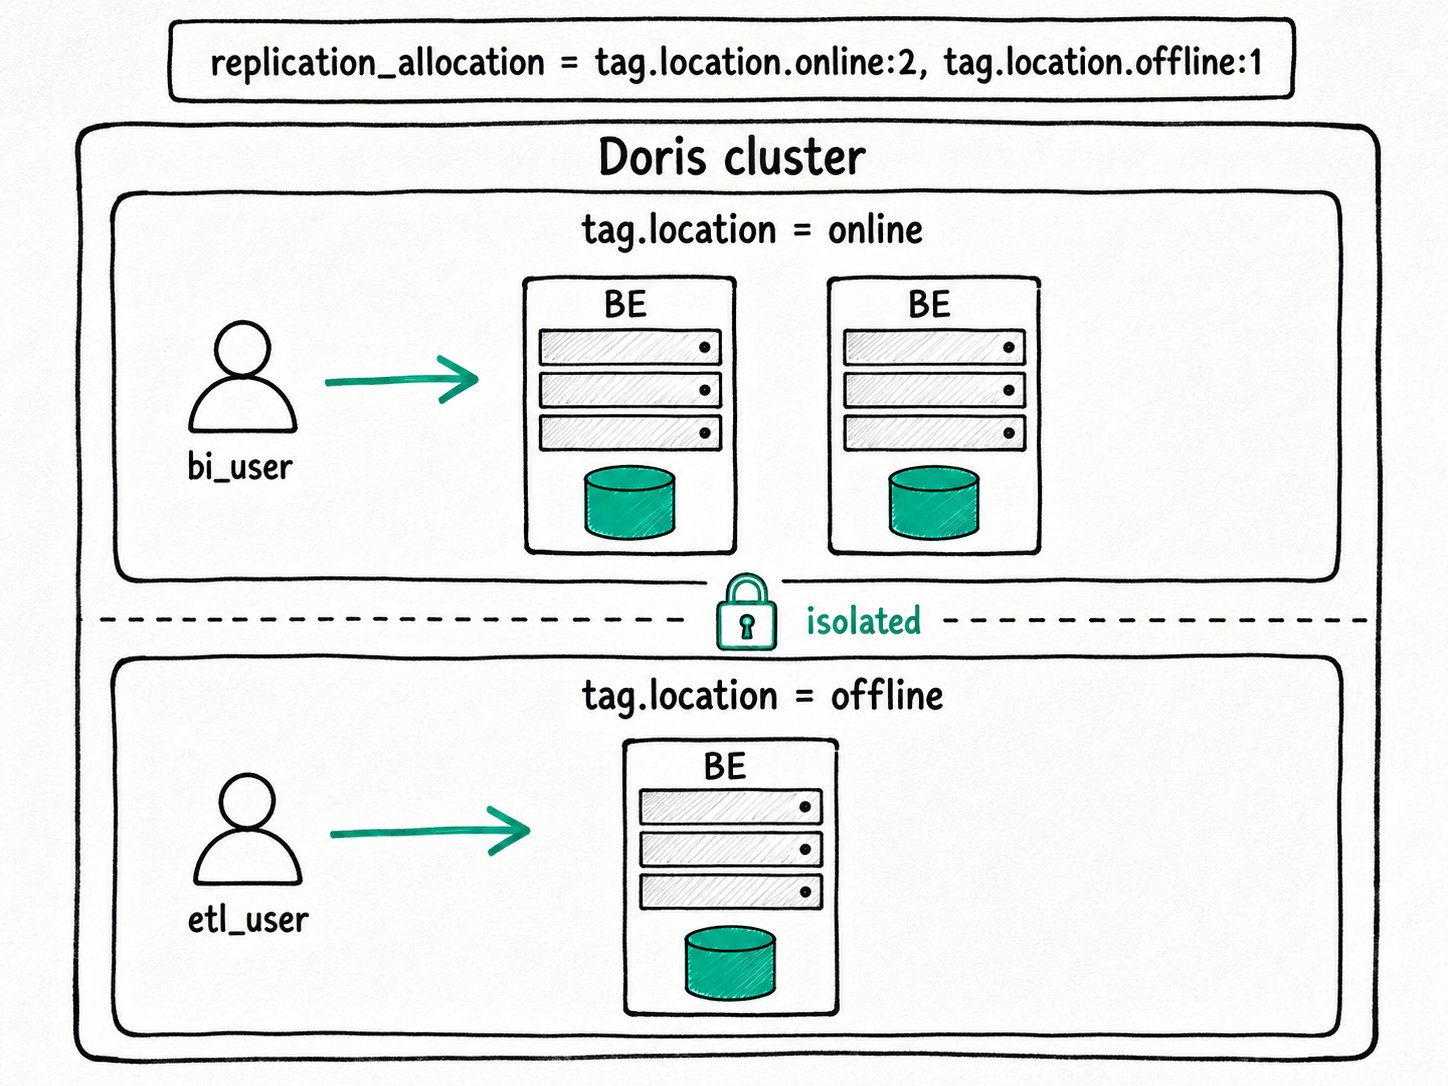
要約 Apache Doris のリソースグループは、BE ノードにタグを付けて名前付きのプールに分け、テーブルのレプリカを各プールに配置し、各ユーザーを一つ以上のプールに紐付けます。クエリはユーザーに割り当てられたプールの BE でのみ実行され、そこに配置されたレプリカだけを読み取ります。プールごとに BE プロセスが異なるため、あるグループでクラッシュや OOM が発生しても、別のグループは停止しません。ただし、ストレージのコストがかかります。テーブルを読み取る各プールには、そのテーブルのレプリカが必要です。
Apache Doris でリソースグループを使う理由
Apache Doris のリソースグループが必要なのは、通常一つのクラスターで複数のワークロードを実行し、それらを互いに分離する必要があるためです。午前 2 時の ETL ジョブが前日のパーティションを書き換える BE では、日中、経営層向けダッシュボードが十五秒ごとにクエリを実行しています。午前 9 時に財務部門のバッチが負荷の高いレポートを再実行する一方で、アナリストが範囲を限定しない SELECT * を実行することもあります。
ワークロードグループは、CPU 用の cgroup、グループごとのメモリトラッカー、グループごとのキューを使って、このような競合の多くを同一プロセス内で処理します。低コストで柔軟ですが、BE のクラッシュには耐えられません。カーネルが OOM によって BE を強制終了すると、その BE 上のすべてのグループが影響を受けます。クエリの実行中に BE でセグメンテーション違反が起きた場合も、ダッシュボードと ETL ジョブの両方で再接続が必要になります。ワークロード同士をプロセス単位で分離する必要がある場合、同一プロセス内の制御だけでは不十分です。
Apache Doris のリソースグループなら、二つ目のクラスターを立ち上げずにこの問題に対応できます。各 BE にラベルを付け、各テーブルでタグごとのレプリカ数を指定し、各ユーザーに利用を許可するタグを割り当てます。クラスターでは FE のクォーラム、スキーマカタログ、認証情報を共有したまま、BE を実行時に相互にリソースを共有しないプールへ分割します。
Apache Doris のリソースグループとは
Apache Doris のリソースグループは、リソースタグに基づく配置とルーティングの機能です。各 BE は、必ず一つの location タグに属します。各テーブルの各レプリカも、テーブル作成時に replication_allocation で決まる一つのタグに属します。各ユーザーが利用できるタグの集合は、resource_tags.location プロパティで決まります。クエリプランナーはこれらを照合し、ユーザーに許可されたタグの BE を選び、その BE に配置されたレプリカのみを読み取ります。
主な用語
tag.location: BE 側のラベルです。ALTER SYSTEM MODIFY BACKEND ... SET ("tag.location" = "<name>")で設定します。BE に指定できる location タグは一つだけで、初期値はdefaultです。replication_allocation: タグとレプリカ数の対応を指定するテーブルまたはデータベースのプロパティで、tag.location.<name>:<n>と記述します。複数のプールにレプリカを配置するには、項目をカンマで区切ります(例:tag.location.online:2, tag.location.offline:1)。resource_tags.location: ユーザーがアクセスを許可されたタグを列挙するユーザープロパティです。複数のタグを許可するには、カンマで区切ります。空の場合は、以下に説明するデフォルトの動作になります。- デフォルトタグ: 組み込みの
defaultタグです。すべての BE は最初このタグに属し、このタグは削除できません。2.0.3 以降、resource_tags.locationを設定していない通常のユーザーに見えるのはdefaultのみです。rootとadminにはすべてのタグが見えます。
Apache Doris のリソースグループの仕組み
Apache Doris のリソースグループは、BE にタグを付ける、タグごとにレプリカを割り当てる、ユーザーをタグに紐付ける、クエリをルーティングする、ロード処理を分ける、という五つの段階で機能します。
- BE にタグを付ける。
ALTER SYSTEM MODIFY BACKEND "host:9050" SET ("tag.location" = "online")を実行します。FE は変更を edit log に記録するため、再起動後も割り当ては維持されます。SHOW BACKENDSのTag列にタグが表示されます。 - タグごとにレプリカを割り当てる。
replication_allocation = "tag.location.online:2, tag.location.offline:1"を指定してテーブルを作成すると、FE は各タグの BE 数が十分かを確認し、tablet scheduler に各スロットへのレプリカ配置を依頼します。確認に失敗すると、"Failed to find enough host with tag(...)" が報告され、DDL は中止されます。このプロパティをデータベースに設定し、新しいテーブルに継承させることもできます。 - ユーザーをタグに紐付ける。
SET PROPERTY FOR 'bi_user' 'resource_tags.location' = 'online'を実行します。変更はグローバルですが、セッションに反映するにはユーザーの再接続が必要です。 - クエリをルーティングする。 ユーザーがクエリを送信すると、FE は許可されたタグから利用対象の BE 集合を決め、その BE に配置されたレプリカだけを使ってクエリを計画します。許可されたどのタグにもテーブルのレプリカがない場合、計画は "no queryable replicas" エラーで失敗します。
- ロード処理を二つに分ける。 ロードジョブには、ソースの読み取り、変換、分散を行う計算部分と、エンコード、圧縮、永続化を行う書き込み部分があります。計算部分はユーザーのタグに従います。書き込み部分はタグにかかわらず、テーブルのレプリカを保持する BE で実行する必要があります。そのため、
offlineに紐付けられたユーザーが Stream Load を送信した場合、計算側は offline の BE で動作しますが、書き込みはすべてのレプリカ所有 BE に及びます。
クイックスタート
-- Tag two BEs into 'online', one into 'offline'
ALTER SYSTEM MODIFY BACKEND "be1:9050" SET ("tag.location" = "online");
ALTER SYSTEM MODIFY BACKEND "be2:9050" SET ("tag.location" = "online");
ALTER SYSTEM MODIFY BACKEND "be3:9050" SET ("tag.location" = "offline");

-- Place 2 replicas in 'online', 1 in 'offline'
CREATE TABLE orders (id BIGINT, region STRING, amount DECIMAL(18,2))
DISTRIBUTED BY HASH(id) BUCKETS 8
PROPERTIES ("replication_allocation" = "tag.location.online:2, tag.location.offline:1");

-- Bind users to their pools
SET PROPERTY FOR 'bi_user'  'resource_tags.location' = 'online';
SET PROPERTY FOR 'etl_user' 'resource_tags.location' = 'offline';
期待される結果
+----------+-------+---------+
| Host     | Alive | Tag     |
+----------+-------+---------+
| be1:9050 | true  | online  |
| be2:9050 | true  | online  |
| be3:9050 | true  | offline |
+----------+-------+---------+
SHOW BACKENDS で割り当てを確認できます。bi_user が再接続すると、そのクエリは二つの online レプリカを使って計画され、be3 にはアクセスしません。etl_user は be3 で実行され、一つの offline レプリカを読み取ります。be3 で BE がクラッシュしても、bi_user には影響しません。
Apache Doris のリソースグループを使う場面
Apache Doris のリソースグループは、単一クラスター上のワークロード間で BE プロセス単位の分離が必要で、プールごとにレプリカを持つための追加のストレージコストを許容できる環境に適しています。
適しているケース
- 単一クラスターでの読み書きの分離: ETL 用のオフラインプールとダッシュボード用のオンラインプールで、共有データセットのレプリカを各プールに一つずつ配置する場合。
- あるテナントの BE のクラッシュや OOM が、他のテナントの障害対応を引き起こしてはならないマルチテナントクラスター。
- ワークロード間の障害分離を維持しながら、複数の物理クラスターを一つに統合したい場合。
- 各プール内でワークロードグループを併用し、CPU とメモリをクエリ単位でさらに分割する場合。詳しくはワークロードグループを参照してください。
適していないケース
- CPU とメモリの緩やかな制限だけが必要で、BE のクラッシュによりすべてが停止することを許容できる場合。ワークロードグループを単独で使用してください。ワークロードグループはグループをまたぐクエリにも対応していますが、リソースグループは対応していません。
- ストレージコストが最も厳しい制約である場合。テーブルを読み取る各プールには、そのテーブルのレプリカが必要です。プールが五つあれば、共有テーブルごとに五つのレプリカが必要となり、ストレージコストはグループ数に比例して増加します。
- ストレージとコンピュートを分離したクラウド環境を使用している場合。対応する機能はコンピュートグループです。ストレージを共有するため、レプリカを増やさずに同様のノード単位の分離を実現できます。
- プールをまたぐ負荷の高いアドホック分析を行う場合。プランナーは異なるタグの BE を組み合わせて一つのクエリを実行できません。必要なレプリカがない場合、別のプールへフォールバックせず、"no queryable replicas" が返されます。
- ロードの書き込み側も分離されることを期待する場合。書き込み側は必ずレプリカ所有 BE に到達し、タグに従うのは計算側だけです。
関連資料
- リソースグループのリファレンス: SQL の全構文、検証ルール、ロード処理の分離についての詳細。
- ワークロード管理の概要: リソースグループ、ワークロードグループ、コンピュートグループの比較。
- ワークロードグループ: 通常リソースグループと併用する、同一プロセス内での分離機能。
- コンピュートグループ: ストレージとコンピュートを分離した環境向けの、ストレージ使用量を増やさない対応機能。
- Apache Doris におけるマルチテナントのワークロード分離: リソースグループとワークロードグループの補完関係を含め、分離機能全体を解説した設計記事。
