Unique Key モデル
要点 Apache Doris の Unique Key モデルは、主キーごとに一行を保持する主キーテーブルモデルです。トランザクションデータベースのように SQL の
UPDATEとDELETEを使用できます。部分カラムの upsert は Stream Load からテーブルに直接書き込めます。バージョン 2.1 以降、Unique Key モデルはデフォルトで Merge-on-Write を使用します。重複は書き込み時に解決されるため、クエリは読み取り時のバージョン統合を必要としません。
Apache Doris の Unique Key モデルを使う理由
Apache Doris の Unique Key モデルは、OLAP エンジンに実際の主キーの性質を与えます。キーごとに一行を保持し、書き込み時に一意性を即座に確保し、パーティションを書き直さずに SQL の UPDATE と DELETE を実行できます。多くの分析エンジンでは、テーブルへの追加のみを想定しています。しかし CDC では変更を扱う必要があります。MySQL の行が更新される、ユーザーが GDPR に基づいて削除を要求する、遅れて届いたイベントで古いイベントを上書きする、といった場合です。追加のみのテーブルモデルでも変更を記録できますが、パーティション全体を書き直さずに古いバージョンをウェアハウスから消すことはできません。
- Flink CDC ジョブが MySQL を監視し、主キーの更新を数秒以内に反映する必要がある。
- 注文ステータスのテーブルでは
created、paid、shipped、deliveredと状態が変わり、クエリには最新の状態だけを表示したい。 - ユーザープロファイルのテーブルをリアルタイム結合に使用し、結合結果に昨日のメールアドレスが現れないようにしたい。
こうした用途に適しているのが Unique Key モデルです。既存のキーで新たに書き込むと古い行が置き換えられ、SQL の UPDATE と DELETE が使えます。それでも分析クエリはカラムナーストレージの速度で実行できます。他の OLAP エンジンで最も近いものは ClickHouse の ReplacingMergeTree ですが、こちらは即時の一意性を保証しません。バックグラウンドのマージが実行されるまで重複行は見えたままで、その後もエンジンが保証するのは最終的な重複排除だけです。書き込み直後のクエリでも古いバージョンが見える可能性があり、読み取り時に重複排除を強制する SELECT ... FINAL は相応のコストがかかる回避策です。Unique Key モデルでは、書き込み時に新しい行が古い行を置き換え、次のクエリからキーごとに一行だけが見えます。
Apache Doris の Unique Key モデルとは
Apache Doris の Unique Key モデルは、Merge-on-Write エンジンが書き込み時に一意性を保証し、主キーごとに正確に一行を保持するテーブルモデルです。キーカラムは、UNIQUE KEY(...) 句を使って CREATE TABLE で指定します。それ以外はすべて値カラムになります。同じキーを持つ二行は共存できません。既存のキーで新たに書き込むと、その行が置き換えられます。
... UNIQUE KEY(order_id) ...
... UNIQUE KEY(tenant_id, user_id) ...
FE カタログはこのモデルを KeysType.UNIQUE_KEYS として記録します。以降、ストレージエンジンはこの定義に従います。モデルは作成時に固定され、後から変更できません。
主な用語
- 主キー:
UNIQUE KEY(...)で指定したカラムです。ディスク上のデータを並べ替える基準となり、一意性も保証します。 - 値カラム:それ以外のすべてのカラムです。集計せず、書き込まれた値のまま保存します。
- Merge-on-Write (MoW):2.1 以降のデフォルトのバックエンドです。新しい書き込みでは既存の行を検索し、行セットごとの削除ビットマップでその行 ID のビットを立て、新しい行を新規の行セットに追加します。
- Merge-on-Read (MoR):従来のバックエンドです。書き込み時は追加のみを行い、読み取り時にキーごとの複数のバージョンを統合します。
enable_unique_key_merge_on_write = falseで引き続き選択できます。 - 削除ビットマップ:
(rowset_id, segment_id, version)をキーとし、クエリが読み飛ばす行 ID を列挙する Roaring ビットマップです。MoW で読み取り時の統合に代わる仕組みです。 - シーケンスカラム(
function_column.sequence_col):同じキーに対する二つの更新のうち、どちらを採用するかを決める値カラムです。順序が前後して届く CDC イベントでも新しい状態を維持できます。 - 部分カラム更新:一部のカラムだけを書き込む upsert です。Apache Doris は既存の行から残りのカラムを読み取り、完全な行を書き戻します。
__DORIS_DELETE_SIGN__:非表示の tinyint カラムです。任意のロード経路から1に設定すると、その行を論理削除します。
Apache Doris の Unique Key モデルの仕組み
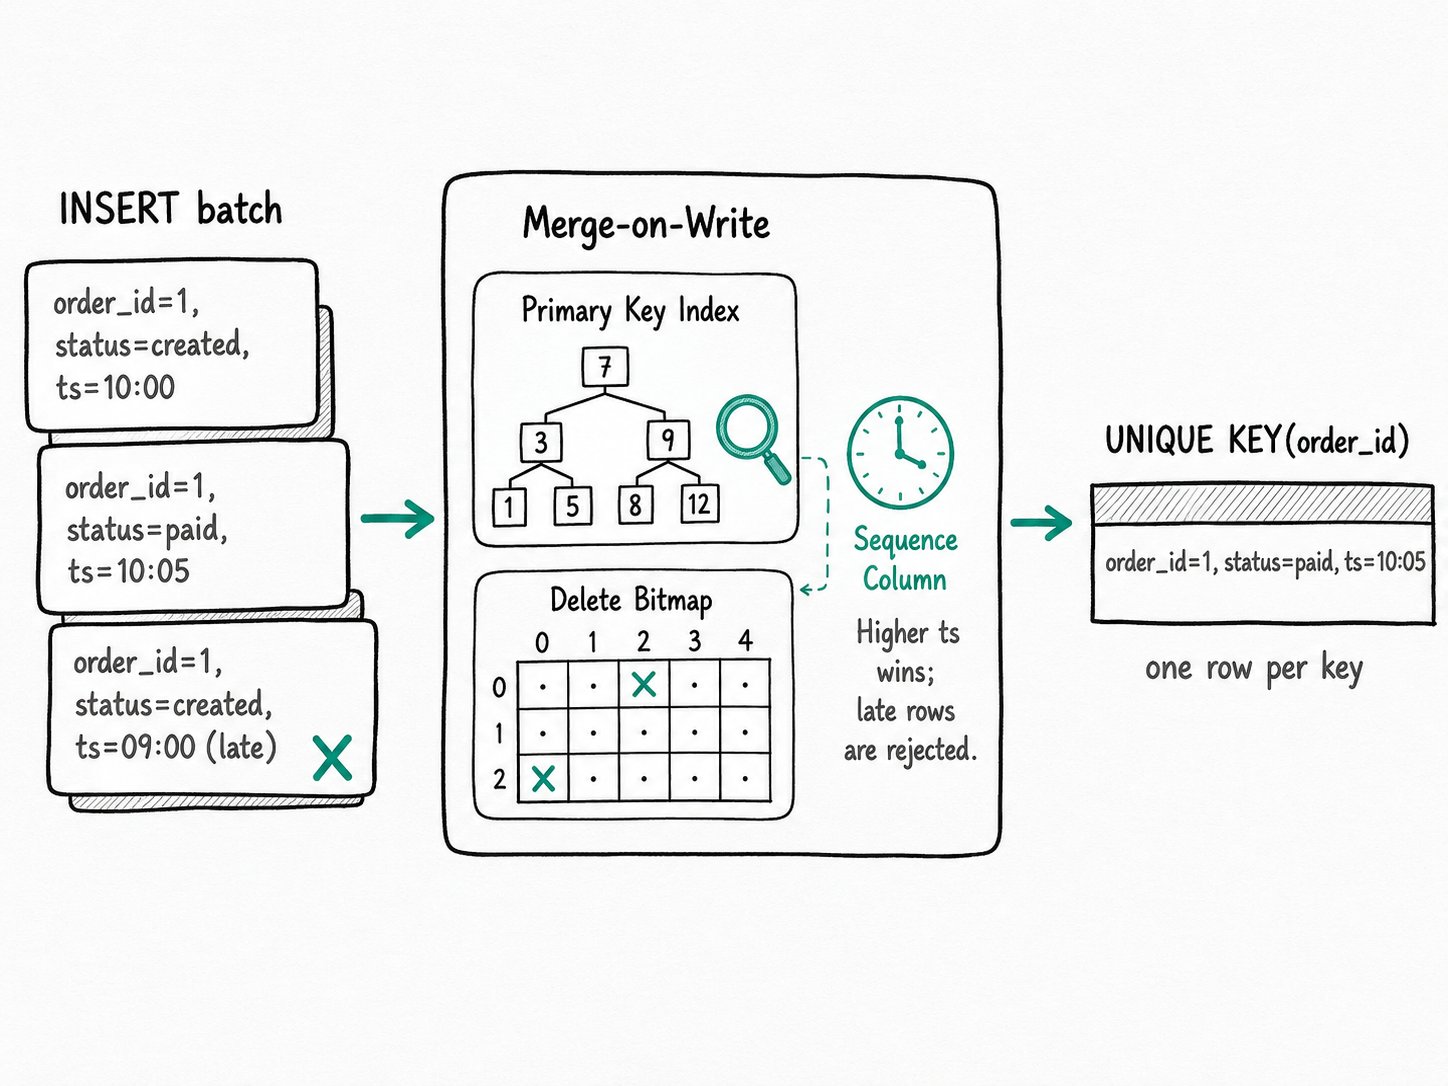
Apache Doris の Unique Key モデルは、バッチのバッファリング、セグメントごとの主キーインデックスでのキー検索、古い行の削除ビットの設定、シーケンスカラムによる順序の解決、新しい行セットの公開という五段階で各 upsert を処理します。
Unique Key の MoW テーブルに対する upsert を例に見てみましょう。
- バッチをバッファリングする。 BE は受け取った行を memtable に集め、キーで並べ替えます。
- 各キーを検索する。 BE はバッチ内の各キーについて、セグメントごとの主キーインデックスを参照し、既存の行セットと行 ID を探します(キーごとに短い読み取りを一回行います)。このインデックスは、各セグメントのフラッシュ時に構築されるソート済みのページ分割された構造で、概念的には RocksDB のパーティション化されたインデックスに似ています。
- 古い行をマークする。 対象の各行セットについて、削除ビットマップ内の古い行 ID に対応するビットを立てます。ビットマップは
(rowset_id, segment_id, version)ごとに管理され、古いデータはコンパクションで回収されるまでディスクに残ります。 - シーケンスカラムで順序を解決する。
function_column.sequence_colが設定されている場合、MoW は入力行のシーケンス値を現在の行の__DORIS_SEQUENCE_COL__と比較します。値が大きい方が優先されます。同値の場合はロード順が使われます。シーケンスの型は整数、DATE、DATETIME、TIMESTAMP_NSのいずれかでなければなりません。 - 新しい行セットを公開する。 トランザクションがコミットされ、新しいバージョンが可視になります。それ以降のクエリは統合された削除ビットマップに従って行を除外します。読み取り時にバージョンを統合する処理はありません。
DELETE FROM ... WHERE も、新しい行セットを作らない点を除けば同じ流れに従います。部分更新では、書き込み前に各キーの更新対象外のカラムを BE が読み取り、完全な行として保存する工程が加わります。
クイックスタート
CREATE TABLE orders (
  order_id BIGINT,
  status   VARCHAR(20),
  amount   DECIMAL(10, 2),
  updated  DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4
PROPERTIES ("function_column.sequence_col" = "updated");

INSERT INTO orders VALUES
  (1, 'created', 99.50, '2026-05-08 10:00:00'),
  (1, 'paid',    99.50, '2026-05-08 10:05:00'),
  (1, 'created', 99.50, '2026-05-08 09:00:00');  -- late event

SELECT * FROM orders;
期待される結果
+----------+--------+--------+---------------------+
| order_id | status | amount | updated             |
+----------+--------+--------+---------------------+
|        1 | paid   |  99.50 | 2026-05-08 10:05:00 |
+----------+--------+--------+---------------------+
三回の挿入で、残る行は一行です。二回目の INSERT ではキーが一致したため、最初の行が上書きされました。三回目にも上書きを試みましたが、updated の値が現在のシーケンス値より古いため、MoW は既存の行を維持しました。function_column.sequence_col プロパティを外すと、ロード順だけで三番目の行が優先されます。これは CDC では望ましくありません。
Apache Doris の Unique Key モデルを使うべき場面
Apache Doris の Unique Key モデルは、CDC の書き込み先、リアルタイムのディメンションテーブルやルックアップテーブル、頻繁に変わる注文・ユーザー・残高のテーブル、store_row_column を併用する KV 形式のポイント検索、GDPR に対応する行単位の削除、複数の上流システムからのワイドテーブル構築に適しています。一方、追加のみのイベントストリーム、単一行を高頻度で更新するループ、ランダムな主キーや非常に幅の広い主キー、従来の Merge-on-Read バックエンドで count(*) を多用するワークロードには適していません。
適している用途
- MySQL、Postgres、その他の主キーを持つソースからの CDC の書き込み先。ソースのコミット時刻または LSN を使うシーケンスカラムと組み合わせます。Kafka CDC 連携 を参照してください。
- ファクトテーブルのクエリに結合する、リアルタイムのディメンションテーブルやルックアップテーブル。
- 頻繁に変更され、分析クエリの対象となる注文、ユーザー、残高、セッション状態のテーブル。
- MoW と
store_row_columnをプリペアドステートメントと組み合わせる KV 形式のポイント検索。高並行ポイントクエリ を参照してください。 - ユーザー ID に基づく GDPR 対応の行単位の削除。任意のロード経路で
__DORIS_DELETE_SIGN__を使った論理削除も含みます。 - 上流システムごとに担当するカラム群が異なり、
partial_columns: trueを指定した Stream Load で担当カラムだけを書き込むワイドテーブル構築。部分カラム更新 を参照してください。
適していない用途
- 追加のみのイベントストリーム(ログ、クリックストリーム、IoT の測定値)。使わない機能のために、書き込みごとにキーインデックスを検索するコストが発生します。代わりに Duplicate Key モデルを選んでください。データモデル を参照してください。
- 単一行の
UPDATEを繰り返す高頻度のループ。各ステートメントが個別のトランザクションとなり、コミットのオーバーヘッドが支配的になります。partial_columns: trueを指定した Stream Load でまとめて処理するか、グループコミット を使用してください。 - ランダムな主キーや非常に幅の広い主キー(UUID、長い複合キー)。ロードバッチごとに主キーインデックスをたどるため、ランダムなキーではキャッシュの局所性が失われます。整数を優先し、キーの幅を抑え、値を収められる最小の型を使用してください。浮動小数点型、倍精度浮動小数点型、および
ARRAY、MAP、STRUCT、JSON、VARIANTのような複合型は、キーカラムとして指定できません。 - 主キーを包含するパーティションキー。パーティションカラムは必ず一意キーの部分集合でなければならず、逆にはできません。そうでないと同じキーが二つのパーティションに配置され、重複排除が機能しなくなります。
- MoR 版で
count(*)を多用するワークロード。MoR はクエリ時にバージョンを再構築するため、件数の集計にコストがかかります。Merge-on-Write(2.1 以降のデフォルト)を有効にするか、データが本当に追加のみなら Duplicate Key モデルに切り替えてください。
関連情報
- Unique Key モデル:SQL 構文、Merge-on-Write と Merge-on-Read の違い、パーティションの規則、作成時のプロパティの詳細。
- データの更新と削除:SQL の操作(
UPDATE、DELETE、部分カラムの upsert、パーティションのアトミックな入れ替え)と、その基盤となる Merge-on-Write の内部動作。 - データモデル:Unique Key、Duplicate Key、Aggregate Key の比較と、各モデルに適したワークロード。
- シーケンスカラムによる同時実行制御:使用可能な型、null の扱い、順序が前後した書き込みの解決方法。
- 高並行ポイントクエリ:Unique Key テーブルを KV ストアとして使うためのショートサーキットプラン。
- Apache Doris 2.1.0:Merge-on-Write が Unique Key のデフォルトに
