レイクハウスの概要
レイクハウスは、データレイクとデータウェアハウスの利点を組み合わせた、現代的なビッグデータソリューションです。データレイクの低コストと高い拡張性に、データウェアハウスの高性能と強力なデータガバナンス機能を組み合わせることで、ビッグデータ時代のさまざまなデータを効率的かつ安全に、品質を管理しながら保存、処理、分析できます。標準化されたオープンなデータ形式とメタデータ管理を通じて、リアルタイムデータと履歴データ、バッチ処理とストリーム処理を統合し、企業向けビッグデータソリューションの新たな標準になりつつあります。
Doris のレイクハウスソリューション
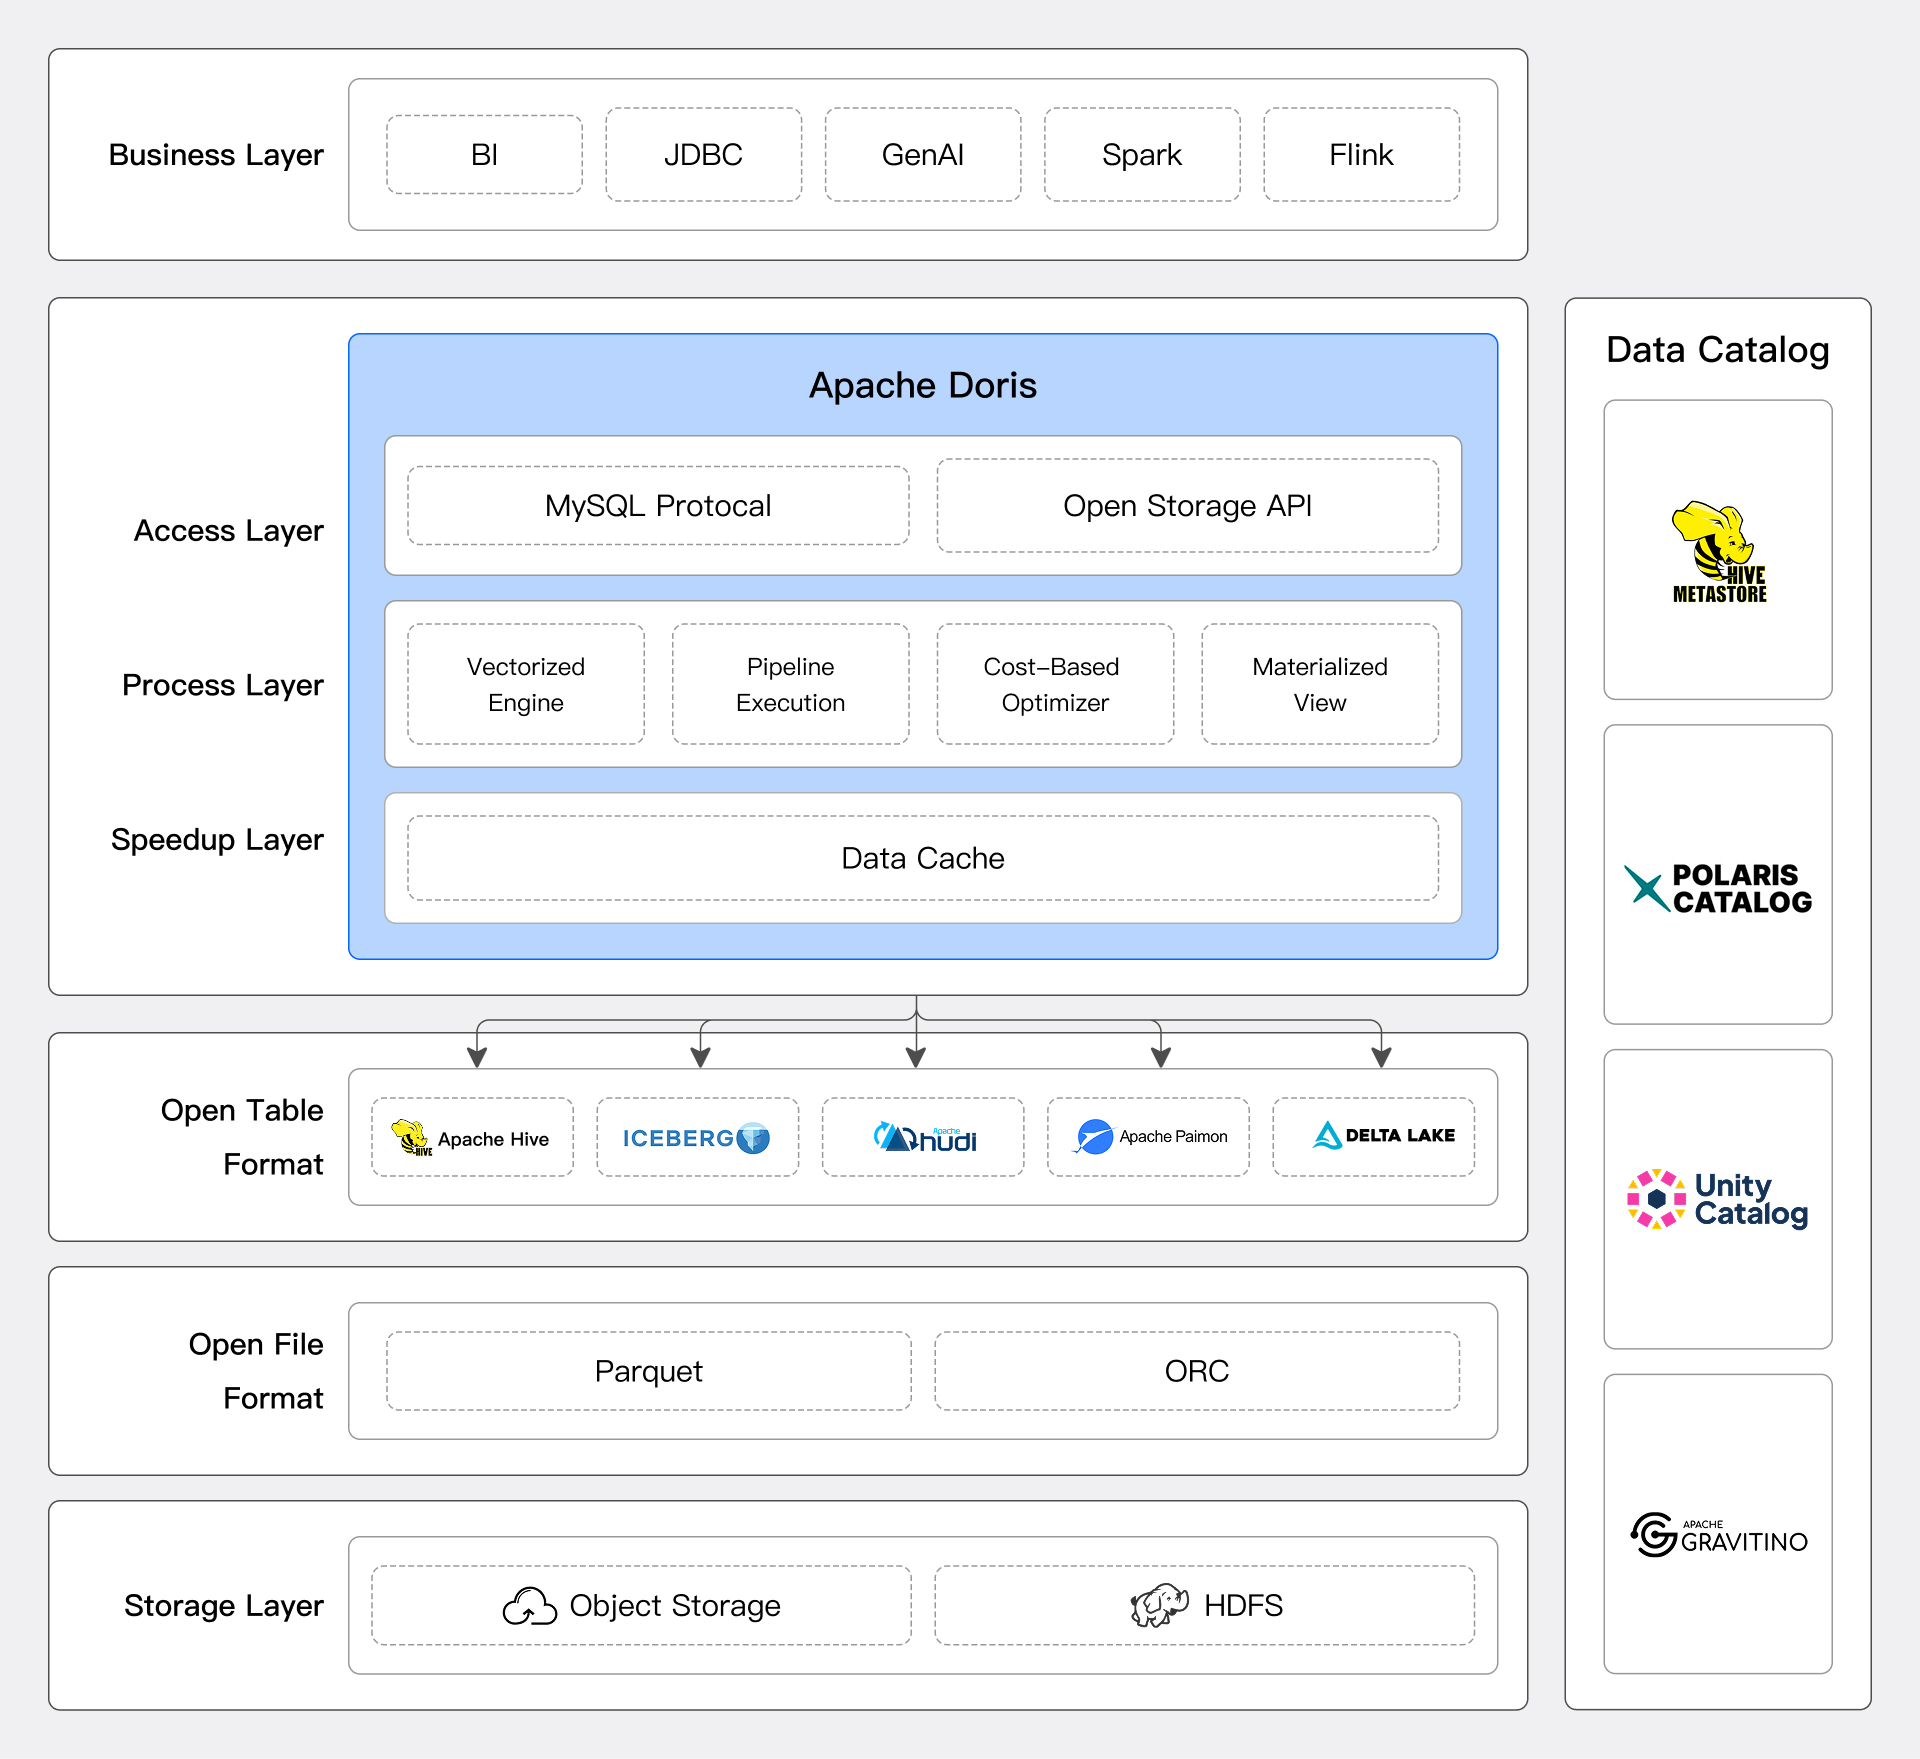
Doris は、拡張可能なコネクターフレームワーク、コンピュートとストレージを分離したアーキテクチャ、高性能なデータ処理エンジン、データエコシステムに対するオープン性を通じて、優れたレイクハウスソリューションを提供します。
柔軟なデータアクセス
Doris は、拡張可能なコネクターフレームワークを通じて主要なデータシステムやデータ形式へのアクセスをサポートし、SQL に基づく統一されたデータ分析機能を提供します。既存のデータを移動せずに、異なるプラットフォームにまたがるデータのクエリや分析を容易に実行できます。詳しくは、Catalog の概要を参照してください。
データソースコネクター
Hive、Iceberg、Hudi、Paimon、JDBC プロトコルをサポートするデータベースシステムなどに、Doris は容易に接続し、効率的にデータへアクセスできます。
レイクハウスシステムでは、Doris は Hive Metastore、AWS Glue、Unity Catalog などのメタデータサービスからデータテーブルの構造と分布に関する情報を取得し、適切なクエリ計画を立て、MPP アーキテクチャを活用して分散計算を実行できます。
詳しくは、Iceberg Catalogなど、各 Catalog のドキュメントを参照してください。
拡張可能なコネクターフレームワーク
Doris は、開発者が企業固有のデータソースへ迅速に接続し、データ連携を実現できる拡張フレームワークを提供します。
Doris は Catalog、Database、Table という三つの階層の標準を定義しており、開発者は必要なデータソースの階層へ容易に対応付けられます。また、メタデータサービスとストレージサービスへアクセスするための標準インターフェースも提供します。開発者は対応するインターフェースを実装するだけで、データソースへの接続を完成できます。
Doris は Trino Connector プラグインと互換性があり、Trino のプラグインパッケージを Doris クラスターへ直接デプロイできます。最小限の設定で、対応するデータソースへアクセスできます。Doris はすでに Kudu、BigQuery、Delta Lake などのデータソースへの接続に対応しています。新しいプラグインを自分で適合させることもできます。
データソースをまたぐ便利なデータ処理
Doris は、実行時に複数のデータ Catalog を作成し、SQL を使用してそれらのデータソースに対するフェデレーションクエリを実行できます。たとえば、Hive のファクトテーブルのデータと MySQL のディメンションテーブルのデータを結合してクエリできます。
SELECT h.id, m.name
FROM hive.db.hive_table h JOIN mysql.db.mysql_table m
ON h.id = m.id;
Doris に組み込まれたジョブスケジューリング機能と組み合わせれば、定期タスクを作成してシステムの複雑さをさらに軽減できます。たとえば、上記のクエリを毎時実行する定期タスクを設定し、毎回の結果を Iceberg テーブルに書き込めます。
CREATE JOB schedule_load
ON SCHEDULE EVERY 1 HOUR DO
INSERT INTO iceberg.db.ice_table
SELECT h.id, m.name
FROM hive.db.hive_table h JOIN mysql.db.mysql_table m
ON h.id = m.id;
高性能なデータ処理
分析用データウェアハウスとして、Doris はレイクハウスのデータ処理と計算に多くの最適化を施し、豊富なクエリ高速化機能を提供します。
-
実行エンジン
Doris の実行エンジンは MPP 実行フレームワークと Pipeline データ処理モデルに基づき、複数マシン・複数コアの分散環境で大量のデータを高速に処理できます。演算子を全面的にベクトル化しているため、TPC-DS などの標準ベンチマークデータセットで高い計算性能を発揮します。
-
クエリオプティマイザ
Doris はクエリオプティマイザを通じて、複雑な SQL リクエストを自動的に最適化、処理できます。複数テーブルの結合、集約、ソート、ページネーションなどの複雑な SQL 演算子を詳細に最適化します。コストモデルと関係代数の変換を十分に活用して、より良い、または最適な論理実行計画と物理実行計画を自動的に導き、SQL の記述を容易にするとともに、使いやすさと性能を向上させます。
-
データキャッシュと IO の最適化
外部データソースへのアクセスは通常ネットワーク経由となるため、レイテンシが高く、安定性が低い場合があります。Apache Doris は豊富なキャッシュ機構を提供し、キャッシュの種類、有効期間、戦略について多くの最適化を施しています。メモリとローカルの高速ディスクを十分に活用し、頻繁に参照されるデータの分析性能を高めます。さらに、スループットが高い、IOPS が低い、レイテンシが高いといったネットワーク IO の特性に合わせて最適化することで、ローカルデータに匹敵する外部データソースへのアクセス性能を提供します。
-
マテリアライズドビューと透過的な高速化
Doris は、全量更新とパーティション単位の増分更新に対応する、多様なマテリアライズドビューの更新方式を提供します。これにより、構築コストを抑え、データの鮮度を高められます。手動更新に加えて、定期更新とデータ駆動型の更新にも対応し、保守コストをさらに削減してデータの一貫性を向上させます。マテリアライズドビューには透過的な高速化機能もあり、クエリオプティマイザが適切なマテリアライズドビューへ自動的にルーティングして、クエリをシームレスに高速化します。また、Doris のマテリアライズドビューは高性能なストレージ形式を使用します。列指向ストレージ、圧縮、インテリジェントなインデックス技術によって効率的なデータアクセスを実現し、データキャッシュの代替手段としてもクエリ効率を向上させます。
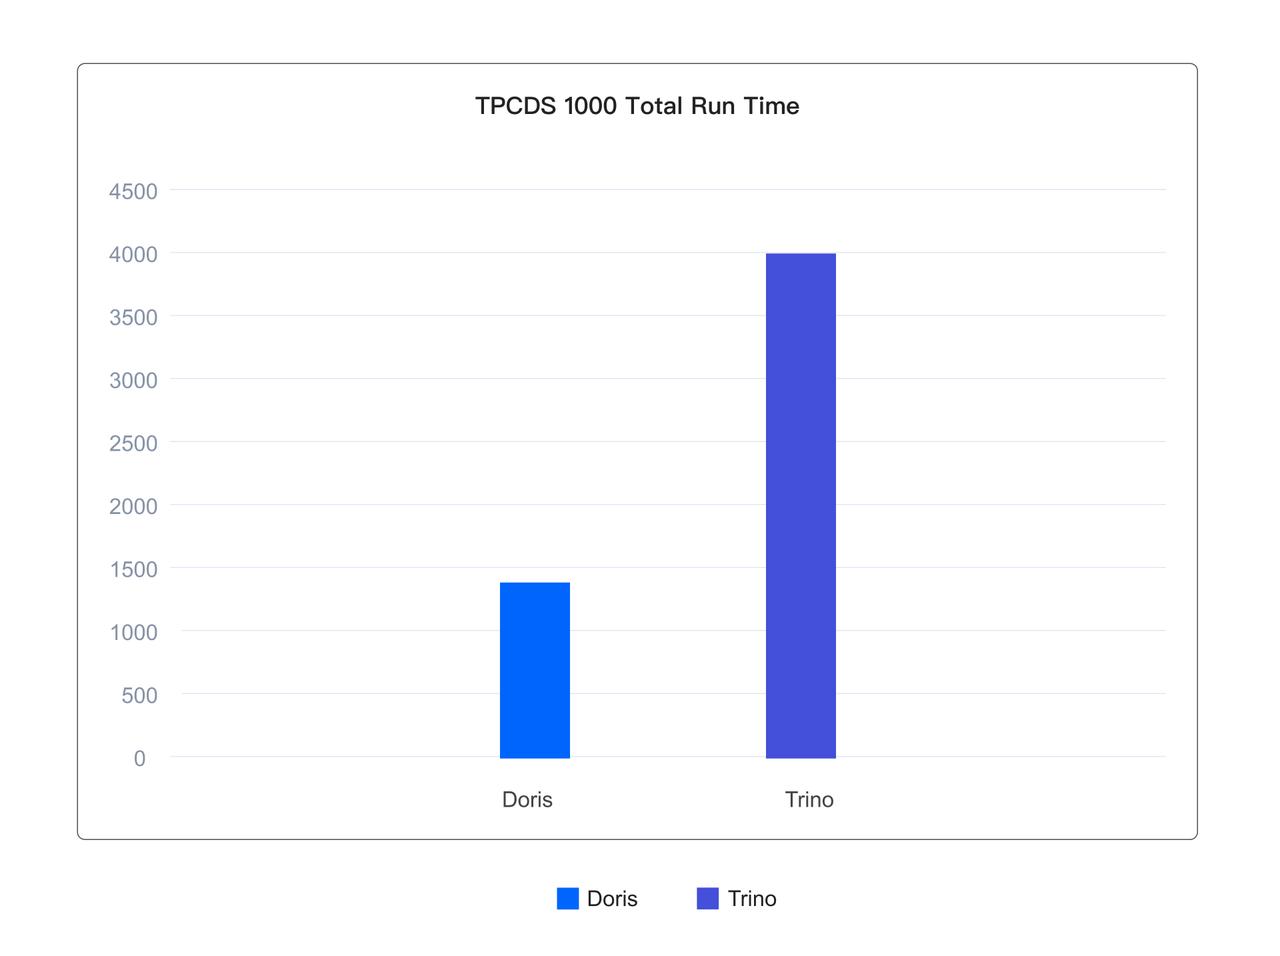
以下に示すように、Iceberg テーブル形式を使用した 1TB の TPCDS 標準テストデータセットでは、Doris が 99 件のクエリ全体を実行する時間は Trino のわずか 1/3 です。
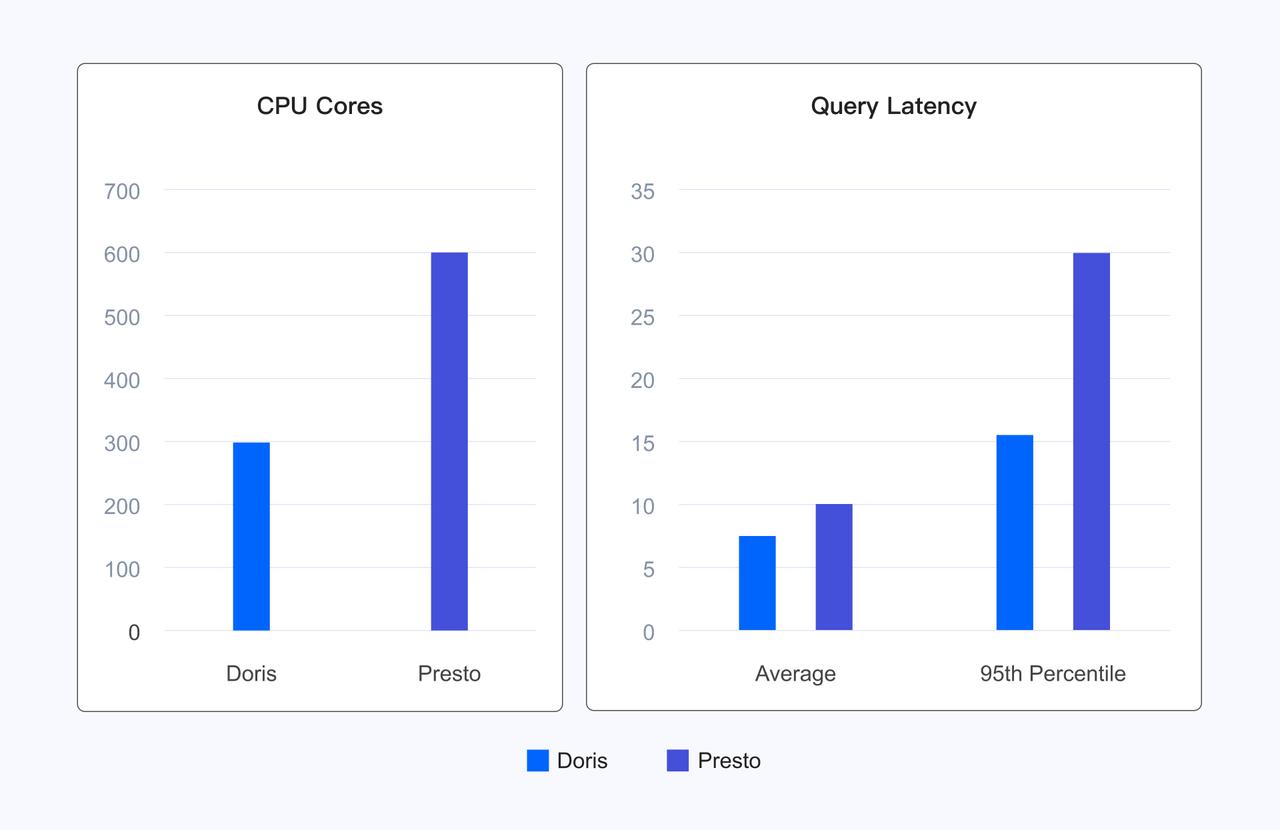
実際のユーザー環境では、Doris は Presto と比較して、半分のリソースで平均クエリレイテンシを 20%、95 パーセンタイルのレイテンシを 50% 削減し、ユーザー体験を向上させながらリソースコストを大幅に削減します。
容易なサービス移行
複数のデータソースを統合してレイクハウスへ移行する過程では、システムごとに SQL の構文や関数のサポートが異なるため、SQL クエリを Doris へ移行することが課題になります。適切な移行計画がなければ、移行先システムの SQL 構文に適合させるために、業務側で大幅な変更が必要になる場合があります。
モダンなデプロイアーキテクチャ
Doris はバージョン 3.0 以降、クラウドネイティブなコンピュートとストレージを分離したアーキテクチャをサポートしています。このアーキテクチャは、低コストと高い伸縮性によってリソース使用率を効果的に改善し、コンピュートとストレージを個別にスケールできるようにします。
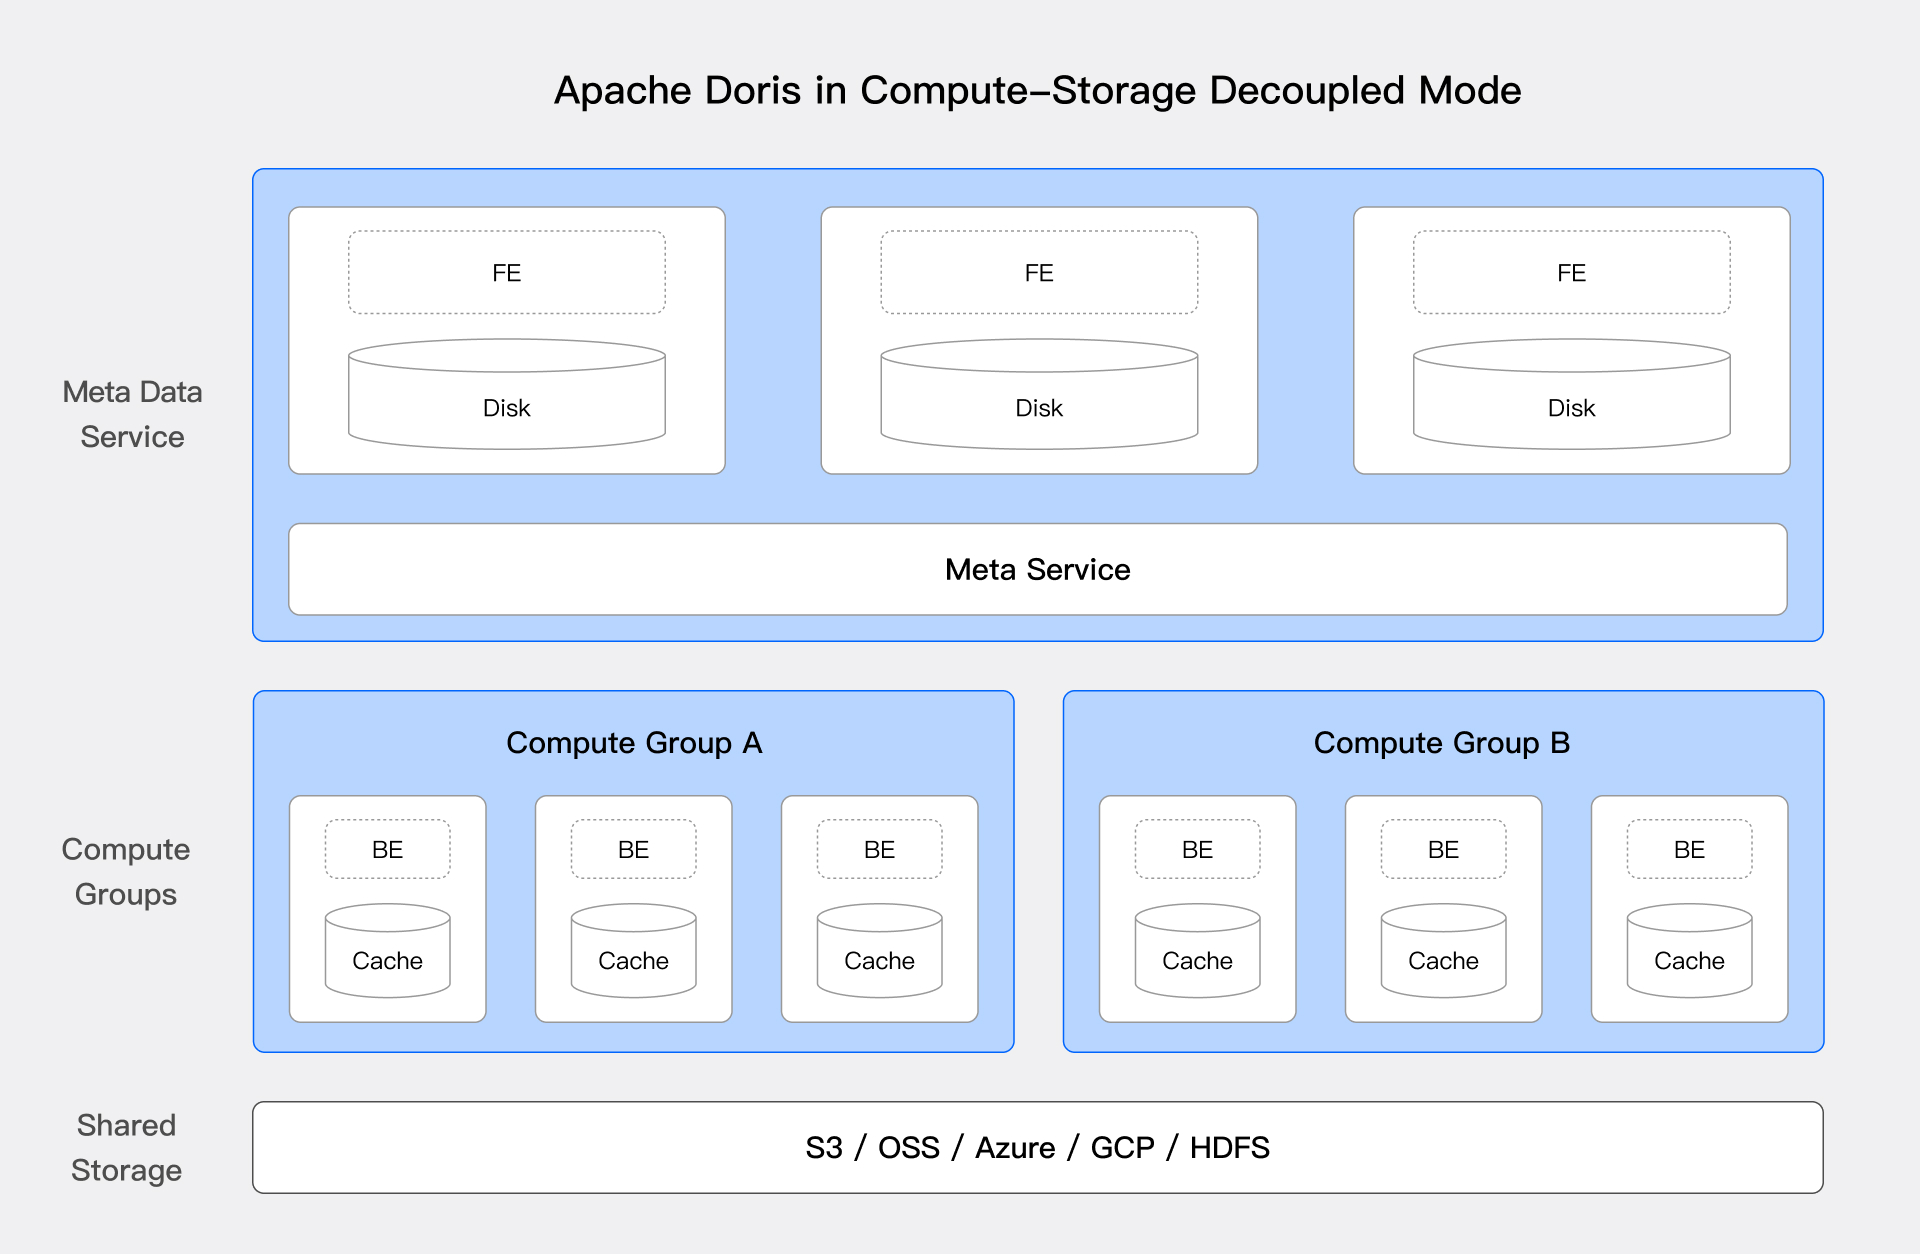
上の図は、コンピュートとストレージを分離した Doris のシステムアーキテクチャを示しています。コンピュートノードはプライマリデータを保持せず、基盤となる共有ストレージ層(HDFS とオブジェクトストレージ)が統一されたプライマリデータの保存先となります。これにより、コンピュートとストレージのリソースを個別にスケールできます。このアーキテクチャは、レイクハウスソリューションに次のような大きな利点をもたらします。
-
低コストのストレージ:ストレージとコンピュートのリソースを個別にスケールできるため、企業はコンピュートリソースを増やさずにストレージ容量を増やせます。また、クラウドのオブジェクトストレージを利用すれば、低いストレージコストと高い可用性を得ながら、比較的少量の頻繁に参照されるデータのキャッシュにはローカルの高速ディスクを引き続き使用できます。
-
信頼できる唯一のデータソース:すべてのデータを統一されたストレージ層に保存することで、異なるコンピュートクラスターから同じデータにアクセスして処理できます。これにより、データの一貫性と完全性を確保し、データ同期や重複保存の複雑さを軽減できます。
-
多様なワークロード:バッチ処理、リアルタイム分析、機械学習などのさまざまな用途をサポートするため、ユーザーはワークロードごとのニーズに応じてコンピュートリソースを動的に割り当てられます。ストレージとコンピュートを分離することで、企業はリソース使用をより柔軟に最適化し、異なる負荷の下でも効率的に運用できます。
また、ストレージとコンピュートを結合したアーキテクチャでも、エラスティックコンピュートノードを使用して、レイクハウスのデータクエリに伸縮性のあるコンピュート能力を提供できます。
オープン性
Doris はオープンなレイクテーブル形式へのアクセスをサポートするだけでなく、Doris 自体に保存したデータにもオープンにアクセスできます。Doris はオープンなストレージ API を提供し、Arrow Flight SQL プロトコルに基づく高速なデータ接続を実装しています。Arrow Flight の速度上の利点と JDBC/ODBC の使いやすさを兼ね備えています。このインターフェースを使用すると、Python/Java/Spark/Flink の ABDC クライアントから Doris に保存されたデータへアクセスできます。
オープンなファイル形式と比較して、オープンなストレージ API は基盤となるファイル形式の具体的な実装を抽象化します。そのため、Doris は豊富なインデックス機構など、ストレージ形式の高度な機能を使ってデータアクセスを高速化できます。さらに、上位のコンピュートエンジンは基盤となるストレージ形式の変更や新機能に個別に対応する必要がなく、サポートされるすべてのコンピュートエンジンが新機能の恩恵を同時に受けられます。
レイクハウスのベストプラクティス
レイクハウスソリューションでは、Doris は主にレイクハウスクエリの高速化、複数データソースのフェデレーション分析、レイクハウスのデータ処理に使用されます。
レイクハウスクエリの高速化
このシナリオでは、Doris はコンピュートエンジンとして機能し、レイクハウスのデータに対するクエリ分析を高速化します。
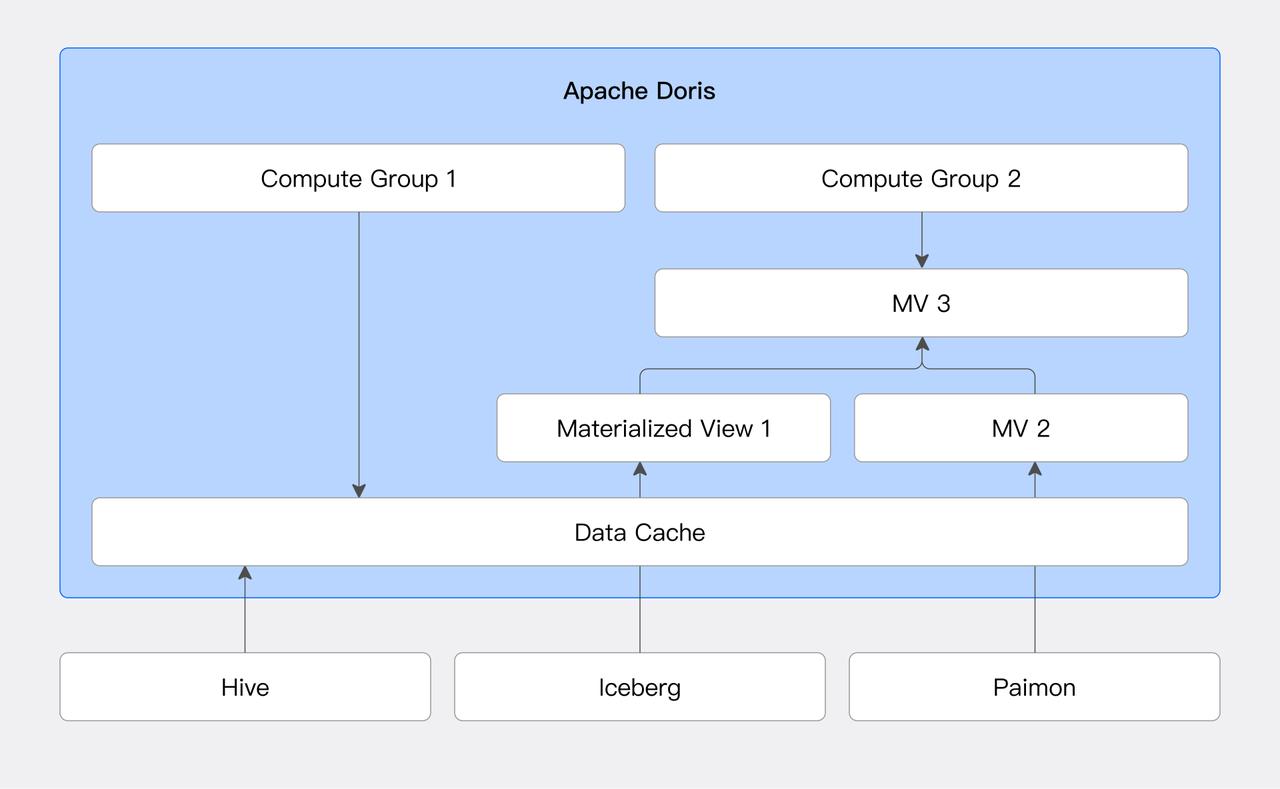
キャッシュによる高速化
Hive や Iceberg などのレイクハウスシステムでは、ローカルディスクキャッシュを設定できます。ローカルディスクキャッシュは、クエリで使用するデータファイルをローカルのキャッシュディレクトリへ自動的に保存し、LRU 戦略でキャッシュからの削除を管理します。詳しくは、データキャッシュのドキュメントを参照してください。
マテリアライズドビューと透過的な書き換え
Doris は、外部データソースに対するマテリアライズドビューの作成をサポートします。マテリアライズドビューは、SQL 定義文に基づいて事前計算した結果を Doris の内部テーブル形式で保存します。また、Doris のクエリオプティマイザは、SPJG(SELECT-PROJECT-JOIN-GROUP-BY)パターンに基づく透過的な書き換えアルゴリズムをサポートします。このアルゴリズムは SQL の構造を分析し、透過的な書き換えに適したマテリアライズドビューを自動的に見つけ、クエリ SQL への応答に最適なマテリアライズドビューを選択します。
この機能は、実行時の計算を減らしてクエリ性能を大幅に向上させます。また、アプリケーション側が意識することなく、透過的な書き換えを通じてマテリアライズドビューのデータへアクセスできます。詳しくは、マテリアライズドビューのドキュメントを参照してください。
複数データソースのフェデレーション分析
Doris は統一された SQL クエリエンジンとして、異なるデータソースを接続してフェデレーション分析を実行し、データサイロを解消できます。
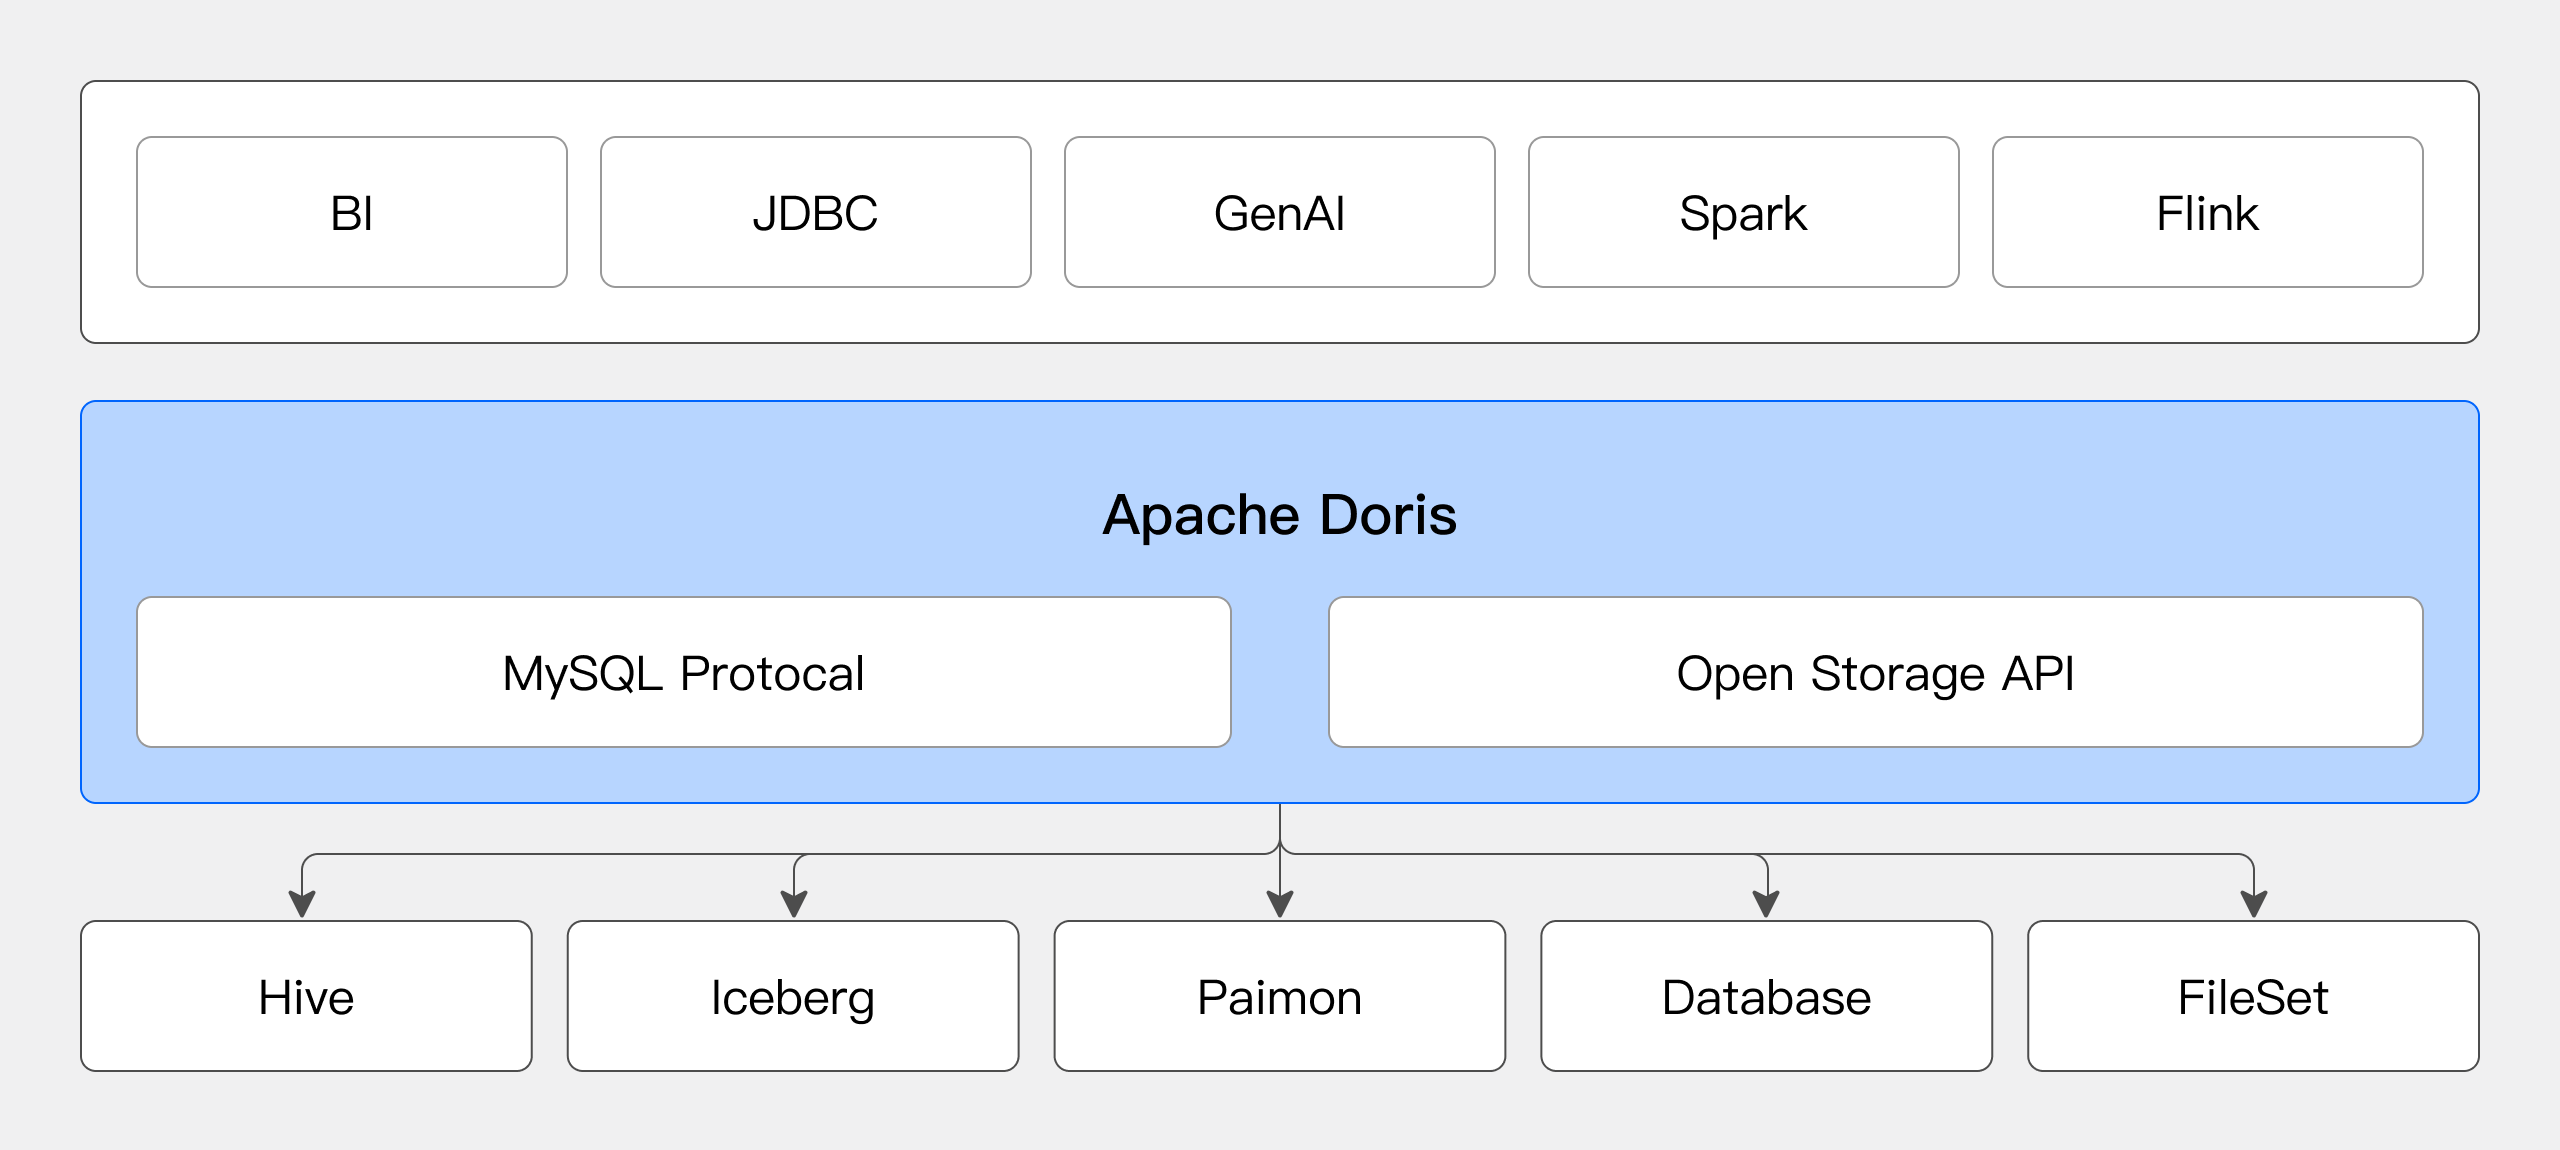
ユーザーは Doris で複数の Catalog を動的に作成して、異なるデータソースへ接続できます。SQL 文を使用し、異なるデータソースのデータに対して任意の結合クエリを実行できます。詳しくは、Catalog の概要を参照してください。
レイクハウスのデータ処理
このシナリオでは、Doris はデータ処理エンジンとして機能し、レイクハウスのデータを処理します。
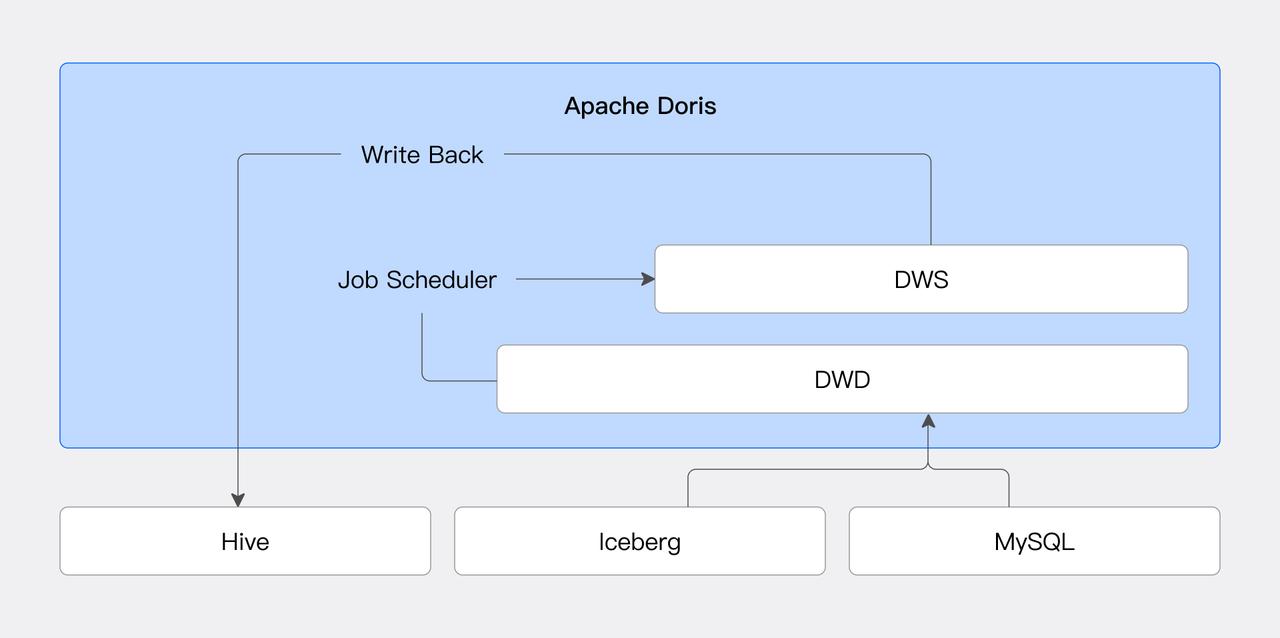
タスクスケジューリング
Doris は Job Scheduler 機能を導入し、効率的で柔軟なタスクスケジューリングを可能にするとともに、外部システムへの依存を減らします。データソースコネクターと組み合わせることで、外部データの定期的な処理と保存を実現できます。詳しくは、Job Schedulerを参照してください。
データモデリング
ユーザーは通常、データレイクに生データを保存し、そのデータを基に階層的な処理を行って、各階層のデータを異なる業務上のニーズに利用します。Doris のマテリアライズドビュー機能では、外部データソースに対するマテリアライズドビューを作成し、そのビューを基にさらに処理できます。これにより、システムの複雑さを軽減し、データ処理効率を高められます。
データの書き戻し
データの書き戻し機能によって、Doris のレイクハウスデータ処理機能は一連の処理を完結できます。ユーザーは Doris から外部データソースに直接データベースとテーブルを作成し、データを書き込めます。現在は JDBC、Hive、Iceberg のデータソースをサポートしており、今後さらに対応するデータソースを追加する予定です。詳しくは、対応するデータソースのドキュメントを参照してください。