に最終更新
ログとトレースの検索
Discover ページでは、高速なログ分析に最適化された、Kibana Discover のような検索と分析ができます。
主な機能は次のとおりです。
- SQL と Lucene の両方のクエリ構文に対応
- ログから関連するトレースへワンクリックで移動
- 時間範囲やフィルターなどを対話的に選択
- テーブル形式と JSON 形式の両方で結果を表示
- 指定したレコードの前後にあるデータを表示してコンテキストを分析
- フィールド値の分布を集計(出現頻度の高い上位 5 件とその割合)
Discover ページの概要
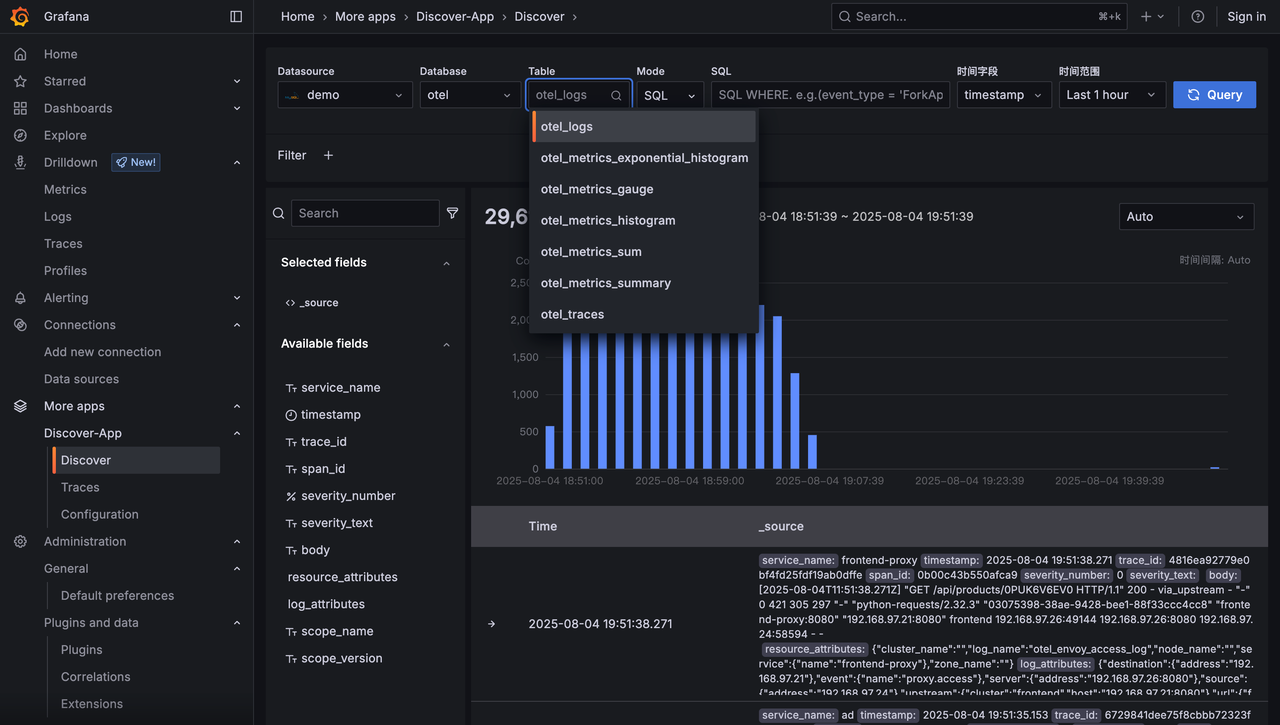
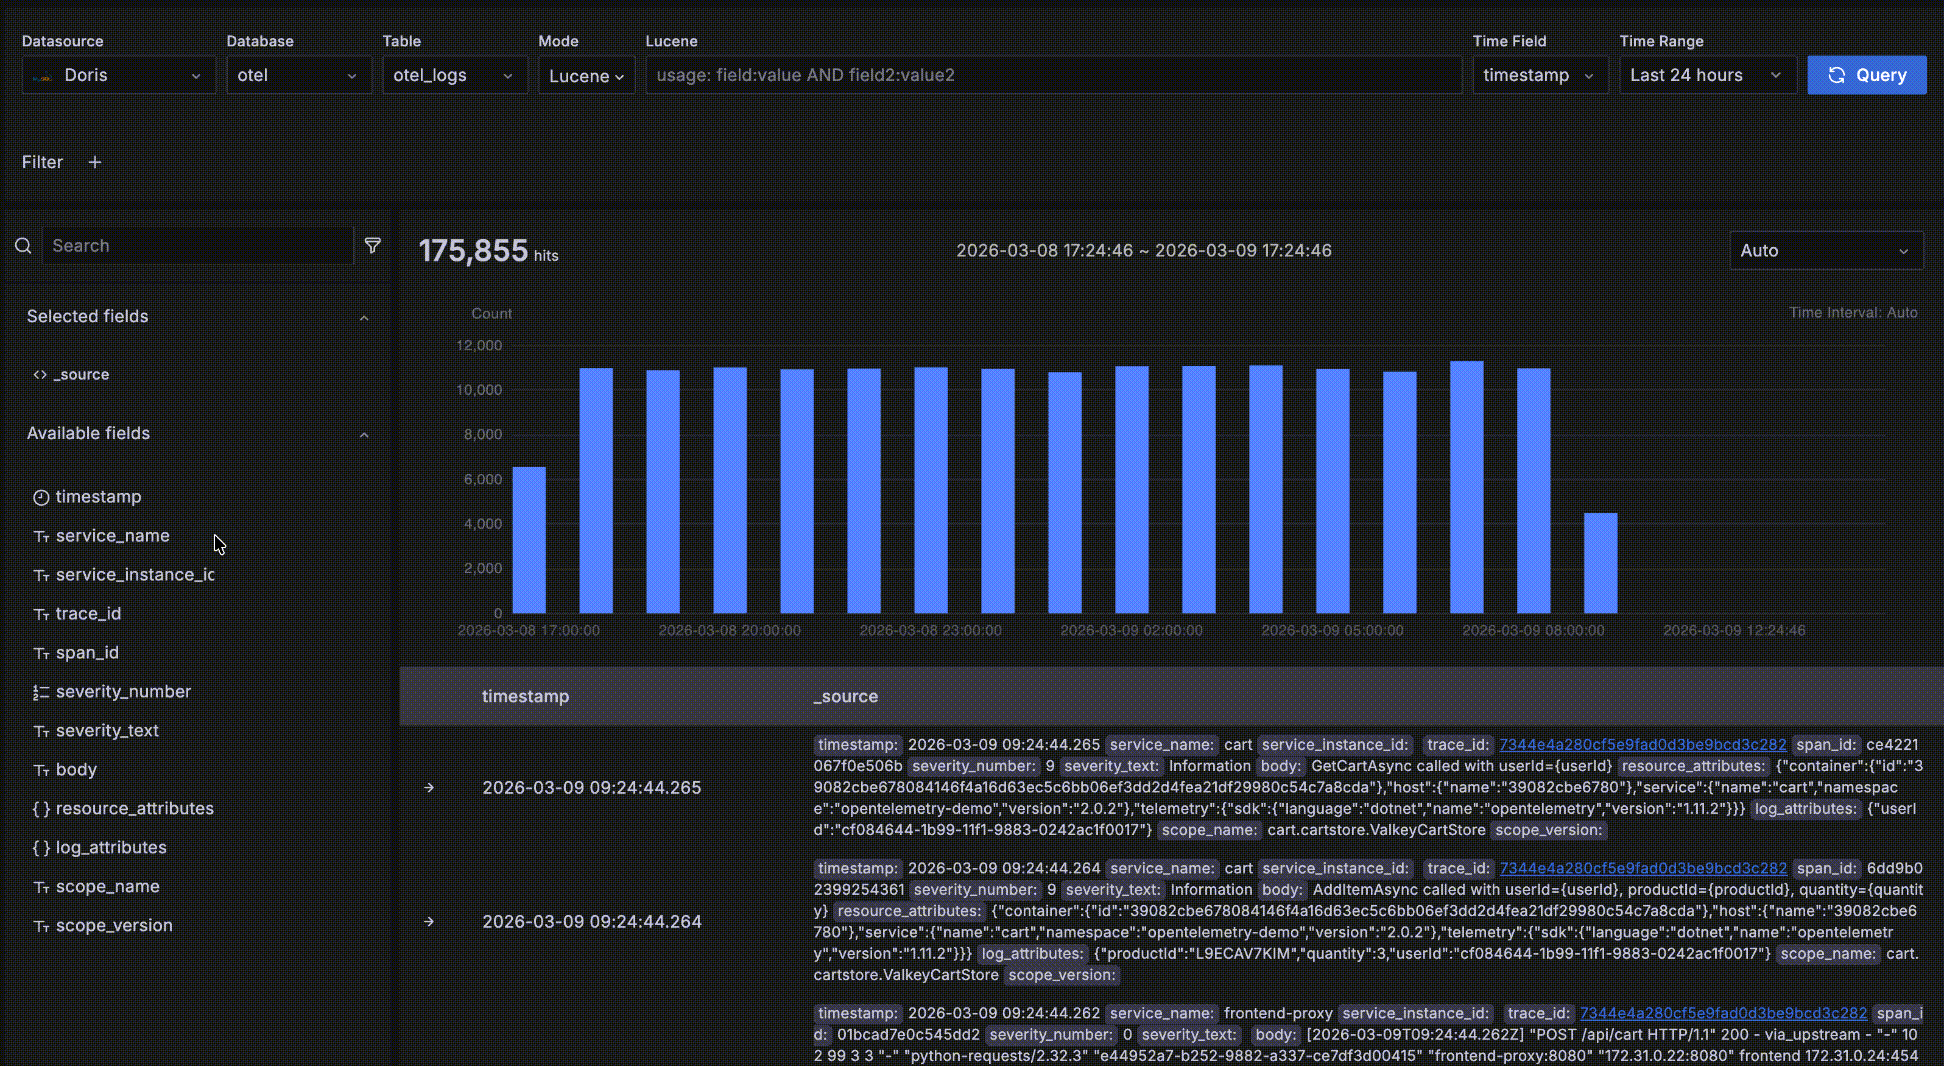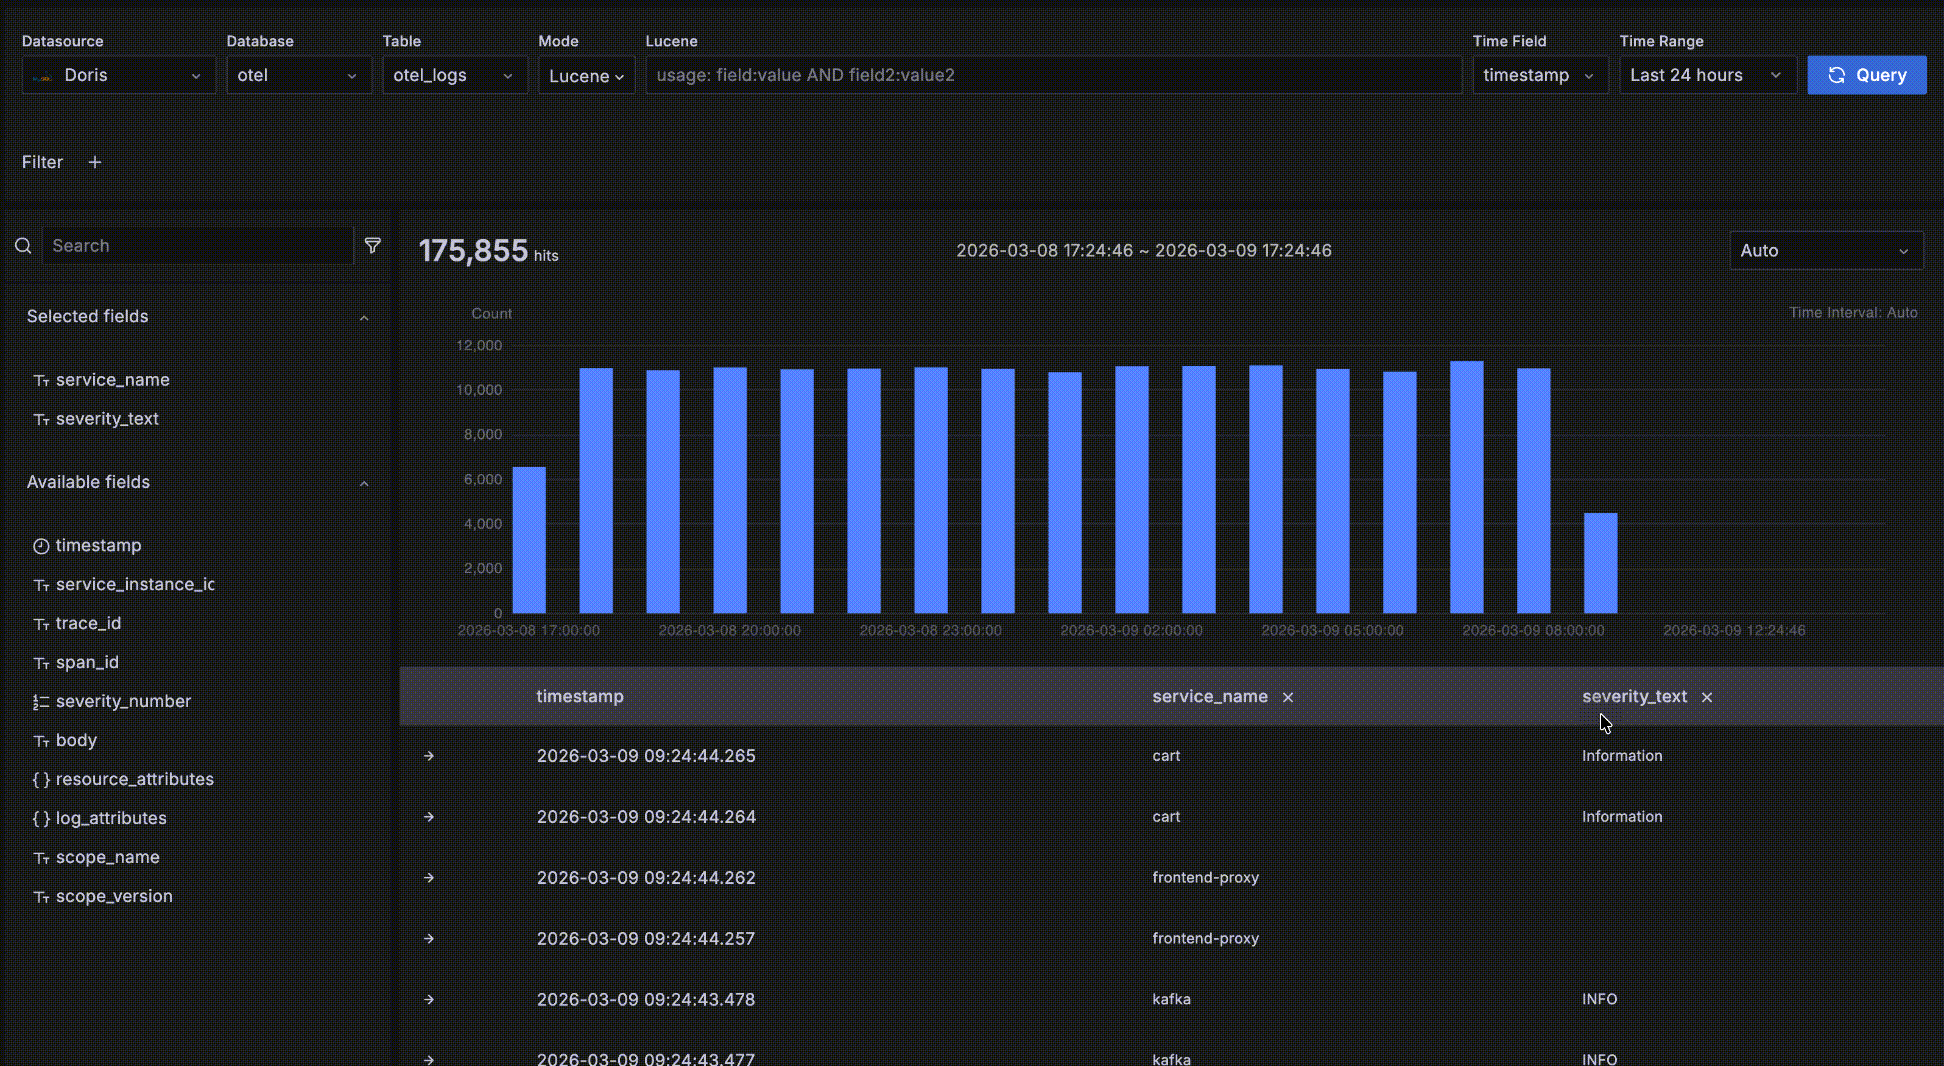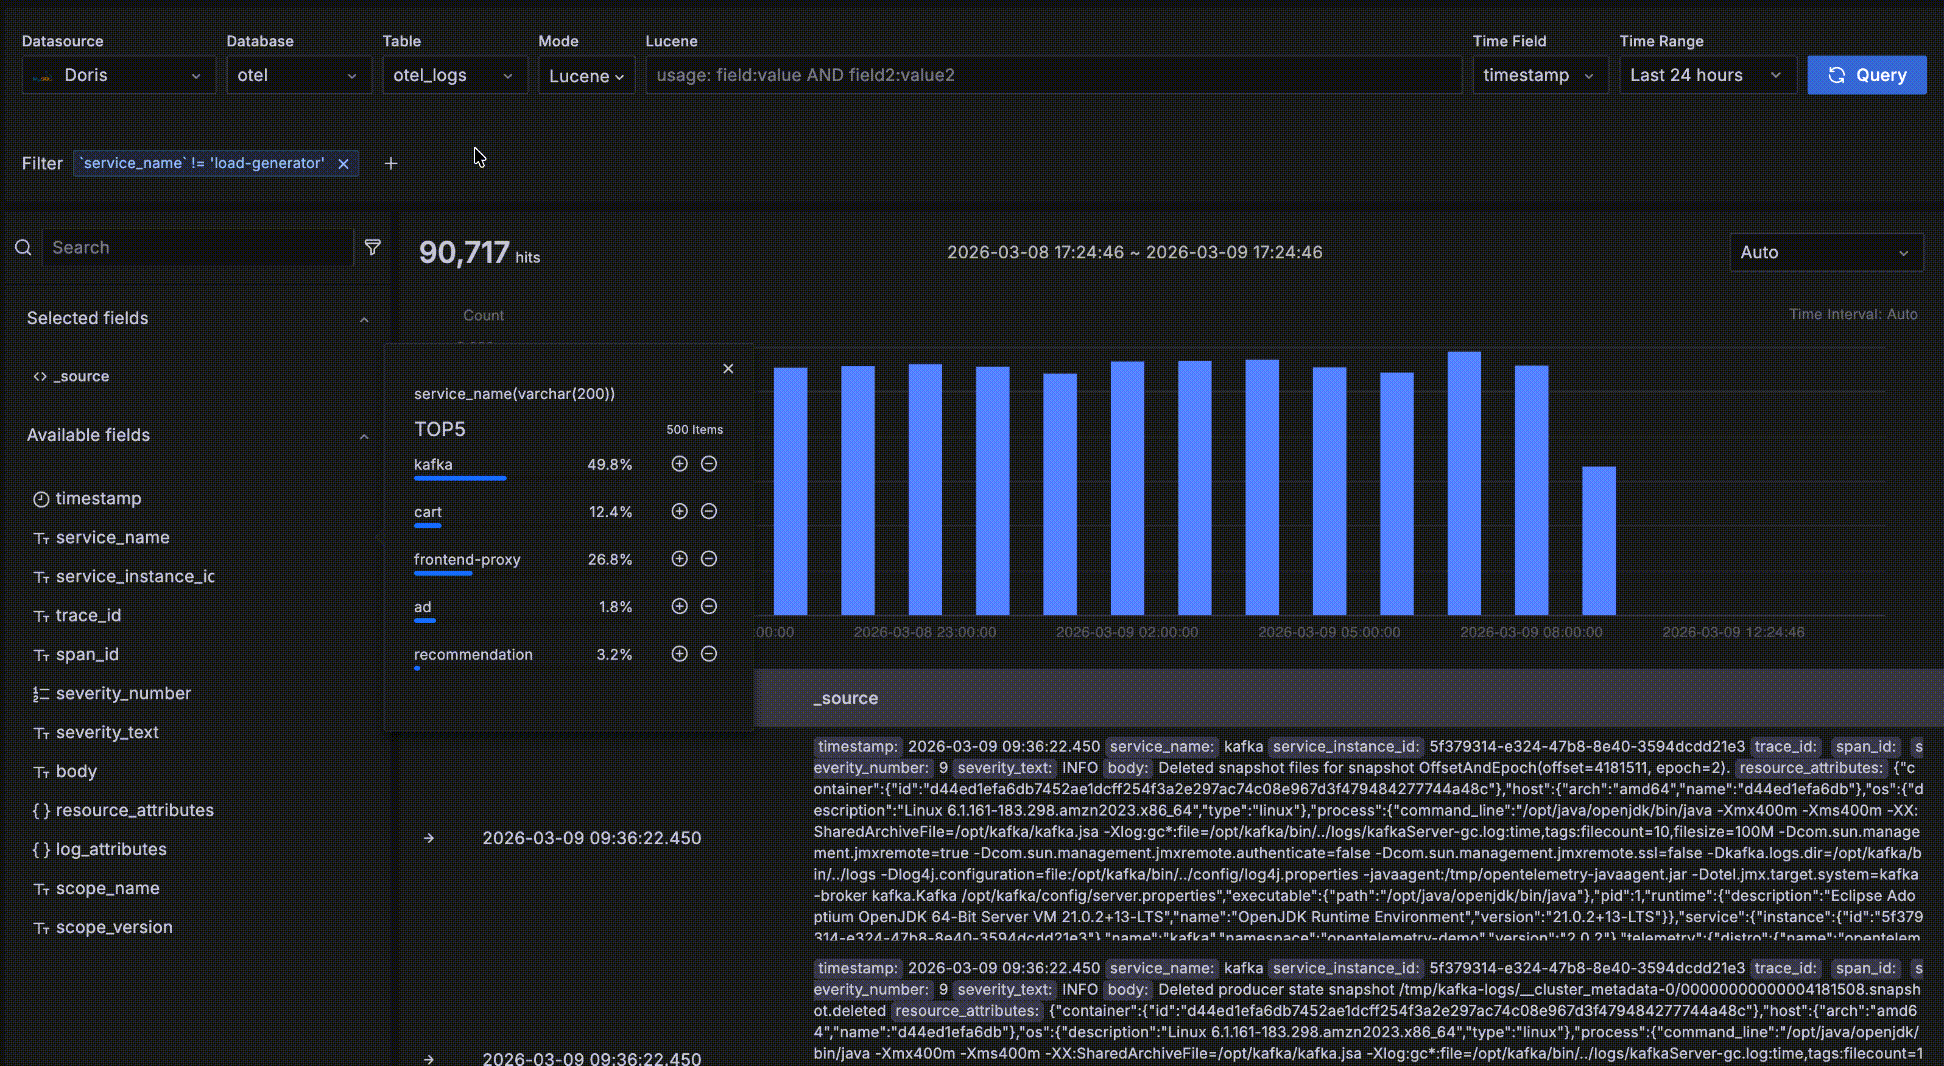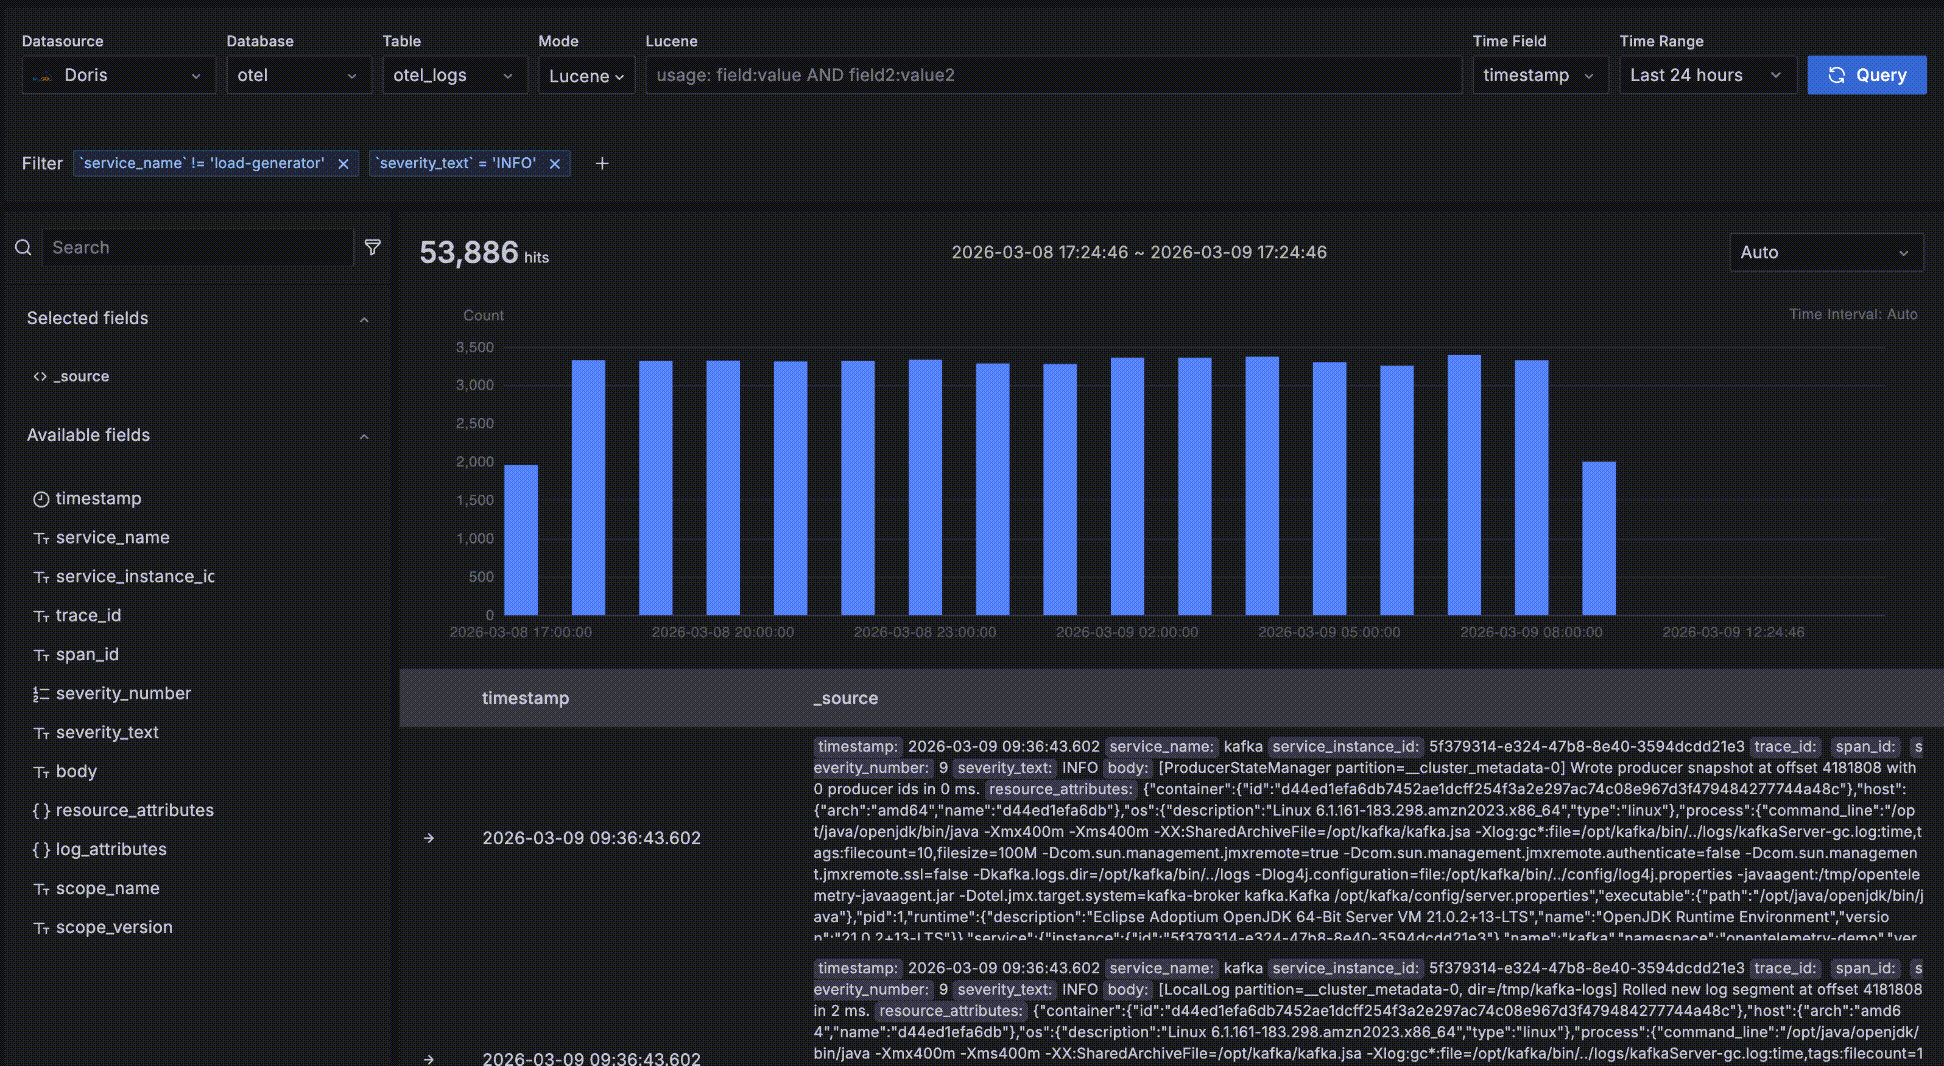
Discover ページは、次の四つの主要な領域で構成されます。
1. クエリ入力領域(上部)
クエリの対象範囲と検索条件を設定します。次の操作ができます。
- データソースの選択
- 時間フィールドと時間範囲の選択
- SQL または Lucene 構文による検索条件の入力
2. 時間傾向領域(中央)
クエリ結果の時間ごとの分布を示すヒストグラムです。次の操作ができます。
- 一致するデータの時間的な傾向をすばやく確認
- 時間帯をドラッグして選択し、クエリの時間範囲を変更
3. 詳細データ領域(下部)
クエリ結果のレコードを表示し、その前後のデータも調べられます。次の操作ができます。
- 一致する最新のレコードを表示し、
trace_idがある場合はクリックしてトレースの詳細を表示 - 個々のログを展開し、すべてのフィールドをテーブル形式または JSON 形式で表示
- テーブル形式の表示からフィルター条件を対話的に作成
- レコードの前後にあるデータを表示
4. フィールドブラウザー領域(左側)
現在のテーブルのすべてのフィールドを表示し、フィールド単位で調べられます。
次の操作ができます。
- 右側に表示するフィールドを選択。デフォルトでは、すべてのフィールドを連結した
_sourceを表示 - フィールドにカーソルを合わせ、出現頻度の高い上位 5 件の値とその割合を確認
- 値の横にある「+」または「-」をクリックしてフィルター条件を対話的に作成。条件は上部のクエリバーに同期
クエリ入力
クエリ入力領域では、ドロップダウンメニューからデータソース、データベース、テーブル、時間フィールド、時間範囲を選択します。データソース、データベース、テーブルのデフォルト値は設定ページで変更できます。時間フィールドのデフォルト値は、テーブル内で最初の DATETIME または DATE 列です。
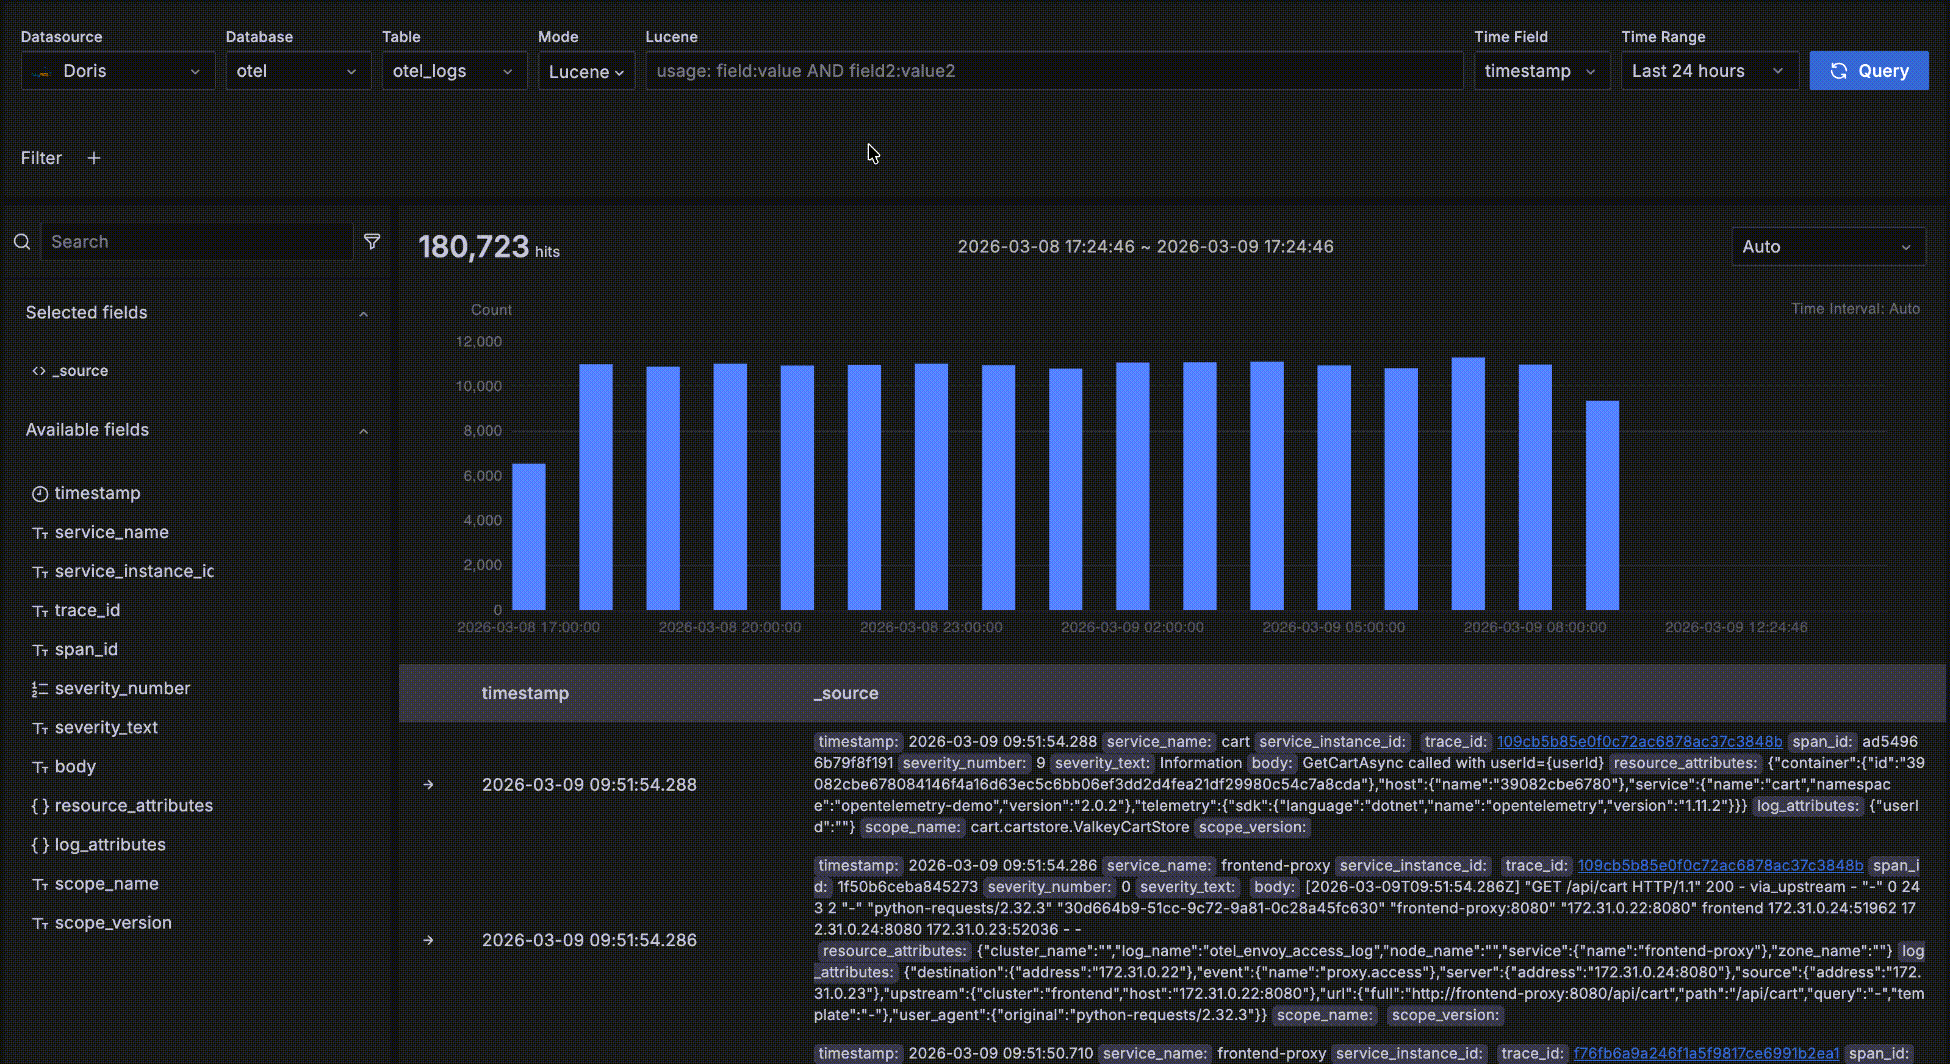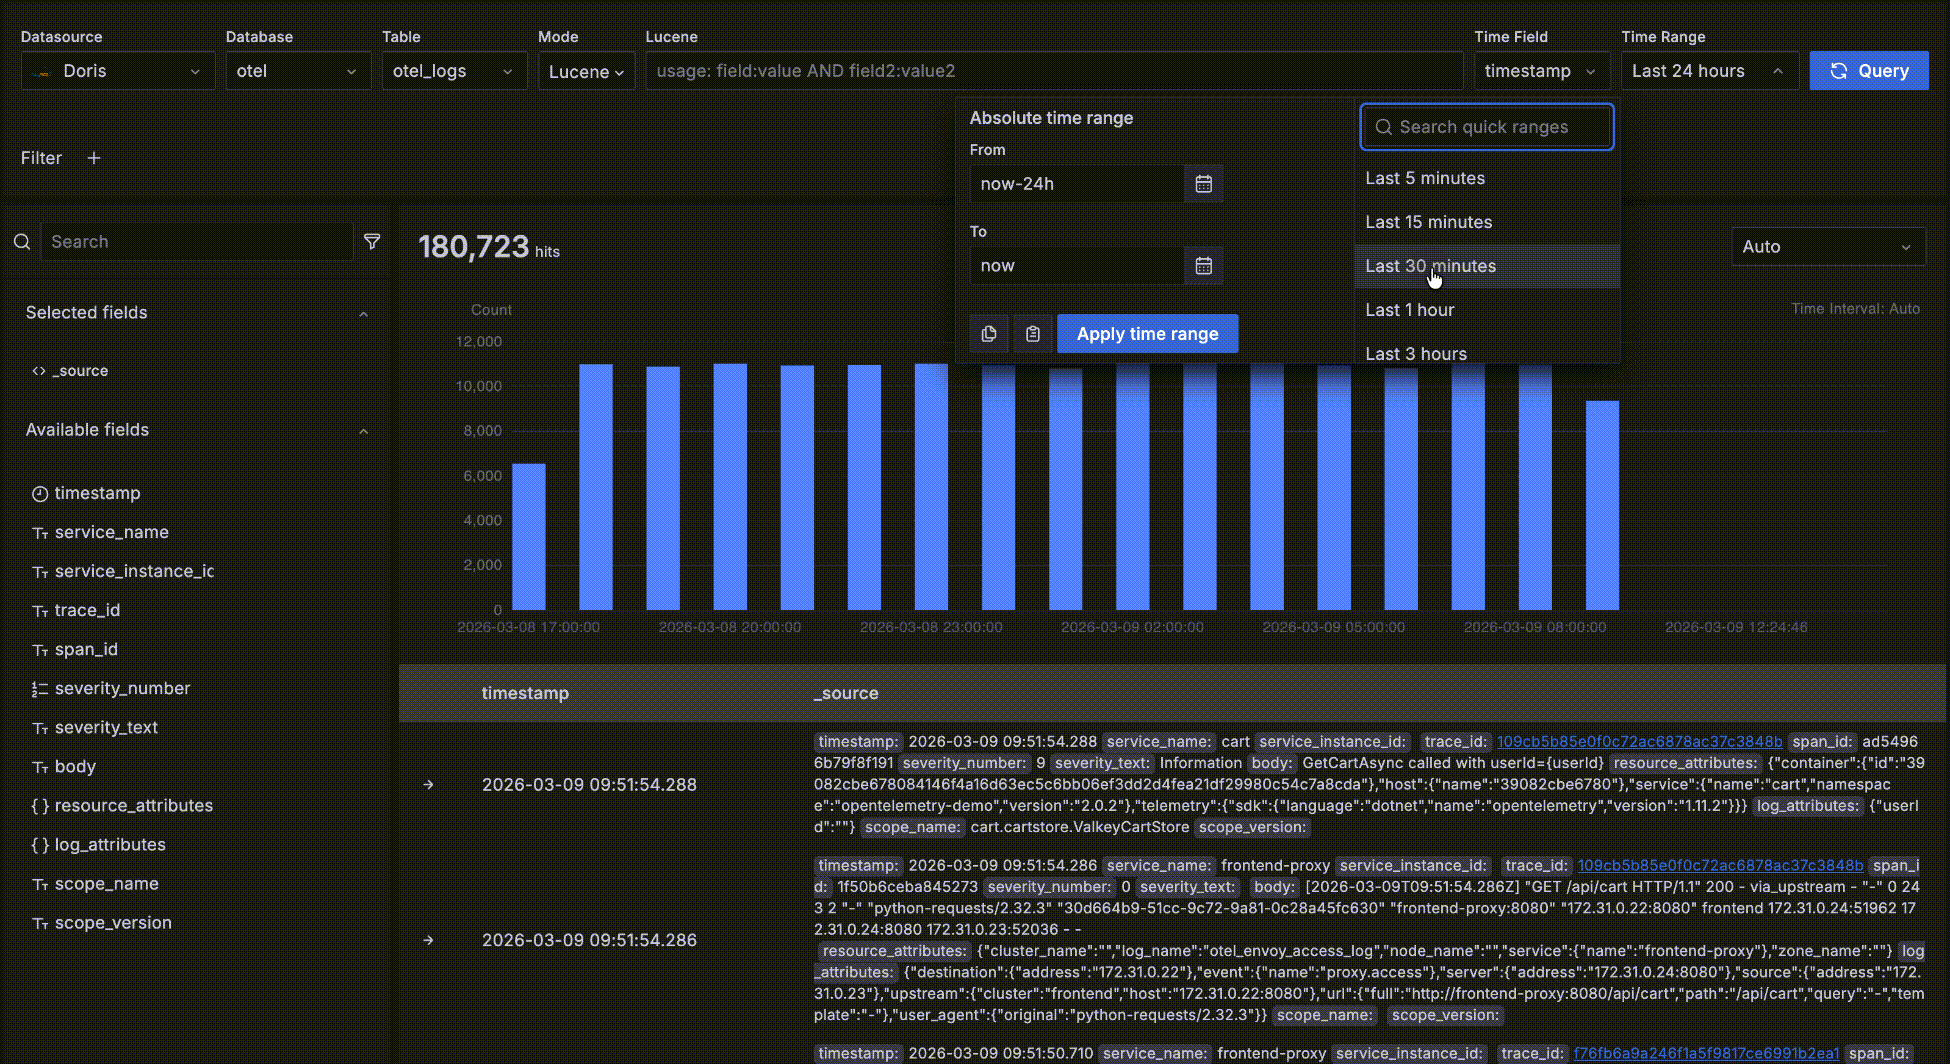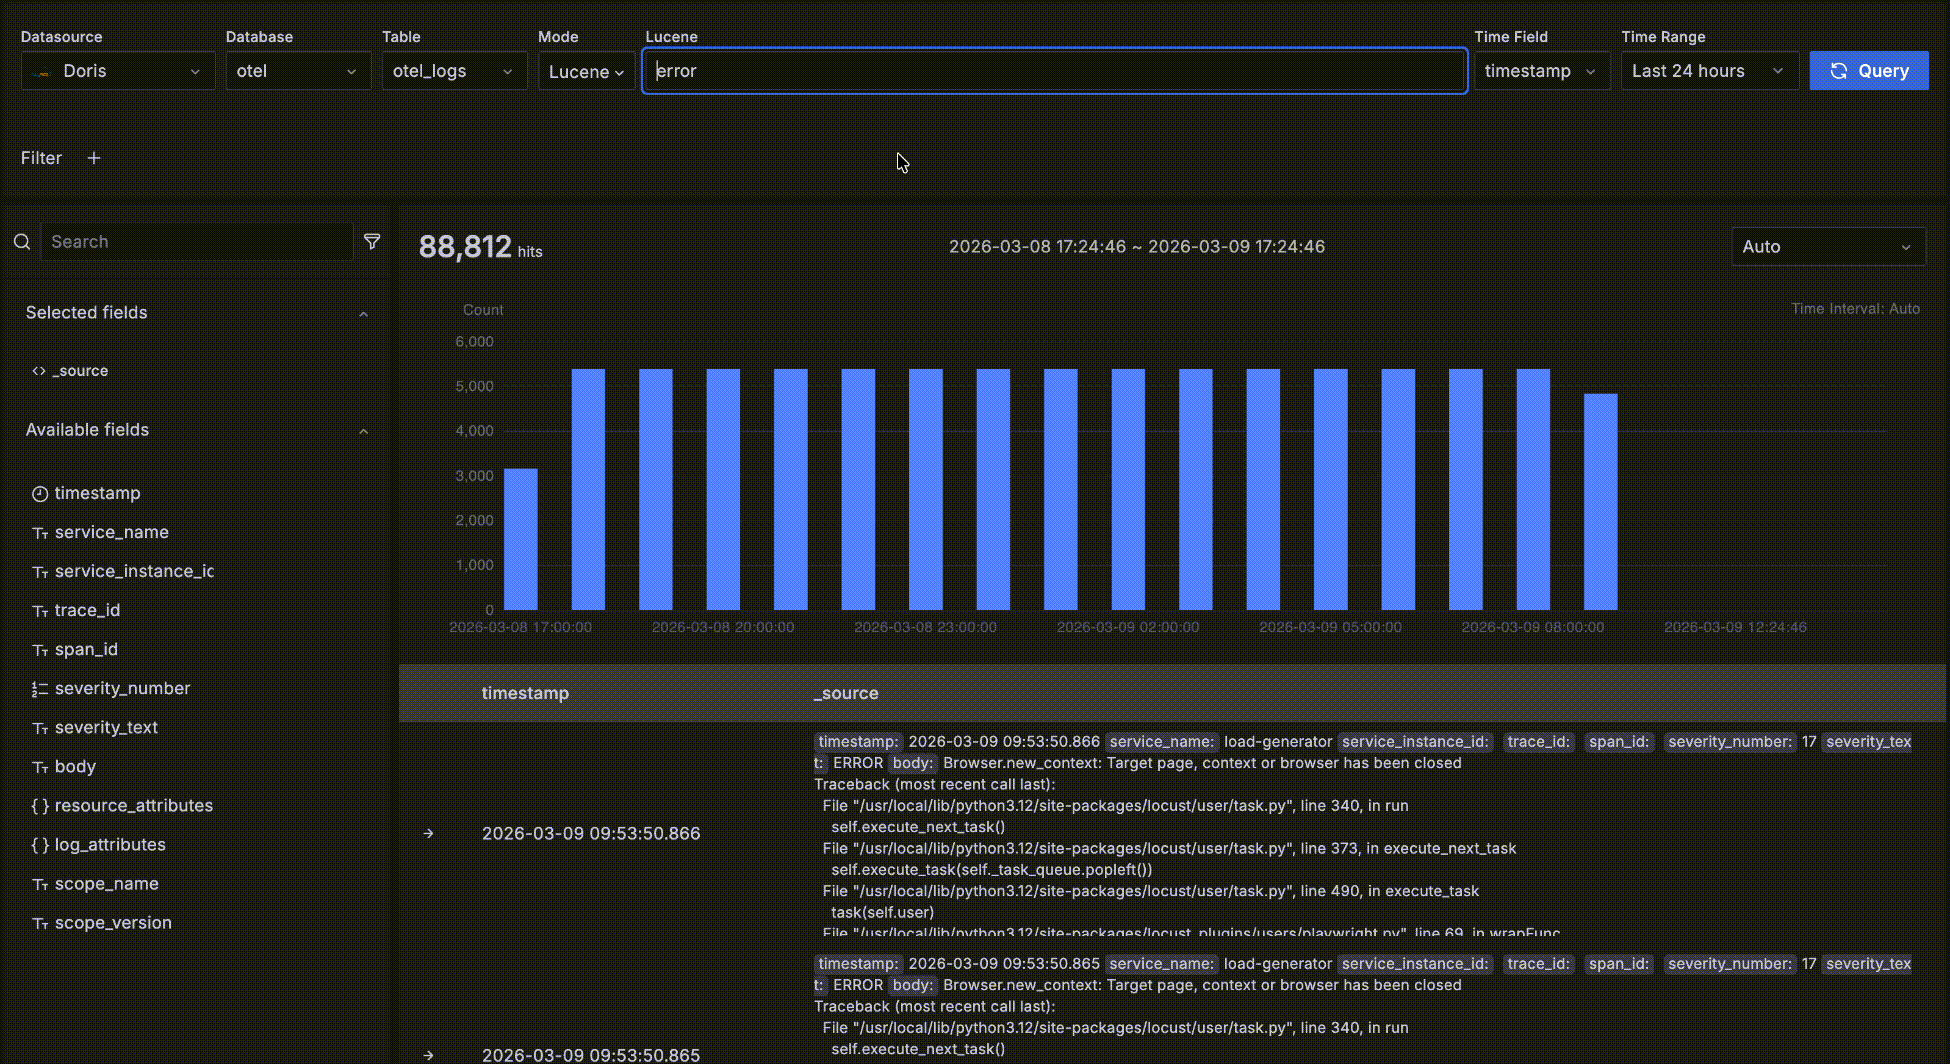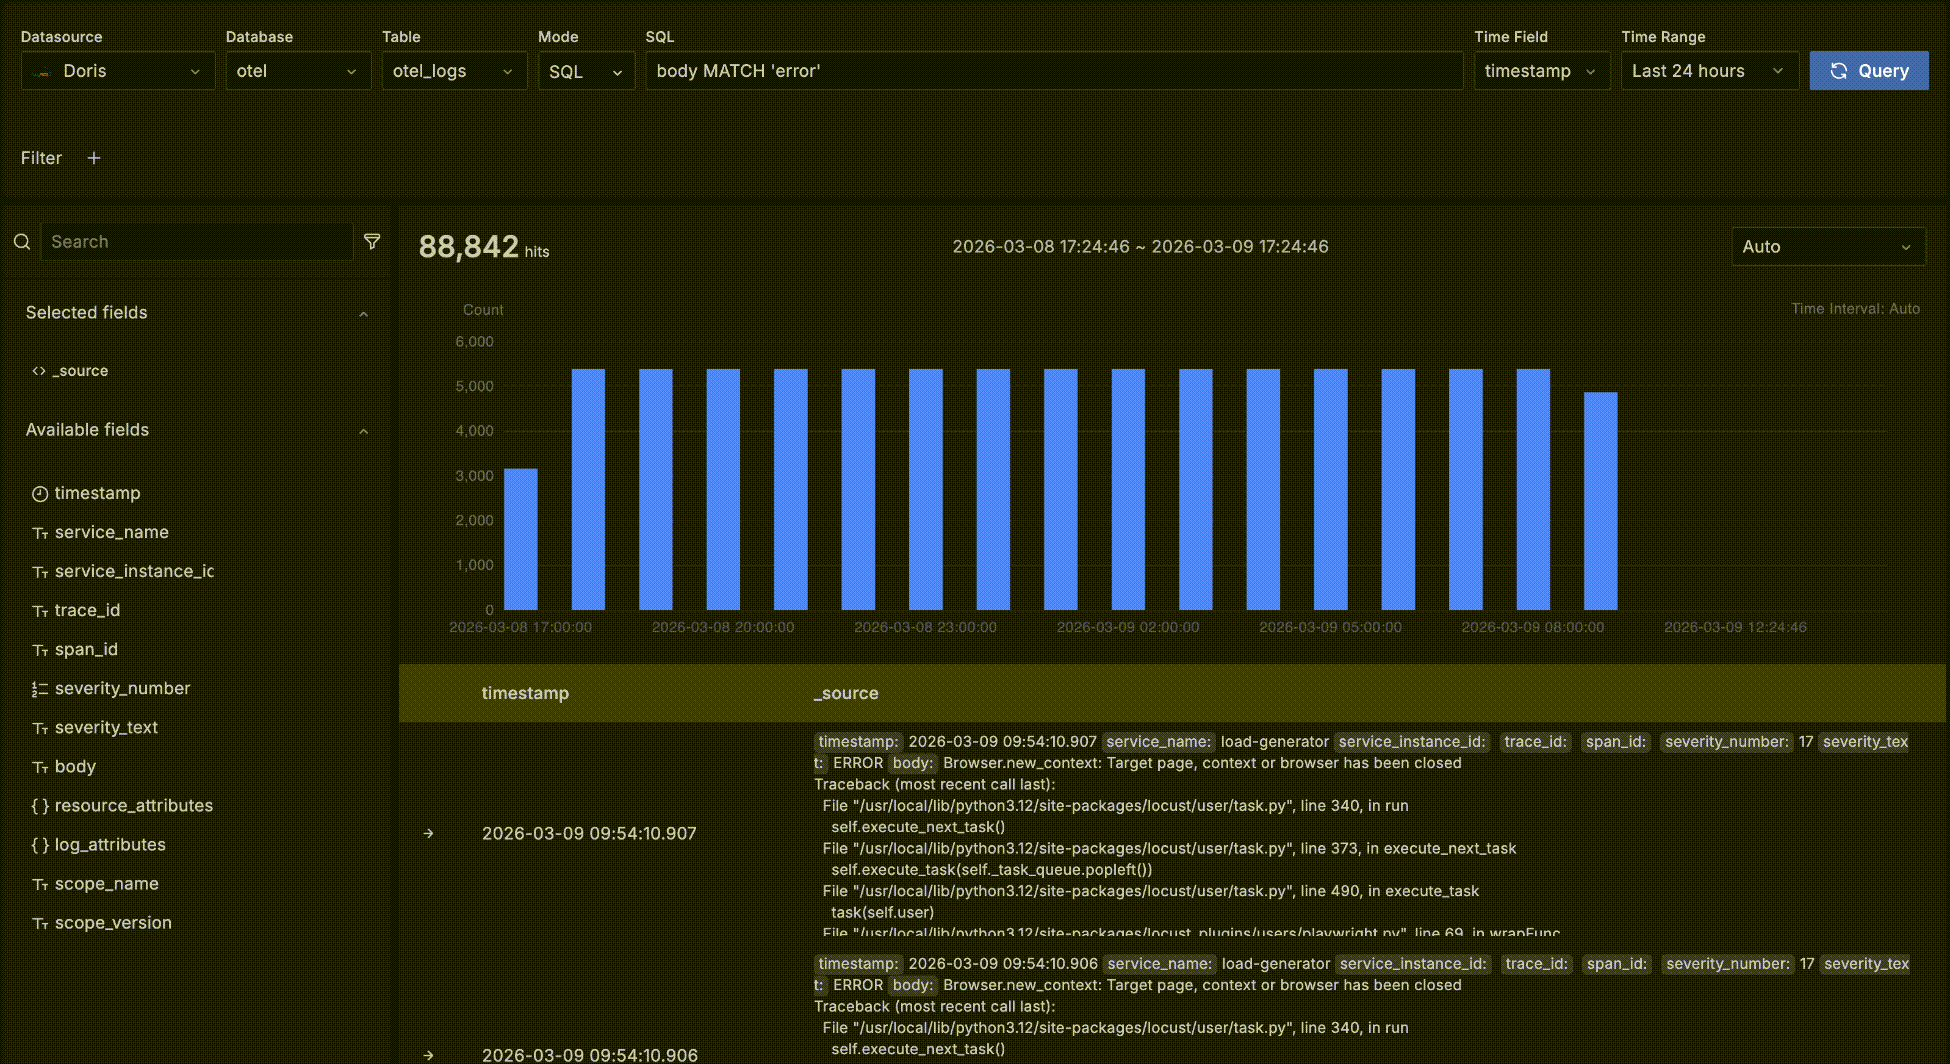
検索入力欄は SQL と Lucene の両方の構文に対応しています。Lucene 構文は内部で SQL の WHERE 条件に変換されます。対応する Lucene 構文と Kibana、SQL の対応関係を以下に示します。
| 機能 | Doris App の Lucene 構文 | Kibana | SQL WHERE | 備考 |
|---|---|---|---|---|
| 単一フィールドのキーワード一致 | service_name:kafka | 同じ | service_name MATCH 'kafka' | 指定フィールドでの一致。service_name MATCH_ANY 'kafka' に書き換えられる |
| 複数フィールドのキーワード一致 | error | 同じ | (service_name MATCH 'error') OR (scope_name MATCH 'error') | 転置インデックスがあるすべてのフィールドで全文一致を検索。複数フィールドの MATCH_ANY に自動で書き換えられる |
| 単一フィールドのフレーズ一致 | service_name:"kafka logs" | 同じ | service_name MATCH_PHRASE 'kafka logs' | フィールド単位のフレーズ一致 |
| 複数フィールドのフレーズ一致 | "kafka logs" | 同じ | service_name MATCH_PHRASE 'kafka logs') | 完全なフレーズ一致。MATCH_PHRASE に書き換えられる |
| ワイルドカード | kaf* | 同じ | ((service_name MATCH_PHRASE_PREFIX 'kaf') OR (scope_name MATCH_PHRASE_PREFIX 'kaf')) | 前方一致/後方一致のワイルドカード。MATCH_PHRASE_PREFIX に書き換えられる |
| 数値/時間の範囲 | duration:[100 TO 500] | 同じ | duration BETWEEN 100 AND 500 | SQL の BETWEEN に変換される |
| 上限または下限のない範囲 | duration:>500 | 同じ | duration > '500' | SQL の比較条件に変換される |
| 開区間/閉区間 | {100 TO 200} | 同じ | 波括弧は開区間を表す | |
| AND の組み合わせ | service_name:kafka AND status:failed | 同じ | (service_name MATCH 'kafka') AND (status MATCH 'failed') | 論理 AND |
| OR の組み合わせ | error OR warning | 同じ | 論理 OR | |
| NOT の組み合わせ | NOT kafka or -kafka | 同じ | NOT (service_name MATCH 'kafka') | 論理 NOT |
| グループ化 | (service_name:kafka OR service_name:zookeeper) AND status:failed | 同じ | ((service_name MATCH 'kafka') OR (service_name MATCH 'zookeeper')) AND (status MATCH 'failed') | 複雑な論理条件の組み合わせに対応 |
Lucene 構文の要点は次のとおりです。
- 基本形は
field_name:match_conditionです。 field_name:を指定すると、単一のフィールドをmatch_conditionと照合します。field_name:を指定しない場合、いずれかのフィールドがmatch_conditionに一致すれば、一致とみなされます(フィールド間の OR 条件)。- テキスト値に対する
match_conditionには、次の三つの形式があります。- 二重引用符で囲むとフレーズ一致になり、引用符内のすべての単語が同じ順序で出現する必要があります。
- 引用符で囲まない場合はキーワード一致になり、いずれか一つの単語が一致すればよい条件です。
*はワイルドカードを表します。
- 数値と日付の値に対する
match_conditionには、次の三つの形式があります。- 単一の値は等価条件を表します。
>、<は SQL と同様に範囲を表します。- 括弧は区間を表し、角括弧は閉区間、波括弧は開区間です。
- SQL と同様に、複数の条件を AND / OR / NOT で組み合わせられます。丸括弧でグループ化の優先順位を調整できます。
SQL 構文の要点は次のとおりです。
MATCHとMATCH_ANYは Lucene のキーワード一致に対応し、いずれか一つのキーワードが一致すればよい条件です(OR 関係)。MATCH_ALLもキーワード一致ですが、すべてのキーワードが一致する必要があります(AND 関係)。MATCH_PHRASEは Lucene のフレーズ一致に対応し、すべての単語が同じ順序で出現する必要があります。- 等価条件と範囲条件には、標準の
=、>、<、BETWEENを使用します。 - 複数の条件を AND / OR / NOT で組み合わせ、丸括弧で優先順位を調整できます。
時間傾向データ
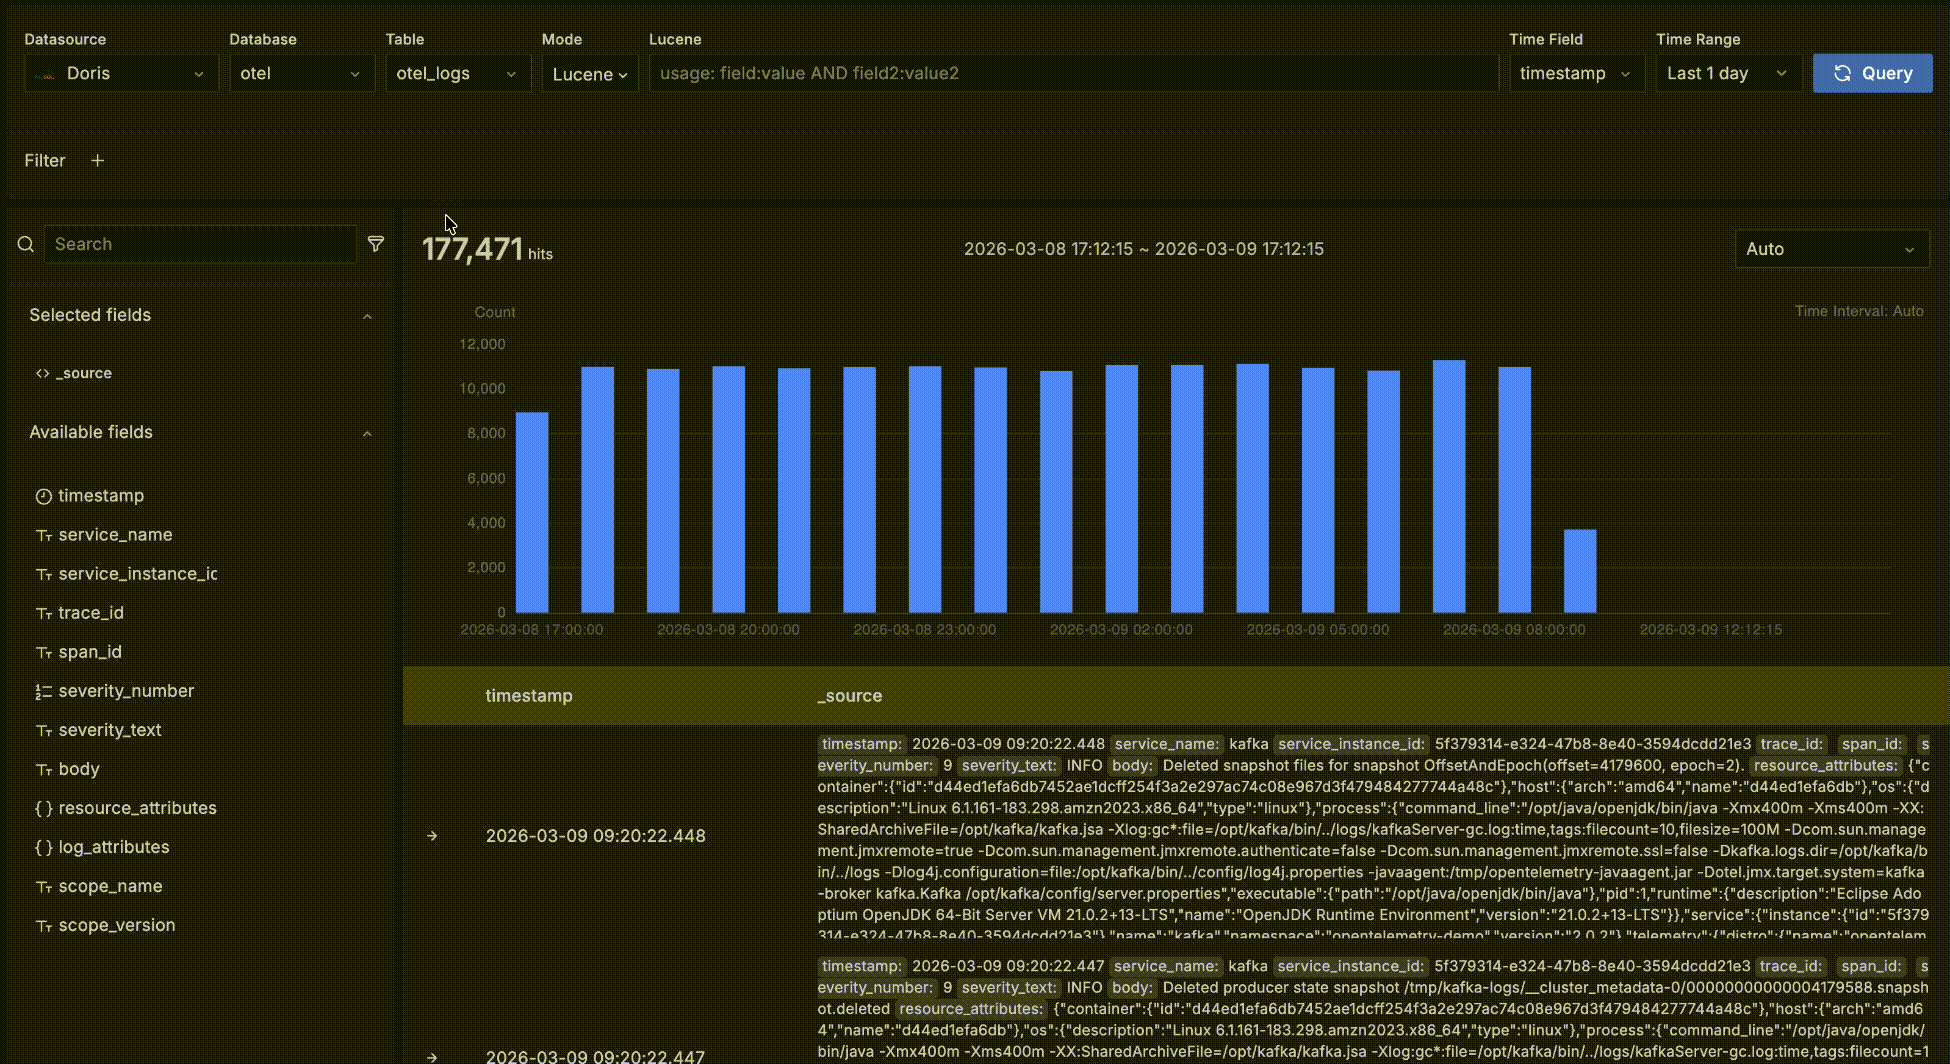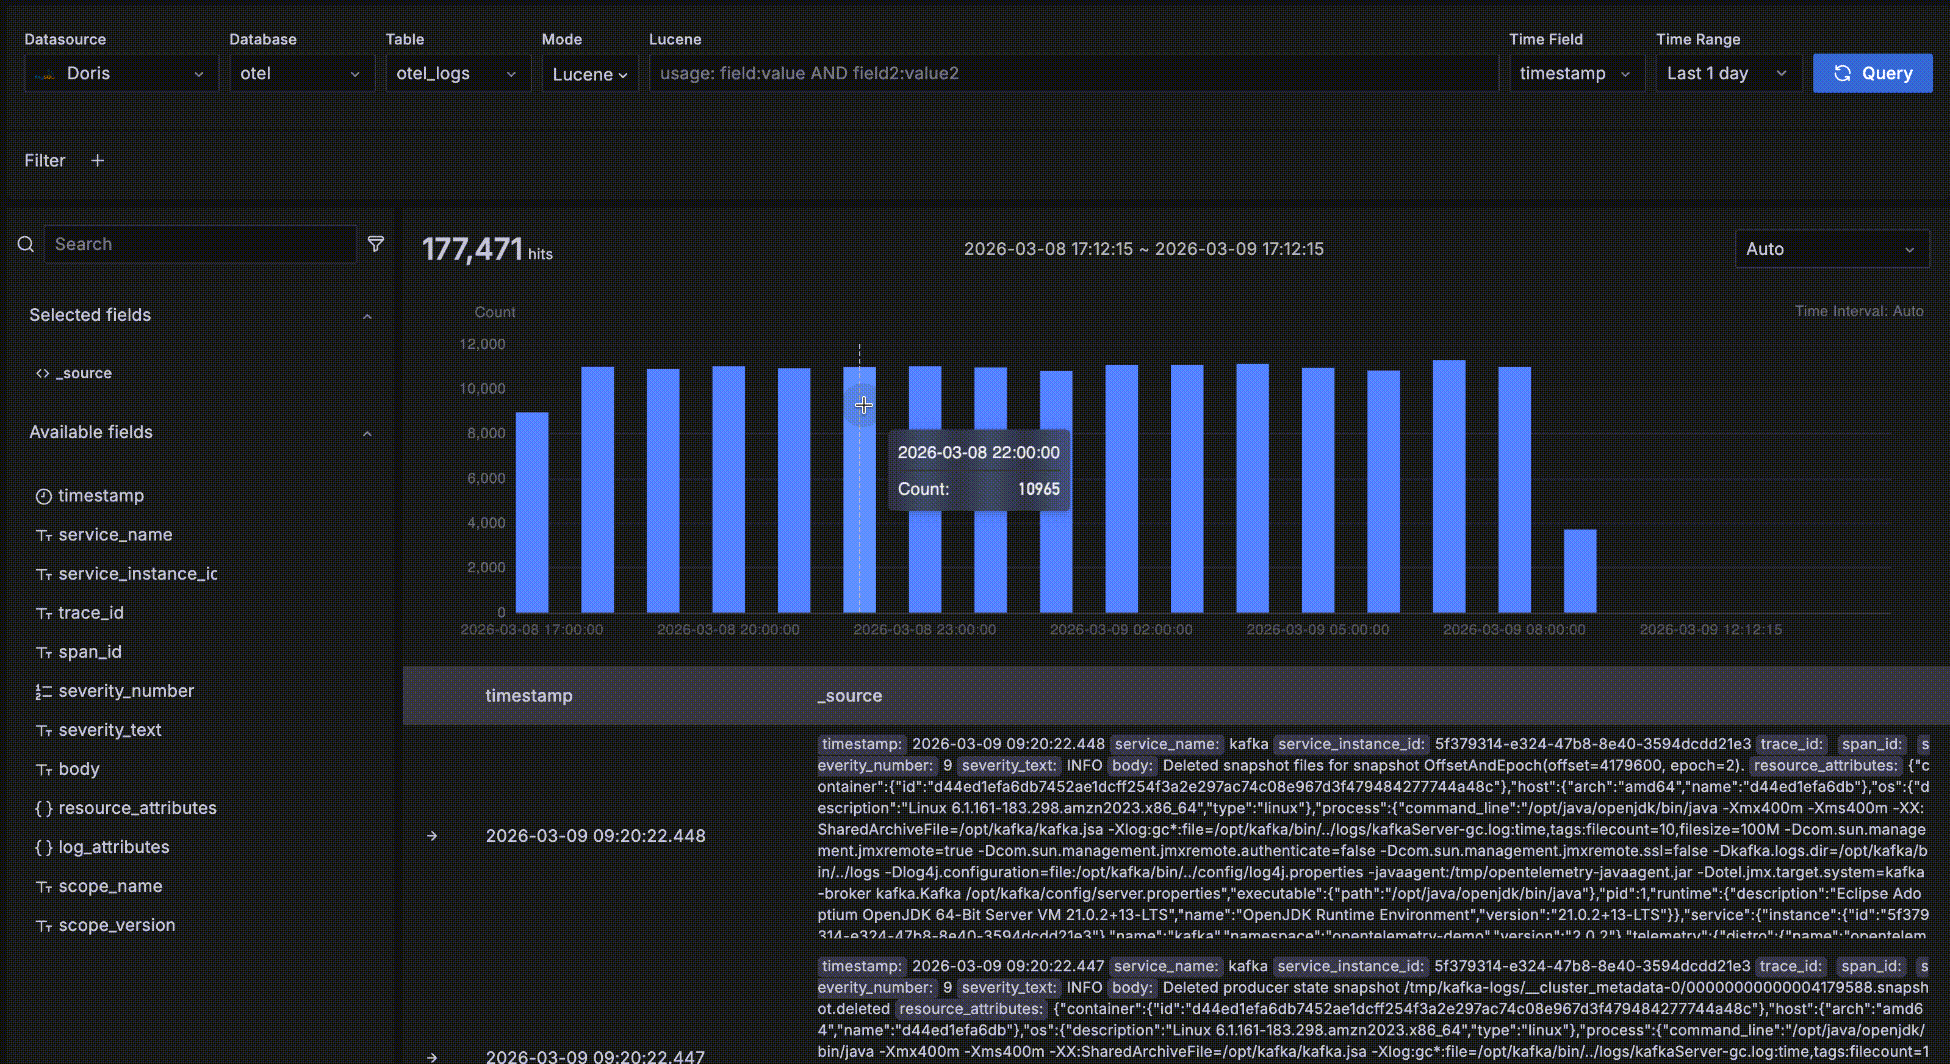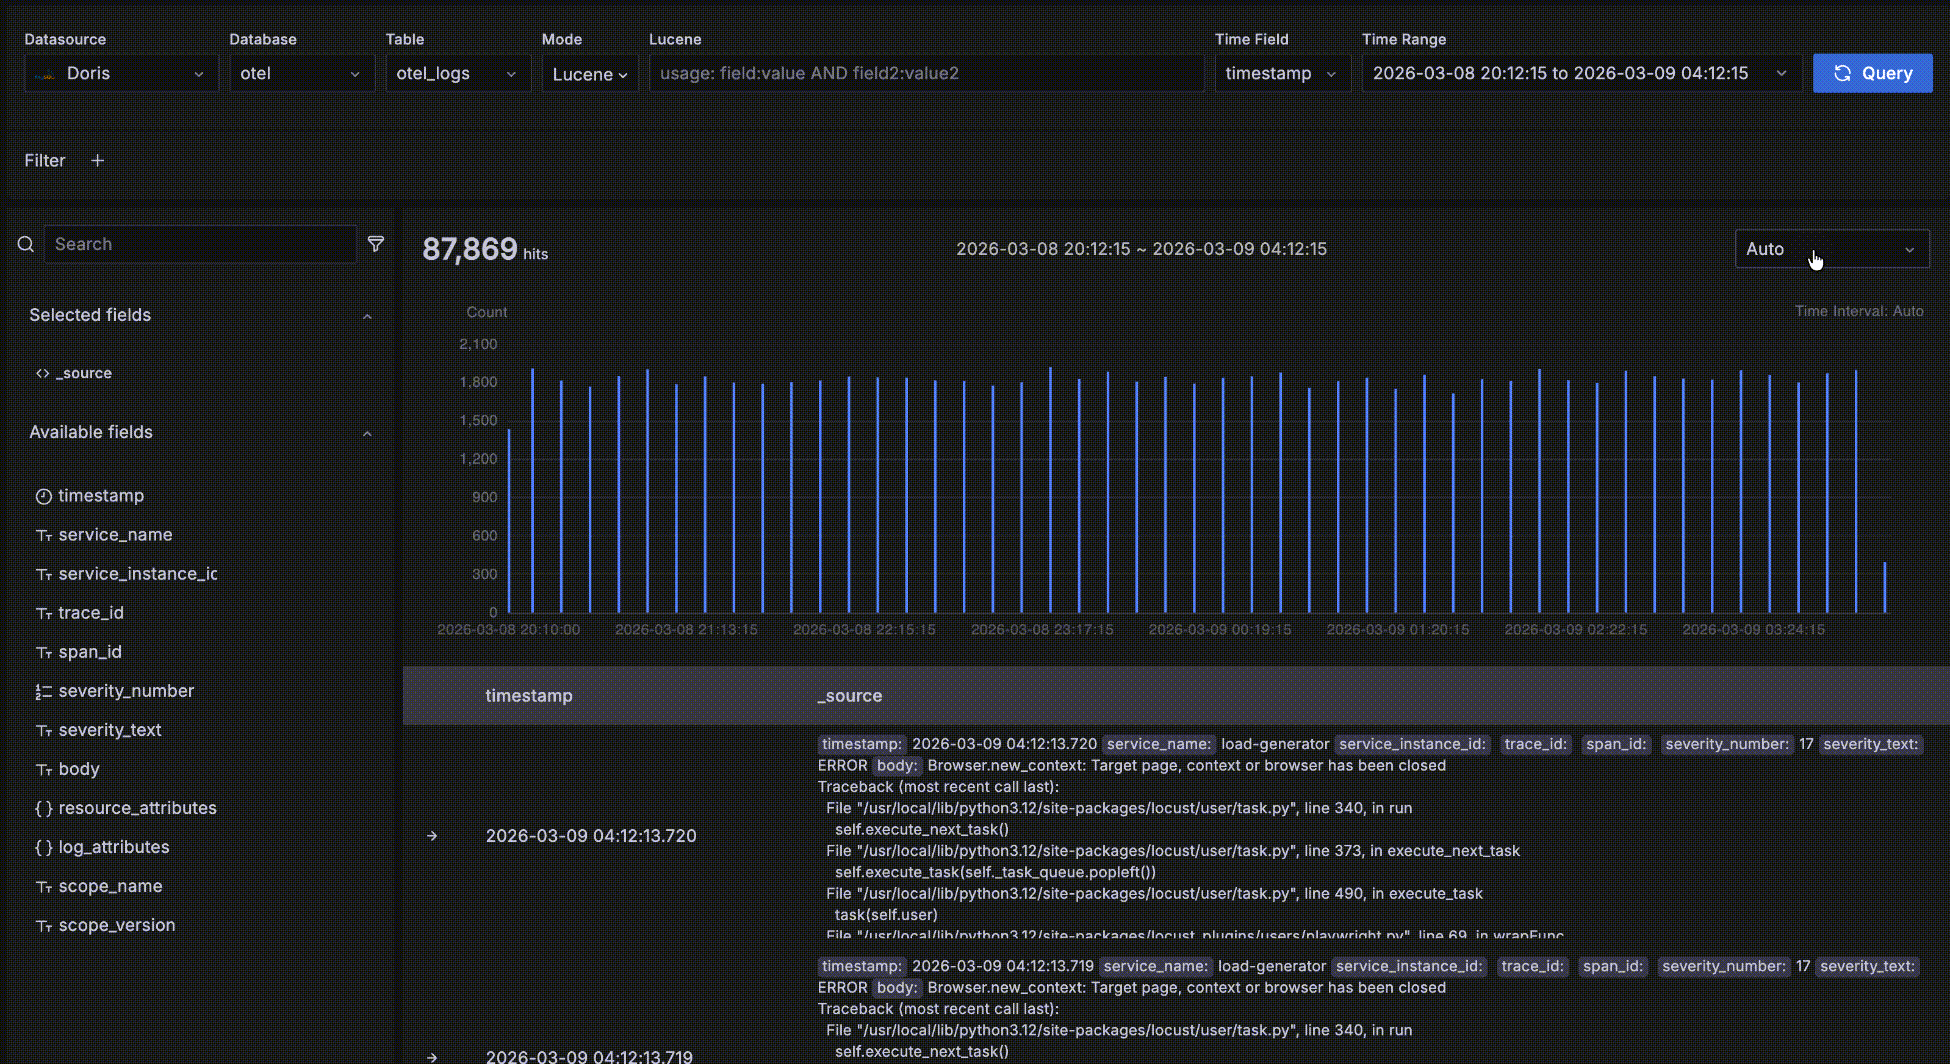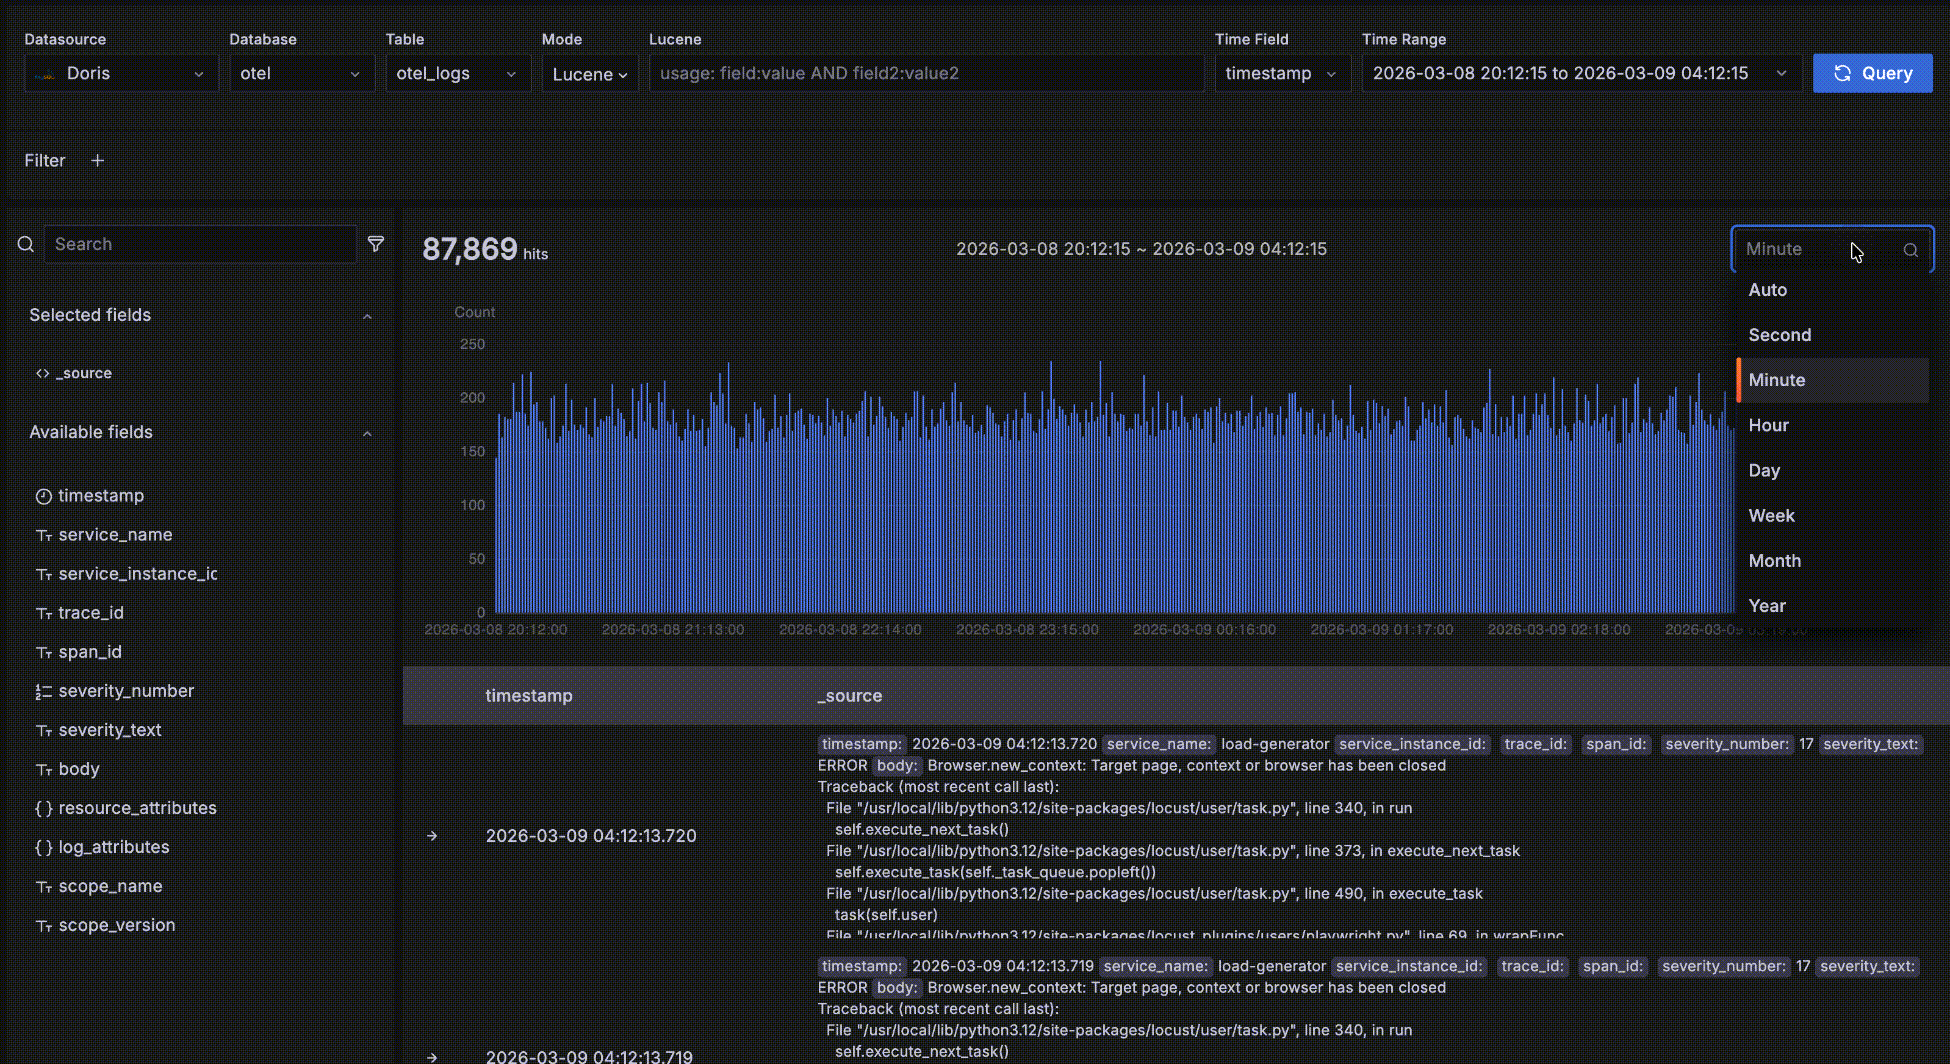
下図の赤枠内が時間傾向データ領域です。一致するデータの件数と時間的な傾向をすばやく確認できます。次の操作ができます。
- 棒グラフの棒にカーソルを合わせると、その時間バケットの開始時刻と、そのバケット内で一致するデータの件数が表示されます。
- 傾向グラフ上で範囲をドラッグして選択すると、クエリの時間範囲を変更できます。
- バケット幅のデフォルト値は
Autoで、時間範囲全体に応じて調整されます。ドロップダウンから秒、分、時間など、別の粒度も選択できます。
詳細データ
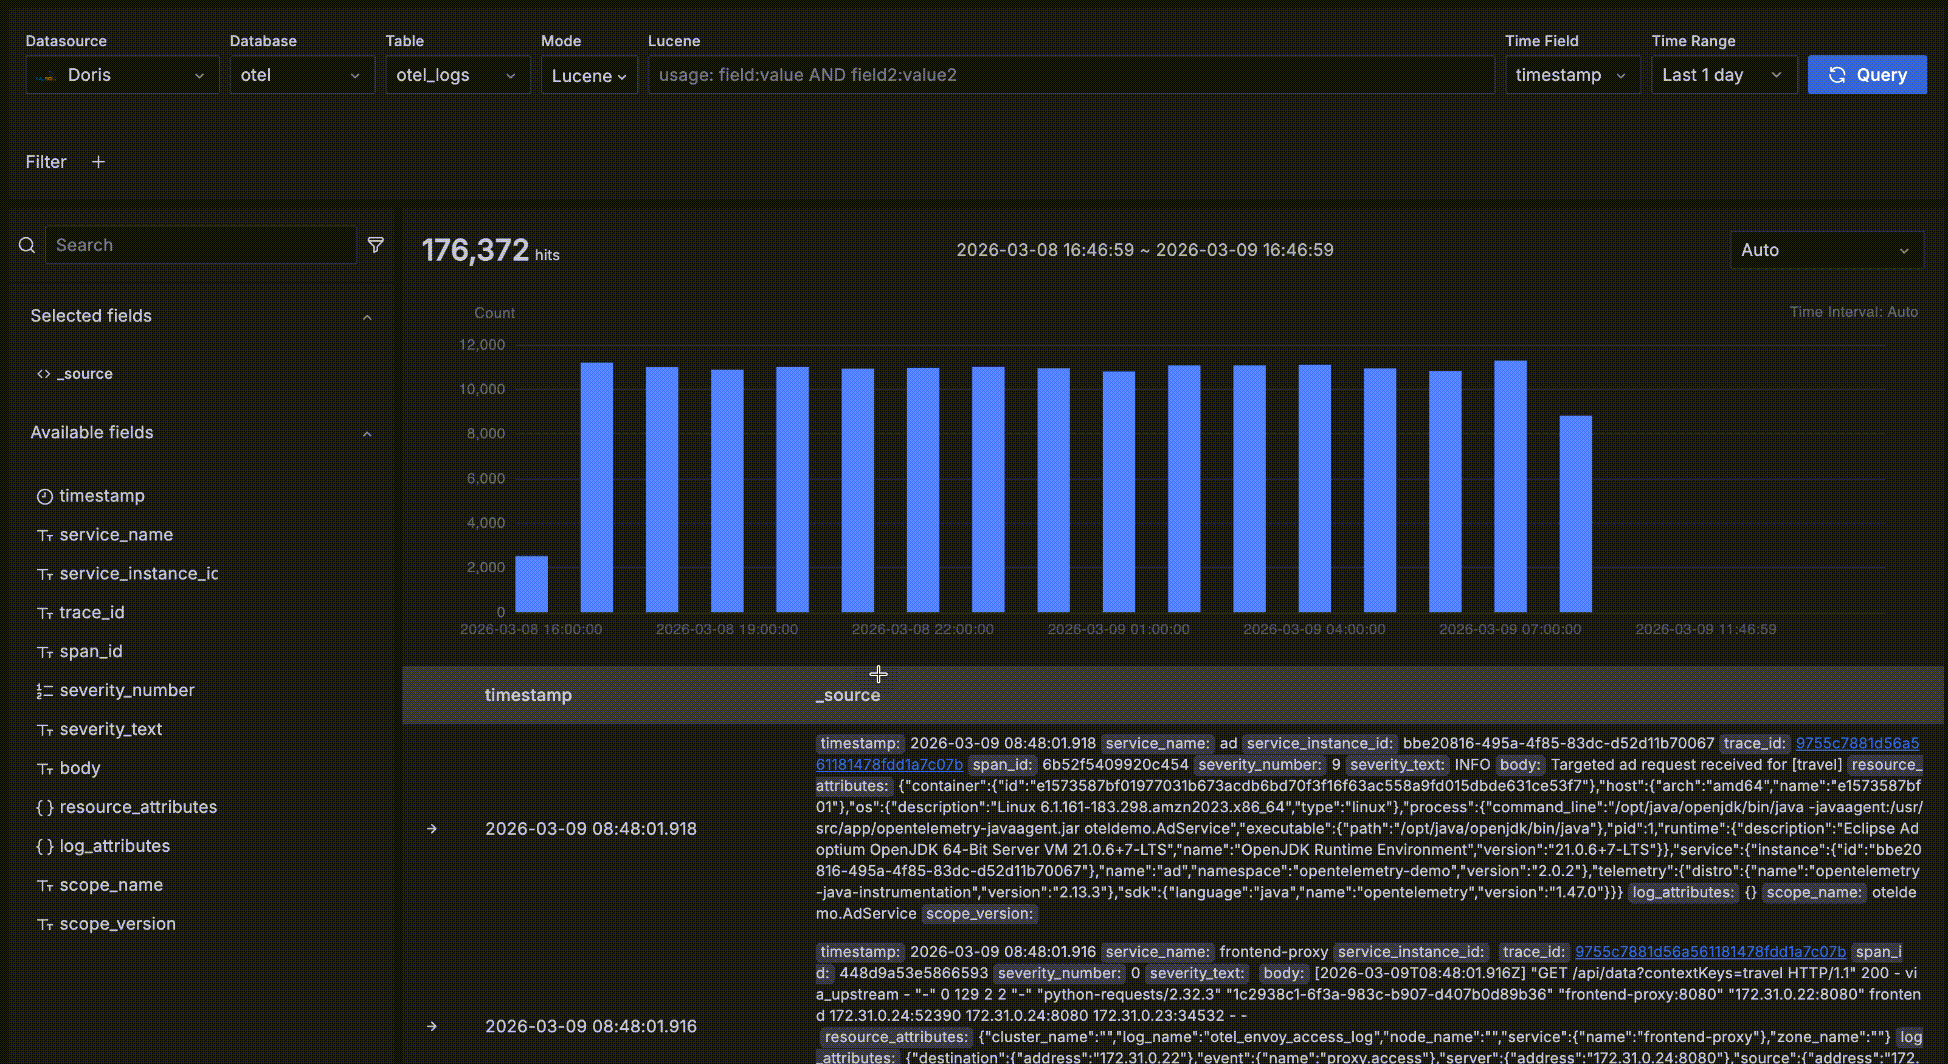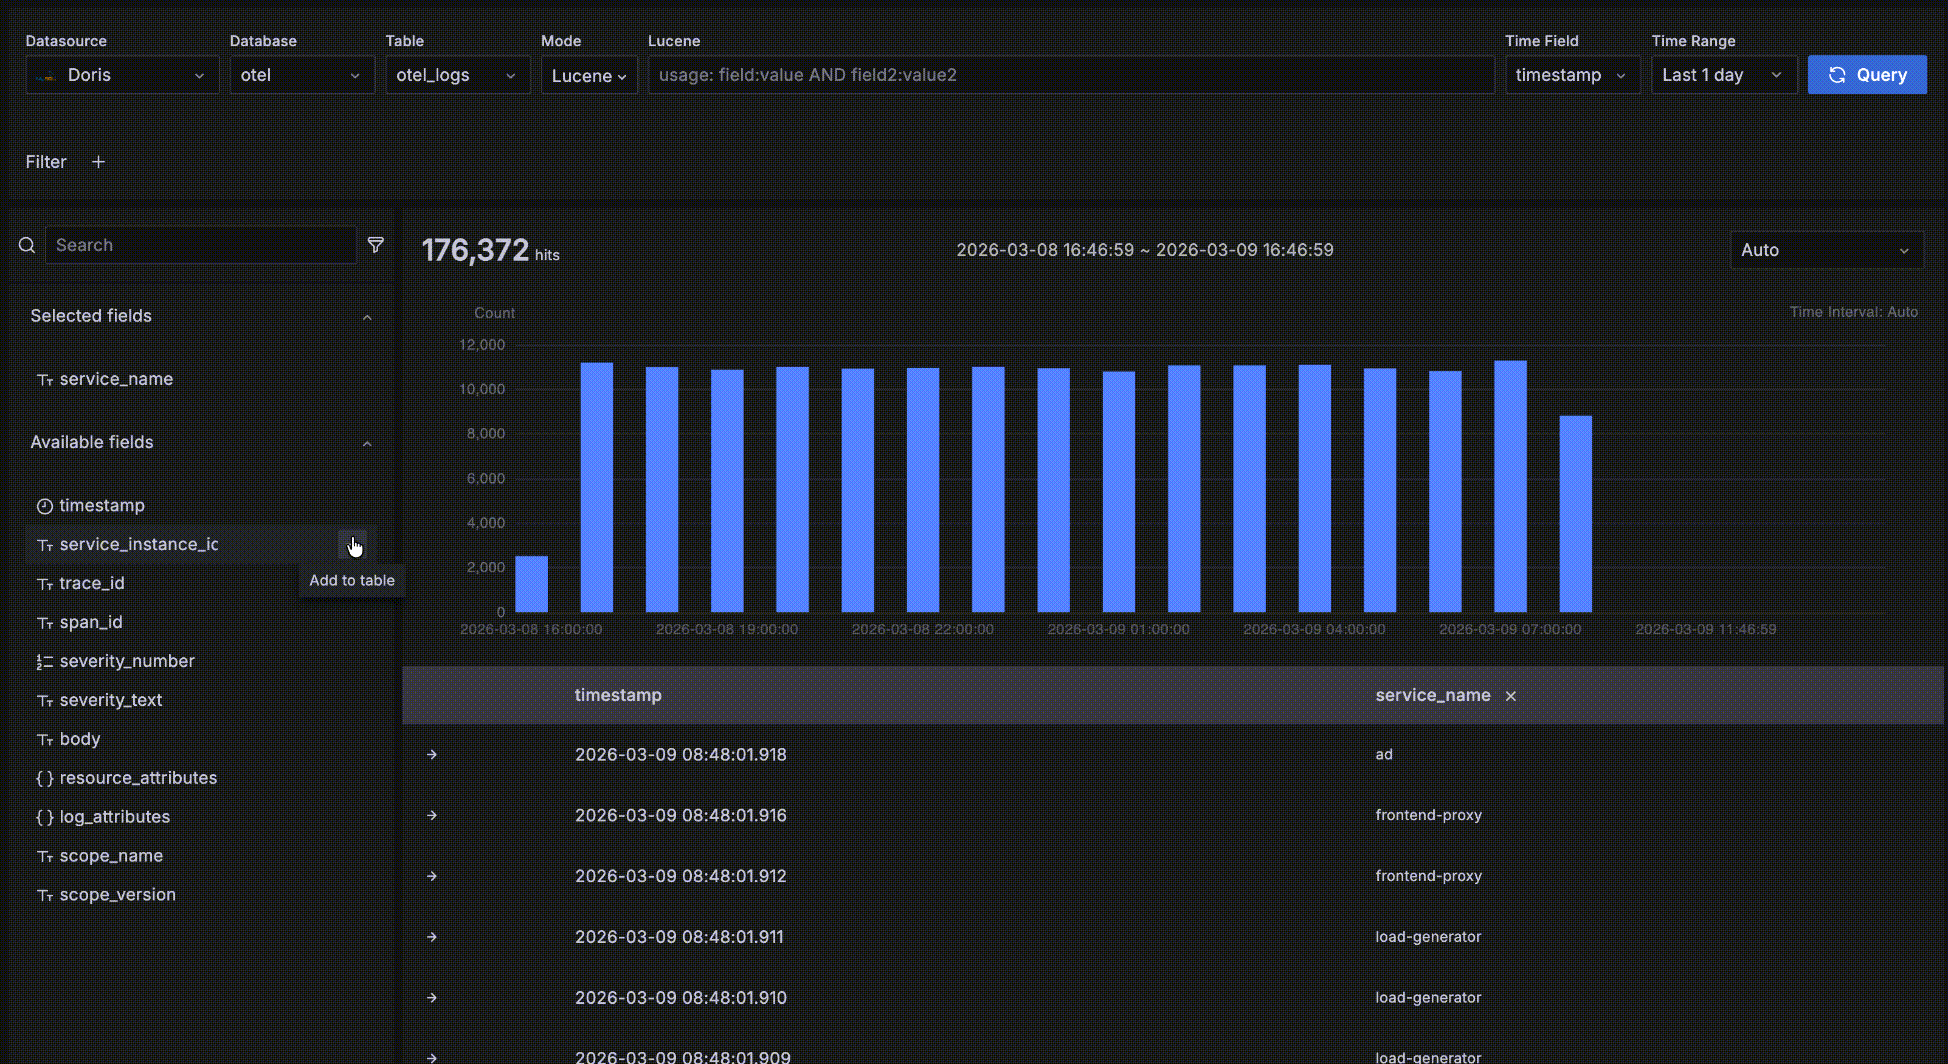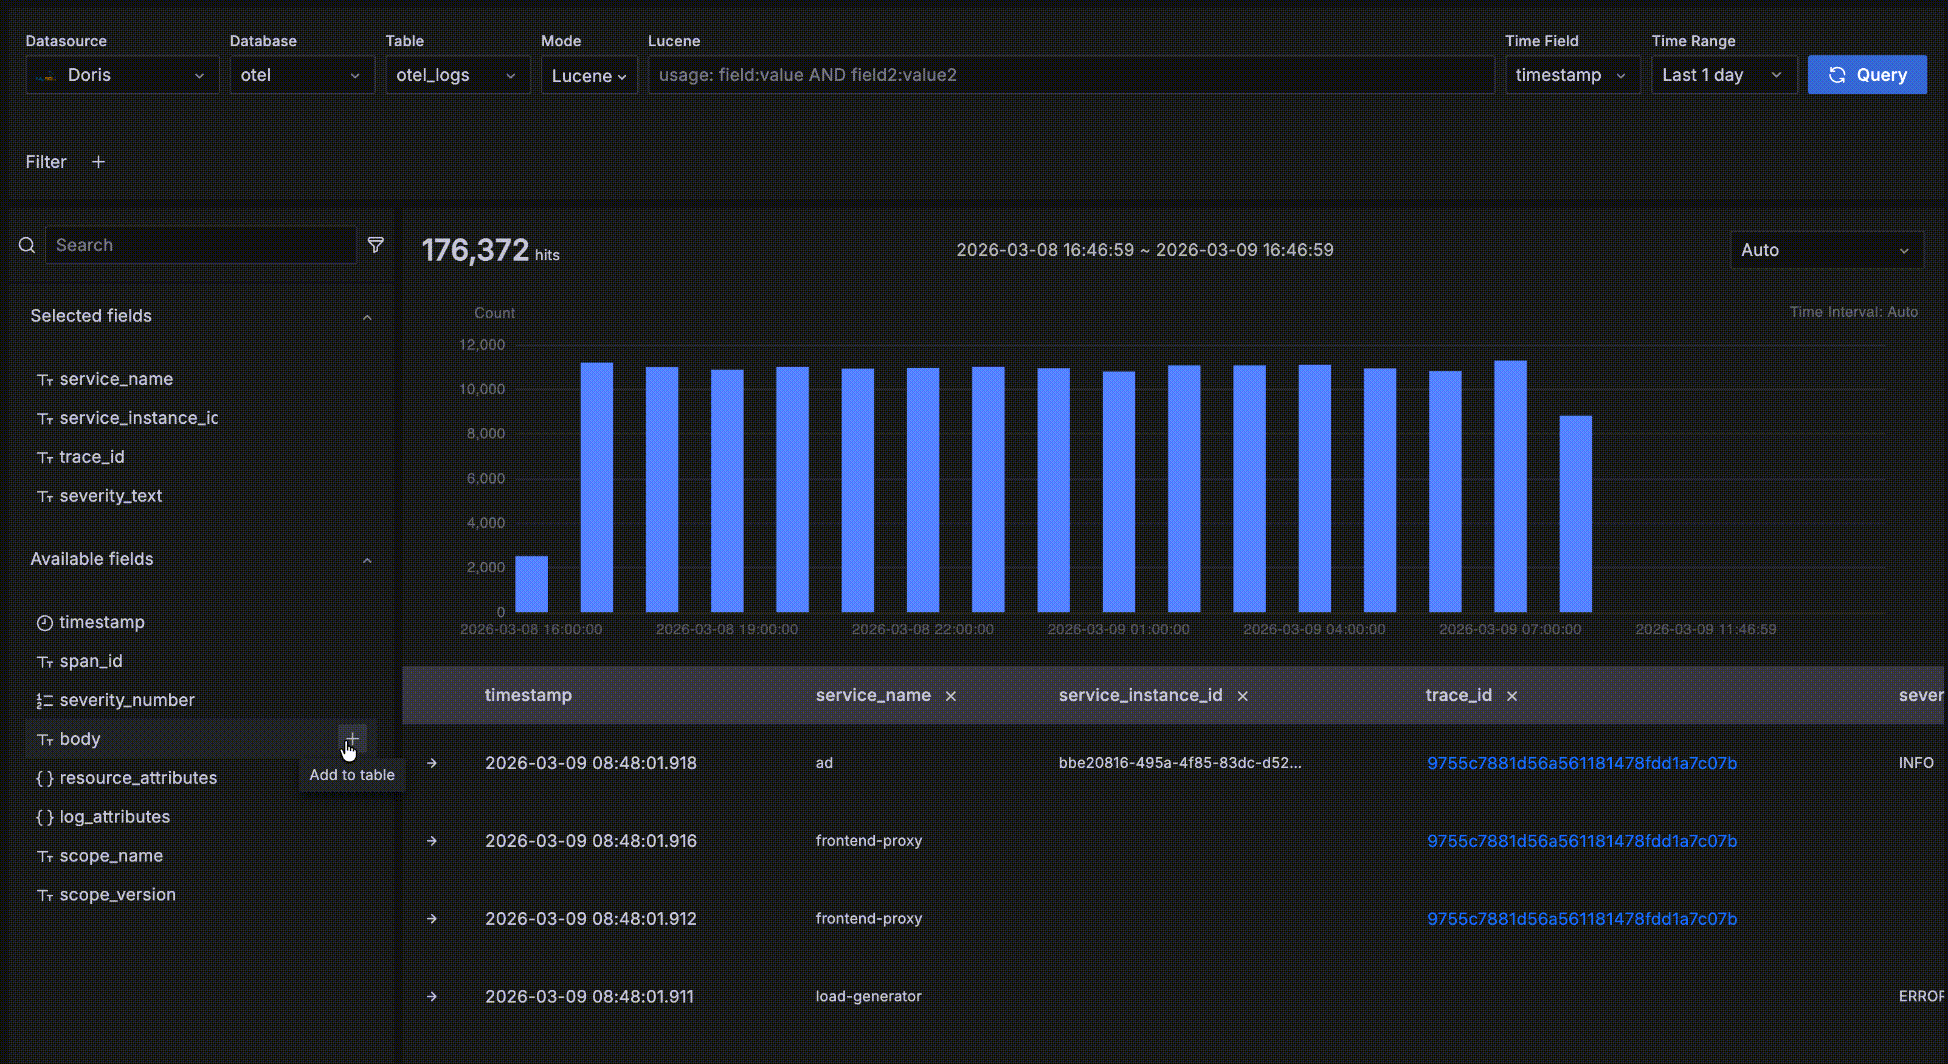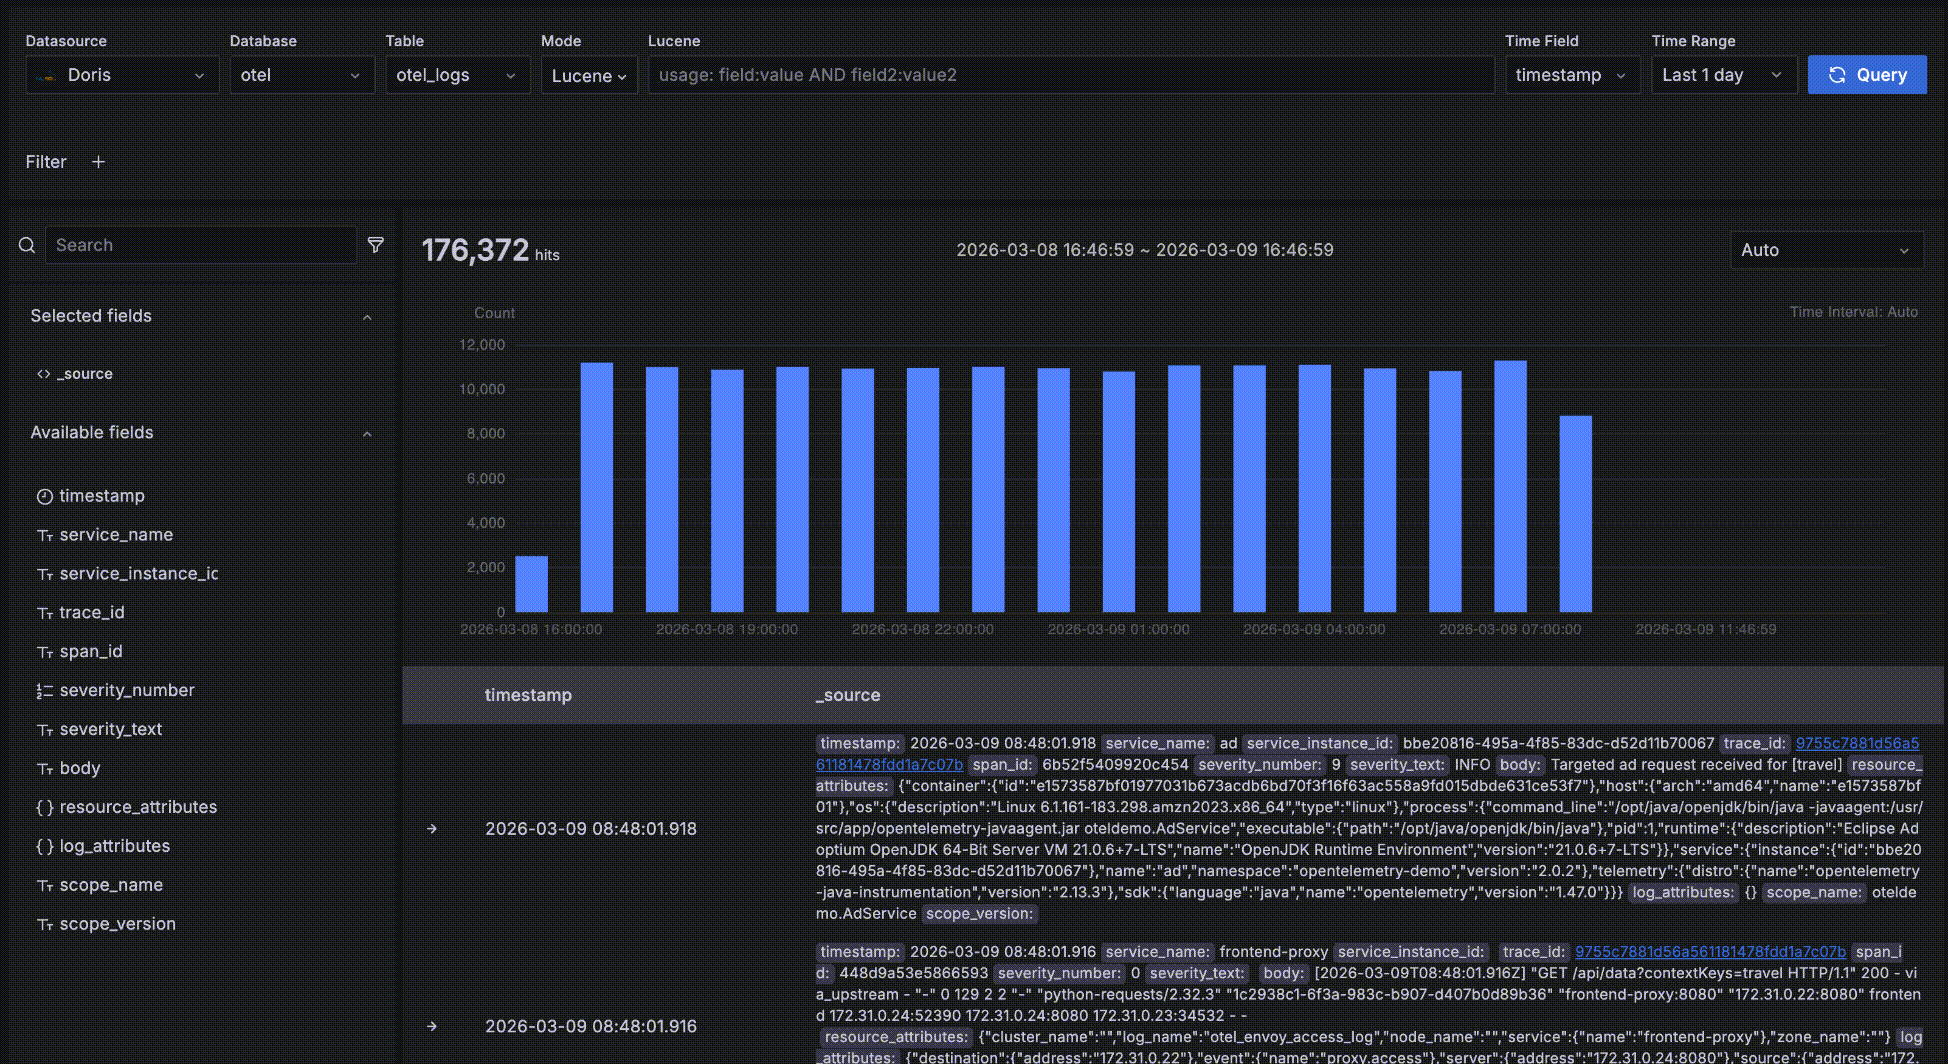
下図の赤枠内が詳細データ領域で、クエリ条件に一致するレコードを表示します。
- レコードは時間フィールドの降順に並び、最新のデータが先頭に表示されます。各ページに 50 件のレコードが表示され、ページを切り替えて続きを確認できます。デフォルトでは、時間フィールドと
_sourceの二つのフィールドが表示されます。_sourceはすべてのフィールドをkey: value形式で仮想的に連結したもので、読みやすいようにキーが強調表示されます。左側のフィールドブラウザーでフィールド名の横にある「+」をクリックすると、右側に表示するフィールドを変更できます。複数のフィールドを追加でき、右側の「x」をクリックすると削除できます。すべてのフィールドを削除すると、デフォルトの_source表示に戻ります。
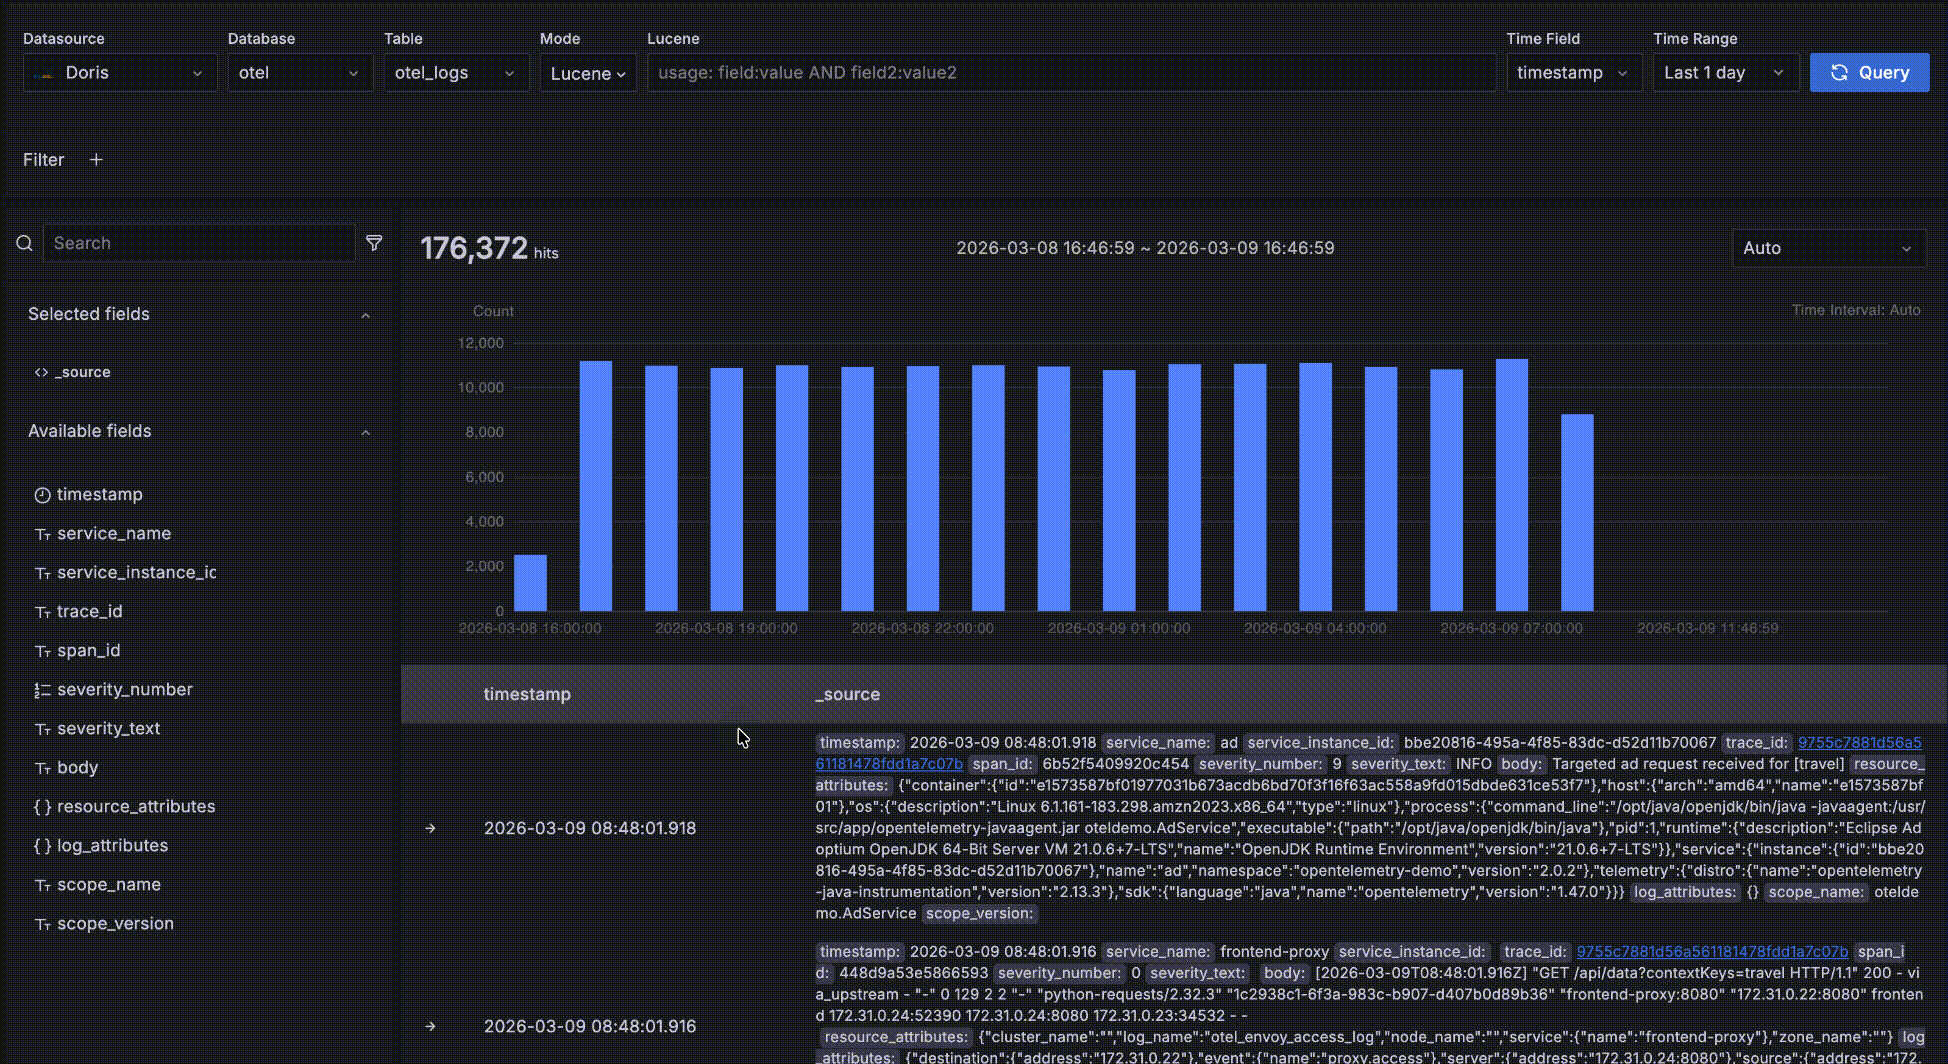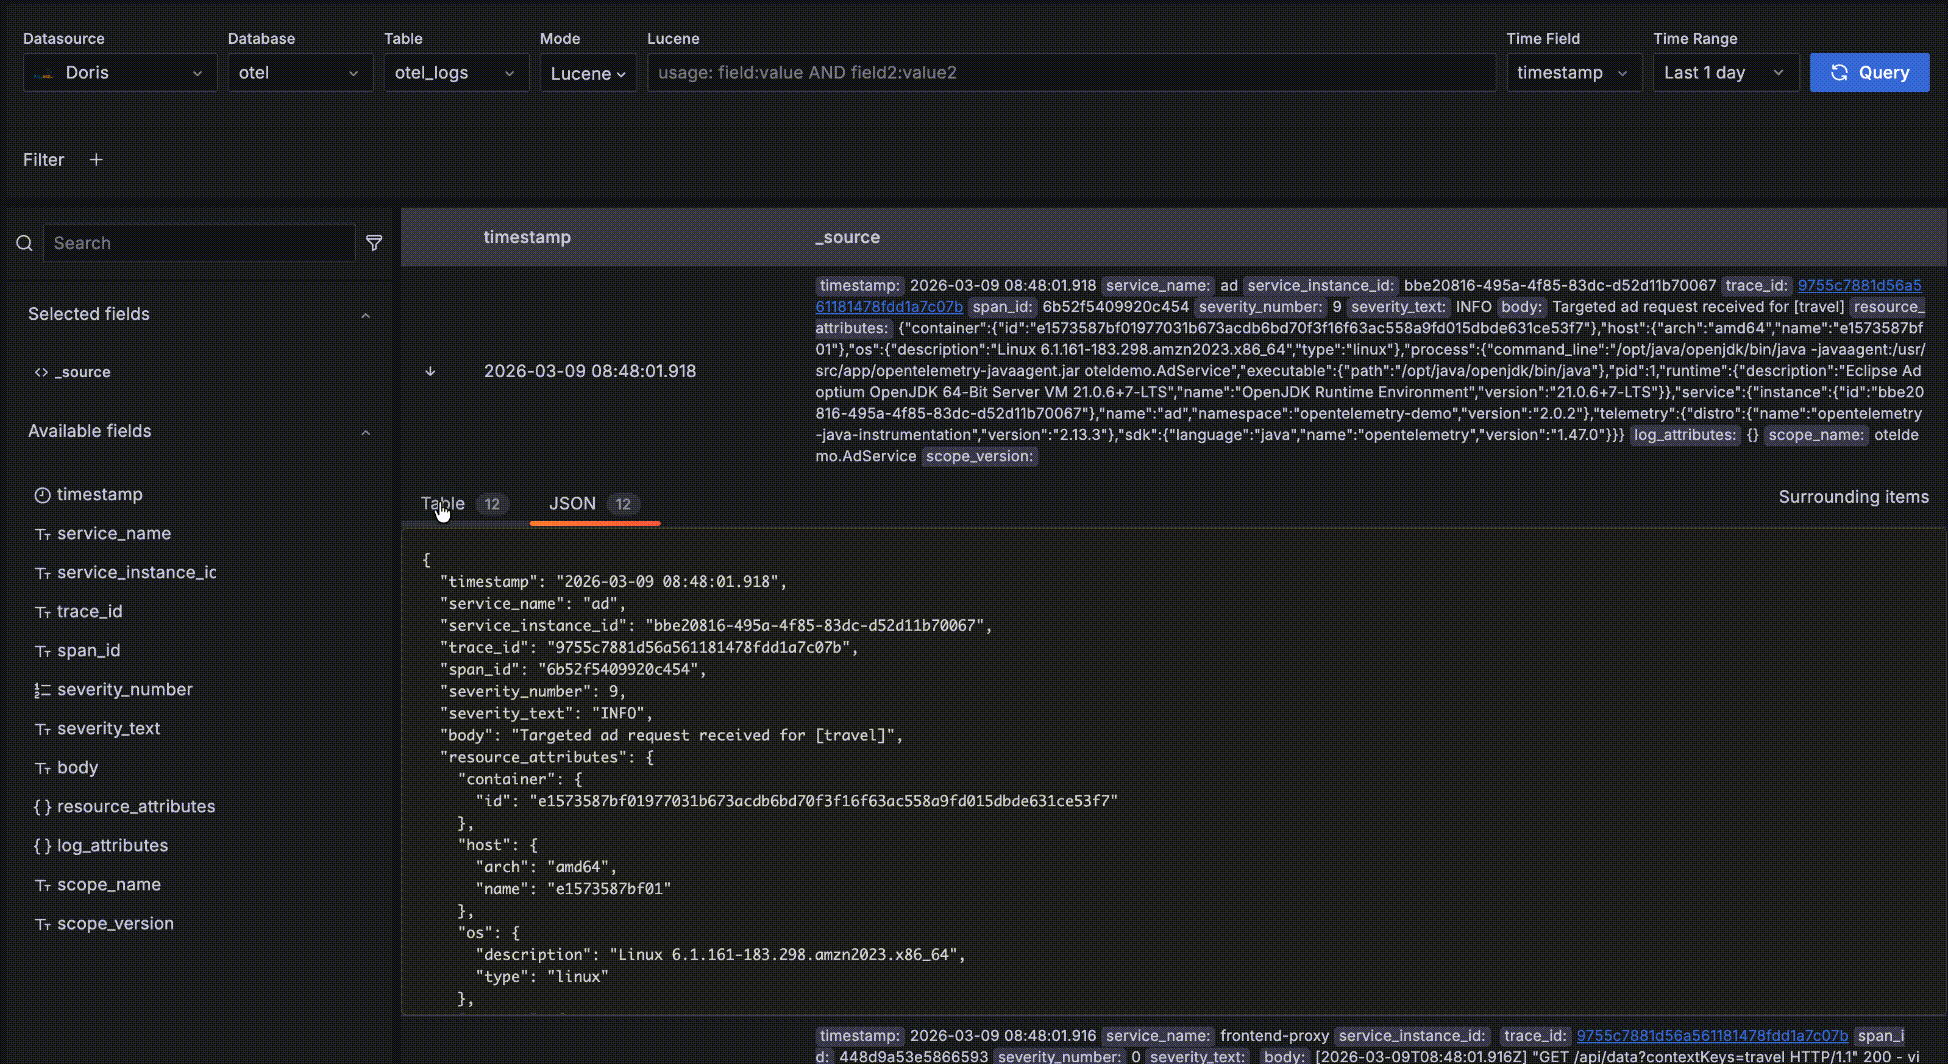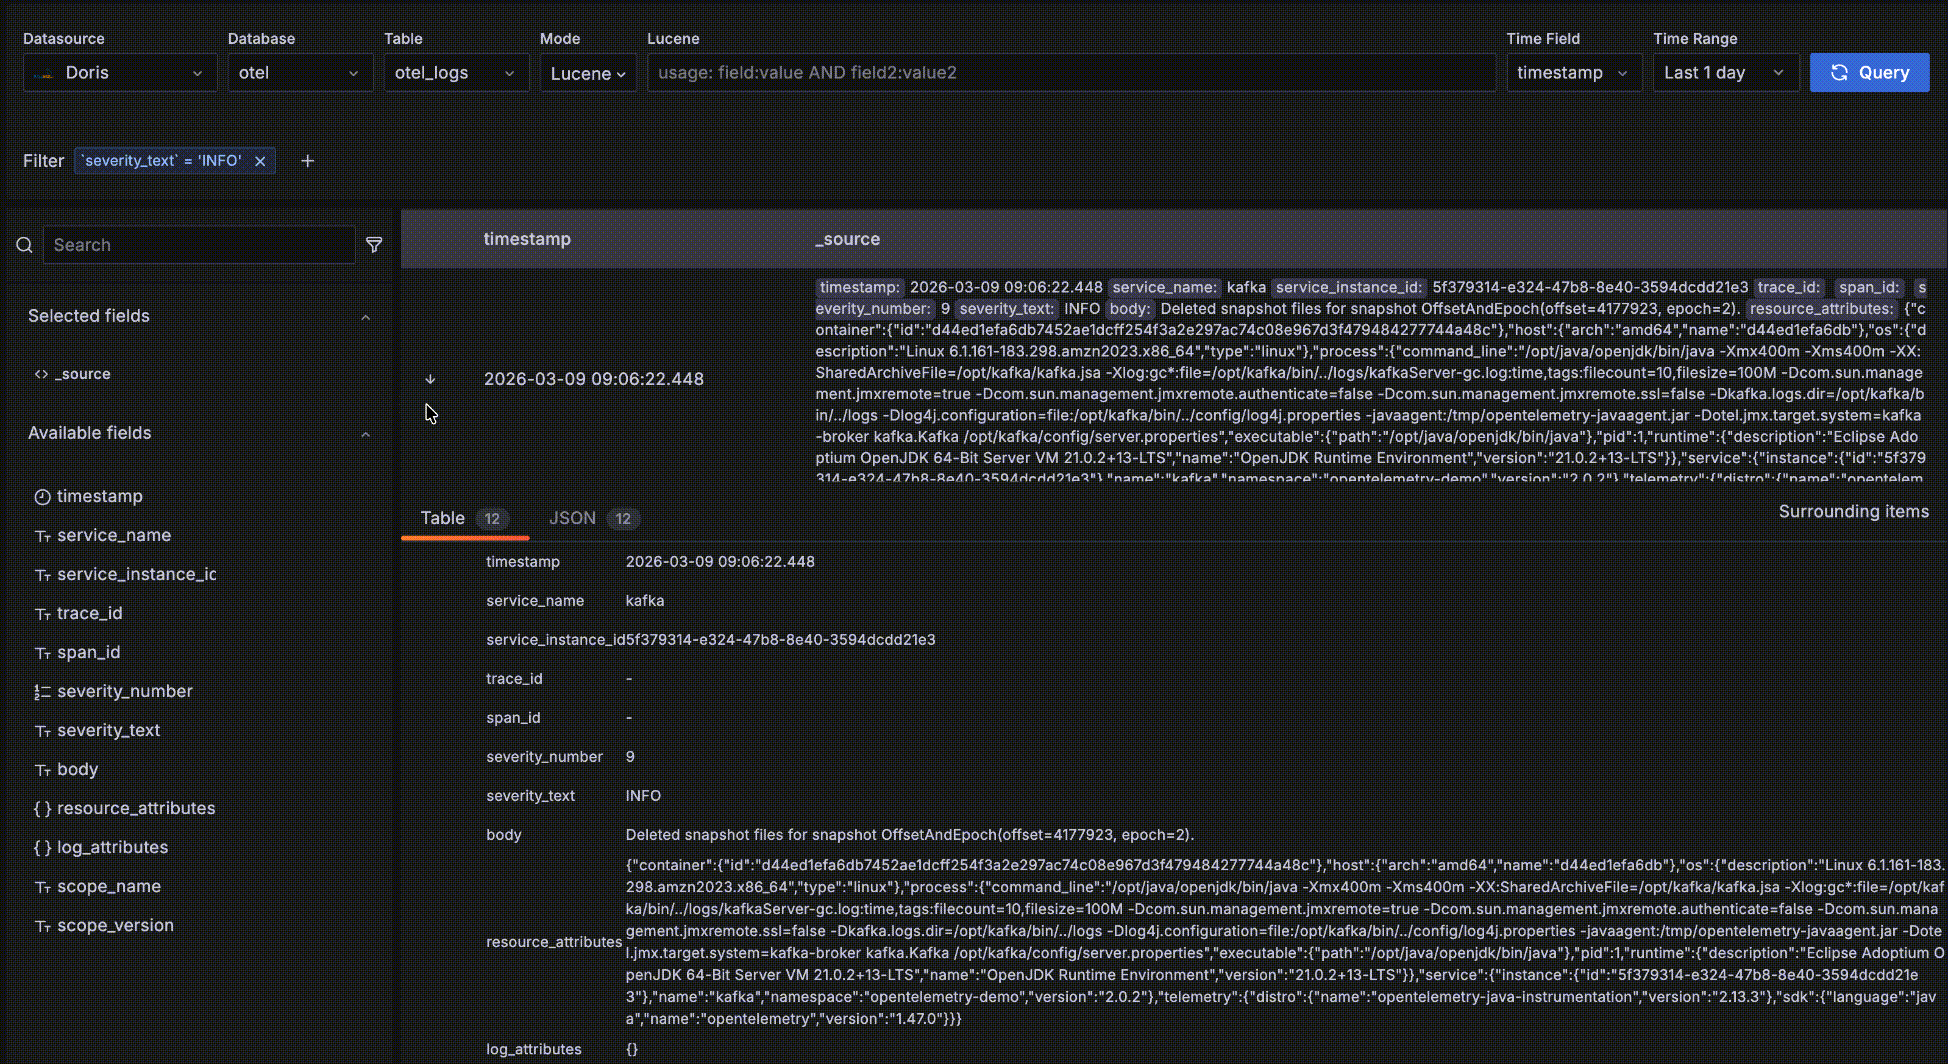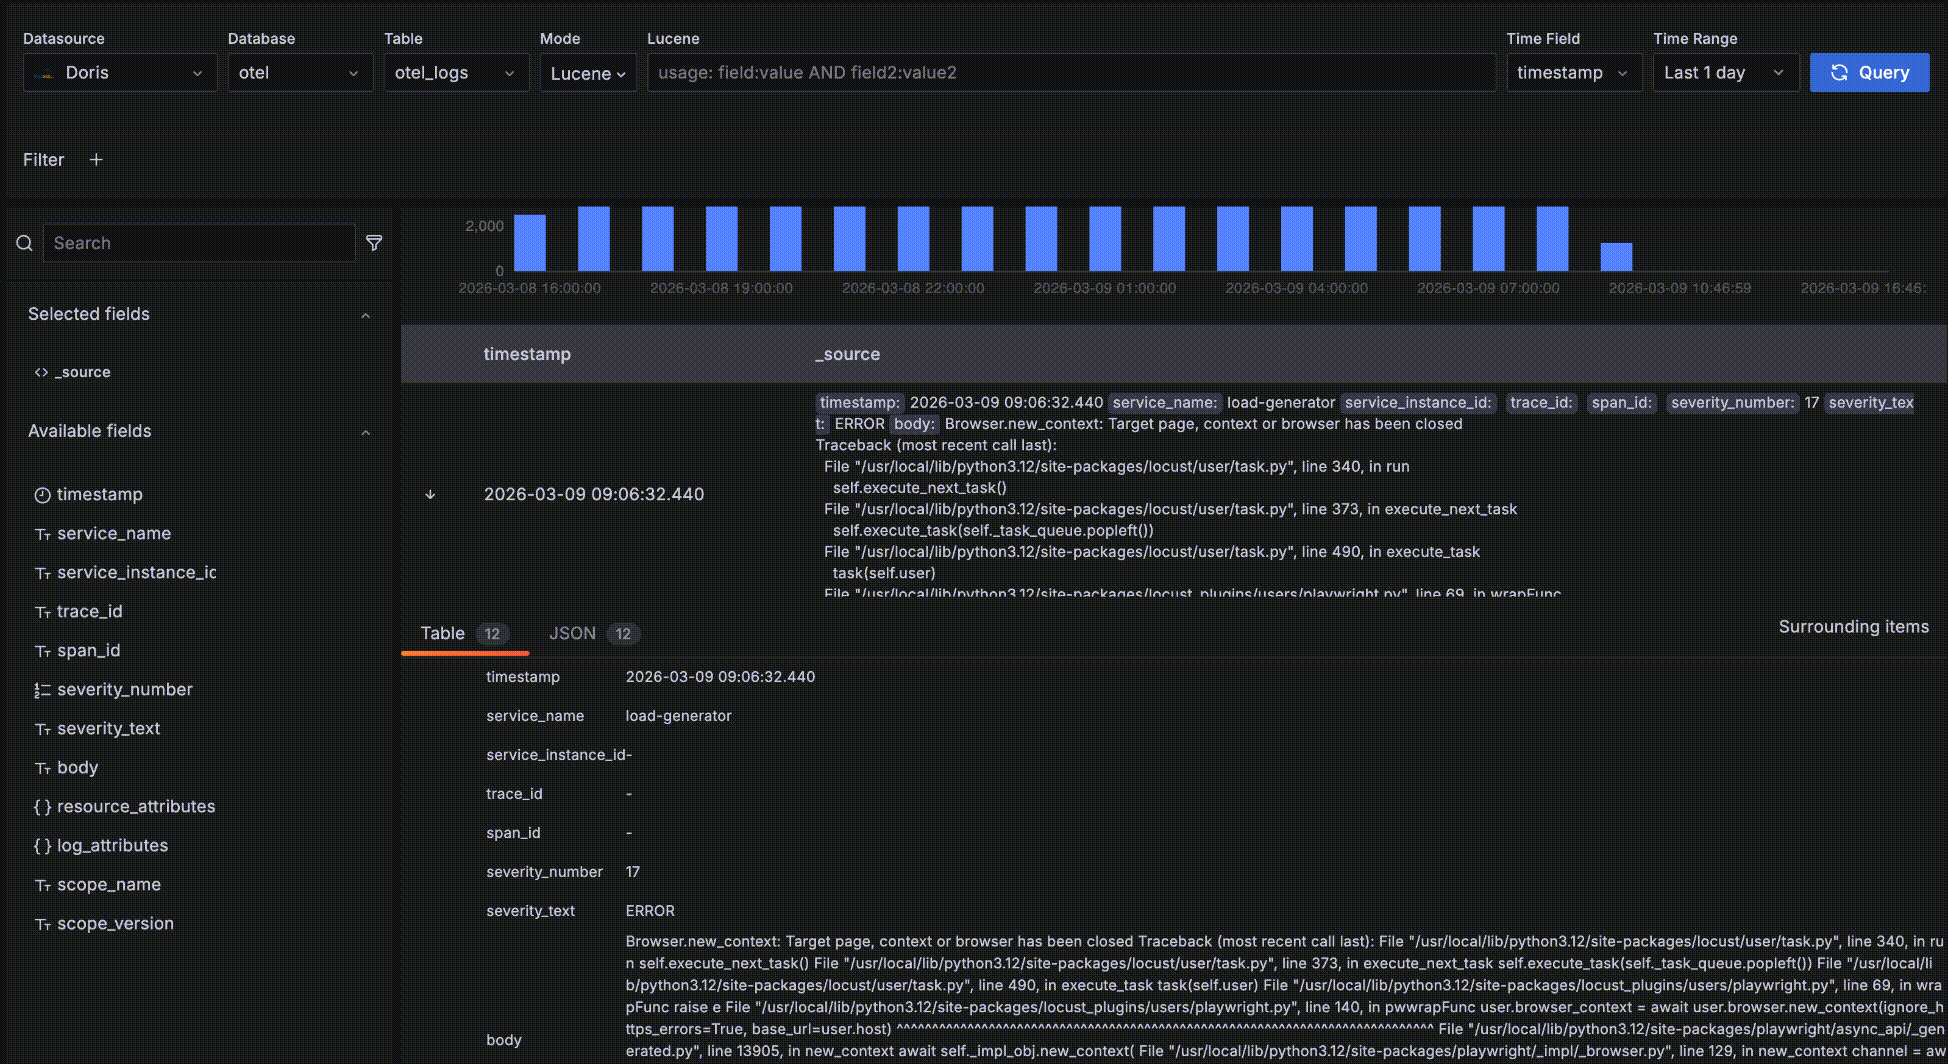
- 左端の「->」矢印をクリックすると、レコードの詳細が展開されます。表示形式は テーブル と JSON の二種類です。テーブル形式では、フィールドの横にある「+」または「-」をクリックすると、
severity_text=INFOなどのフィルター条件を対話的に追加できます。
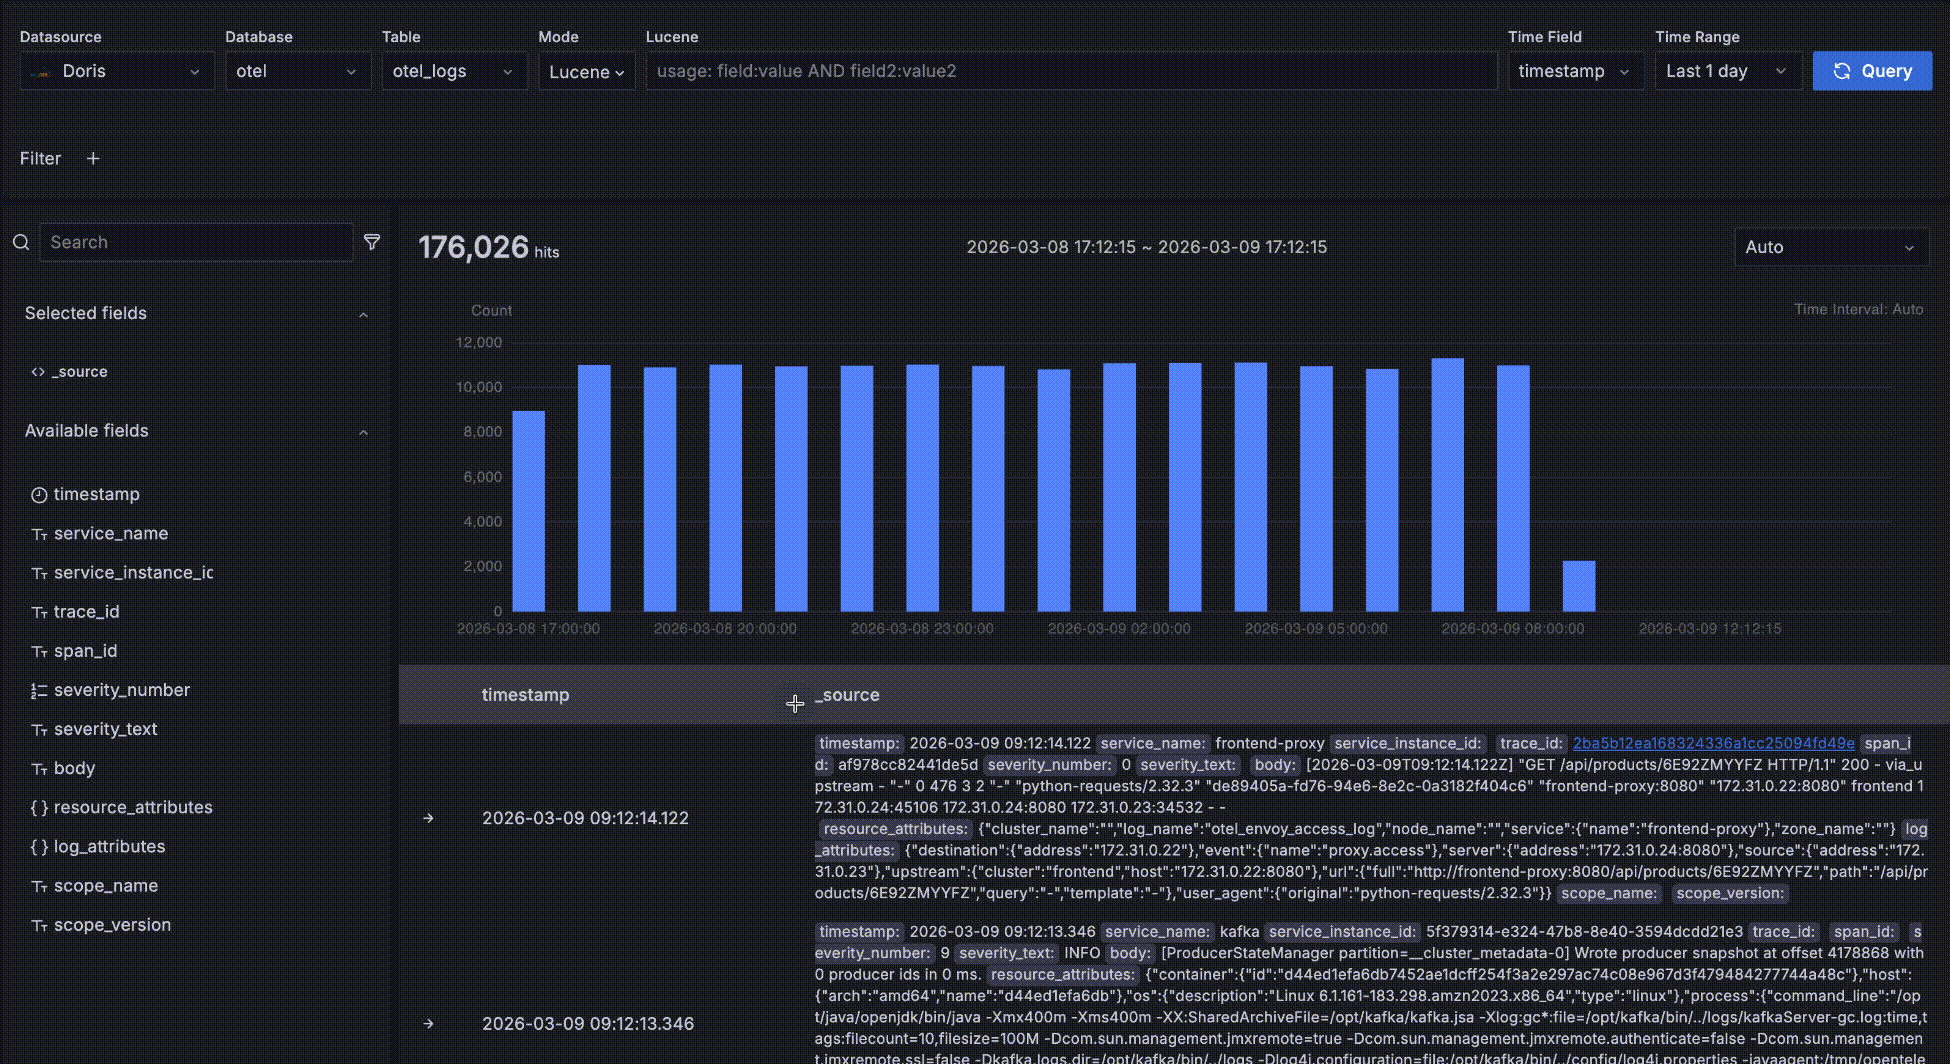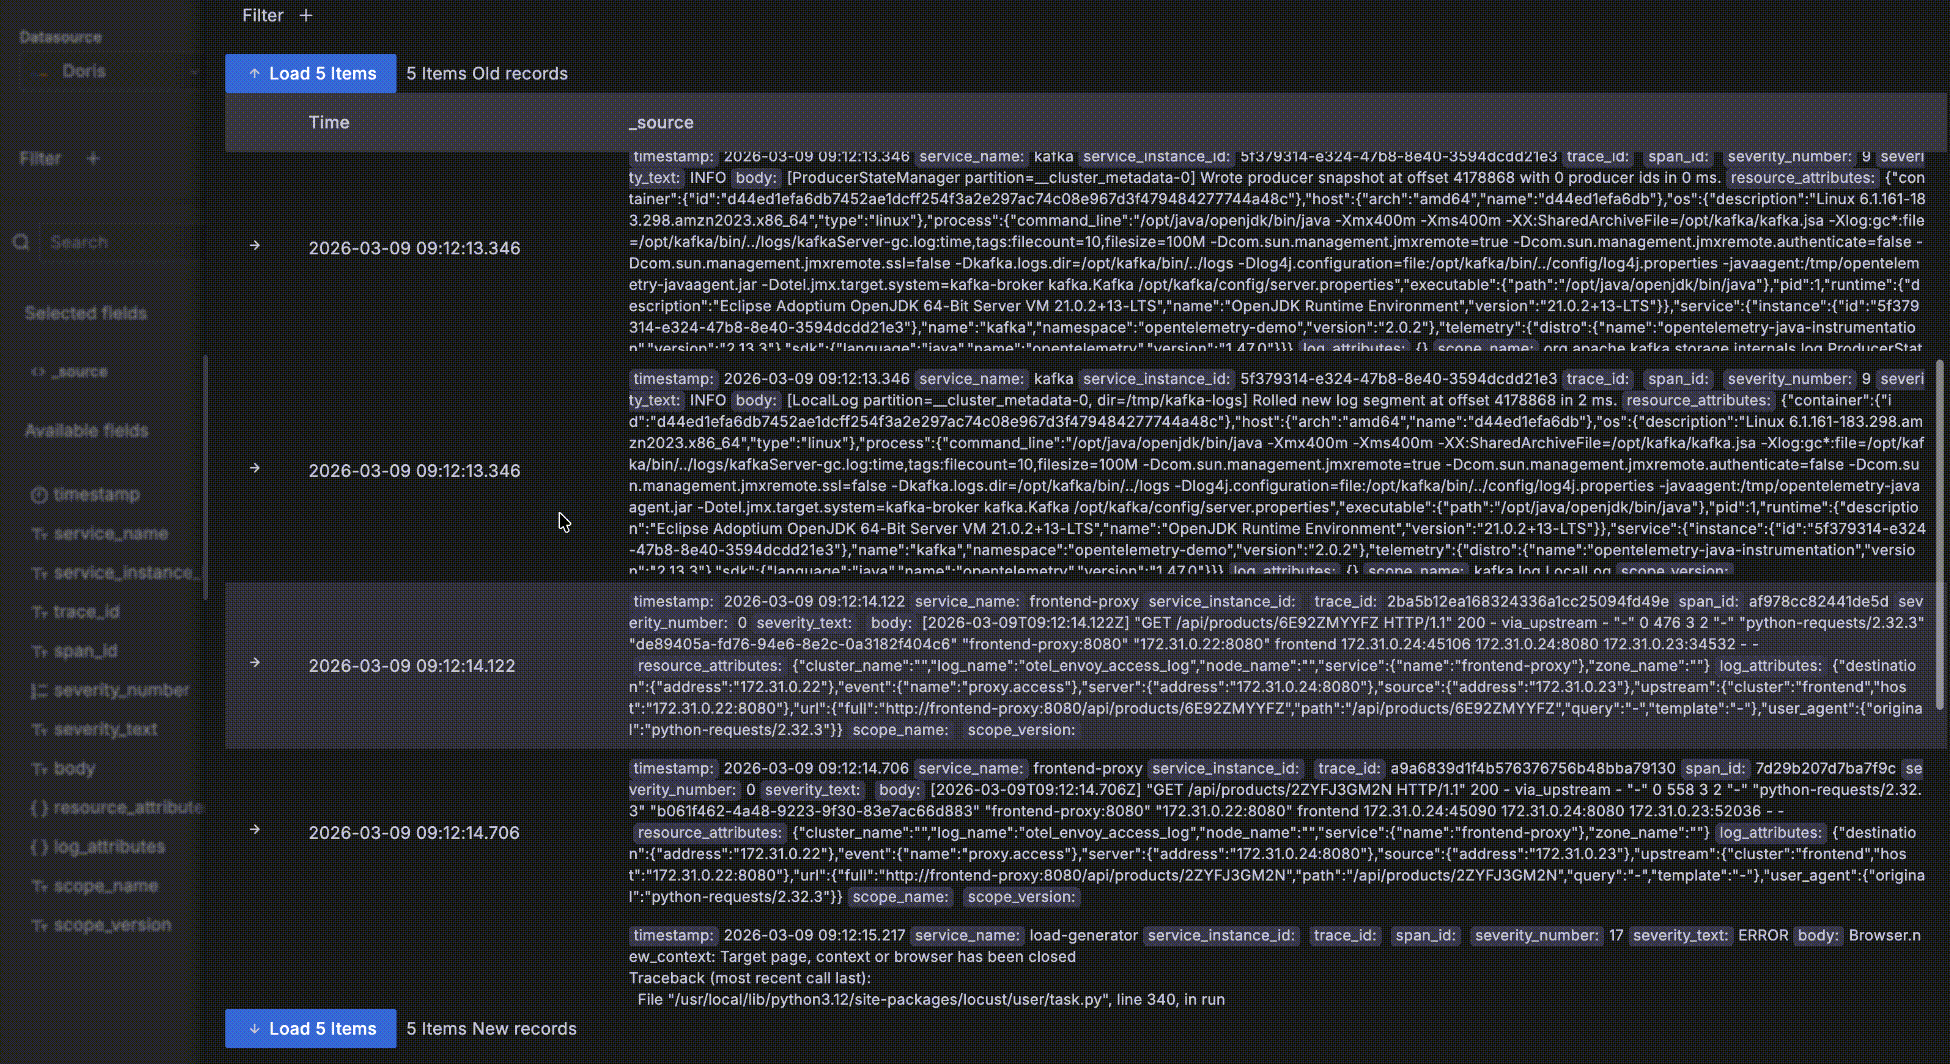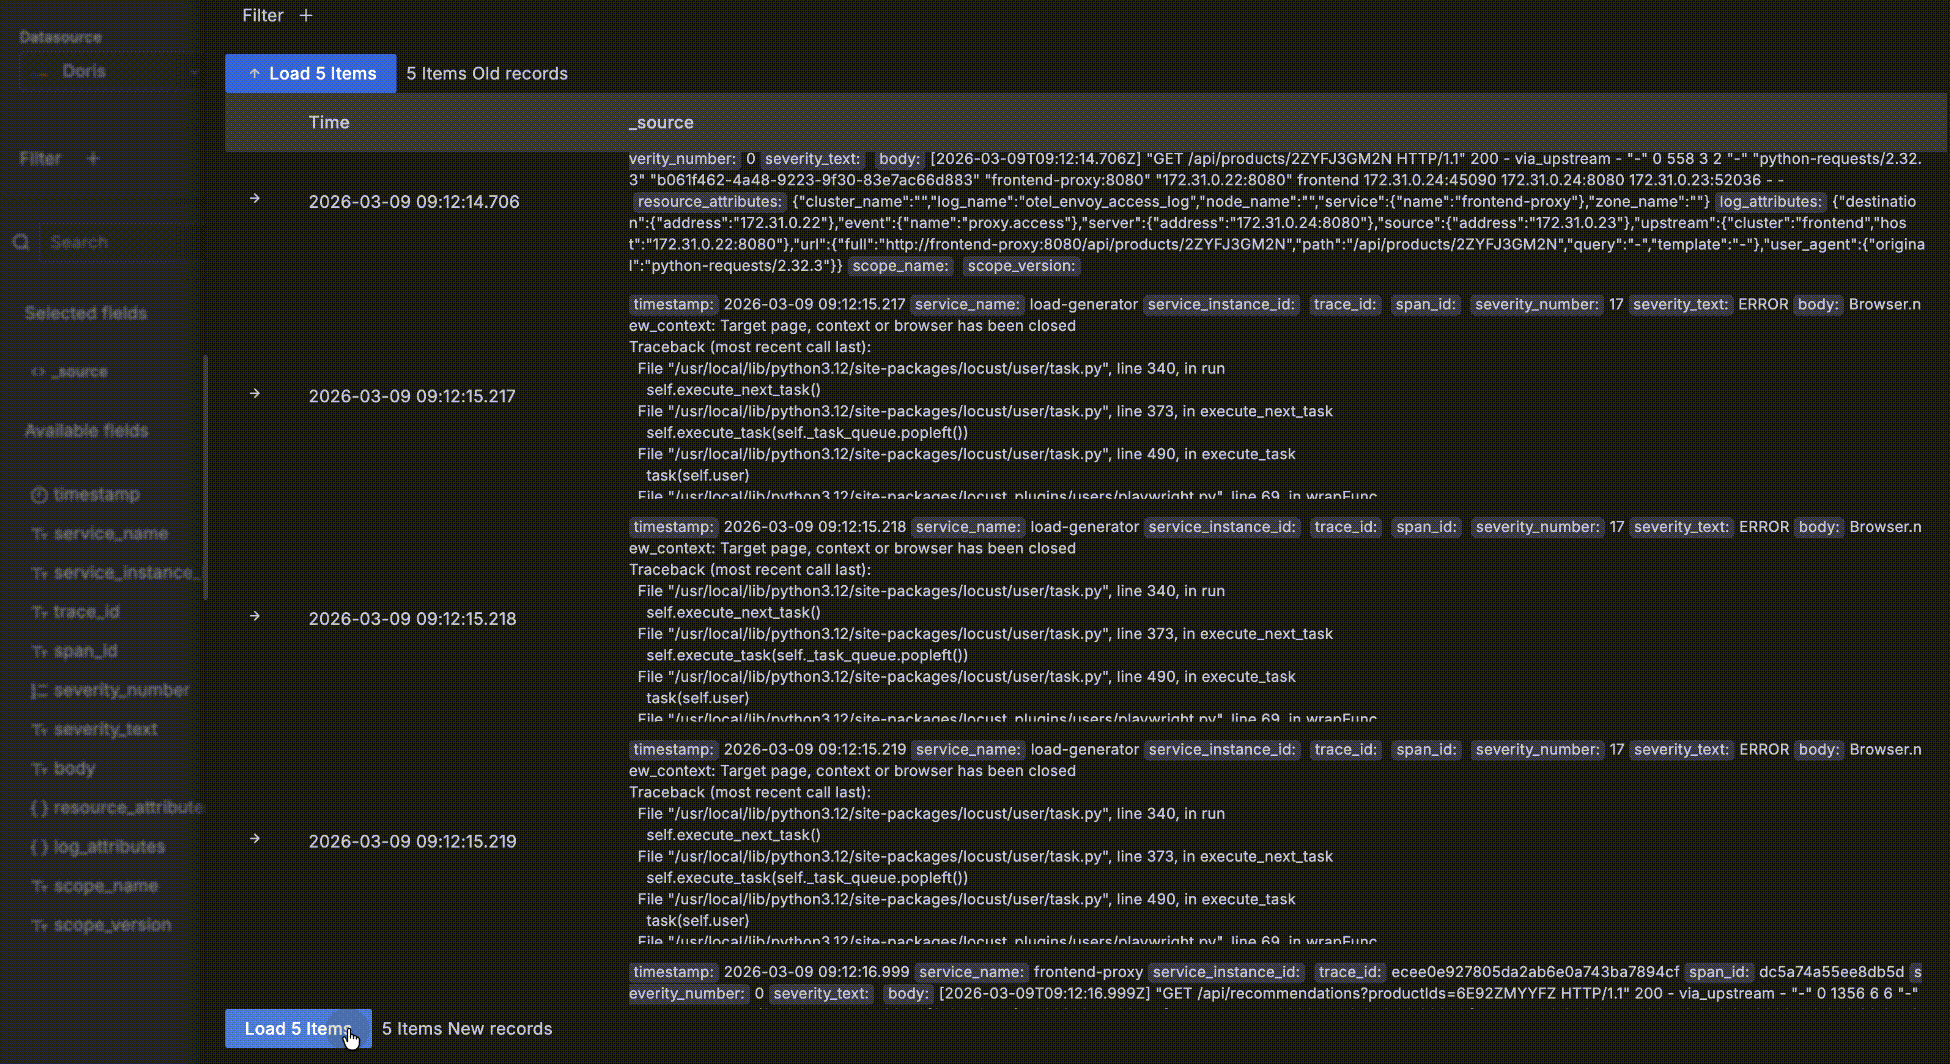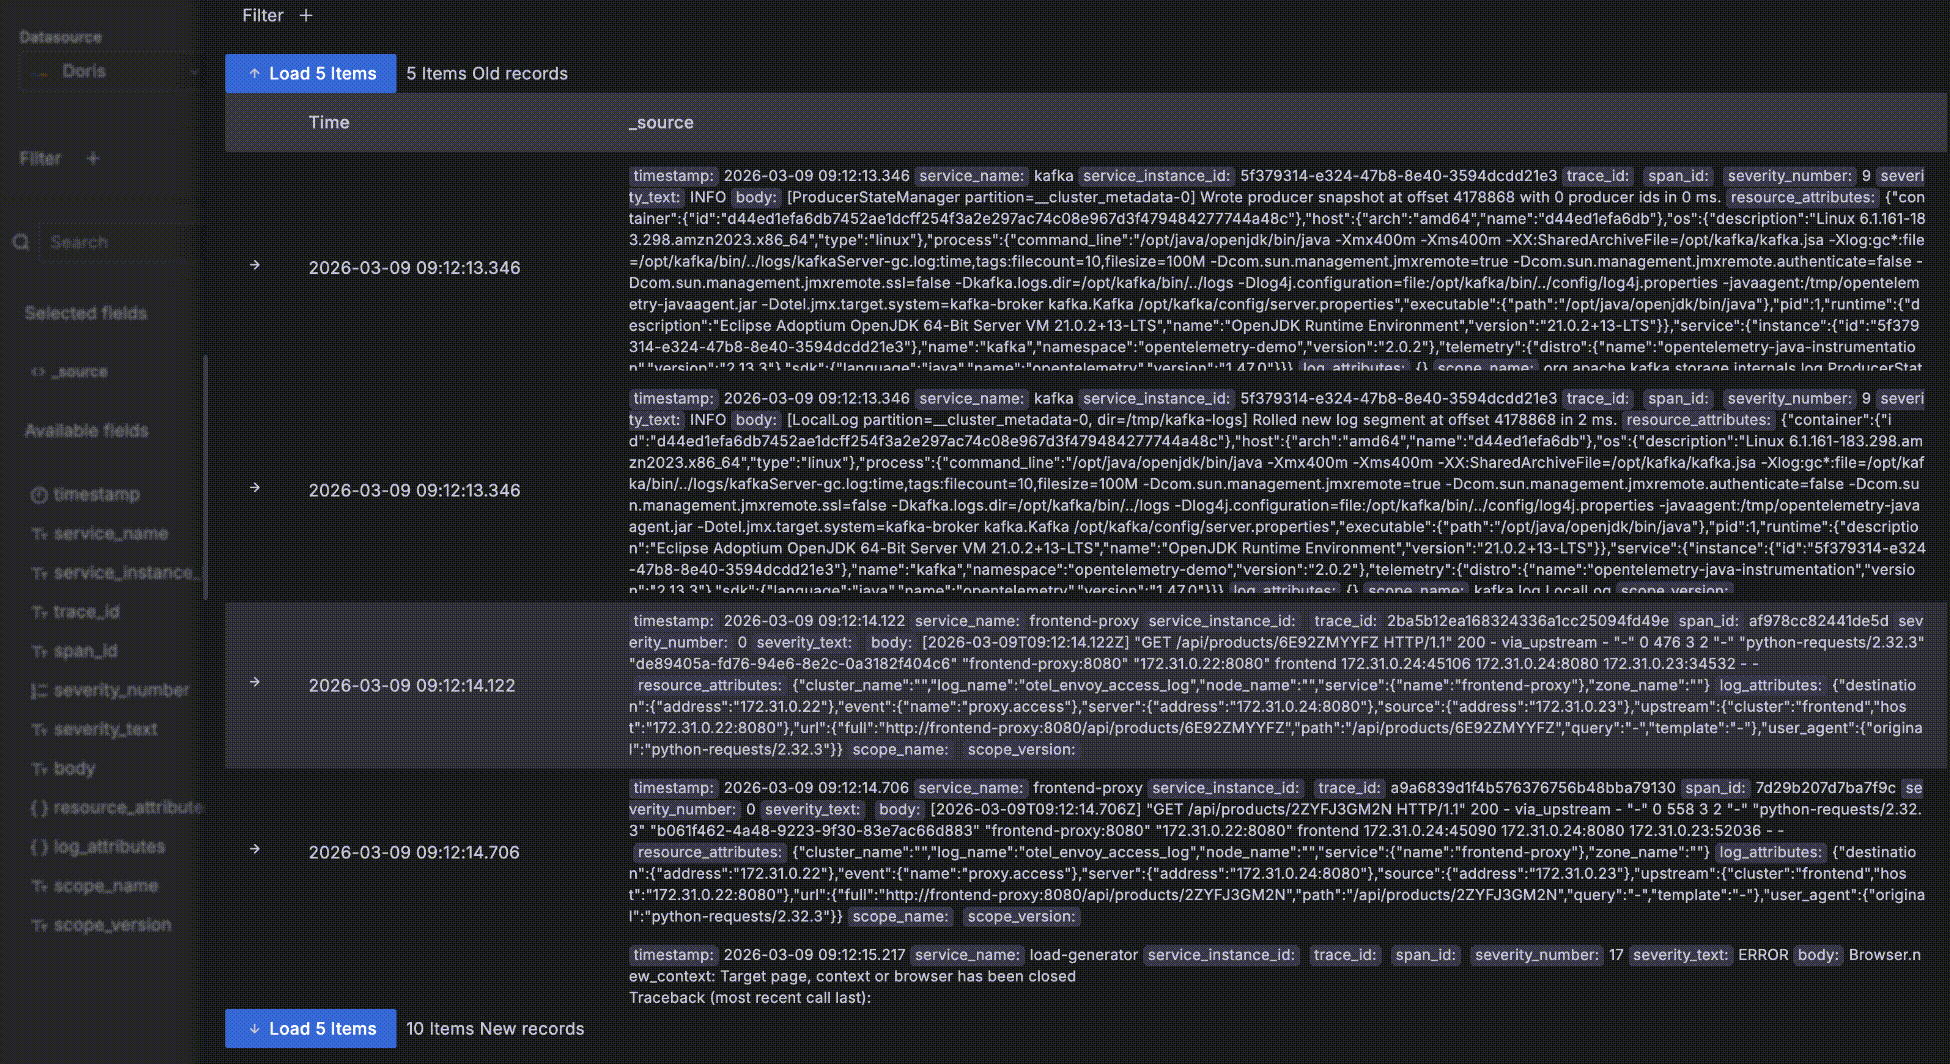
- レコードを展開して Surrounding items(前後の項目)をクリックすると、そのレコードの「コンテキスト」として、時間的に前後 5 件ずつのレコードを表示できます。この機能は問題の調査中に特定のログの前後を確認するためによく使われるため、時間以外のクエリフィルター条件は無視されます。そうしなければ、詳細データテーブルと同じ結果になってしまいます。前後 5 件を超えるレコードを表示したり、特定のホストに絞り込むなどのフィルターを追加したりすることもできます。
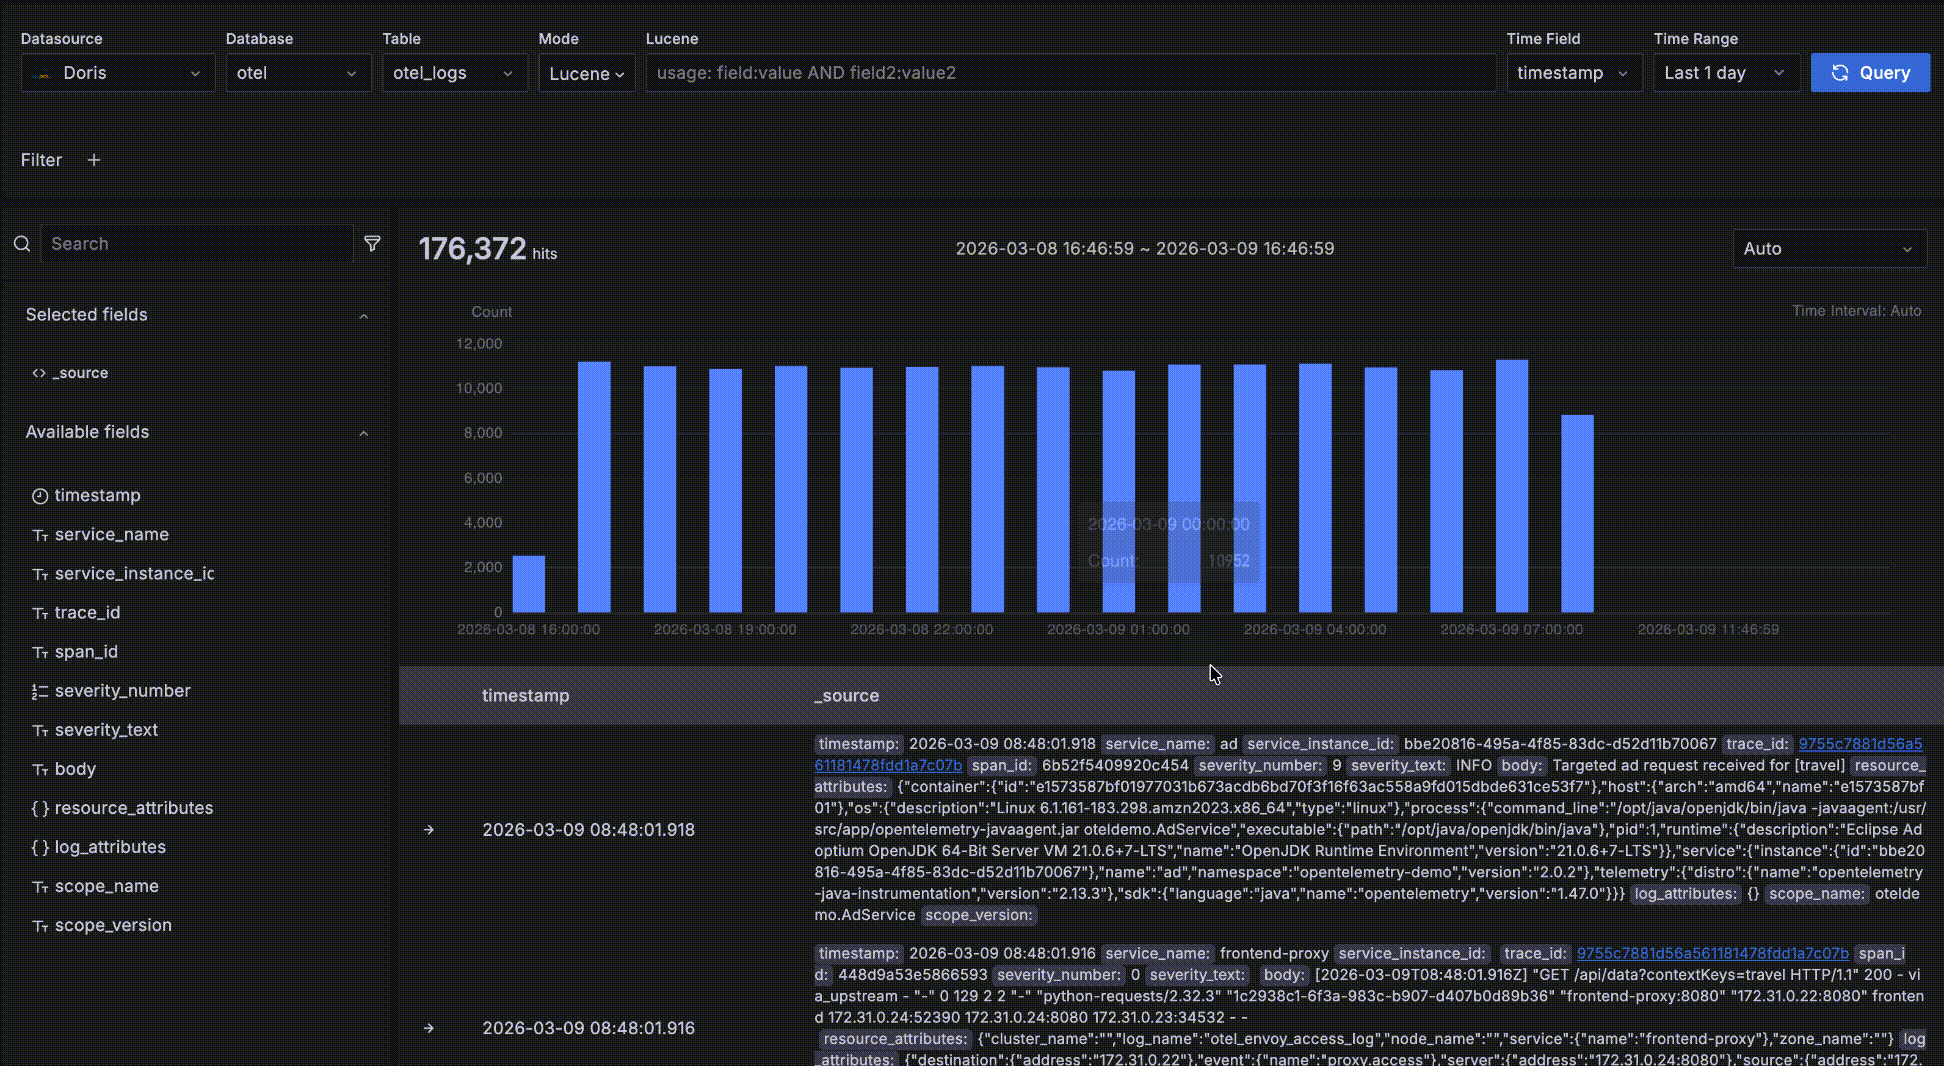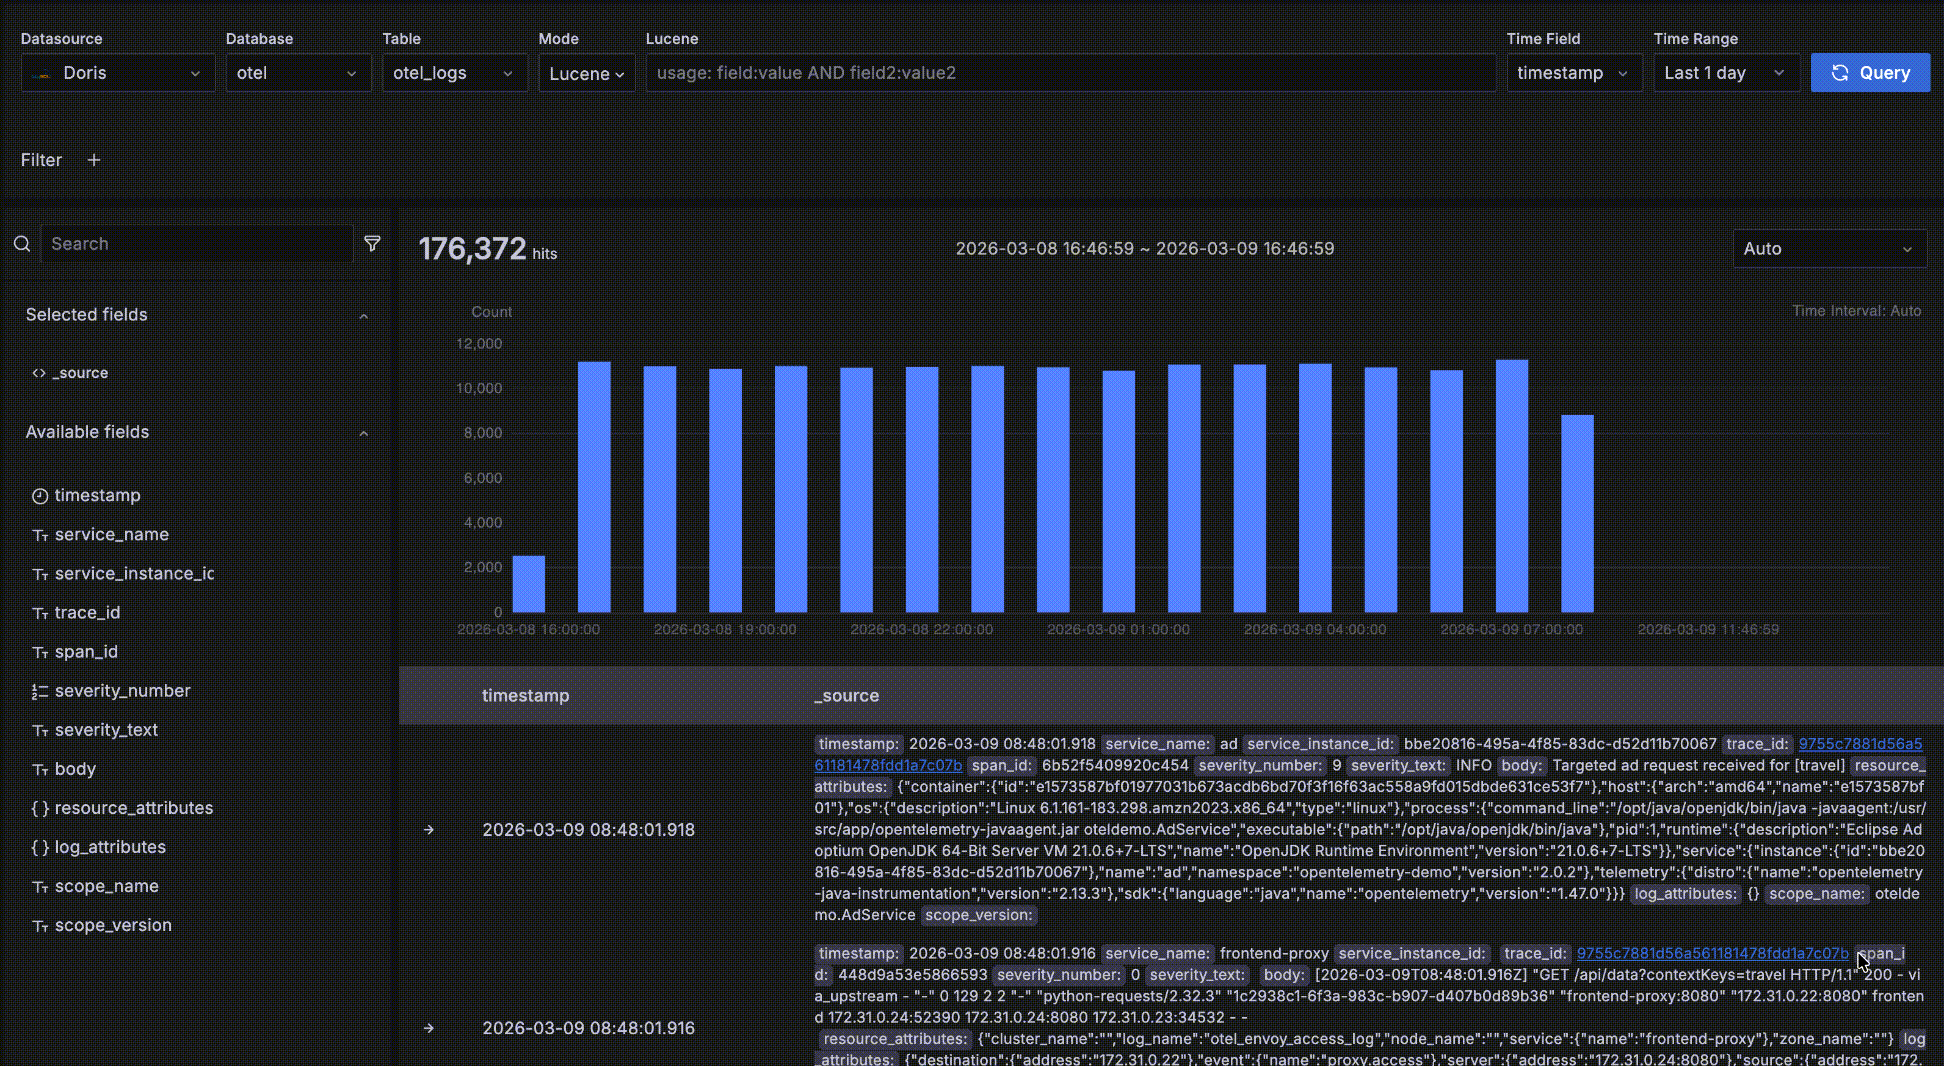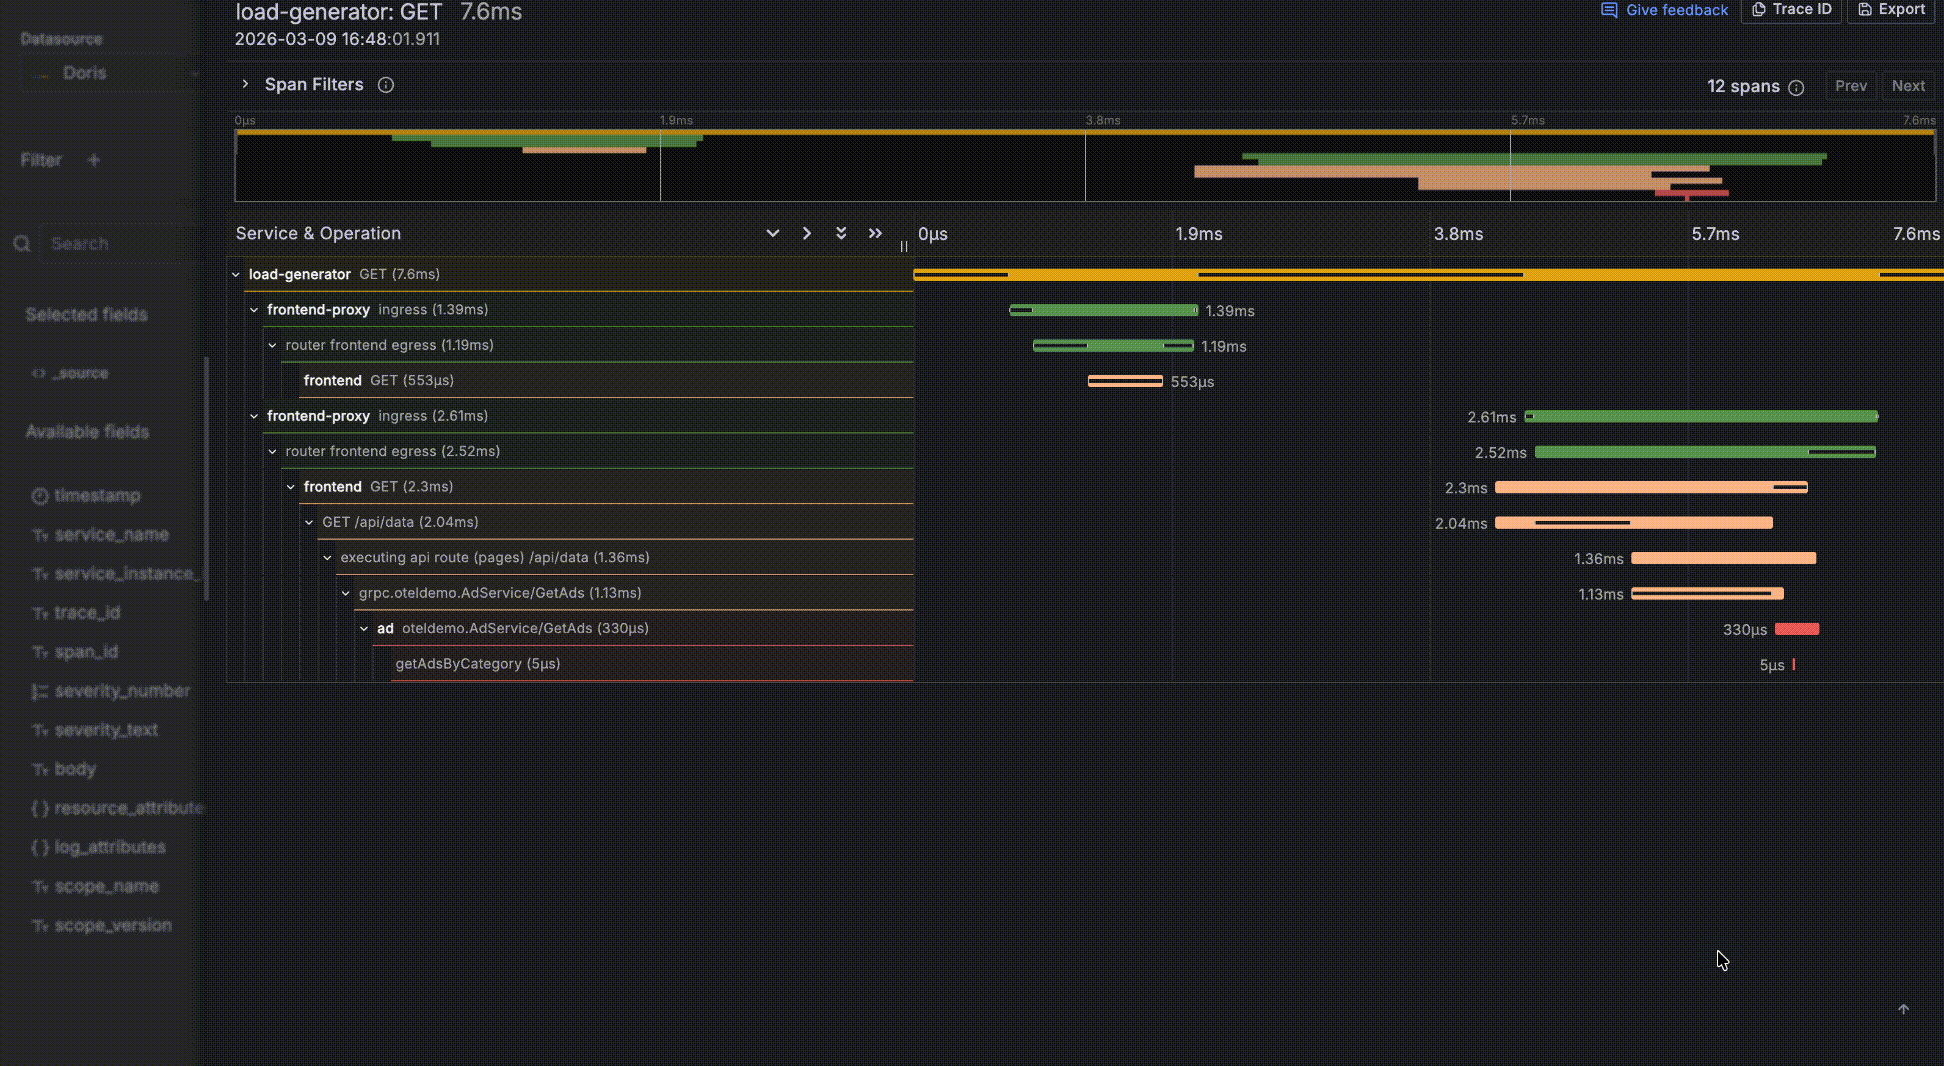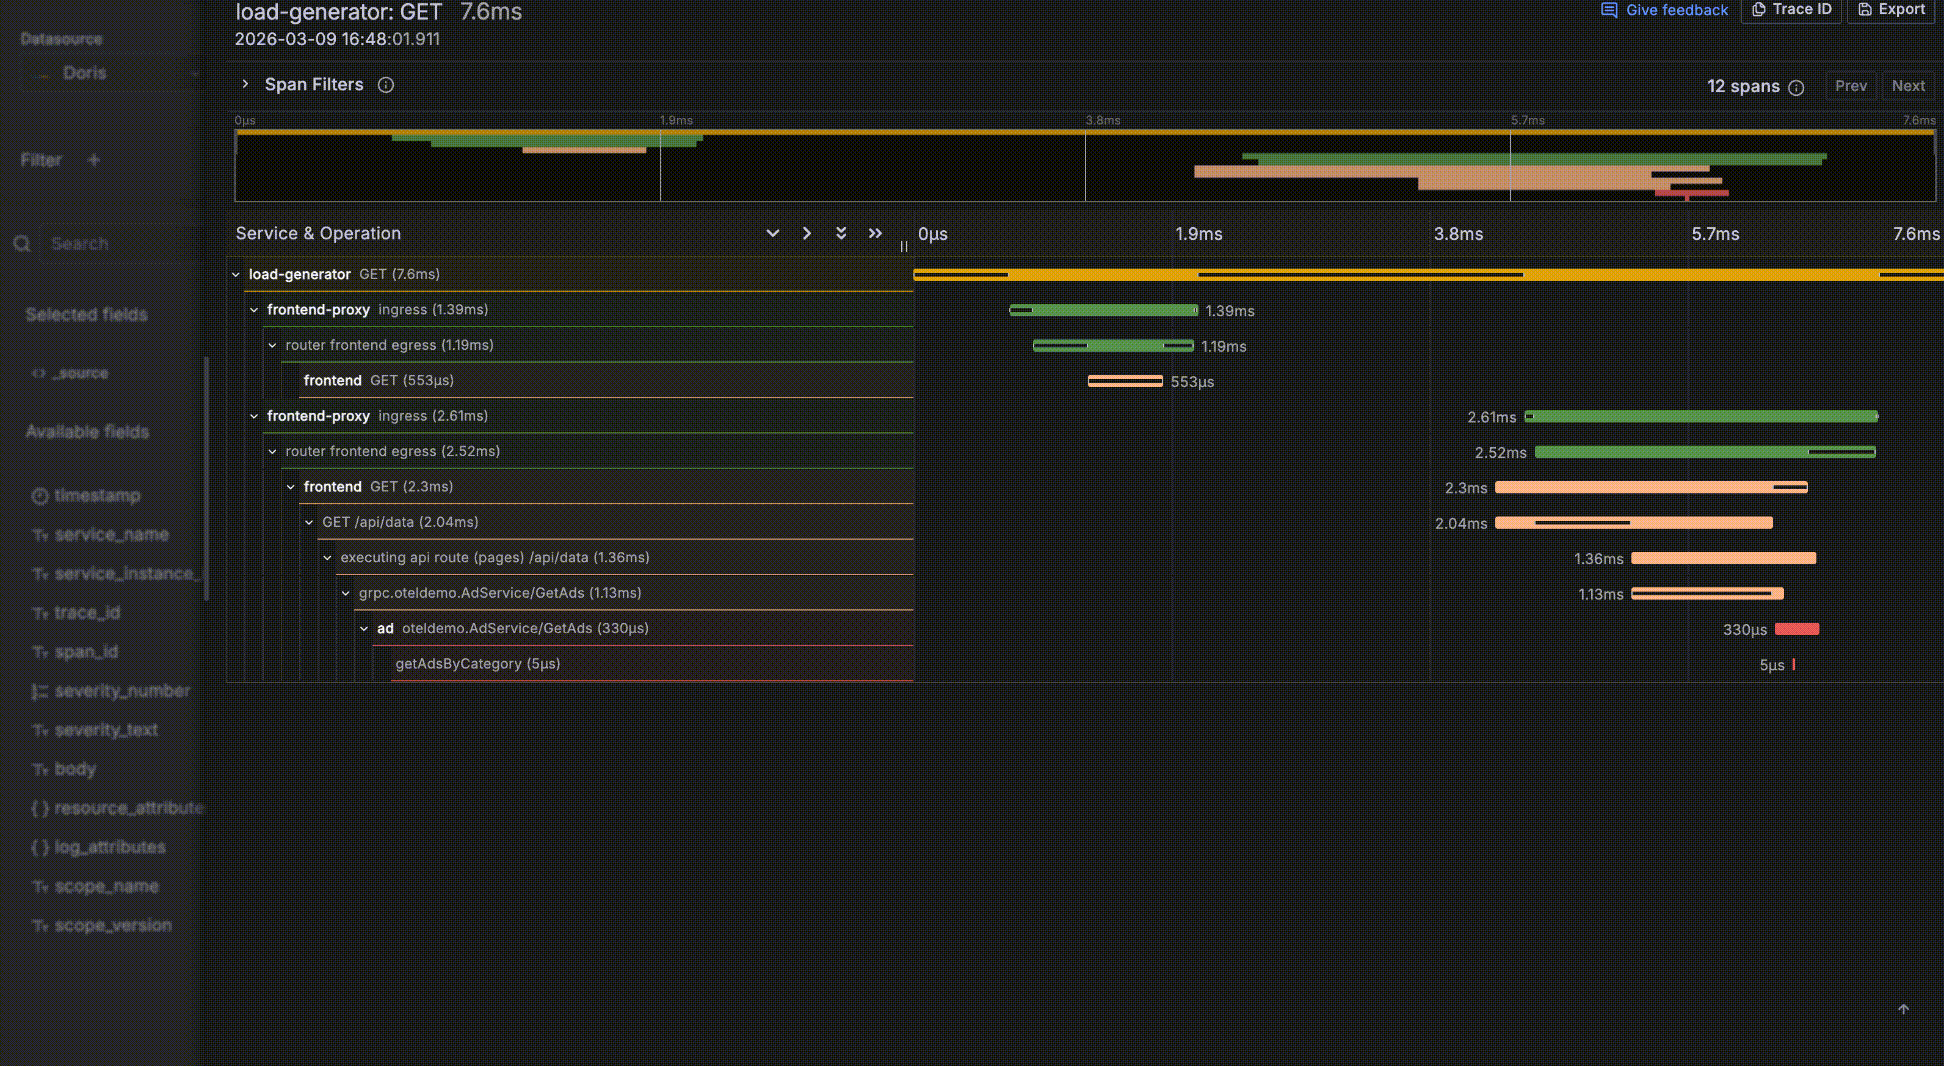
- レコードに
trace_idフィールドがある場合、関連するトレースとして認識されます。その値はクリック可能なリンクになり、クリックするとログとトレースを関連付けて確認できるトレースのウォーターフォール表示ドロワーが開きます。
フィールドブラウザー
左側のフィールドブラウザーでは、現在のテーブルのフィールドを確認し、値の分布を分析できます。
- フィールドの右側にある「+」をクリックすると、そのフィールドを詳細データテーブルに追加できます。
- フィールド名をクリックすると、出現頻度の高い上位 5 件の値を確認できます。値の横にある「+」または「-」をクリックすると、フィルター条件を動的に追加できます。