ログの保存と分析
ログは、イベントの主体、時刻、場所、内容などの重要な情報を含む、システムの動作に関する詳細な記録です。運用時の可観測性、ネットワークセキュリティの監視、ビジネス分析のため、企業は分散したログを一元的に収集、保存、分析し、大量のログから価値を引き出す必要があります。
Apache Doris は、一般的な OLAP 機能に加え、この用途に向けて転置インデックスと高速な全文検索を備え、書き込み性能とストレージ効率を追求しています。Apache Doris を使用すると、オープンで高性能かつ低コストな統合ログ保存・分析プラットフォームを構築できます。
この記事では、このソリューションについて次の内容を説明します。
- 全体アーキテクチャ:Apache Doris を使用したログプラットフォームの主要コンポーネントと基盤となるアーキテクチャ。
- 機能と利点:Elasticsearch と比較した際の特徴。
- 運用ガイド:リソースの見積もりからログのクエリまでの一連の手順。
1. 全体アーキテクチャ
Apache Doris を使用したログ保存・分析プラットフォームのアーキテクチャを次に示します。
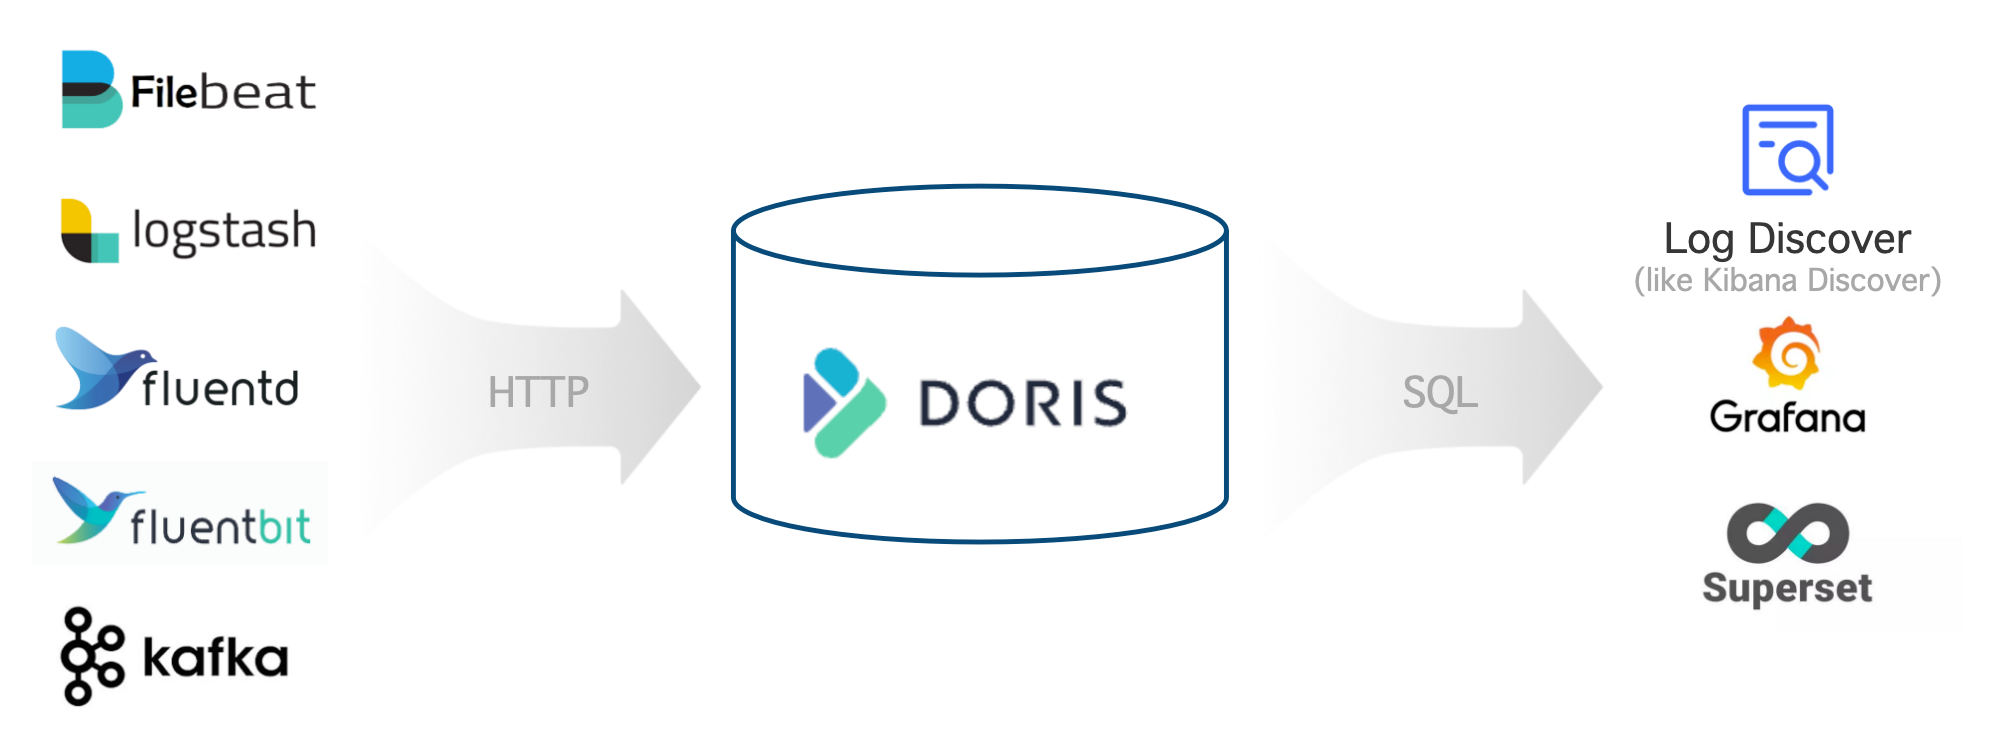
全体アーキテクチャは次の三つの層で構成されます。
| 層 | コンポーネント | 説明 |
|---|---|---|
| ログの収集と前処理 | Logstash、Filebeat、Fluentbit、Kafka など | HTTP API を介して Apache Doris にログデータを書き込む |
| ログの保存と分析 | Apache Doris | 高性能で低コストな統合ストレージと、SQL インターフェースによる多様な検索・分析機能を提供する |
| ログ分析とアラート | Grafana、Superset、Doris WebUI など | 標準の MySQL プロトコルで Doris にクエリを実行し、使いやすい可視化インターフェースを提供する |
2. 機能と利点
Apache Doris を使用したログプラットフォームには、次の主要な機能があります。
| 機能 | 説明 |
|---|---|
| 高スループット・低レイテンシの取り込み | 1 秒未満のレイテンシで、GB/s の速度による日量数百 TB の安定した継続的な取り込みをサポートする |
| 大量データの低コスト保存 | PB 規模の保存に対応し、Elasticsearch と比較してストレージコストを 60%~80% 削減できる。コールドデータを S3/HDFS に階層化すると、さらに 50% 削減できる |
| 高性能な全文検索と分析 | 転置インデックスと全文検索をサポートし、キーワードによる詳細検索や傾向分析などのクエリに秒単位で応答する |
| オープンで使いやすいエコシステム | 上流では Logstash、Filebeat、Fluentbit、Kafka などと連携し、下流では標準の MySQL プロトコルを通じて Grafana、Superset、Doris WebUI と連携する |
2.1 高性能と低コスト
ベンチマークと本番環境での検証によると、Apache Doris を使用したログプラットフォームの費用対効果は Elasticsearch の 5~10 倍です。この利点は主に、高性能なストレージ・クエリエンジンと、ログ用途に特化した最適化によるものです。
- 高い書き込みスループット:Elasticsearch では、データ解析と転置インデックスの構築に使用する CPU が書き込みのボトルネックになります。Apache Doris は SIMD などの CPU ベクトル化命令を使用して JSON の解析とインデックスの構築を高速化します。また、ログ用途では不要な正引きインデックスなどのデータ構造を除去して、転置インデックスの構造を簡素化します。同じリソースを使用した場合、Doris の書き込み性能は Elasticsearch の 3~5 倍です。
- 低いストレージコスト:Elasticsearch では、データの複数のコピー(正引きインデックス、転置インデックス、doc values カラムストア)と、比較的低い全体的な圧縮率が課題です。Doris は正引きインデックスを除去してインデックスデータを 30% 削減し、Zstandard 圧縮アルゴリズムを使用するカラム型ストレージによって 5~10 の圧縮率を実現します。これは Elasticsearch の 1.5 を大きく上回ります。ホット・コールド階層化機能により、過去のログを自動的にオブジェクトストレージへ移動でき、コールドデータのストレージコストを 70% 以上削減できます。ストレージ全体のコストは Elasticsearch の約 20% です。
- 高いクエリ性能:Doris は全文検索の処理を簡素化し、ログ用途では不要な関連度スコアリングなどのアルゴリズムを省きます。「指定したキーワードを含む最新の 100 件のログ」のような典型的なクエリでは、プランニング層と実行層で TopN の動的枝刈りなどの専用の最適化を適用します。
2.2 強力な分析機能
Apache Doris は標準 SQL をサポートし、MySQL プロトコルと構文に互換性があります。そのため、Doris を使用したログシステムには次の利点があります。
- 使いやすさ:エンジニアやデータアナリストは SQL に慣れているため、新しい技術スタックを学ばずにすぐに使い始められます。
- 豊富なエコシステム:MySQL コマンドライン、さまざまな GUI / BI ツール、ビッグデータエコシステムとシームレスに連携し、複雑で多様なデータ処理・分析のニーズに対応します。
- 高い分析能力:SQL はデータ分析の事実上の標準であり、検索、集計、複数テーブルの JOIN、サブクエリ、UDF、論理ビュー、マテリアライズドビューなどをサポートします。
2.3 柔軟なスキーマ
次に、JSON 形式の半構造化ログの典型例を示します。トップレベルのフィールド(timestamp、source、node、component、level、clientRequestId、message、properties)は比較的固定されています。一方、拡張属性 properties の内部にあるネストされたフィールド(properties.size や properties.format など)は変化しやすく、ログごとに異なる場合があります。
{
  "timestamp": "2014-03-08T00:50:03.8432810Z",
  "source": "ADOPTIONCUSTOMERS81",
  "node": "Engine000000000405",
  "level": "Information",
  "component": "DOWNLOADER",
  "clientRequestId": "671db15d-abad-94f6-dd93-b3a2e6000672",
  "message": "Downloading file path: benchmark/2014/ADOPTIONCUSTOMERS81_94_0.parquet.gz",
  "properties": {
    "size": 1495636750,
    "format": "parquet",
    "rowCount": 855138,
    "downloadDuration": "00:01:58.3520561"
  }
}
Apache Doris は、次の二つの仕組みで柔軟なスキーマをサポートします。
- Light Schema Change:トップレベルのフィールドがときどき変わる場合、
ADD/DROP COLUMNやADD/DROP INDEXなどのスキーマ変更を数秒で完了できます。設計時には、その時点でインデックスが必要なフィールドだけを検討すれば済みます。 - VARIANT 半構造化型:
propertiesなどの拡張フィールドには任意の JSON データを書き込めます。フィールド名と型は自動的に検出され、頻出するフィールドはカラム型ストレージに分離されます。VARIANTに転置インデックスを作成して、内部フィールドのクエリや検索を高速化することもできます。
Elasticsearch の dynamic mapping と比較すると、Apache Doris の柔軟なスキーマには次の利点があります。
- 同じフィールドに複数の型を許容します。
VARIANTは型の競合と型の昇格を自動的に処理するため、ログデータの継続的な変化に適応しやすくなります。 VARIANTは出現頻度の低いフィールドを自動的に単一のカラムにまとめ、多数のフィールド、メタデータ、カラムによる性能上の問題を回避します。- カラムやインデックスを動的に追加・削除できます。すべてのフィールドのインデックスを事前に作成する必要がないため、不要なコストを抑えられます。
3. 運用ガイド
次の表に、Apache Doris でログプラットフォームを構築するための六つのステップを示します。
| ステップ | 目的 |
|---|---|
| ステップ 1:リソースを見積もる | FE/BE ノード数、ディスク容量、オブジェクトストレージのサイズを見積もる |
| ステップ 2:クラスタをデプロイする | 物理マシンまたは仮想マシンに Apache Doris をデプロイする |
| ステップ 3:FE と BE の設定を調整する | ログ用途に合わせて主要なパラメータを調整する |
| ステップ 4:テーブルを作成する | パーティションとバケット、圧縮、コンパクション、インデックス、階層化ポリシーを設計する |
| ステップ 5:ログを収集する | Logstash、Filebeat、Kafka、または独自のプログラムと連携する |
| ステップ 6:ログをクエリ・分析する | SQL と可視化ツールを使用してログを検索・分析する |
3.1 リソースを見積もる
クラスタをデプロイする前に、サーバーのハードウェアリソースを見積もる必要があります。主な手順は次のとおりです。
-
次の式で書き込みリソースを見積もります。
Average write throughput = Daily incremental data / 86400 sPeak write throughput = Average write throughput * Peak-to-average write ratioCPU cores required for peak writes = Peak write throughput / Per-core write throughput
-
次の式でストレージリソースを見積もります。
Required storage = Daily incremental data / Compression ratio * Replica count * Data retention period
-
クエリリソースを見積もります:クエリのリソース消費量は、クエリの件数と複雑さによって異なります。初期の見積もりでは CPU リソースの 50% をクエリ用に確保し、実際のテスト結果に基づいて調整します。
-
リソースを集計します:手順 1 と 3 から必要な CPU コア数を見積もり、マシンごとの CPU コア数で割って BE サーバーの台数を求めます。これと手順 2 の結果から各 BE サーバーに必要なストレージを見積もり、4~12 台のデータディスクに分散して各ディスクの容量を算出します。
例:日量 100 TB の新規ログに必要なリソースの見積もり
圧縮前の新規データが日量 100 TB、圧縮率が 5、レプリカ数が 1、ホットデータの保持期間が 3 日、コールドデータの保持期間が 30 日、書き込みのピーク対平均比が 200%、CPU コアごとの書き込みスループットが 10 MB/s、CPU の 50% をクエリ用に確保する場合を考えます。見積もりは次のとおりです。
- FE:3 台のサーバー。それぞれ 16 CPU コア、64 GB のメモリ、100 GB の SSD を一台搭載
- BE:15 台のサーバー。それぞれ 32 CPU コア、256 GB のメモリ、600 GB の SSD を十台搭載
- S3 オブジェクトストレージ:コールドデータ用に 600 TB
主な指標の値と計算方法を次に示します。
| 主な指標(単位) | 値 | 説明 |
|---|---|---|
| 日次増分データ(TB) | 100 | 実際の要件に応じて入力 |
| 圧縮率 | 5 | 通常は 3~10(インデックスを含む)。実際の要件に応じて入力 |
| レプリカ数 | 1 | 実際の要件に応じて入力。デフォルトは 1。設定可能な値は 1、2、3 |
| ホットデータの保持期間(日) | 3 | 実際の要件に応じて入力 |
| コールドデータの保持期間(日) | 30 | 実際の要件に応じて入力 |
| 合計保持期間(日) | 33 | 計算式:Hot data retention + Cold data retention |
| ホットデータの推定ストレージ容量(TB) | 60 | 計算式:Daily incremental data / Compression ratio * Replica count * Hot data retention |
| コールドデータの推定ストレージ容量(TB) | 600 | 計算式:Daily incremental data / Compression ratio * Replica count * Cold data retention |
| 書き込みのピーク対平均比 | 200% | 実際の要件に応じて入力。デフォルトは 200% |
| マシンごとの CPU コア数 | 32 | 実際の要件に応じて入力。デフォルトは 32 コア |
| 平均書き込みスループット(MB/s) | 1214 | 計算式:Daily incremental data / 86400 s |
| ピーク時の書き込みスループット(MB/s) | 2427 | 計算式:Average write throughput * Peak-to-average write ratio |
| ピーク時の書き込みに必要な CPU コア数 | 242.7 | 計算式:Peak write throughput / Per-core write throughput |
| クエリ用に確保する CPU | 50% | 実際の要件に応じて入力。デフォルトは 50% |
| BE サーバーの推定台数 | 15.2 | 計算式:CPU cores required for peak writes / CPU cores per machine / (1 - CPU reserved for queries) |
| BE サーバーの推定台数(丸め後) | 15 | 計算式:MAX(Replica count, rounded estimated number of BE servers) |
| BE サーバーごとの推定ストレージ容量(TB) | 5.7 | 計算式:Estimated hot-data storage / Estimated number of BE servers / (1 - 30%)。30% はストレージの予備容量。I/O 能力を高めるため、各 BE に 4~12 台のデータディスクをマウントすることを推奨 |
3.2 クラスタをデプロイする
リソースの見積もり後、Apache Doris クラスタをデプロイします。物理マシンまたは仮想マシンへのデプロイを推奨します。手動デプロイの手順については、手動デプロイを参照してください。
3.3 FE と BE の設定を調整する
クラスタのデプロイ後、ログの保存・分析に適するよう、FE と BE のパラメータをそれぞれ調整します。
3.3.1 FE の設定を調整する
fe/conf/fe.conf で、次の表に従って FE の設定を調整します。
| 調整するパラメータ | 説明 |
|---|---|
max_running_txn_num_per_db = 10000 | 高並行度の取り込みでは実行中のトランザクションが多いため、このパラメータを引き上げる |
streaming_label_keep_max_second = 3600label_keep_max_second = 7200 | 頻繁な取り込みによるトランザクションラベルは多くのメモリを消費するため、保持時間を短縮する |
enable_round_robin_create_tablet = true | タブレット作成時にラウンドロビン方式を使用し、分布をできるだけ均等にする |
tablet_rebalancer_type = partition | バランシング時に各パーティション内のタブレット数をできるだけ均等にする方式を使用する |
autobucket_min_buckets = 10 | ログ量が増えたときにバケット数が不足しないよう、最小の自動バケット数を 1 から 10 に引き上げる |
max_backend_heartbeat_failure_tolerance_count = 10 | ログ用途では BE サーバーへの負荷が高く、一時的にハートビートが欠落する場合があるため、許容回数を 1 から 10 に引き上げる |
各パラメータの詳細については、FE の設定を参照してください。
3.3.2 BE の設定を調整する
be/conf/be.conf で、次の表に従って BE の設定を調整します。
| モジュール | 調整するパラメータ | 説明 |
|---|---|---|
| ストレージ | storage_root_path = /path/to/dir1;/path/to/dir2;...;/path/to/dir12 | ディスク上のホットデータ用ディレクトリをストレージパスとして設定する |
| ストレージ | enable_file_cache = true | ファイルキャッシュを有効にする |
| ストレージ | file_cache_path = [{"path": "/mnt/datadisk0/file_cache", "total_size":53687091200, "query_limit": "10737418240"},{"path": "/mnt/datadisk1/file_cache", "total_size":53687091200,"query_limit": "10737418240"}] | コールドデータ用キャッシュのパスと設定を指定する:path:キャッシュパスtotal_size:キャッシュパスの合計サイズ(バイト)。53687091200 バイト = 50 GBquery_limit:単一のクエリがキャッシュパスから読み取れる最大データ量(バイト)。10737418240 バイト = 10 GB |
| 書き込み | write_buffer_size = 1073741824 | 書き込みバッファファイルのサイズを増やし、小さいファイルとランダム I/O を減らして性能を向上させる |
| コンパクション | max_cumu_compaction_threads = 8 | CPU コア数を 4 で割った値に設定する。CPU の 1/4 を書き込み、1/4 をバックグラウンドのコンパクションに使用し、1/2 をクエリなどに確保する |
| コンパクション | inverted_index_compaction_enable = true | インデックスのコンパクションを有効にし、コンパクション時の CPU 消費を減らす |
| コンパクション | enable_segcompaction = falseenable_ordered_data_compaction = false | ログ用途で不要な二つのコンパクション機能を無効にする |
| コンパクション | enable_compaction_priority_scheduling = false | 優先度の低いコンパクションはディスクあたり 2 タスクに制限され、コンパクション速度が低下するため無効にする |
| コンパクション | total_permits_for_compaction_score = 200000 | メモリの制御に使用する。時系列ポリシー自体でもメモリを制御できる |
| キャッシュ | disable_storage_page_cache = trueinverted_index_searcher_cache_limit = 30% | ログデータは大量にあるため、データキャッシュの効果は限定的。データキャッシュを無効にし、代わりにインデックスキャッシュを使用する |
| キャッシュ | inverted_index_cache_stale_sweep_time_sec = 3600index_cache_entry_stay_time_after_lookup_s = 3600 | インデックスキャッシュを最長一時間メモリに保持する |
| キャッシュ | enable_inverted_index_cache_on_cooldown = trueenable_write_index_searcher_cache = false | コールドストレージへのアップロード時にインデックスの自動キャッシュを有効にする |
| キャッシュ | tablet_schema_cache_recycle_interval = 3600segment_cache_capacity = 20000 | ほかのキャッシュが使用するメモリを減らす |
| キャッシュ | inverted_index_ram_dir_enable = true | 書き込み中にインデックスの一時ファイルが生む I/O オーバーヘッドを減らす |
| スレッド | pipeline_executor_size = 24doris_scanner_thread_pool_thread_num = 48 | 32 コア CPU 向けの計算・I/O スレッド設定。コア数に応じて比例的に増減させる |
| スレッド | scan_thread_nice_value = 5 | クエリ I/O スレッドの優先度を下げ、書き込み性能と適時性を確保する |
| その他 | string_type_length_soft_limit_bytes = 10485760 | String データの長さ制限を 10 MB に引き上げる |
| その他 | trash_file_expire_time_sec = 300path_gc_check_interval_second = 900path_scan_interval_second = 900 | 不要ファイルの回収を速める |
各パラメータの詳細については、BE の設定を参照してください。
3.4 テーブルを作成する
ログデータの書き込みとクエリにはそれぞれ特有の性質があります。性能を高めるため、テーブル作成時には以下の各節に示す設定を適用してください。
3.4.1 パーティションとバケットのパラメータを設定する
パーティション:
- 時刻フィールドに範囲パーティション(
PARTITION BY RANGE(ts))を使用し、動的パーティション("dynamic_partition.enable" = "true")を有効にして日次パーティションを自動管理します。 Datetime型の時刻フィールドをキー(DUPLICATE KEY(ts))に使用します。これにより、最新の N 件のログをクエリする際に数倍の高速化が得られます。
バケット:
- バケット数はクラスタ内のディスク総数の約 3 倍とし、各バケットの圧縮後データ量を約 5 GB にします。
- ランダム方式(
DISTRIBUTED BY RANDOM BUCKETS 60)と、書き込み時の単一タブレットへの取り込みを組み合わせ、バッチ書き込みの効率を高めます。
パーティションとバケットの詳細については、データパーティションを参照してください。
3.4.2 圧縮パラメータを設定する
- データの圧縮率を高めるため、Zstd 圧縮アルゴリズム(
"compression" = "zstd")を使用します。
3.4.3 コンパクションのパラメータを設定する
- 時系列ポリシー(
"compaction_policy" = "time_series")を使用して書き込み増幅を抑えます。これは、高スループットのログ書き込みに必要なリソース量を抑えるうえで重要です。
3.4.4 インデックスを作成・設定する
- 頻繁にクエリするフィールドにインデックスを作成します(
USING INVERTED)。 - 全文検索が必要なフィールドでは、トークナイザーのパラメータ(
parser)を、ほとんどの用途に適したunicodeに設定します。フレーズ検索をサポートするにはsupport_phraseをtrueに設定し、不要な場合はfalseにしてストレージ使用量を減らします。
3.4.5 ストレージポリシーを設定する
- ホットデータの保存:クラウドディスクを使用する場合はレプリカ数を 1 に設定できます。物理ディスクを使用する場合は、少なくとも 2 レプリカ(
"replication_num" = "2")を設定します。 - ホット・コールド階層化:
log_s3ストレージロケーション(CREATE RESOURCE "log_s3")を設定し、log_policy_3day階層化ポリシー(CREATE STORAGE POLICY log_policy_3day)を設定します。これにより、3 日を経過したデータは、log_s3で指定したストレージロケーションに自動的に移動されます。
3.4.6 テーブル作成の完全な例
CREATE DATABASE log_db;
USE log_db;

CREATE RESOURCE "log_s3"
PROPERTIES
(
    "type" = "s3",
    "s3.endpoint" = "your_endpoint_url",
    "s3.region" = "your_region",
    "s3.bucket" = "your_bucket",
    "s3.root.path" = "your_path",
    "s3.access_key" = "your_ak",
    "s3.secret_key" = "your_sk"
);

CREATE STORAGE POLICY log_policy_3day
PROPERTIES(
    "storage_resource" = "log_s3",
    "cooldown_ttl" = "259200"
);

CREATE TABLE log_table
(
  `ts` DATETIME,
  `host` TEXT,
  `path` TEXT,
  `message` TEXT,
  INDEX idx_host (`host`) USING INVERTED,
  INDEX idx_path (`path`) USING INVERTED,
  INDEX idx_message (`message`) USING INVERTED PROPERTIES("parser" = "unicode", "support_phrase" = "true")
)
ENGINE = OLAP
DUPLICATE KEY(`ts`)
PARTITION BY RANGE(`ts`) ()
DISTRIBUTED BY RANDOM BUCKETS 60
PROPERTIES (
  "compression" = "zstd",
  "compaction_policy" = "time_series",
  "dynamic_partition.enable" = "true",
  "dynamic_partition.create_history_partition" = "true",
  "dynamic_partition.time_unit" = "DAY",
  "dynamic_partition.start" = "-30",
  "dynamic_partition.end" = "1",
  "dynamic_partition.prefix" = "p",
  "dynamic_partition.buckets" = "60",
  "dynamic_partition.replication_num" = "2", -- Not needed in compute-storage separation
  "replication_num" = "2",                    -- Not needed in compute-storage separation
  "storage_policy" = "log_policy_3day"        -- Not needed in compute-storage separation
);
3.5 ログを収集する
テーブルを作成したら、ログの収集を開始できます。Apache Doris は、Logstash、Filebeat、Kafka などの一般的なログコレクターと連携できる、オープンで汎用的な Stream HTTP API を提供します。次の表に、各収集方法が適した用途を示します。
| 収集方法 | 適した用途 |
|---|---|
| Logstash | 豊富なフィルターとプラグインのエコシステムを必要とする既存の Logstash パイプライン |
| Filebeat | リソースが限られる環境での軽量なファイル収集 |
| Kafka Routine Load | ログがすでに Kafka に格納されており、Doris から能動的に取得する場合 |
| 独自プログラム(Stream Load) | 社内の収集プログラムや特殊なデータソースとの連携 |
3.5.1 Logstash と連携する
次の手順に従います。
-
Logstash Doris Output プラグインをダウンロードしてインストールします。次のいずれかの方法を選択してください。
-
直接ダウンロード:こちらからダウンロードします。
-
ソースからビルドし、次のコマンドでインストールします。
./bin/logstash-plugin install logstash-output-doris-1.2.0.gem
-
-
Logstash を設定します。次の二つのファイルが必要です。
-
logstash.yml:ログをバッチ処理する際のバッチサイズと待機時間を設定し、書き込み性能を高めます。pipeline.batch.size: 1000000
pipeline.batch.delay: 10000 -
logstash_demo.conf:収集するログの入力パスと、Apache Doris への出力設定を指定します。input {
file {
path => "/path/to/your/log"
}
}
output {
doris {
http_hosts => [ "<http://fehost1:http_port>", "<http://fehost2:http_port>", "<http://fehost3:http_port>" ]
user => "your_username"
password => "your_password"
db => "your_db"
table => "your_table"
# doris stream load http headers
headers => {
"format" => "json"
"read_json_by_line" => "true"
"load_to_single_tablet" => "true"
}
# field mapping: doris field name => logstash field name
# %{} to get a logstash field, [] for nested field such as [host][name] for host.name
mapping => {
"ts" => "%{@timestamp}"
"host" => "%{[host][name]}"
"path" => "%{[log][file][path]}"
"message" => "%{message}"
}
log_request => true
log_speed_interval => 10
}
}
-
-
Logstash を実行してログを収集し、Apache Doris に出力します。
./bin/logstash -f logstash_demo.conf
設定の詳細については、Logstash Doris Output プラグインを参照してください。
3.5.2 Filebeat と連携する
次の手順に従います。
-
Apache Doris への出力をサポートする Filebeat のバイナリを入手します。こちらからダウンロードするか、Apache Doris のソースからビルドできます。
-
Filebeat を設定します。主なファイルは
filebeat_demo.ymlで、収集するログの入力パスと Apache Doris への出力設定を指定します。# input
filebeat.inputs:
- type: log
enabled: true
paths:
- /path/to/your/log
# multiline can join lines that span multiple lines (such as Java stack traces) into a single log
multiline:
type: pattern
# Behavior: lines starting with yyyy-mm-dd HH:MM:SS are treated as a new log; others are appended to the previous log
pattern: '^[0-9]{4}-[0-9]{2}-[0-9]{2} [0-9]{2}:[0-9]{2}:[0-9]{2}'
negate: true
match: after
skip_newline: true
processors:
# Use the js script plugin to replace \t in the log with spaces, to avoid JSON parsing errors
- script:
lang: javascript
source: >
function process(event) {
var msg = event.Get("message");
msg = msg.replace(/\t/g, " ");
event.Put("message", msg);
}
# Use the dissect plugin for simple log parsing
- dissect:
# 2024-06-08 18:26:25,481 INFO (report-thread|199) [ReportHandler.cpuReport():617] begin to handle
tokenizer: "%{day} %{time} %{log_level} (%{thread}) [%{position}] %{content}"
target_prefix: ""
ignore_failure: true
overwrite_keys: true
# queue and batch
queue.mem:
events: 1000000
flush.min_events: 100000
flush.timeout: 10s
# output
output.doris:
fenodes: [ "http://fehost1:http_port", "http://fehost2:http_port", "http://fehost3:http_port" ]
user: "your_username"
password: "your_password"
database: "your_db"
table: "your_table"
# output string format
## %{[agent][hostname]} %{[log][file][path]} are metadata that come with filebeat
## Another commonly used filebeat metadata is the collection timestamp %{[@timestamp]}
## %{[day]} %{[time]} are the fields parsed by the dissect step above
codec_format_string: '{"ts": "%{[day]} %{[time]}", "host": "%{[agent][hostname]}", "path": "%{[log][file][path]}", "message": "%{[message]}"}'
headers:
format: "json"
read_json_by_line: "true"
load_to_single_tablet: "true" -
Filebeat を実行してログを収集し、Apache Doris に出力します。
chmod +x filebeat-doris-2.1.1
./filebeat-doris-2.1.1 -c filebeat_demo.yml
設定の詳細については、Beats Doris Output プラグインを参照してください。
3.5.3 Kafka と連携する
JSON 形式のログを Kafka のメッセージキューに書き込み、Kafka Routine Load を作成して Apache Doris から Kafka のデータを能動的に取得します。
次の例を参照してください。property.* は Librdkafka クライアントの設定です。実際の Kafka クラスタに合わせて調整してください。
-- Prepare the kafka cluster and topic log__topic_
-- Create a routine load that imports data from kafka log__topic_ into the log_table table
CREATE ROUTINE LOAD load_log_kafka ON log_db.log_table
COLUMNS(ts, host, path, message)
PROPERTIES (
"max_batch_interval" = "60",
"max_batch_rows" = "20000000",
"max_batch_size" = "1073741824",
"load_to_single_tablet" = "true",
"format" = "json"
)
FROM KAFKA (
"kafka_broker_list" = "host:port",
"kafka_topic" = "log__topic_",
"property.group.id" = "your_group_id",
"property.security.protocol"="SASL_PLAINTEXT",
"property.sasl.mechanism"="GSSAPI",
"property.sasl.kerberos.service.name"="kafka",
"property.sasl.kerberos.keytab"="/path/to/xxx.keytab",
"property.sasl.kerberos.principal"="<xxx@yyy.com>"
);
-- Check the status of the routine load
SHOW ROUTINE LOAD;
Kafka の設定の詳細については、Routine Loadを参照してください。
3.5.4 独自のプログラムでログを収集する
一般的なログコレクターとの連携に加え、独自のプログラムから HTTP API の Stream Load を使用してログをインポートすることもできます。
curl
--location-trusted
-u username:password
-H "format:json"
-H "read_json_by_line:true"
-H "load_to_single_tablet:true"
-H "timeout:600"
-T logfile.json
http://fe_host:fe_http_port/api/log_db/log_table/_stream_load
独自のプログラムを使用する場合は、次の点に注意してください。
- HTTP 認証には Basic Auth を使用します。
echo -n 'username:password' | base64コマンドで値を計算できます。 - HTTP ヘッダーに
format:jsonを設定し、データ形式として JSON を指定します。 - HTTP ヘッダーに
read_json_by_line:trueを設定し、各行に JSON を一件ずつ指定します。 - HTTP ヘッダーに
load_to_single_tablet:trueを設定し、各回の取り込みを単一のバケットに書き込むことで小さいファイルを減らします。 - クライアントは 100 MB~1 GB のバッチを送信することを推奨します。Apache Doris 2.1 以降では、サーバー側の Group Commit 機能を使用すると、クライアント側のバッチサイズを小さくできます。
3.6 ログをクエリ・分析する
3.6.1 ログをクエリする
Apache Doris は標準 SQL をサポートします。MySQL クライアント、JDBC などのツールからクラスタに接続して SQL クエリを実行できます。
mysql -h fe_host -P fe_mysql_port -u your_username -Dyour_db_name
参考として、一般的な SQL クエリを 5 つ示します。
-
最新の 10 件のレコードを表示します。
SELECT * FROM your_table_name ORDER BY ts DESC LIMIT 10; -
hostが8.8.8.8である最新の 10 件のレコードをクエリします。SELECT * FROM your_table_name WHERE host = '8.8.8.8' ORDER BY ts DESC LIMIT 10; -
messageフィールドにerrorまたは404が含まれる最新の 10 件のレコードを検索します。MATCH_ANYは Apache Doris の全文検索用 SQL 構文で、引数内のいずれかのキーワードに一致します。SELECT * FROM your_table_name WHERE message MATCH_ANY 'error 404'
ORDER BY ts DESC LIMIT 10; -
messageフィールドにimageとfaqの両方が含まれる最新の 10 件のレコードを検索します。MATCH_ALLは Apache Doris の全文検索用 SQL 構文で、引数内のすべてのキーワードに一致します。SELECT * FROM your_table_name WHERE message MATCH_ALL 'image faq'
ORDER BY ts DESC LIMIT 10; -
messageフィールドにimageとfaqの両方が同じ順序で含まれる最新の 10 件のレコードを検索します。MATCH_PHRASEは Apache Doris の全文検索用 SQL 構文で、引数内のすべてのキーワードが同じ順序で現れる場合に一致します。たとえば、a image faq bは一致しますが、a faq image bは一致しません。SELECT * FROM your_table_name WHERE message MATCH_PHRASE 'image faq'
ORDER BY ts DESC LIMIT 10;
3.6.2 ログを視覚的に分析する
一部のサードパーティーベンダーは、Apache Doris を基盤とするログ分析プラットフォームを提供しています。Kibana Discover に似たログ検索・分析インターフェースもあり、直感的で使いやすい探索的なログ分析を実現できます。
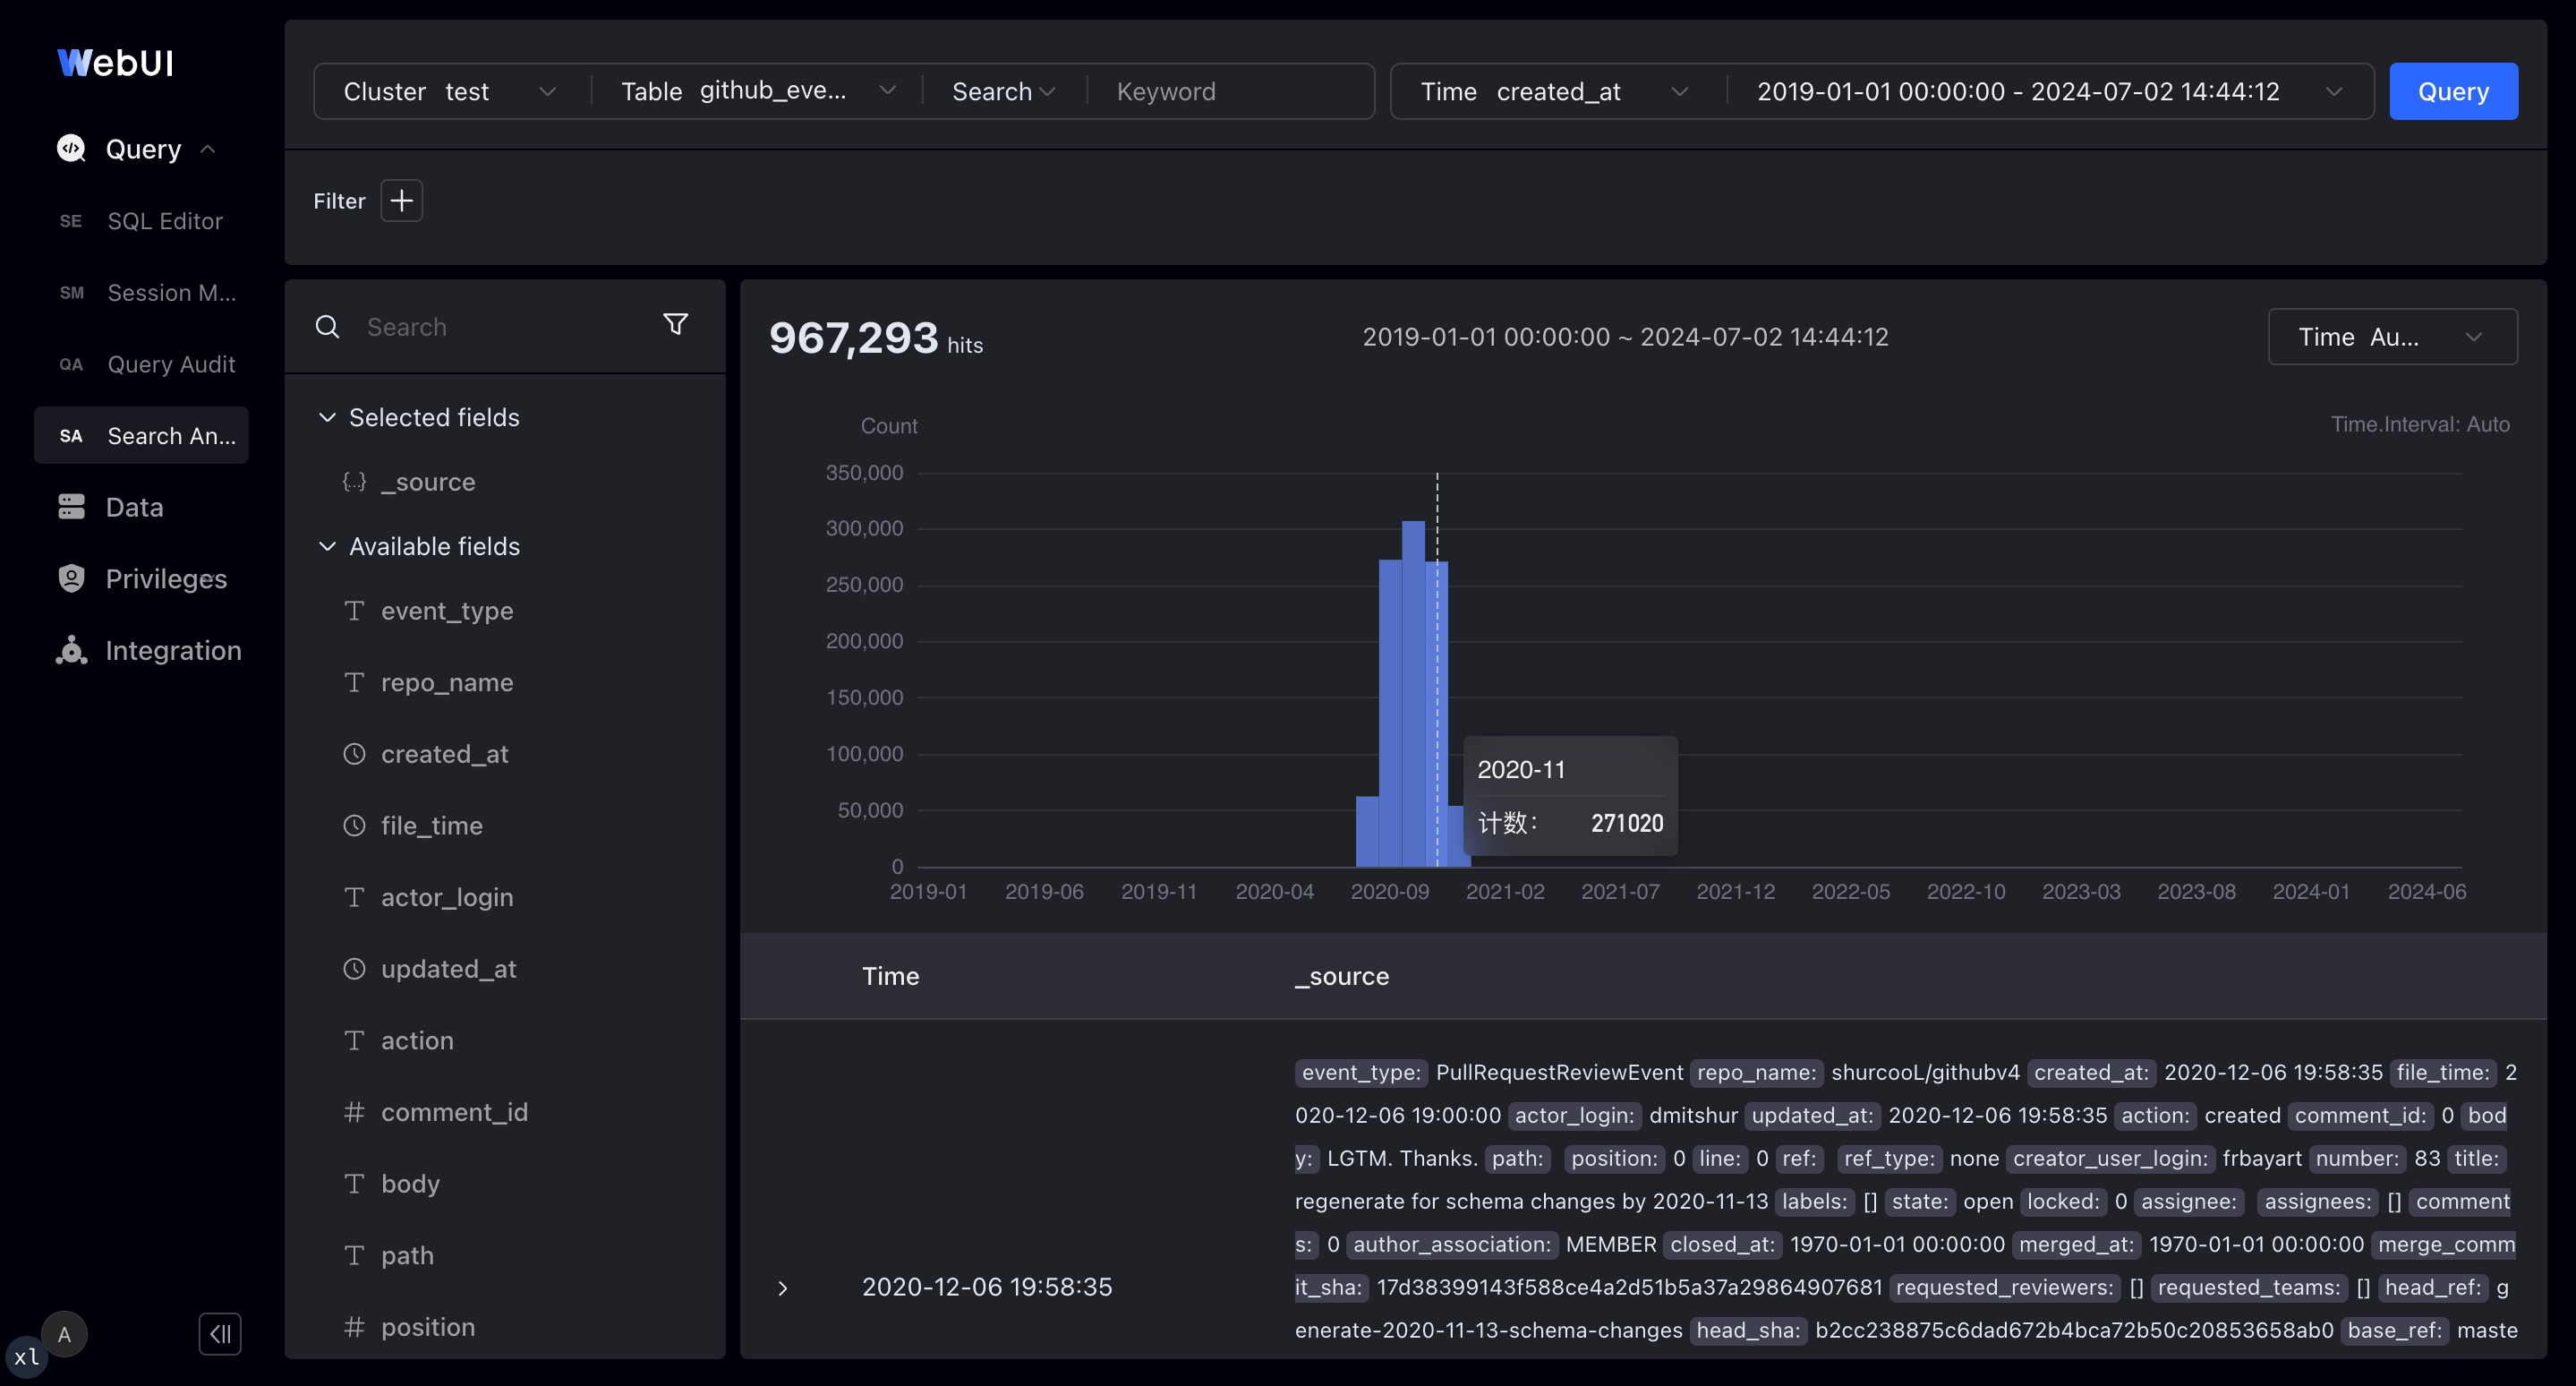
- 全文検索モードと SQL モードの両方をサポート
- 時間選択ツールとヒストグラムでログクエリの時間範囲を選択可能
- JSON や表に展開できる多様なログ詳細表示をサポート
- ログデータのコンテキスト内で、クリック操作によってフィルターを追加・削除可能
- 検索結果の各フィールドで出現頻度の高い値を表示し、異常の発見や詳細分析を支援
さらにサポートが必要な場合は、dev@doris.apache.org にお問い合わせください。
4. よくある質問
Q1:ログ用途における Apache Doris と Elasticsearch の主な違いは何ですか?
A:Doris の書き込みスループットは Elasticsearch の 3~5 倍で、ストレージコストは Elasticsearch の約 20% です。Doris は標準 SQL と MySQL プロトコルにも対応し、より強力な分析機能を提供します。ホット・コールド階層化によってコールドデータを S3/HDFS に移動すれば、ストレージコストをさらに削減できます。
Q2:ログのフィールドが頻繁に変わる場合はどうすればよいですか?
A:トップレベルのフィールドでは Light Schema Change を使用して、ADD/DROP COLUMN や ADD/DROP INDEX を数秒で実行できます。動的なネストされたフィールドには VARIANT 型を使用します。フィールド名と型が自動的に検出され、VARIANT に転置インデックスを作成することもできます。
Q3:バケット数はどのように決めますか?
A:バケット数はクラスタ内のディスク総数の約 3 倍とし、各バケットの圧縮後データ量を約 5 GB にします。DISTRIBUTED BY RANDOM と単一タブレットへの書き込みを組み合わせると、バッチ書き込みの効率が高まります。
Q4:ホット・コールド階層化ポリシーの cooldown_ttl の単位は何ですか?
A:単位は秒です。たとえば 259200 は 3 日を意味し、その期間が過ぎるとデータはストレージポリシーで指定されたオブジェクトストレージのロケーションに自動的に移動されます。
Q5:書き込み側のバッチサイズはどのように決めますか?
A:リクエストあたり 100 MB~1 GB のバッチサイズを推奨します。Apache Doris 2.1 以降では、サーバー側の Group Commit 機能を有効にして、クライアント側のバッチサイズを小さくできます。
5. トラブルシューティング
| 症状 | 考えられる原因 | 推奨される対処 |
|---|---|---|
| 高並行度の取り込みがトランザクション数の上限を超える | max_running_txn_num_per_db のデフォルト値が小さすぎる | max_running_txn_num_per_db = 10000 に引き上げる |
| BE のハートビートが頻繁にタイムアウトする | ログ書き込みの負荷が高く、BE が一時的に応答しなくなる | max_backend_heartbeat_failure_tolerance_count = 10 に引き上げる |
| 書き込み時に小さいファイルやランダム I/O が大量に発生する | 書き込みバッファが小さすぎるか、単一タブレットへの取り込みを使用していない | write_buffer_size = 1073741824 に引き上げ、load_to_single_tablet:true を設定する |
| コンパクションが遅く、書き込みに影響する | コンパクション用スレッドが不足しているか、低優先度のスケジューリングに制限がある | CPU コア数を 4 で割った値を max_cumu_compaction_threads に設定し、enable_compaction_priority_scheduling を無効にする |
| インデックスのメモリ使用量が多すぎる | データキャッシュとインデックスキャッシュがメモリを奪い合っている | disable_storage_page_cache を無効にし、inverted_index_searcher_cache_limit = 30% に制限する |
| 全文検索のフレーズクエリが動作しない | インデックスで support_phrase が有効になっていない | インデックス作成時に "support_phrase" = "true" を設定する |
| 自動バケット設定によるバケット数が少なすぎ、ホットスポットが発生する | autobucket_min_buckets が小さすぎる | autobucket_min_buckets = 10 に引き上げる |