トレースの保存と分析
この記事では、Apache Doris でトレースデータを保存・分析する方法を、テーブルの作成から収集、クエリまで説明します。
クイックナビゲーション
導入は次の三つのステップで進めます。
| ステップ | 内容 | 目的 |
|---|---|---|
| 1. テーブルを作成する | Doris にトレース保存用テーブルを作成する | トレースの書き込みとクエリのパターンに合わせて性能を最適化する |
| 2. 収集する | OpenTelemetry を通じてトレースデータを Doris に書き込む | アプリケーションから Collector を経由して Doris に至るパイプラインを接続する |
| 3. クエリする | Grafana でトレースデータを視覚的に分析する | 検索、レイテンシー分布の表示、トレースの詳細確認を行う |
1. テーブルを作成する
トレースデータには、書き込みとクエリのパターンに明確な特徴があります。テーブル作成時にそれらに合わせて設定すると、性能が向上します。
1.1 主な設定項目
次の表に、テーブル作成時の主な設定項目と推奨事項を示します。
| 設定項目 | 推奨事項 | 説明 |
|---|---|---|
| パーティション | 時間フィールドで RANGE パーティションを作成し、動的パーティションを有効にして日次パーティションを自動管理する | パーティションを自動的に更新し、ホットデータとコールドデータの分離や、期限切れデータの削除を容易にする |
| ソートキー | service_name と DATETIME 型の時間フィールドをキーにする | 特定サービスの指定期間をスキャンするクエリを数倍高速化する |
| バケット数 | クラスター内のディスク総数のおよそ 3 倍にする | 並列度を確保しながら小さなファイルの増加を抑える |
| バケット分割方式 | RANDOM を使用し、書き込み時には単一タブレットへのインポートを組み合わせる | 書き込みをまとめて処理しやすくする |
| コンパクション | time_series コンパクションポリシーを使用する | 書き込み増幅を抑える。これは大量のトレースを書き込む際のリソース最適化に重要 |
| 半構造化フィールド | span_attributes と resource_attributes に VARIANT 型を使用する | JSON をストレージ上のサブカラムに自動分割し、圧縮率とサブカラムのフィルタリング・分析性能を向上させる |
| インデックス | よくクエリするフィールドに転置インデックスを作成する | 等価フィルターと範囲クエリを高速化する |
| 全文検索 | parser パラメーターでトークナイザーを指定し(通常は unicode で十分)、必要に応じて support_phrase を有効にする | support_phrase を有効にするとフレーズクエリが可能になる。不要な場合は無効にしてストレージ容量を節約する |
| レプリカ | クラウドディスクではレプリカを 1 つにできる。物理ディスクでは少なくとも 2 つ使用する | 信頼性とコストのバランスを取る |
| ホット・コールド分離 | log_s3 オブジェクトストレージと log_policy_3day ポリシーを設定する | 3 日を超えたデータを自動的に S3 に移動し、ホットストレージのコストを削減する |
1.2 テーブル作成 SQL の例
次の例は、リソース、ストレージポリシー、テーブルを作成する一連の手順です。
CREATE DATABASE log_db;
USE log_db;

-- Not required in the storage-compute decoupled mode
CREATE RESOURCE "log_s3"
PROPERTIES
(
    "type" = "s3",
    "s3.endpoint" = "your_endpoint_url",
    "s3.region" = "your_region",
    "s3.bucket" = "your_bucket",
    "s3.root.path" = "your_path",
    "s3.access_key" = "your_ak",
    "s3.secret_key" = "your_sk"
);

-- Not required in the storage-compute decoupled mode
CREATE STORAGE POLICY log_policy_3day
PROPERTIES(
    "storage_resource" = "log_s3",
    "cooldown_ttl" = "259200"
);

CREATE TABLE trace_table
(
    service_name          VARCHAR(200),
    timestamp             DATETIME(6),
    service_instance_id   VARCHAR(200),
    trace_id              VARCHAR(200),
    span_id               STRING,
    trace_state           STRING,
    parent_span_id        STRING,
    span_name             STRING,
    span_kind             STRING,
    end_time              DATETIME(6),
    duration              BIGINT,
    span_attributes       VARIANT,
    events                ARRAY<STRUCT<timestamp:DATETIME(6), name:STRING, attributes:MAP<STRING, STRING>>>,
    links                 ARRAY<STRUCT<trace_id:STRING, span_id:STRING, trace_state:STRING, attributes:MAP<STRING, STRING>>>,
    status_message        STRING,
    status_code           STRING,
    resource_attributes   VARIANT,
    scope_name            STRING,
    scope_version         STRING,
    INDEX idx_timestamp(timestamp) USING INVERTED,
    INDEX idx_service_instance_id(service_instance_id) USING INVERTED,
    INDEX idx_trace_id(trace_id) USING INVERTED,
    INDEX idx_span_id(span_id) USING INVERTED,
    INDEX idx_trace_state(trace_state) USING INVERTED,
    INDEX idx_parent_span_id(parent_span_id) USING INVERTED,
    INDEX idx_span_name(span_name) USING INVERTED,
    INDEX idx_span_kind(span_kind) USING INVERTED,
    INDEX idx_end_time(end_time) USING INVERTED,
    INDEX idx_duration(duration) USING INVERTED,
    INDEX idx_span_attributes(span_attributes) USING INVERTED,
    INDEX idx_status_message(status_message) USING INVERTED,
    INDEX idx_status_code(status_code) USING INVERTED,
    INDEX idx_resource_attributes(resource_attributes) USING INVERTED,
    INDEX idx_scope_name(scope_name) USING INVERTED,
    INDEX idx_scope_version(scope_version) USING INVERTED
)
ENGINE = OLAP
DUPLICATE KEY(service_name, timestamp)
PARTITION BY RANGE(timestamp) ()
DISTRIBUTED BY RANDOM BUCKETS 250
PROPERTIES (
"compression" = "zstd",
"compaction_policy" = "time_series",
"inverted_index_storage_format" = "V2",
"dynamic_partition.enable" = "true",
"dynamic_partition.create_history_partition" = "true",
"dynamic_partition.time_unit" = "DAY",
"dynamic_partition.start" = "-30",
"dynamic_partition.end" = "1",
"dynamic_partition.prefix" = "p",
"dynamic_partition.buckets" = "250",
"dynamic_partition.replication_num" = "2", -- Not required in storage-compute decoupled mode
"replication_num" = "2", -- Not required in storage-compute decoupled mode
"storage_policy" = "log_policy_3day" -- Not required in storage-compute decoupled mode
);
2. トレースの収集
Doris は、OpenTelemetry などのトレース収集システムと連携できる、オープンで汎用的な Stream HTTP API を提供します。
2.1 パイプライン全体
アプリケーション → OpenTelemetry SDK/Agent → OpenTelemetry Collector(Doris Exporter を含む)→ Doris テーブル、という流れです。
2.2 OpenTelemetry との連携手順
ステップ 1: アプリケーションに OpenTelemetry SDK を組み込む
この例では、OpenTelemetry Java SDK を組み込んだ公式の Spring Boot デモを使用します。このデモが返す文字列は Hello World! で、対象のパスは / です。
OpenTelemetry Java Agent をダウンロードします。Java Agent を使用すると、既存のアプリケーションのコードを変更せずに済みます。
他の言語や連携方法については、次を参照してください。
ステップ 2: OpenTelemetry Collector をデプロイ・設定する
OpenTelemetry Collector をダウンロードして展開します。
名前が
otelcol-contribで始まるリリースパッケージをダウンロードしてください。トレースデータを Doris にインポートできる Doris Exporter コンポーネントが含まれています。
次の内容で設定ファイル otel_demo.yaml を作成します。その他の設定オプションについては、Doris Exporter のドキュメントを参照してください。
receivers:
    otlp: # otlp protocol, receives data sent by the OpenTelemetry Java Agent
        protocols:
            grpc:
                endpoint: 0.0.0.0:4317
            http:
                endpoint: 0.0.0.0:4318

processors:
    batch:
        send_batch_size: 100000 # Number of records per batch; recommended batch size is between 100M and 1G
        timeout: 10s

exporters:
    doris:
        endpoint: http://localhost:8030 # FE HTTP address
        database: doris_db_name
        username: doris_username
        password: doris_password
        table:
            traces: doris_table_name
        create_schema: true # Whether to automatically create the schema; when set to false, you need to create the table manually
        mysql_endpoint: localhost:9030  # FE MySQL address
        history_days: 10
        create_history_days: 10
        timezone: Asia/Shanghai
        timeout: 60s # http stream load client timeout
        log_response: true
        sending_queue:
            enabled: true
            num_consumers: 20
            queue_size: 1000
        retry_on_failure:
            enabled: true
            initial_interval: 5s
            max_interval: 30s
        headers:
            load_to_single_tablet: "true"
ステップ 3: OpenTelemetry Collector を実行する
./otelcol-contrib --config otel_demo.yaml
ステップ 4: Spring Boot のサンプルアプリケーションを起動する
アプリケーションを起動する前に、いくつかの環境変数を設定するだけで済みます。コードの変更は不要です。
export JAVA_TOOL_OPTIONS="${JAVA_TOOL_OPTIONS} -javaagent:/your/path/to/opentelemetry-javaagent.jar" # Path to the OpenTelemetry Java Agent
export OTEL_JAVAAGENT_LOGGING="none" # Disable otel logging to avoid interfering with the service's own logs
export OTEL_SERVICE_NAME="myproject"
export OTEL_TRACES_EXPORTER="otlp" # Use the otlp protocol to send trace data
export OTEL_EXPORTER_OTLP_ENDPOINT="http://localhost:4317" # Address of the OpenTelemetry Collector

java -jar myproject-0.0.1-SNAPSHOT.jar
ステップ 5: サンプルアプリケーションにアクセスしてトレースデータを生成する
curl localhost:8080 を実行して hello サービスの呼び出しを発生させます。OpenTelemetry Java Agent がトレースデータを自動生成し、OpenTelemetry Collector に送信します。その後、Collector が設定済みの Doris Exporter を通じてトレースデータを Doris テーブルに書き込みます(デフォルトのテーブル名は otel.otel_traces です)。
3. トレースのクエリ
トレースのクエリは通常、Grafana などの視覚的なインターフェースから実行します。一般的な使用例は次のとおりです。
-
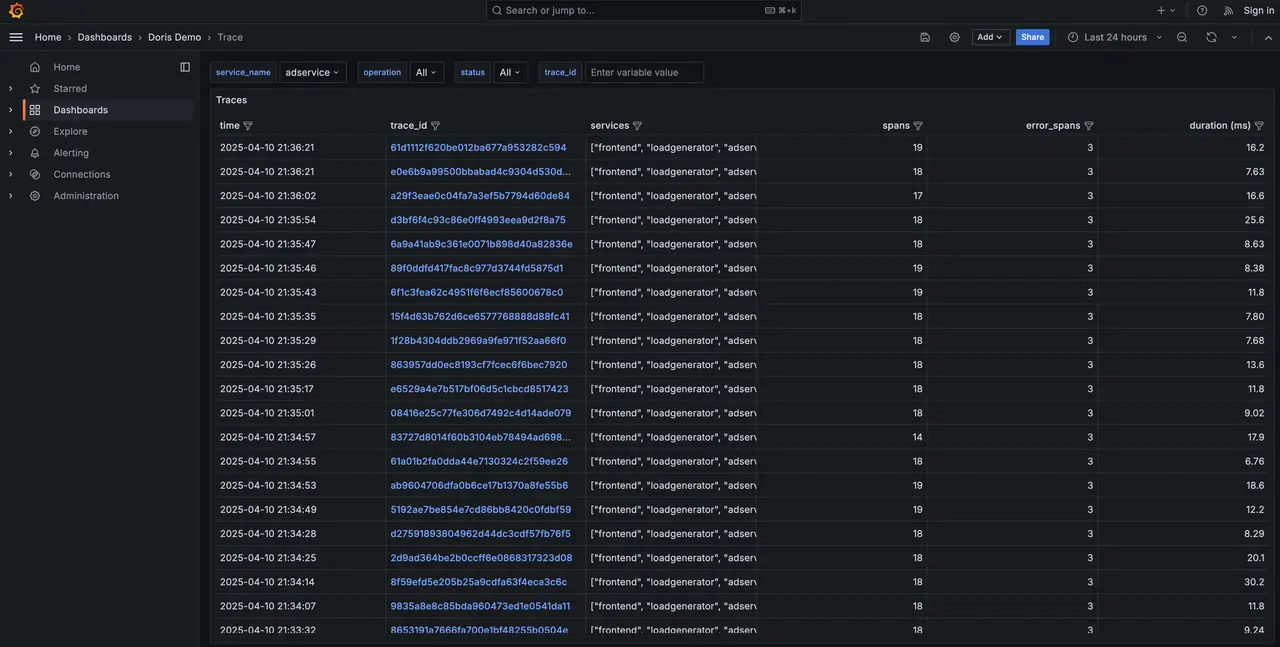
時間範囲とサービス名で絞り込み、レイテンシー分布のグラフや最新のトレースを含む概要を表示します。
-
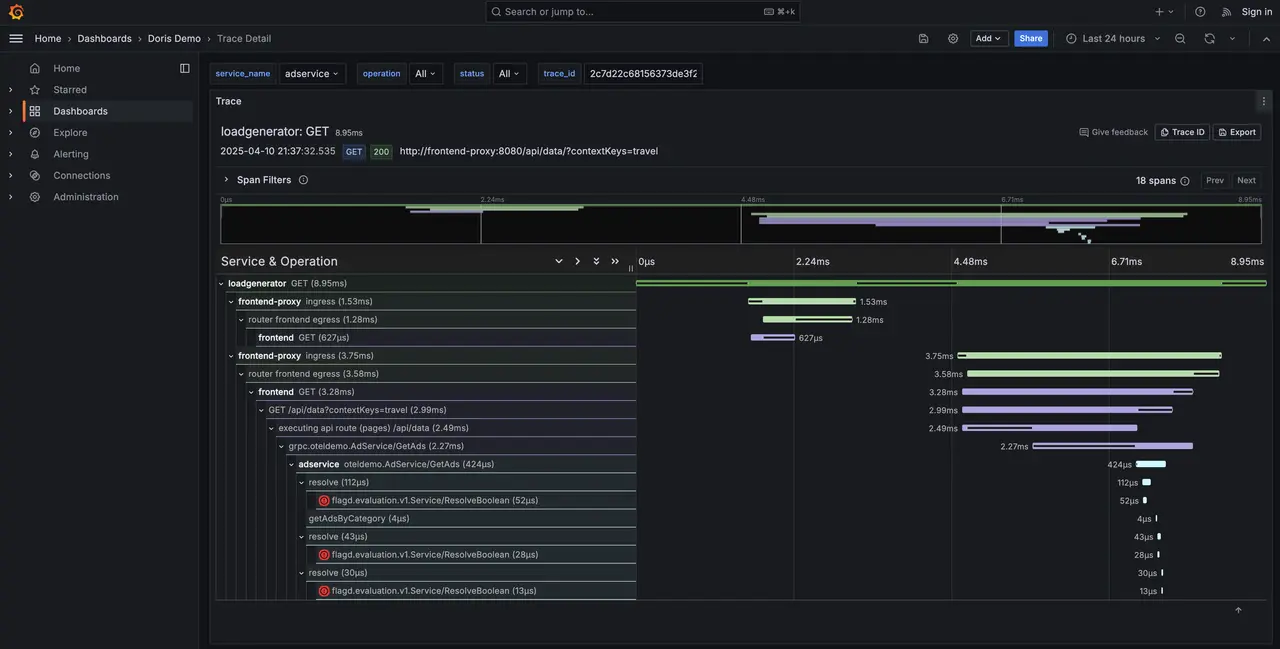
リンクをクリックしてトレースの詳細を表示します。