Pipeline 実行エンジン
一文での定義
Pipeline 実行エンジンは、Doris 3.0 以降で Volcano モデルに完全に取って代わった並列実行モデルです。Hyper の論文で説明されている Pipeline の実装を参考に、クエリを並列実行できる Pipeline と PipelineTask に分割します。これにより、マルチコア CPU の処理能力を十分に引き出しながらクエリのスレッド数を制限し、スレッド数の過剰な増加を解消します。
概要チェックリスト
この記事を読む前に、次の点を押さえておいてください。
- Doris 3.0 以降、Pipeline 実行エンジンは従来の Volcano モデルに完全に取って代わっています。
- Doris は Pipeline モデルに基づいて、Query、DDL、DML ステートメントを並列処理します。
- 詳細な設計、実装、効果については、次の二つの DSIP を参照してください。
物理プラン
Pipeline 実行モデルを理解するには、まずクエリの物理プランにおける PlanFragment と PlanNode という二つの中心的な概念を理解する必要があります。以下の SQL を例に説明します。
SELECT k1, SUM(v1) FROM A,B WHERE A.k2 = B.k2 GROUP BY k1 ORDER BY SUM(v1);
論理プラン
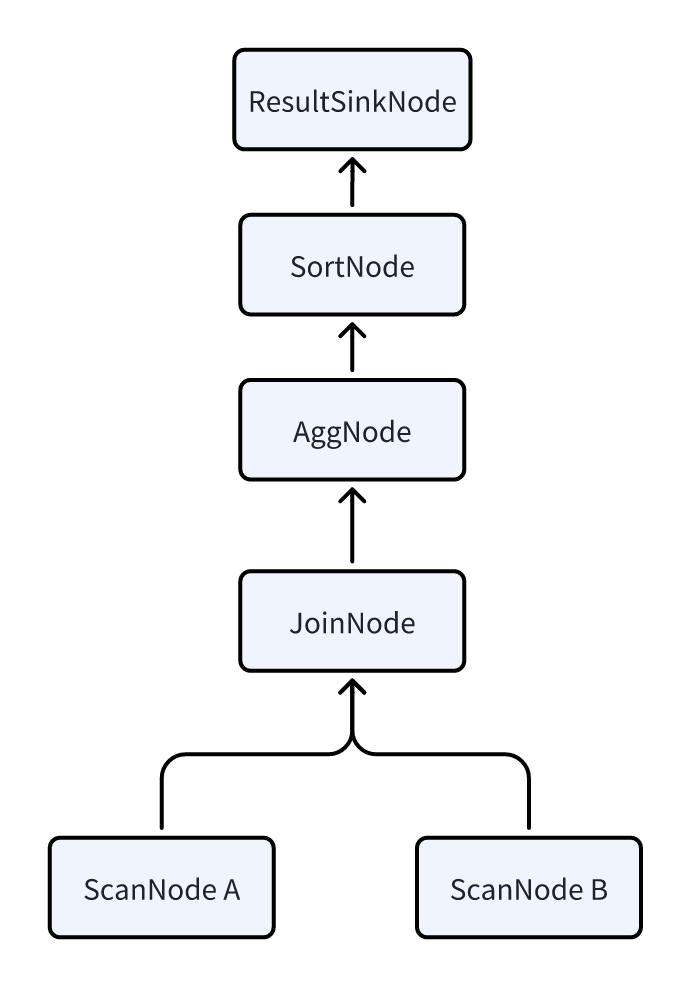
FE はまず、この SQL を以下の論理プランに変換します。プラン内の各ノードが PlanNode です。各 Node タイプの意味については、物理プランの確認方法を説明する箇所を参照してください。
物理プラン
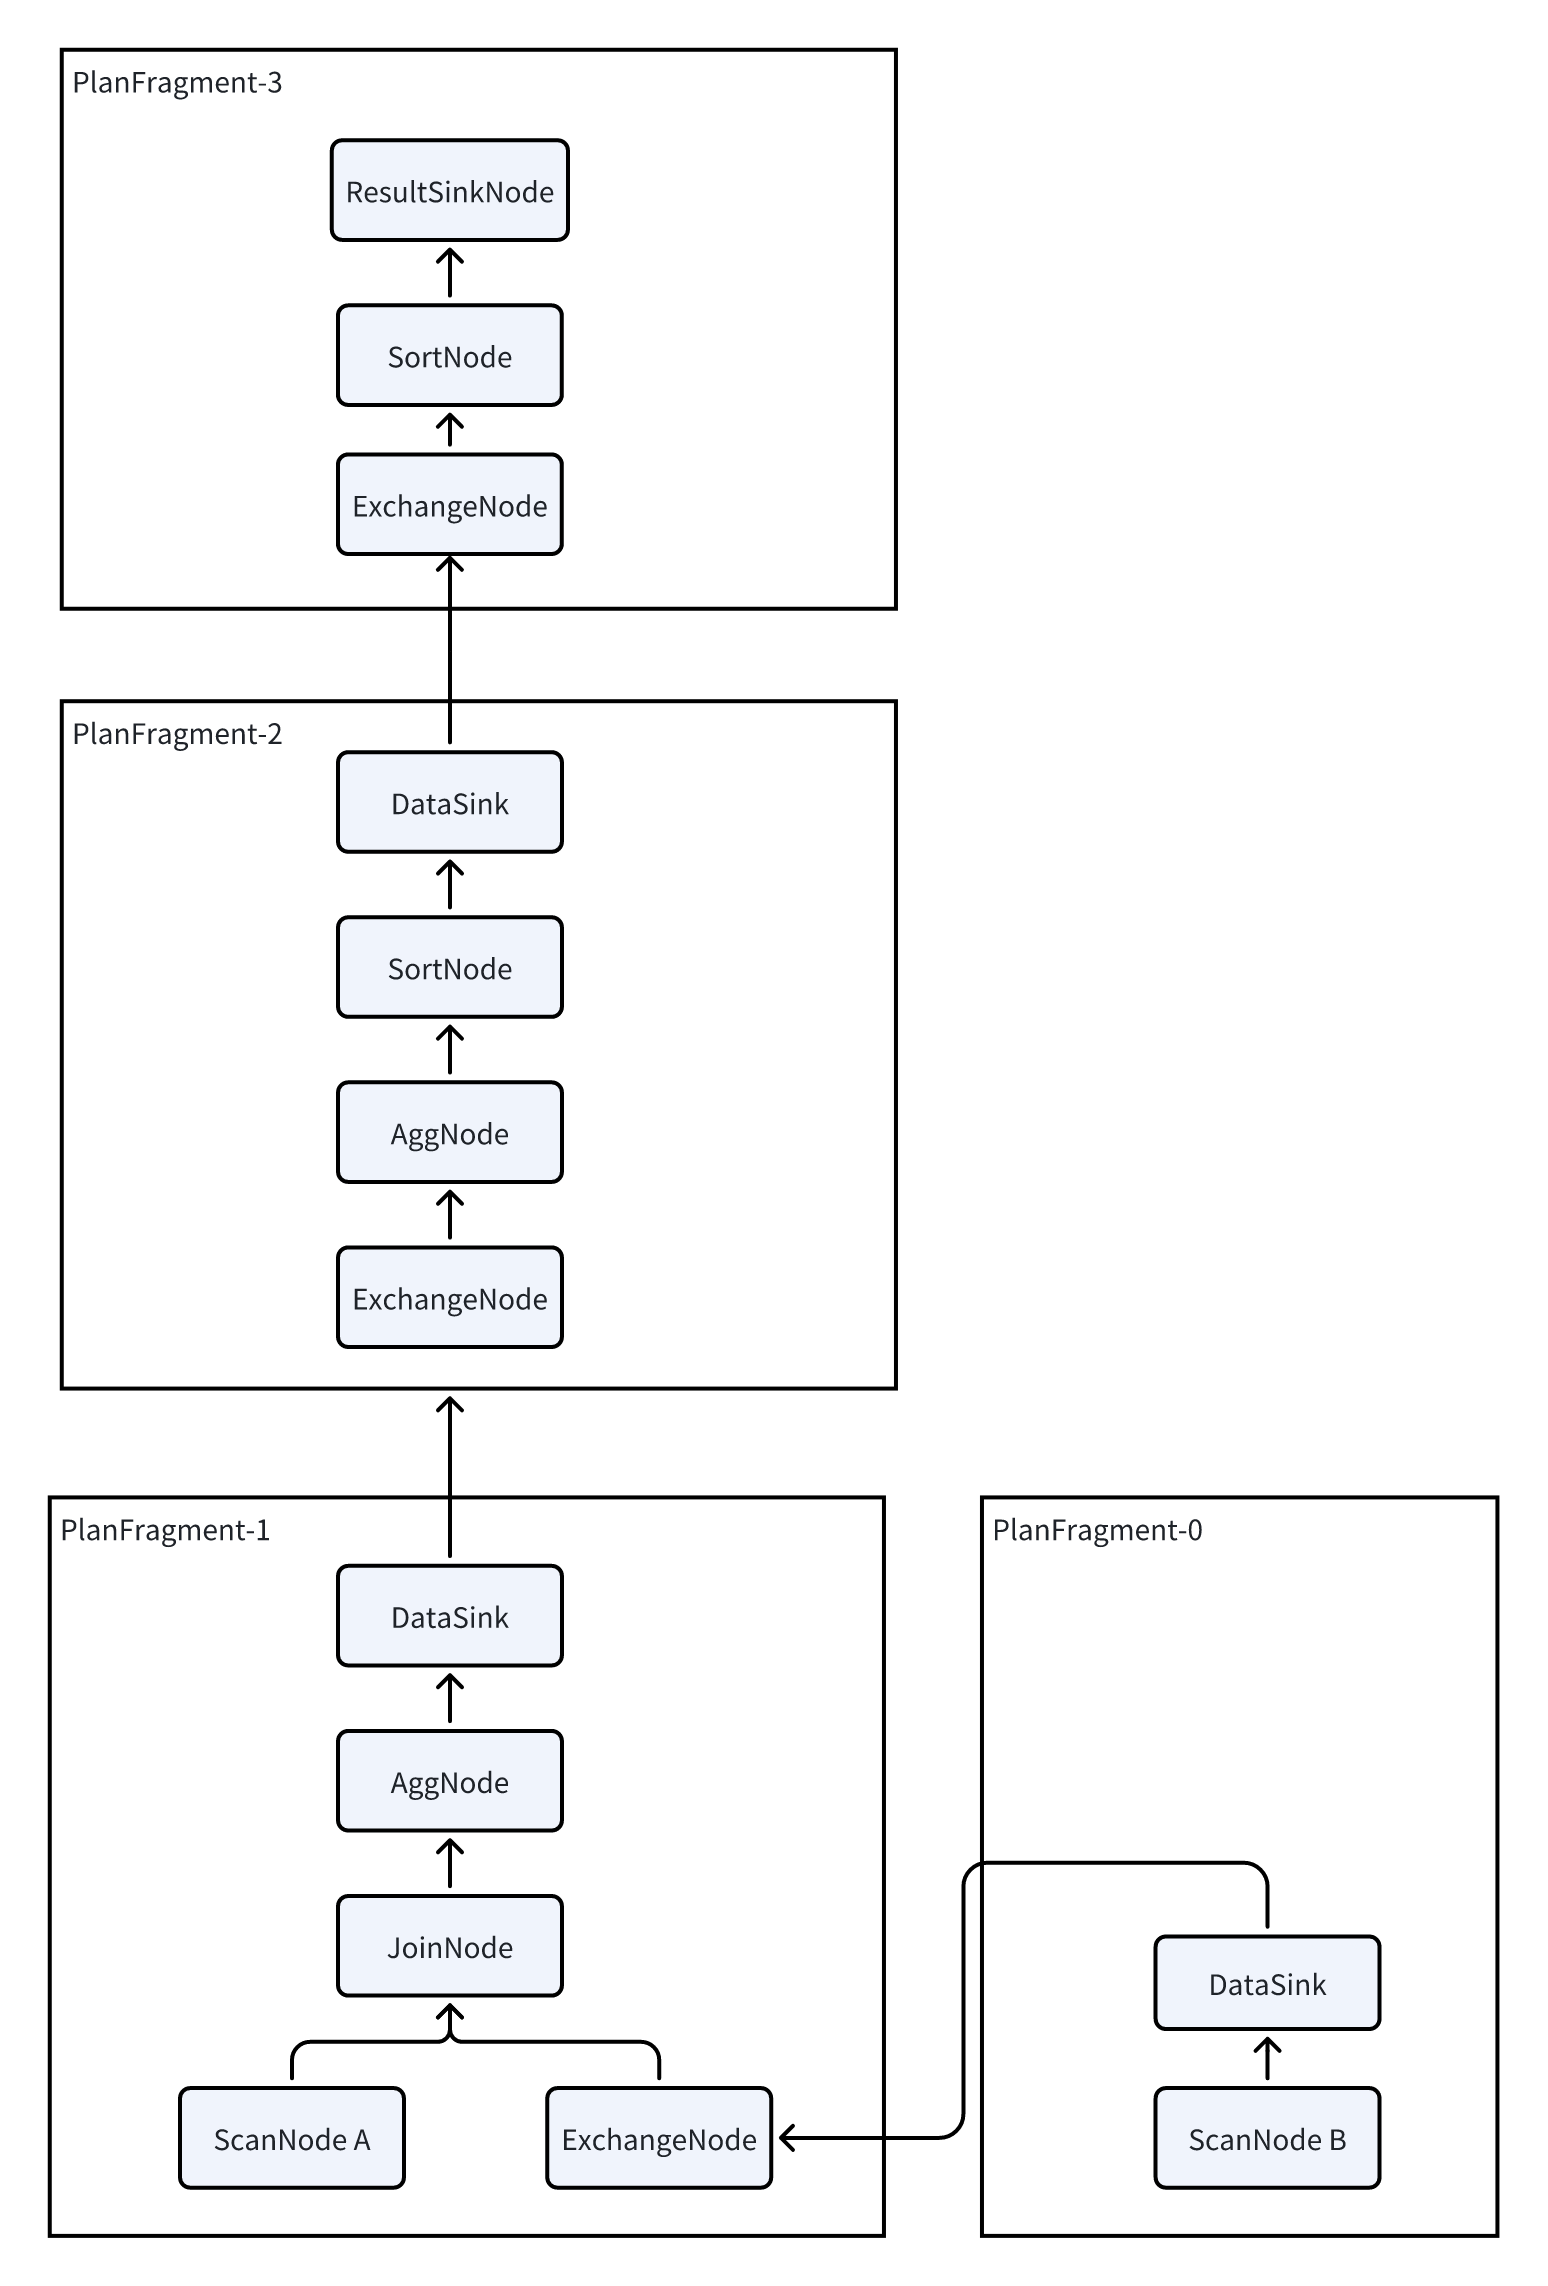
Doris は MPP アーキテクチャを採用しているため、各クエリでは、実行にすべての BE を並列に参加させてクエリのレイテンシーを下げようとします。そのため、論理プランを物理プランに分割する必要があります。
- 論理プランに
DataSinkとExchangeNodeを挿入します。これらの Node は、複数の BE 間でのデータ Shuffle を担います。 - 分割後の各 PlanFragment は PlanNode の一部を含み、独立したタスクとして BE に送信できます。
- BE は PlanFragment 内の PlanNode の計算を終えると、
DataSinkとExchangeNodeを通じてデータを他の BE に Shuffle し、計算を続けます。
三層のプランニング構造
Doris のプランニングは、次の 3 層に分かれます。
| 層 | 名前 | 説明 |
|---|---|---|
| 1 | PLAN(実行プラン) | SQL ステートメントは実行プランナーによって実行プランに変換され、その後、実行エンジンによって実行されます。 |
| 2 | FRAGMENT(実行フラグメント) | Doris は分散実行エンジンです。完全な実行プランは複数の単一マシン用の実行フラグメントに分割されます。FRAGMENT は完全な単一マシン用実行フラグメントを表し、複数の FRAGMENT で完全な PLAN を構成します。 |
| 3 | PLAN NODE(オペレーター) | 実行プランの最小単位です。FRAGMENT は複数のオペレーターから構成され、各オペレーターは集約や Join など、特定の実行ロジックを担当します。 |
Pipeline 実行モデル
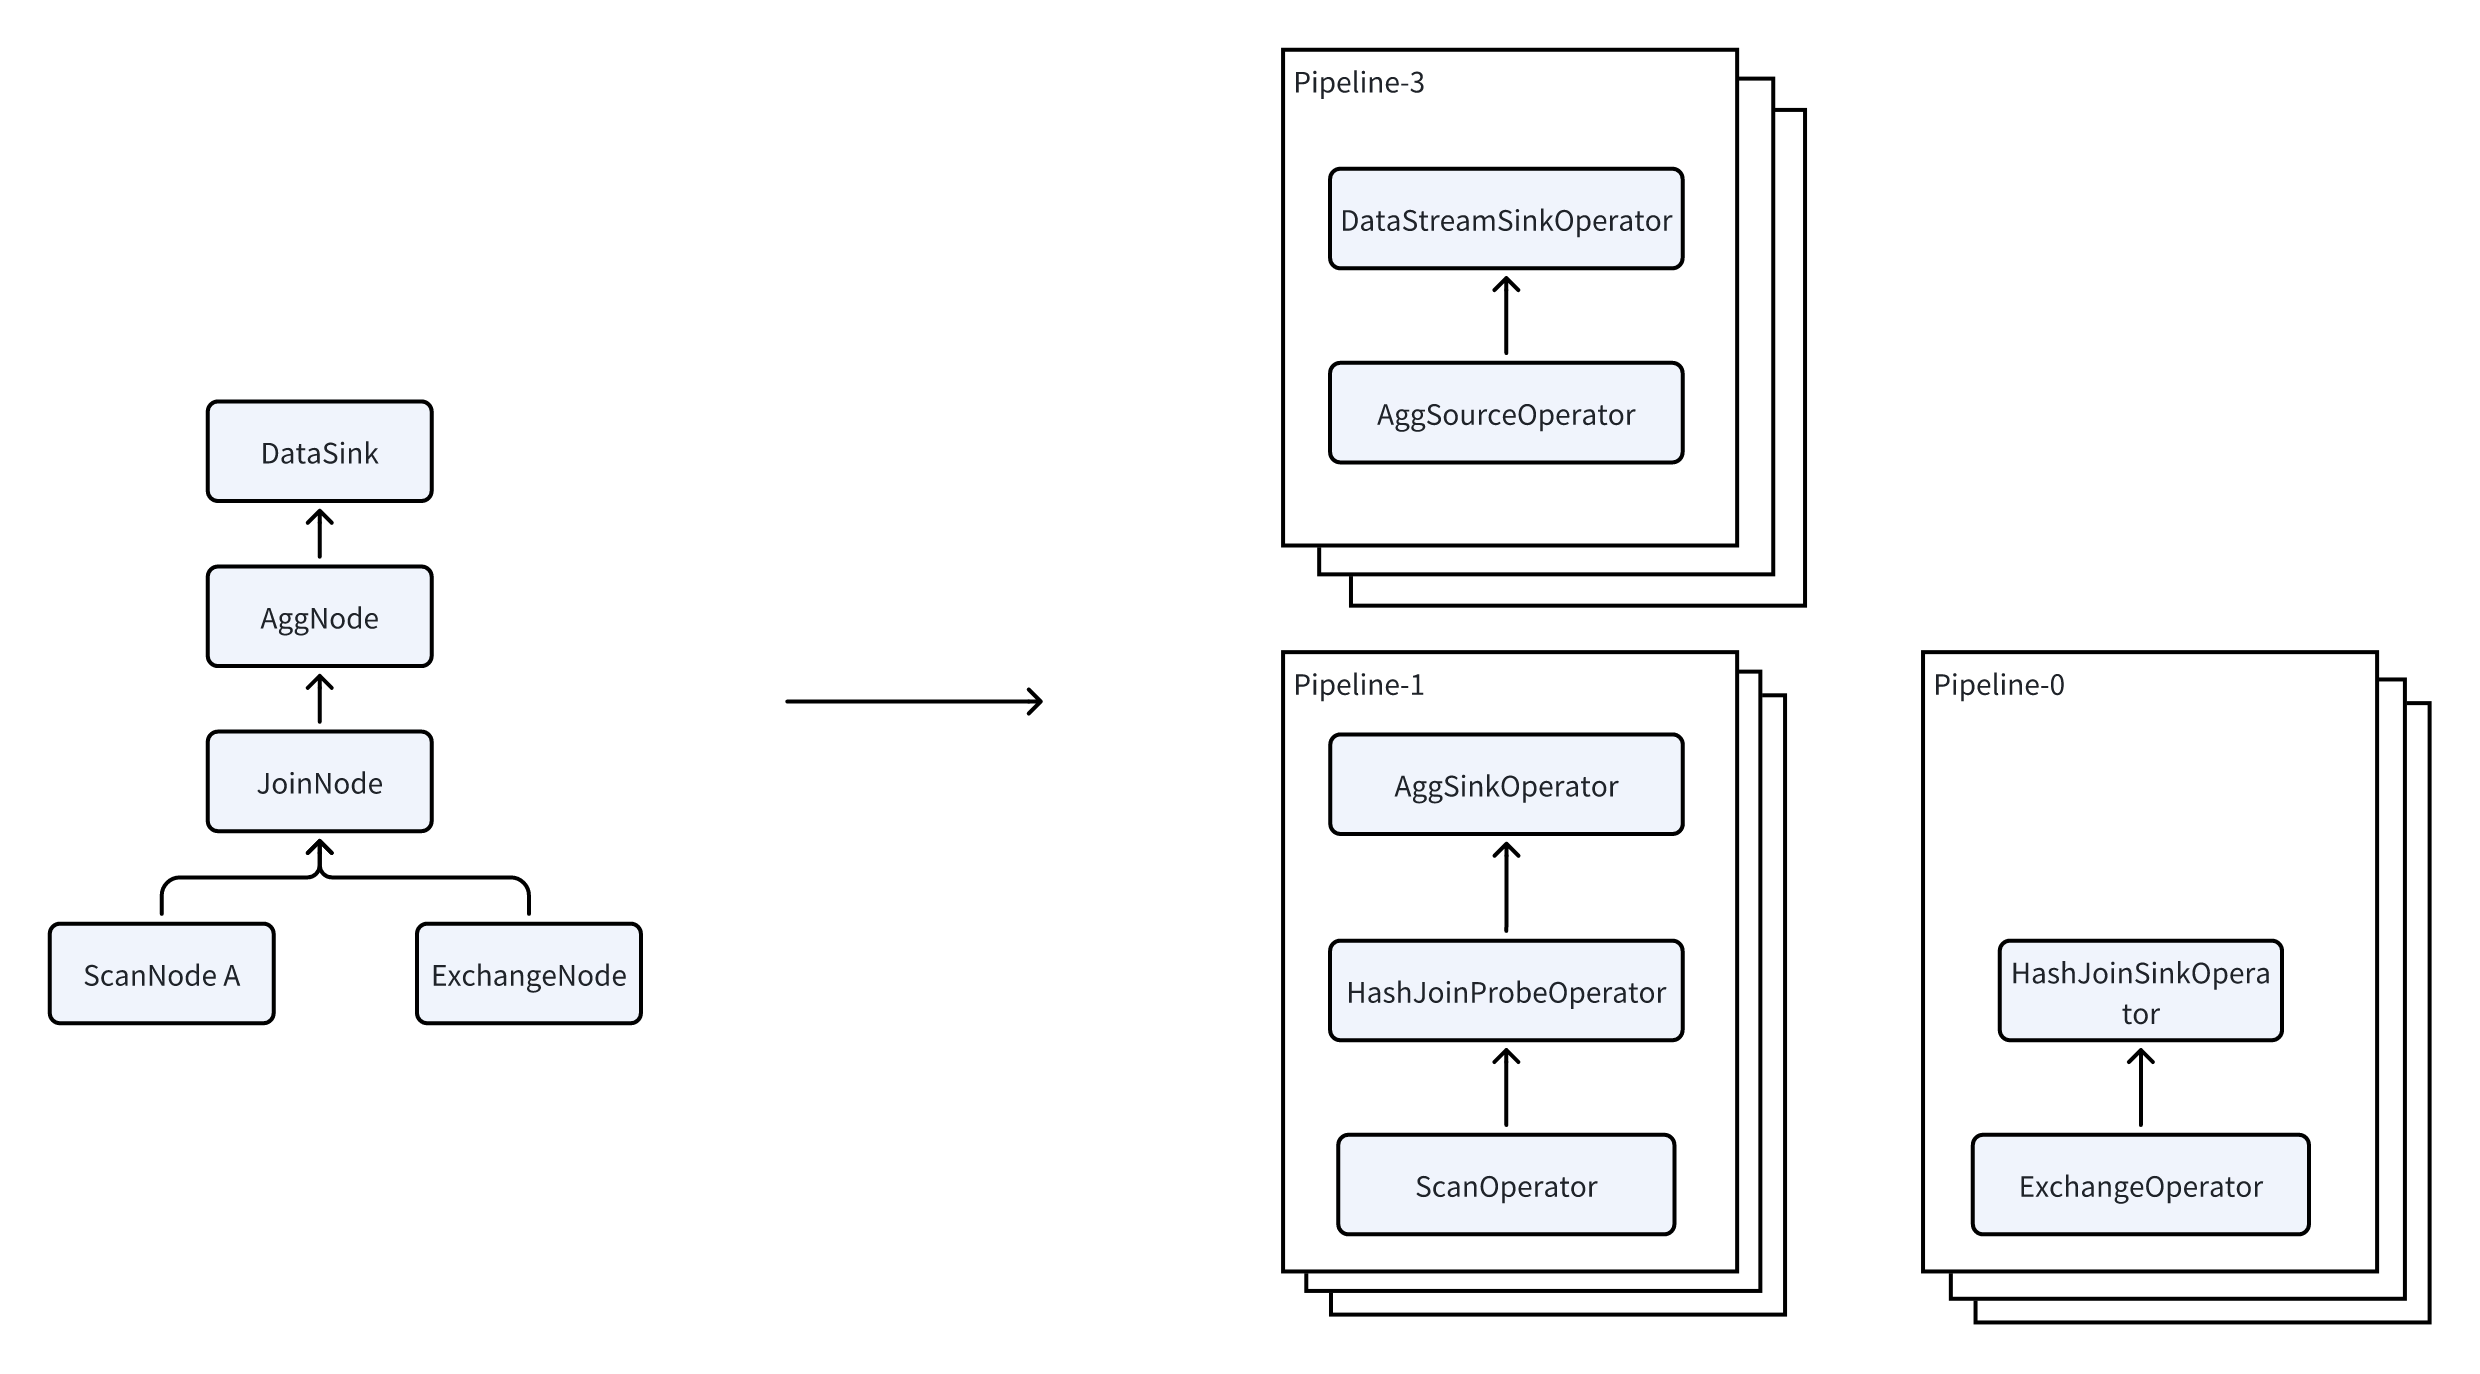
PlanFragment は、FE が BE に送信する実行タスクの最小単位です。BE は同じ Query に属する複数の異なる PlanFragment を受け取る場合があり、それぞれを独立して処理します。
BE は PlanFragment を受け取ると、次のように処理します。
- PlanFragment を複数の Pipeline に分割します。
- 複数の PipelineTask を開始して並列実行します。
- クエリの実行効率を高めます。
Pipeline
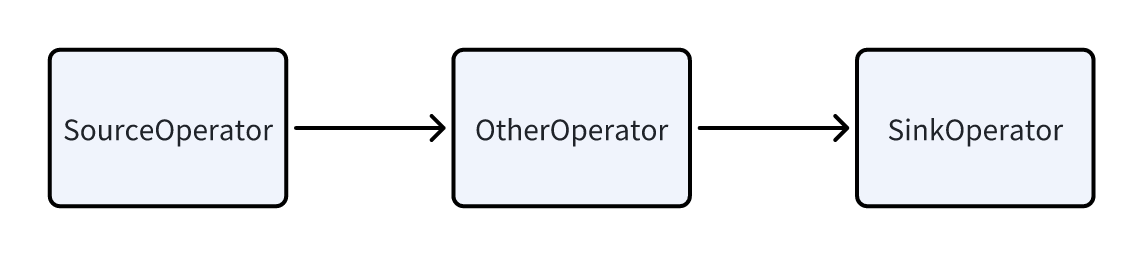
Pipeline は、次の要素で構成されます。
- 一つの SourceOperator:外部からのデータの読み取りを表します。テーブル(OlapTable)または Buffer(Exchange)を使用できます。
- 中間にある複数の Operator。
- 一つの SinkOperator:データの出力を表します。ネットワーク経由で別のノードにデータを Shuffle するもの(
DataStreamSinkOperatorなど)や、HashTable に出力するもの(Agg オペレーター用のJoinBuildHashTableなど)があります。
Pipeline 間の依存関係(Dependency)
複数の Pipeline の間には依存関係があります。JoinNode を例にすると、実際には次の 2 つの Pipeline に分割されます。
- Pipeline-0:Exchange からデータを読み取り、HashTable を構築します。
- Pipeline-1:テーブルからデータを読み取り、Probe を実行します。
これらの Pipeline の関係は次のとおりです。
- Pipeline-1 の実行は、Pipeline-0 の完了に依存します。
- この依存関係を Dependency と呼びます。
- Pipeline-0 は実行を終えると、Dependency の
set_readyメソッドを呼び出し、実行できる状態になったことを Pipeline-1 に通知します。
PipelineTask
Pipeline は実際にはまだ論理的な概念であり、そのまま実行できる実体ではありません。実際に実行するには、Pipeline を複数の PipelineTask としてインスタンス化する必要があります。
- 読み取るデータは各 PipelineTask に割り当てられ、最終的に並列処理が可能になります。
- 同じ Pipeline の複数の PipelineTask は、まったく同じ Operator を持ちます。異なるのは Operator の状態です(たとえば、読み取るデータや構築する HashTable が異なります)。このような個別の状態を LocalState と呼びます。
- 各 PipelineTask は最後に独立したタスクとしてスレッドプールに送られ、実行されます。
この Dependency によって駆動される仕組みの下で、マルチコア CPU をより効果的に活用し、十分な並列性を実現できます。
Operator
ほとんどの場合、Pipeline 内の各 Operator は一つの PlanNode に対応しますが、次のように例外となるオペレーターもあります。
| 元の PlanNode | 分割後の Operator |
|---|---|
| JoinNode | JoinBuildOperator + JoinProbeOperator |
| AggNode | AggSinkOperator + AggSourceOperator |
| SortNode | SortSinkOperator + SortSourceOperator |
分割の原則:計算前にすべてのデータを収集する必要がある一部のブレイキングオペレーターでは、データを取り込む部分を Sink に分割し、そのオペレーターからデータを取得する部分を Source と呼びます。
スキャンの並列化
データのスキャンは IO 負荷の高い処理です。ローカルディスクから大量のデータを読み取る必要があり、データレイクの場合は、さらにレイテンシーの高い HDFS や S3 から読み取らなければなりません。スキャン効率を高めるため、Doris は ScanOperator に並列スキャンを導入しています。
- ScanOperator は複数の Scanner を動的に生成します。
- 各 Scanner は約 1~2 百万行のデータをスキャンします。
- 各 Scanner はスキャン中に、対応するデータの展開、フィルタリング、その他の計算を行います。
- Scanner は ScanOperator が読み取れるように、データを DataQueue に送ります。
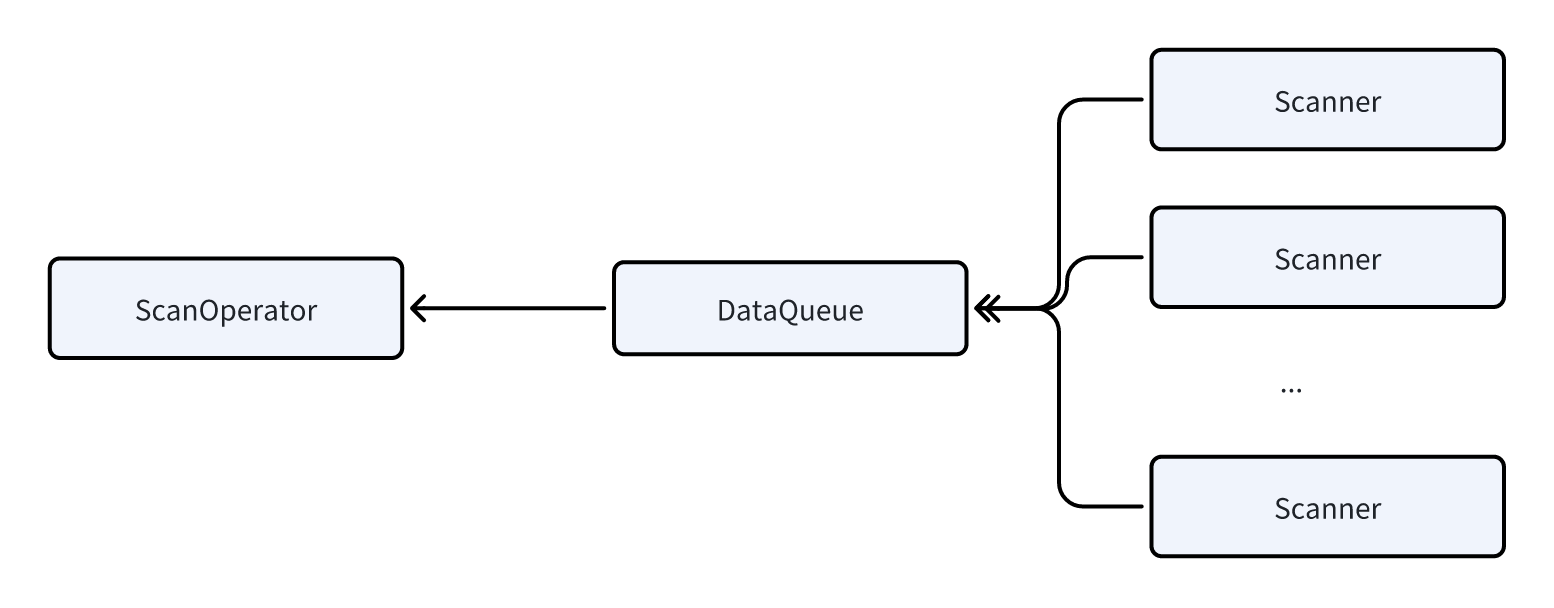
効果:並列スキャンにより、不適切なバケット分割やデータの偏りが原因で一部の ScanOperator の実行が長引き、クエリ全体のレイテンシーが増大する問題を効果的に回避できます。
Local Shuffle
Pipeline 実行モデルでは、Local Exchange が Pipeline Breaker として機能します。これは、データを各実行タスクにローカルで再分配する技術です。
主な目的は次のとおりです。
- 上流の Pipeline が出力したすべてのデータを、所定の方法(HASH または Round Robin)で下流の Pipeline のすべての Task に均等に分配します。
- 実行中のデータの偏りを解消します。
- 実行モデルがデータの格納方法やプランによる制約を受けないようにします。
動作例
先ほどの例の Pipeline-1 を使って、Local Exchange がデータの偏りを回避する仕組みを説明します。
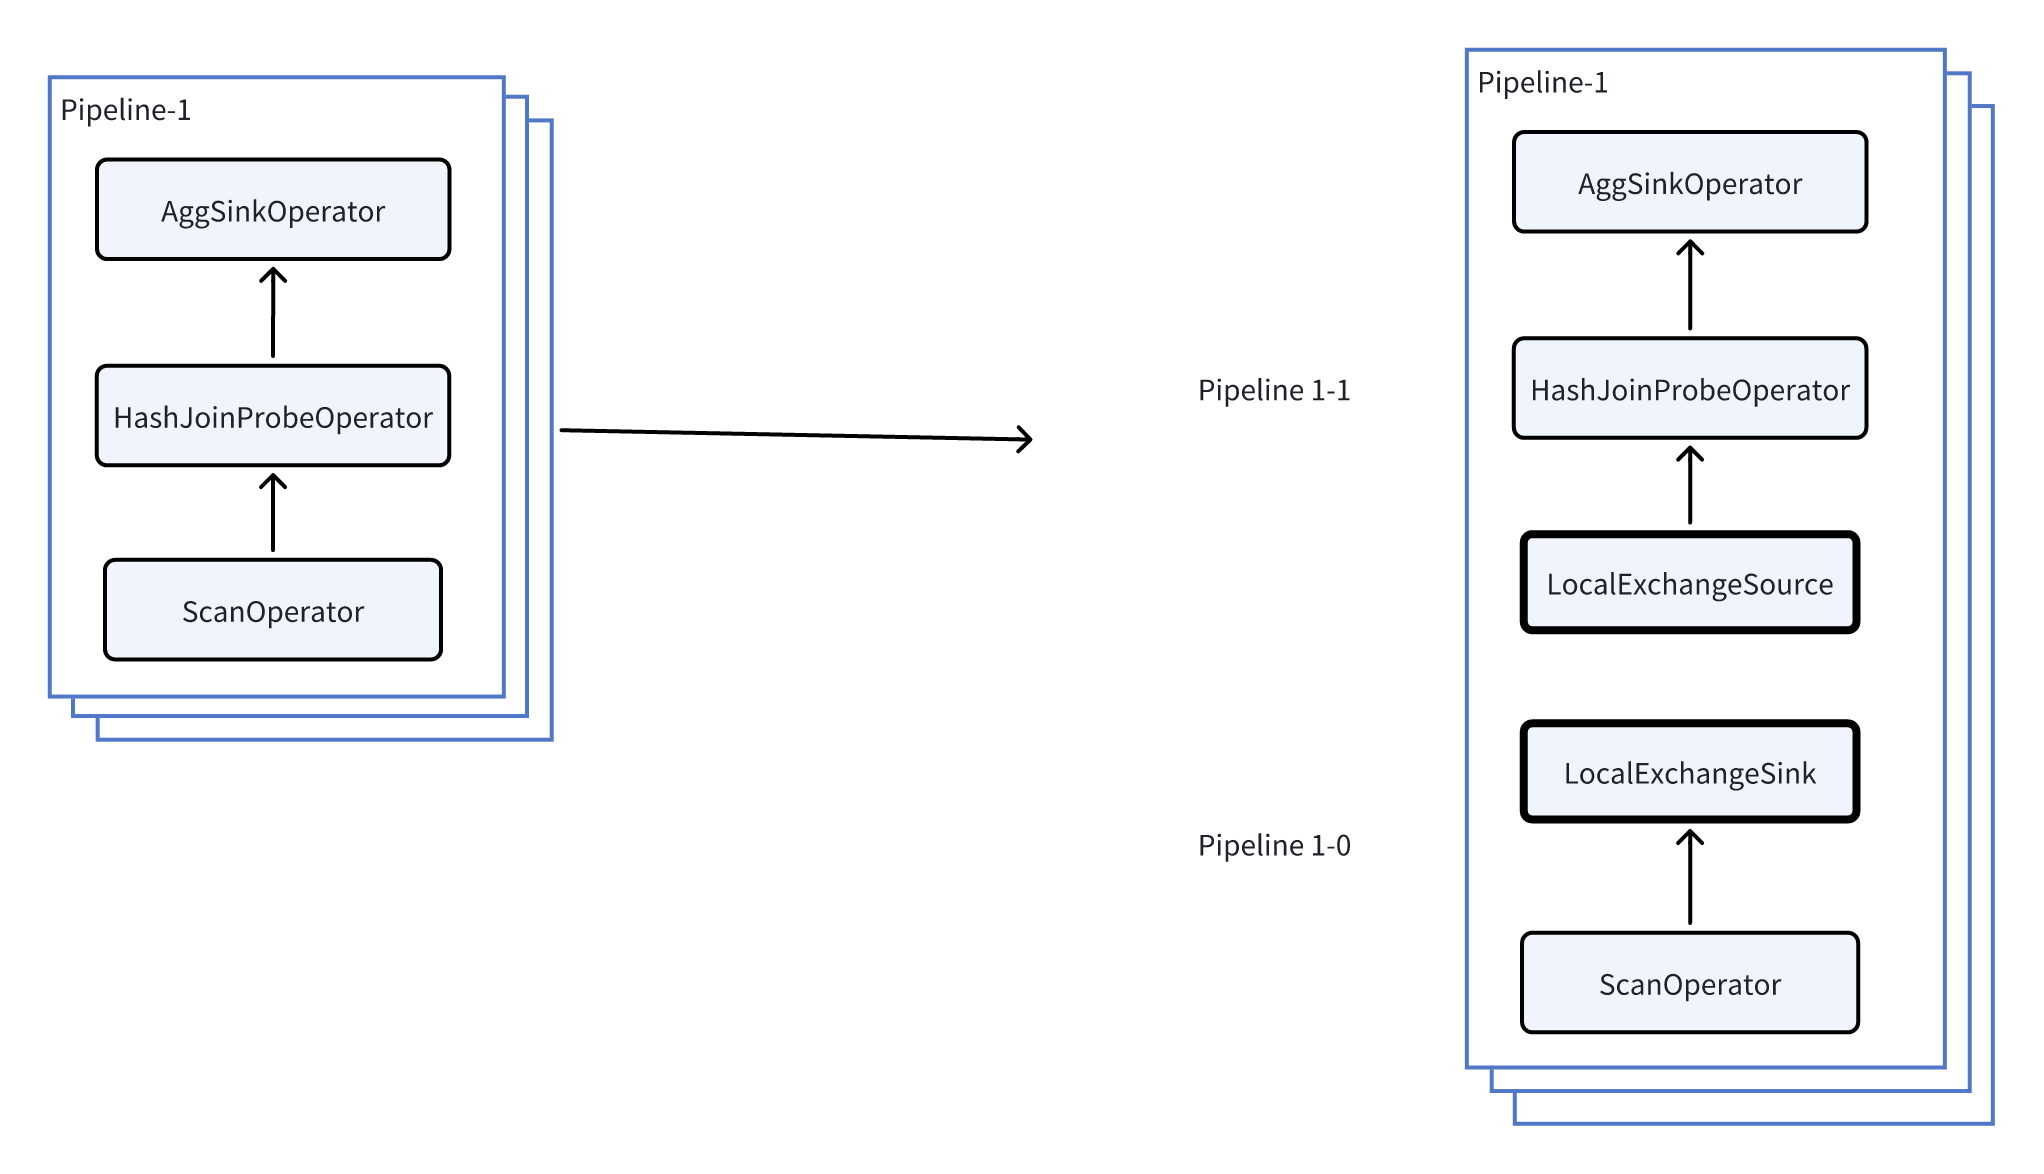
上の図のように、Pipeline 1 に Local Exchange を挿入すると、Pipeline 1 はさらに次のように分割されます。
- Pipeline 1-0
- Pipeline 1-1
現在の並列度が 3(各 Pipeline に 3 つのタスク)で、各タスクがストレージ層から一つのバケットを読み取り、3 つのバケットの行数がそれぞれ 1、1、7 であるとします。Local Exchange の挿入前後で、実行は次のように変わります。
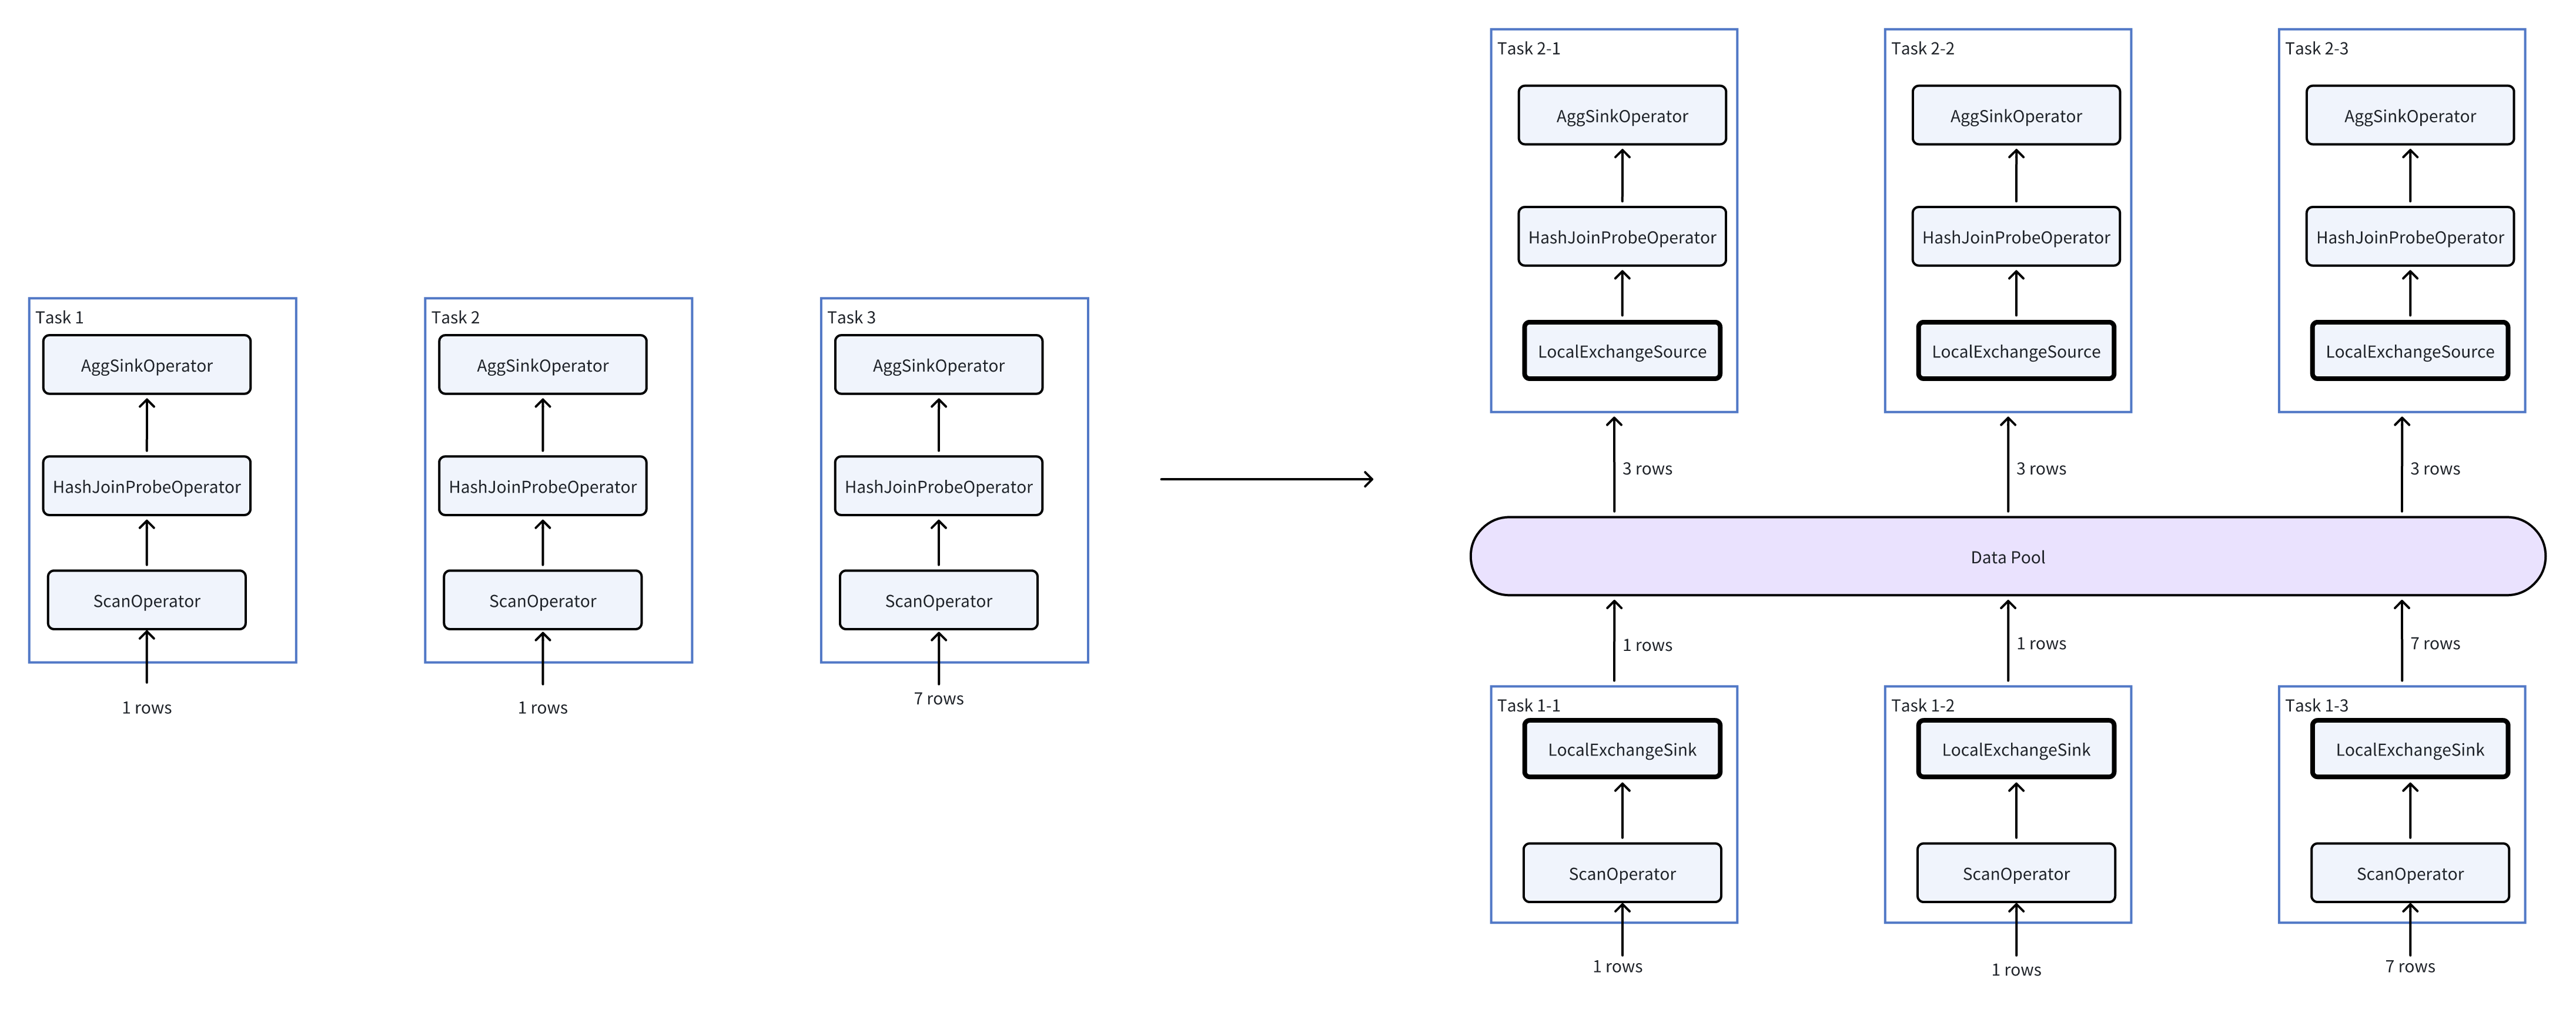
図の右側に示すように、HashJoin と Agg のオペレーターが処理するデータ量は (1, 1, 7) から (3, 3, 3) に変わり、データの偏りを回避できます。
プランニング規則
Doris で Local Exchange をプランに組み込むかどうかは、一連の規則によって決まります。たとえば、クエリに Join、集約、ウィンドウ関数など時間のかかるオペレーターが含まれる場合は、データの偏りをできるだけ回避するために Local Exchange が使用されます。